
รายงานความพร้อมใช้งาน GitHub ต.ค. 2026: รับมือเหตุขัดข้อง 8 ครั้ง
เรายังคงแชร์อัปเดตรายเดือนเกี่ยวกับงานเบื้องหลังความพร้อมใช้งานและความน่าเชื่อถือของ GitHub อย่างต่อเนื่อง
สรุปเนื้อหาเดือนตุลาคมแบบสั้น: เราได้เพิ่มความจุของ Azure ที่สามารถปรับขนาดได้อย่างเป็นอิสระ (independently scalable) ในปริมาณมาก และได้ขจัดวิธีต่างๆ ที่ความล้มเหลวอาจลุกลามออกไป อย่างไรก็ตาม การหยุดชะงักของการเขียน (write outages), ช่องโหว่ในการตรวจสอบ (monitoring gaps) ระหว่างการย้ายข้อมูล และการหยุดชะงักของเครือข่ายในระดับภูมิภาค ได้ตอกย้ำถึงความจำเป็นที่การขยายความจุต้องควบคู่ไปกับการปฏิบัติงานที่ปลอดภัยกว่าเดิม การแยกส่วน (isolation) ที่แข็งแกร่งขึ้น และการกู้คืนระดับภูมิภาคที่ได้รับการตรวจสอบแล้ว
ณ วันที่ 9 พฤศจิกายน บริการที่ใช้งานจริง (production services) 140 จาก 151 บริการ และ MySQL primaries 32 จาก 50 ตัว กำลังทำงานใน Azure Central US โดย Azure ให้บริการการอ่านสำหรับบริการที่ย้ายมาแล้ว (migrated-service reads) 63%, การอ่านแบบ monolith 66% และการอ่าน Git 52% นอกจากนี้เรายังเสร็จสิ้นการขยายส่วนประมวลผลใน Central US Kubernetes clusters ทั้ง 9 แห่ง ซึ่งเพิ่มความจุมากกว่าสองเท่า
ความจุดังกล่าวรองรับการเติบโตที่เกิดขึ้นจริงแล้ว ปริมาณทราฟฟิกของบริการที่ย้ายมาเพิ่มขึ้น 82% ตั้งแต่เดือนมีนาคม โดย Central US รองรับการเติบโตที่เกินกว่าภาระโหลดเฉลี่ยรายสัปดาห์สูงสุดที่เคยให้บริการจากศูนย์ข้อมูลเดิมของเรา สิ่งนี้ช่วยให้ GitHub มีพื้นที่ในการเติบโตมากขึ้นโดยไม่ต้องผลักดันสภาพแวดล้อมเดิมให้เกินขอบเขตการทำงานก่อนหน้านี้
เรายังได้ทำการปรับปรุงความน่าเชื่อถือแบบเฉพาะเจาะจงหลายประการ การเปลี่ยนแปลงใน Actions ช่วยเพิ่มความจุสำหรับการร้องขอ control-plane ของ Azure ที่สำคัญ การบรรเทาปัญหา NAT-gateway แยกต่างหากช่วยลดการใช้งานลง 85% มีงาน production ล้มเหลว 4 งานระหว่างการเปลี่ยนแปลง เมื่อเทียบกับที่คาดไว้ประมาณ 800 งานหากไม่มีการบรรเทาปัญหา นอกจากนี้ การจำกัดการเชื่อมต่อและการปรับปรุงฝั่ง client อื่นๆ ในขณะนี้ยังช่วยลดโอกาสที่การขัดจังหวะของส่วนที่ต้องพึ่งพา (dependency interruption) จะกลายเป็นพายุการเชื่อมต่อใหม่ (reconnect storm) ในวงกว้าง
เราได้ขจัดแหล่งสะสมภาระโหลดของฐานข้อมูลด้วยเช่นกัน endpoint ของ GitHub Actions ที่มีทราฟฟิกสูงซึ่งจัดการคำร้องขอมากกว่า 250 ล้านรายการต่อวันได้ถูกย้ายไปยังเส้นทางบริการที่มีประสิทธิภาพมากขึ้น ช่วยลดการอ่านฐานข้อมูลช่วงสูงสุดลง 85% การกำหนดให้มีอักขระอย่างน้อยสามตัวก่อนการค้นหาหัวข้อใน repository ช่วยลดคิวรีที่ช้าหรือถูกยกเลิกสำหรับรูปแบบนั้นลงประมาณ 98%
อย่างไรก็ตาม ความน่าเชื่อถือยังไม่เป็นไปตามที่ควรจะเป็น เหตุการณ์ write outages เมื่อวันที่ 7 ตุลาคม เผยให้เห็นการปฏิสัมพันธ์ที่ไม่ปลอดภัยระหว่าง database orchestration และการกำหนดเส้นทางใน production การหยุดชะงักของเครือข่าย Azure เมื่อวันที่ 29 ตุลาคม ส่งผลกระทบต่อ Central US availability zones ทั้งสามแห่ง และผู้ใช้ที่ลงชื่อเข้าใช้งานอย่างน้อย 34,128 ราย รายละเอียดเพิ่มเติมเกี่ยวกับเหตุการณ์เหล่านี้และเหตุการณ์อื่นๆ มีดังนี้
การสร้าง East US 3 ล่าช้ากว่าแผนประมาณหนึ่งสัปดาห์ ขั้นตอนต่อไปจะเริ่มด้วยการเพิ่มทราฟฟิกที่ผ่านการตรวจสอบแล้วครั้งแรกในสัปดาห์แรกของเดือนธันวาคม ในขณะที่เรายังคงเสริมความปลอดภัยในการย้ายข้อมูล การแยกส่วน dependency และการกู้คืนระดับภูมิภาคให้แข็งแกร่งยิ่งขึ้น
หลักการยังคงเหมือนเดิมคือ: ความพร้อมใช้งาน (availability) ตามด้วยความจุ (capacity) แล้วจึงตามด้วยฟีเจอร์ (features)
05 ตุลาคม 19:11 UTC (ใช้เวลา 3 ชั่วโมง 38 นาที)
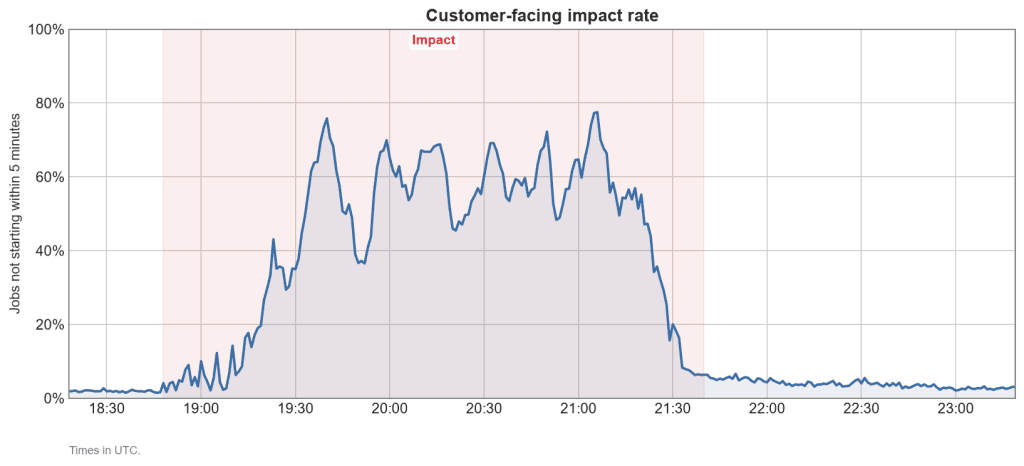
ระยะเวลา: ประมาณ 3 ชั่วโมง 45 นาที
ลูกค้าอาจเห็นงาน GitHub Actions บน GitHub-hosted runners ค้างอยู่ในคิวรอนานกว่าปกติมาก และ workflow runs บางส่วนเริ่มทำงานไม่สำเร็จ ในช่วงที่แย่ที่สุดซึ่งกินเวลาประมาณ 90 นาที งานส่วนใหญ่บน GitHub-hosted runners ไม่เริ่มทำงานภายในห้านาที ผลกระทบเบาบางลงเมื่อเรา fail over ไปยังภูมิภาคที่ปกติดีและเพิ่มความจุ ส่วน self-hosted runners ไม่ได้รับผลกระทบ ไซต์ GitHub Pages ที่สร้างด้วย actions อัปเดตล่าช้า แม้ว่าไซต์เดิมจะยังคงให้บริการได้ตามปกติ ลูกค้าบางรายยังพบข้อผิดพลาดในรายการ repository, หน้าลิขสิทธิ์และการเรียกเก็บเงิน และฟีเจอร์ Copilot บางอย่างด้วย
เกิดอะไรขึ้นและทำไม?
งาน Actions ค้างอยู่ในคิวหรือเริ่มทำงานไม่สำเร็จเนื่องจากบริการที่รับหน้าที่จ่ายงานให้กับ GitHub-hosted runners หยุดทำงานอย่างเสถียร ความล้มเหลวของเครือข่ายบางส่วนในฝั่งผู้ให้บริการคลาวด์ขัดขวางการเชื่อมต่อบางอย่างระหว่างภูมิภาคศูนย์ข้อมูลแห่งหนึ่งกับฐานข้อมูลบนคลาวด์ที่บริการนั้นพึ่งพา แทนที่จะล้มเหลวทันที (fail fast) บริการกลับรอให้การเรียกเหล่านั้นหมดเวลา (time out) คำเรียกที่รอกองสะสมจนกระทั่งบริการหน่วยความจำเต็มและเริ่มการทำงานใหม่ (restart)
จากนั้นงานต่างๆ ถูกเปลี่ยนไปที่บริการเดียวกันในภูมิภาคที่ปกติดี ซึ่งไม่มีความจุเพียงพอสำหรับความต้องการที่เพิ่มขึ้นและเริ่มล้มเหลวตามไปด้วย ในขณะเดียวกัน runner ที่ไม่ได้รับงานนานหลายนาทีได้ปิดตัวลงและถูกแทนที่ได้ช้า จึงมี runner พร้อมใช้งานน้อยลงเพื่อมารับงาน
เราตอบสนองอย่างไร?
- ความล้มเหลวของเครือข่ายบางส่วนเริ่มต้นขึ้น และงาน Actions เริ่มค้างสะสม
- การแจ้งเตือนระบุถึงข้อผิดพลาดและการจ่ายงานที่ล่าช้า และเราได้ประกาศเหตุการณ์ฉุกเฉิน
- เราได้ติดตั้ง (redeploy) บริการที่จ่ายงานให้ GitHub-hosted runners ใหม่ แต่ก็ไม่กู้คืน เราพบร่องรอยความล้มเหลวจากปัญหาเครือข่าย
- เราได้ทำ fail over ฐานข้อมูลและพื้นที่จัดเก็บที่ได้รับผลกระทบไปยังภูมิภาคที่ปกติดีทีละบริการ และเพิ่มความจุ Actions กู้คืนได้ แต่บริการอื่นๆ ที่ได้รับผลกระทบบางส่วนยังคงล้มเหลวแม้จะทำ fail over แล้ว
- เราทำงานร่วมกับผู้ให้บริการคลาวด์เพื่อแก้ไขความล้มเหลวของเครือข่าย บริการที่เหลือได้รับการกู้คืน และเราได้ปิดเหตุการณ์
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เรากำลังทำให้บริการที่จ่ายงานให้กับ GitHub-hosted runners สามารถรองรับภาระโหลดที่เพิ่มขึ้นกะทันหันได้ดีขึ้น เพื่อให้ทำงานต่อได้เมื่อภูมิภาคอื่นโอนย้ายงานส่วนเกินมาให้
- ตอนนี้เราได้ขยายลำดับความสำคัญของการจ่าย runner ตามโปรไฟล์ลูกค้าเมื่อความจุ runner ที่พร้อมใช้งานลดลง
- เรากำลังเปลี่ยนพฤติกรรมของ GitHub-hosted runners เพื่อลดเวลากู้คืนเมื่อบริการจ่ายงานลดประสิทธิภาพลงในช่วงเวลาหนึ่ง
- เรากำลังปรับปรุงความรวดเร็วในการตรวจจับและระบุตำแหน่งของความล้มเหลวของเครือข่ายบางส่วนระหว่างศูนย์ข้อมูลของเราและบริการบนคลาวด์ที่พึ่งพา
06 ตุลาคม 19:57 UTC (ใช้เวลา 3 ชั่วโมง 43 นาที)
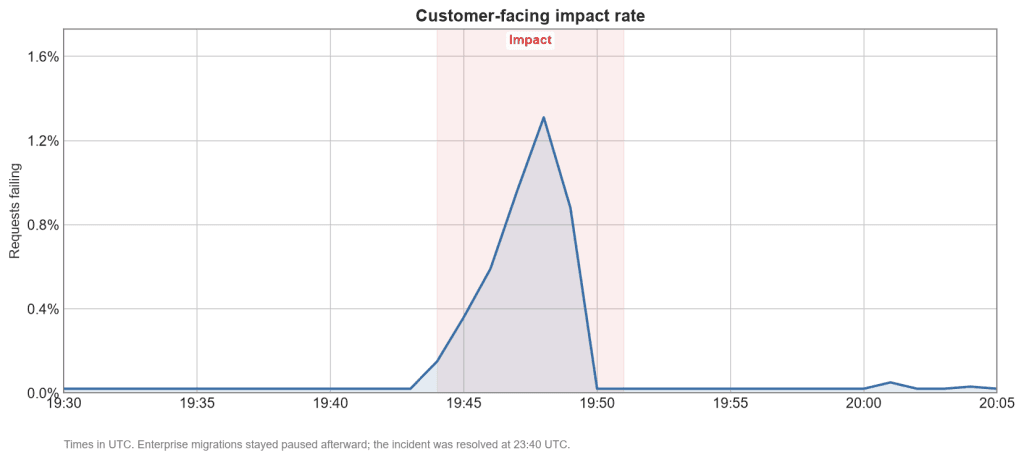
ระยะเวลา: ประมาณ 6 นาทีของคำร้องขอที่ล้มเหลวหรือล่าช้าใน github.com ตามด้วยเวลาประมาณ 3 ชั่วโมง 30 นาทีที่มีการระงับการย้ายข้อมูลขององค์กร
ลูกค้าอาจพบข้อผิดพลาดของเซิร์ฟเวอร์หรือการตอบสนองที่ล่าช้าเมื่อลงชื่อเข้าใช้, ทำงานกับ repository และ pull request, เรียกใช้ API หรือใช้ GitHub Codespaces การลองใหม่อีกครั้งในเวลาสั้นๆ จะสำเร็จ และการส่งมอบ webhook ที่ล่าช้าสามารถไล่ตามทันได้ในไม่ช้า ในช่วงสูงสุด คำร้องขอประมาณ 1.3% ล้มเหลวหรือหมดเวลา และองค์กรประมาณ 6.4 พันแห่งพบคำร้องขอที่ล้มเหลวหรือล่าช้าอย่างน้อยหนึ่งครั้ง
การย้ายข้อมูลถูกระงับสำหรับลูกค้าที่ใช้ GitHub Enterprise Importer และกลับมาทำงานต่อได้เมื่อมีการติดตั้งการแก้ไขแล้ว
เกิดอะไรขึ้นและทำไม?
กิจกรรมการย้ายข้อมูลที่พุ่งสูงขึ้นทำให้ GitHub Enterprise Importer ส่งคิวรีขนาดใหญ่จำนวนมากไปยังฐานข้อมูลที่ใช้ร่วมกัน คิวรีเหล่านี้ใช้เวลานานกว่าปกติมาก และเมื่อรวมกับทราฟฟิกปกติ จึงได้ใช้การเชื่อมต่อที่มีอยู่ทั้งหมดของฐานข้อมูล จนขัดขวางไม่ให้ฟีเจอร์อื่นๆ ของ github.com ที่พึ่งพาฐานข้อมูลเดียวกันนั้นดำเนินการตามคำร้องขอได้สำเร็จ
ตัวนำเข้าข้อมูลไม่ได้ลดภาระโหลดลงเมื่อฐานข้อมูลรับภาระเกินขีดจำกัด ผลกระทบสิ้นสุดลงภายในไม่กี่นาที เมื่อตัวนำเข้าประมวลผลคิวรีที่ค้างอยู่เสร็จและมีการคืนการเชื่อมต่อของฐานข้อมูล เพื่อป้องกันการเกิดซ้ำ เราได้ระงับการย้ายข้อมูลจนกว่าเราจะติดตั้งมาตรการบรรเทาที่เรียกใช้คิวรีเหล่านี้เป็นชุดย่อยๆ (smaller batches)
เราตอบสนองอย่างไร?
- กิจกรรมการย้ายข้อมูลที่พุ่งสูงขึ้นทำให้ฐานข้อมูลที่ใช้ร่วมกันรับภาระเกิน ส่งผลให้คำร้องขอใน github.com ล้มเหลวหรือช้าลง
- การตรวจสอบอัตโนมัติตรวจพบความล้มเหลวและแจ้งเตือนวิศวกรที่สแตนด์บายอยู่
- ข้อผิดพลาดหยุดลงเองภายในไม่กี่นาที
- เราได้ประกาศเหตุการณ์และระงับการย้ายข้อมูลขององค์กรเพื่อป้องกันการเกิดซ้ำในขณะที่เราตรวจสอบหาสาเหตุ
- เมื่อมีการติดตั้งมาตรการบรรเทาปัญหาแล้ว เราได้เริ่มการย้ายข้อมูลต่อและปิดเหตุการณ์
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เราได้ปรับปรุงคิวรีที่ GitHub Enterprise Importer ส่งไปยังฐานข้อมูลเพื่อให้แต่ละรายการมีขนาดเล็กและคงที่
- เรากำลังทำให้การถอยกลับ (backoff) ของตัวนำเข้าข้อมูลเป็นแบบอัตโนมัติเมื่อฐานข้อมูลมีความเครียดสูง เพื่อผ่อนคลายภาระโหลดก่อนที่จะส่งผลกระทบต่อบริการอื่นๆ ของ GitHub
- เรากำลังเพิ่มการแจ้งเตือนฐานข้อมูลที่จะระบุคิวรีที่ทำงานหนักเกินปกติและระบุว่าคิวรีใดเป็นผู้รับผิดชอบ เพื่อให้เราสามารถหาและแก้ไขปัญหาเช่นนี้ได้เร็วขึ้น
07 ตุลาคม 15:14 และ 17:17 UTC (ใช้เวลา 1 ชั่วโมง 11 นาที และ 47 นาที ตามลำดับ)
ระยะเวลา: การหยุดชะงักของการเขียน (write outages) แยกกันสองครั้งนานประมาณ 10 นาทีและ 9 นาที รวมประมาณ 19 นาที ครั้งที่สองเป็นการเกิดซ้ำของครั้งแรกด้วยสาเหตุเดียวกัน
ลูกค้าอาจพบข้อผิดพลาดเมื่อ push code, ลงชื่อเข้าใช้, อัปเดต pull request หรือ issue หรือทำการเปลี่ยนแปลงผ่าน API รวมถึง Webhooks, GitHub Apps และ OAuth, actions, code scanning, codespaces และ Copilot ก็ได้รับผลกระทบเช่นกัน การดูเนื้อหาส่วนใหญ่ไม่ได้รับผลกระทบ ข้อมูลที่บันทึกไปแล้วไม่สูญหาย และการดำเนินการที่ล้มเหลวระหว่างช่วงที่หยุดชะงักจะทำสำเร็จเมื่อลองใหม่หลังจากกู้คืนแล้ว
ความล้มเหลวของคำร้องขอ Web และ API พุ่งสูงสุดที่ 8.9% ในการหยุดชะงักครั้งแรก และ 9.3% ในครั้งที่สอง ส่งผลกระทบต่อองค์กรมากกว่า 12,000 แห่ง และ 11,000 แห่งตามลำดับ บางองค์กรอาจได้รับผลกระทบจากการหยุดชะงักทั้งสองครั้ง
เกิดอะไรขึ้นและทำไม?
ระหว่างการบำรุงรักษาตามปกติ เรารูปแบบการเปลี่ยนเครื่องที่จัดการตำแหน่งที่จะส่งการเขียนฐานข้อมูล เครื่องใหม่เครื่องหนึ่งเริ่มต้นทำงานด้วยบันทึกที่ล้าสมัยซึ่งยังคงแสดงรายชื่อเซิร์ฟเวอร์ฐานข้อมูลที่ปลดระวางแล้ว เมื่อมันได้รับเลือกเป็น leader โดยอัตโนมัติ มันได้เผยแพร่การตั้งค่าการกำหนดเส้นทางที่ส่งการเขียนสำหรับฐานข้อมูลหลักหลายตัวไปยังเซิร์ฟเวอร์ที่ปลดระวางเหล่านั้น การตั้งค่าที่ไม่ถูกต้องผ่านการตรวจสอบที่มีอยู่ของเราและมีผลทันที ต่อมา งานบำรุงรักษาอัตโนมัติไม่ได้ทำตามการสั่งระงับการบำรุงรักษาและกระตุ้นให้เกิดการเลือก leader อีกครั้ง และเนื่องจากเครื่องใหม่ยังไม่ได้ถูกนำออก มันจึงกลายเป็น leader อีกครั้ง
เราตอบสนองอย่างไร?
- การตรวจสอบอัตโนมัติแจ้งเตือนเราเกี่ยวกับความล้มเหลวของการเขียน และเราได้ประกาศเหตุการณ์
- การเขียนได้รับการกู้คืนเมื่อเครื่องเดิมที่มีบันทึกที่ถูกต้องกลายเป็น leader และเผยแพร่การตั้งค่าที่ถูกต้อง
- เราพบสาเหตุว่ามาจากเครื่องใหม่ จึงปิดเหตุการณ์แรก และระงับการบำรุงรักษาอัตโนมัติเพื่อป้องกันการเกิดซ้ำ
- เมื่อมีงานบำรุงรักษาไม่ปฏิบัติตามการระงับและเหตุการณ์เกิดขึ้นซ้ำ เราได้ประกาศเหตุการณ์ที่สอง
- การเขียนได้รับการกู้คืนเมื่อเครื่องเดิมกลายเป็น leader อีกครั้ง เราได้นำเครื่องใหม่ออกและปิดเหตุการณ์ที่สอง
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เราได้ปรับปรุงวิธีการปลดระวางเซิร์ฟเวอร์ฐานข้อมูล เพื่อไม่ให้หลงเหลือบันทึกที่ล้าสมัย
- เราได้เพิ่มการควบคุมในการเพิ่มเครื่องใหม่ที่จัดการการกำหนดเส้นทางฐานข้อมูล และตรวจสอบให้แน่ใจว่าการบำรุงรักษาอัตโนมัติปฏิบัติตามคำสั่งระงับ
- เราได้เสริมความแข็งแกร่งในการตรวจสอบการตั้งค่าการกำหนดเส้นทางฐานข้อมูล เพื่อให้จับการตั้งค่าที่ไม่ถูกต้องได้ก่อนที่จะมีผล
19 ตุลาคม 15:49 UTC (ใช้เวลา 1 ชั่วโมง 7 นาที)
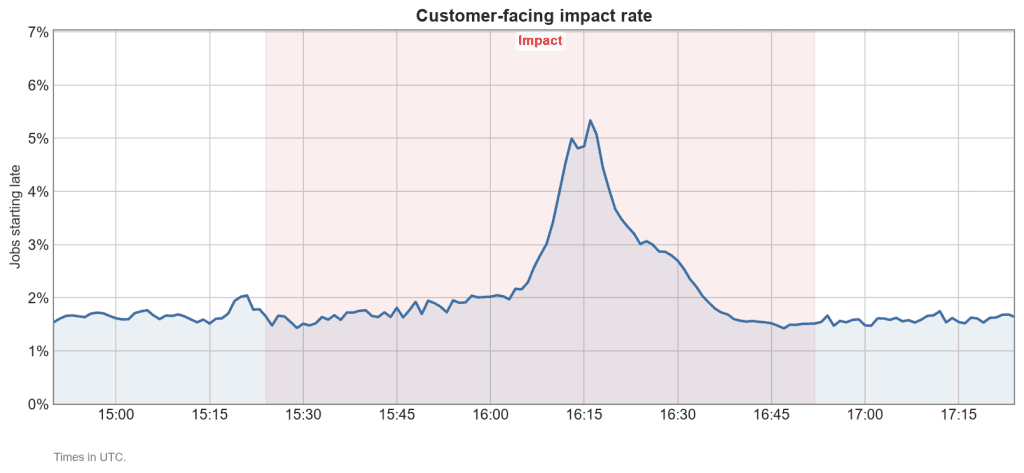
ระยะเวลา: ประมาณ 1 ชั่วโมง 28 นาที
ลูกค้าอาจเห็นความล่าช้าในการอัปเดตสถานะ GitHub Actions workflow, logs และ checks งานประมาณ 5% บน GitHub-hosted runners ประสบปัญหาการเริ่มต้นที่ล่าช้า ส่วนน้อยมากของ workflow runs ล้มเหลว และบางคำร้องขอไปยัง REST API ของงาน actions คืนค่าเป็นข้อผิดพลาด การติดตั้ง GitHub Pages และเหตุการณ์ webhook ของ workflow และ check ที่สร้างโดยการรัน actions ก็ล่าช้าเช่นกัน ในช่วงเวลานี้ การอัปเดตแบบสดบน github.com และ code search ก็ลดประสิทธิภาพลง
เกิดอะไรขึ้นและทำไม?
บริการ actions ภายในที่จัดเก็บ workflow logs และสถานะการทำงานสูญเสียการเชื่อมต่อกับ cache servers บางส่วนในภูมิภาคคลาวด์แห่งหนึ่ง ทุกเซิร์ฟเวอร์ที่รันบริการนั้นพยายามเชื่อมต่อใหม่พร้อมกัน การพยายามเชื่อมต่อใหม่เหล่านั้นร่วมกันทำให้การเชื่อมต่อเครือข่ายระหว่างศูนย์ข้อมูลของ GitHub และภูมิภาคนั้นเต็มขีดจำกัด (saturated) ซึ่งขัดขวางบริการอื่นที่ใช้ลิงก์เดียวกัน
เราตอบสนองอย่างไร?
- การแจ้งเตือนอัตโนมัติตรวจพบความล้มเหลว เราได้ประกาศเหตุการณ์และพบร่องรอยปัญหาไปยังลิงก์เครือข่ายที่ใช้ร่วมกัน
- เรากำหนดเส้นทางบริการ actions ออกจาก cache servers บางส่วนในภูมิภาคนั้น แต่ลิงก์ยังคงรับภาระเกินความจุ
- เรากำหนดเส้นทางออกจาก cache servers ที่เหลือทั้งหมดในภูมิภาคนั้น และลิงก์ได้รับการกู้คืน
- เราเพิ่มขีดจำกัดการประมวลผลเพื่อล้างงาน actions ที่ค้างอยู่ และเราปิดเหตุการณ์เมื่อบริการทั้งหมดที่ได้รับผลกระทบกู้คืนแล้ว
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เราได้จำกัดความเร็วที่บริการ actions นี้สามารถเปิดการเชื่อมต่อใหม่ไปยัง cache servers ของมัน
- เรากำลังแจ้งเตือนเมื่อพบการพุ่งสูงขึ้นของการเชื่อมต่อใหม่จากบริการนี้เพื่อระบุและจัดการต้นเหตุได้เร็วขึ้น
21 ตุลาคม 14:52 UTC (ใช้เวลา 4 ชั่วโมง 30 นาที)
ระยะเวลา: ประมาณ 6 ชั่วโมง 46 นาที
ลูกค้าอาจเห็นความล่าช้าในการอัปเดต pull request, การอัปเดตสถานะ GitHub Actions workflow และการส่งมอบ webhook หลังการ push คอมมิตใหม่จะปรากฏบน pull request ช้า workflow ที่ถูกกระตุ้นโดยการ push เริ่มทำงานล่าช้า Status checks จาก actions workflows อาจดูเหมือนค้างบน pull request ซึ่งทำให้การ merge ที่ต้องการให้ check เหล่านั้นผ่านต้องรอค้างไว้ ฟีเจอร์เหล่านี้กู้คืนได้ภายในประมาณ 2 ถึง 3.5 ชั่วโมง
เหตุการณ์ใน Audit log ได้รับผลกระทบนานที่สุด กิจกรรมล่าสุดใช้เวลานานขึ้นในการปรากฏเมื่อลูกค้าค้นหา audit logs โดยมีความล่าช้าสูงสุด 1 ชั่วโมง 50 นาที เหตุการณ์ใน Audit log ไล่ตามทันได้ครบถ้วนหลังจากผ่านไปประมาณ 6 ชั่วโมง 46 นาที
การส่งมอบ webhook บางรายการจากช่วงเวลานี้อาจหายไปจากประวัติการส่งมอบ webhook แม้ว่าตัว webhook เองจะถูกส่งไปแล้วก็ตาม
เกิดอะไรขึ้นและทำไม?
เซิร์ฟเวอร์บางตัวในแพลตฟอร์ม event streaming ของเรามีหน่วยความจำใกล้เต็มขีดจำกัด และการใช้หน่วยความจำบนเซิร์ฟเวอร์เหล่านี้จะเพิ่มขึ้นตามจำนวนการเชื่อมต่อของ client เมื่อคำร้องขอไปยังเซิร์ฟเวอร์เหล่านี้ล้มเหลว การเชื่อมต่อใหม่จะถูกเปิดขึ้นทันที ซึ่งไปเพิ่มจำนวนการเชื่อมต่อและหน่วยความจำที่ใช้ การเพิ่มขึ้นของหน่วยความจำทำให้เซิร์ฟเวอร์ทำงานช้าลงและรับภาระเกิน
เราได้นำเซิร์ฟเวอร์ที่รับภาระเกินออกจากระบบ และทราฟฟิกของพวกมันถูกย้ายไปยังเซิร์ฟเวอร์อื่น จากนั้นเซิร์ฟเวอร์เหล่านั้นก็รับภาระเกินเช่นกัน และปัญหาลุกลามไปยังเซิร์ฟเวอร์มากขึ้นในชั่วโมงต่อมา เราเริ่มปรับสมดุล (rebalancing) partition ที่รับภาระหนักไปยัง brokers ที่มีพื้นที่ว่าง ซึ่งช่วยบรรเทาปัญหานี้
Audit logs ใช้เวลานานที่สุดในการกู้คืน บริการที่เขียนเหตุการณ์ audit log รีสตาร์ทตัวเองซ้ำๆ จากข้อผิดพลาดของแพลตฟอร์มเป็นเวลามากกว่าสองชั่วโมงและตามหลังอยู่มากขึ้น เมื่อเริ่มเสถียรแล้ว มันสามารถเขียนเหตุการณ์ได้ในอัตราที่จำกัด ดังนั้นงานที่ค้างสะสมจึงใช้เวลาอีกหลายชั่วโมงในการล้างออก
เราตอบสนองอย่างไร?
- เราได้ประกาศเหตุการณ์และย้ายทราฟฟิกบางส่วนออกจากเซิร์ฟเวอร์ที่รับภาระเกิน แต่เซิร์ฟเวอร์เพิ่มขึ้นเรื่อยๆ ที่รับภาระเกินหลังจากนั้นไม่นาน
- เราแบ่งทราฟฟิกที่หนาแน่นที่สุดออกเป็น partition มากขึ้นและย้ายไปยังเซิร์ฟเวอร์ที่ภาระน้อยกว่า ฟีเจอร์ทั้งหมดที่ได้รับผลกระทบยกเว้น audit logs ค่อยๆ กู้คืน
- เมื่อบริการ audit log หยุดรีสตาร์ท เราได้เพิ่มอัตราการเขียนเหตุการณ์เพื่อให้งานค้างสะสมถูกล้างได้เร็วขึ้น
- เราปิดเหตุการณ์เมื่อความล่าช้าของ audit log กลับมาอยู่ในช่วงที่ปกติ และงานค้างที่เหลือถูกล้างออกหลังจากนั้น
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เราได้เพิ่มการสุ่มเวลาดีเลย์ในการเชื่อมต่อใหม่หลังจากคำร้องขอพลาเพื่อไม่ให้เซิร์ฟเวอร์ที่ช้าอยู่แล้วถูกกระหน่ำด้วยการเชื่อมต่อใหม่จำนวนมาก
- เรากำลังแจ้งเตือนการใช้หน่วยความจำเซิร์ฟเวอร์ให้เร็วขึ้น เพื่อให้เราย้ายทราฟฟิกได้ก่อนเซิร์ฟเวอร์จะทำงานช้าลง
- เรากำลังเพิ่มปลายทางที่สองสำหรับข้อมูลการส่งมอบ webhook ที่เราสามารถสลับไปใช้ได้ เพื่อให้การส่งมอบ webhook ดำเนินต่อไปได้หากแพลตฟอร์ม event streaming ของเราช้าลง
- เราได้ปรับปรุงคู่มือปฏิบัติงาน (playbooks) เพื่อย้าย hot partitions สำหรับสถานการณ์ที่คล้ายคลึงกันในอนาคต
28 ตุลาคม 14:12 UTC (ใช้เวลา 1 ชั่วโมง 16 นาที)
ระยะเวลา: ประมาณ 1 ชั่วโมง 32 นาที
ลูกค้าอาจพบข้อผิดพลาดเมื่อใช้โมเดลในตระกูล GPT หลายตัวใน Copilot คำร้องขอที่ใช้โมเดลเหล่านี้ใน Copilot Chat ใน IDE และใน github.com, Copilot CLI, Copilot code review และ Copilot coding agent คืนค่าเป็นข้อผิดพลาดหรือไม่สำเร็จ ประมาณ 1 ใน 10 ของคำร้องขอไปยังโมเดลที่ได้รับผลกระทบล้มเหลว โมเดลอื่นยังคงทำงานได้ และการเลือกโมเดลอื่นสามารถหลีกเลี่ยงข้อผิดพลาดได้ การเลือกโมเดลอัตโนมัติช่วยลดข้อผิดพลาดโดยส่งคำร้องขอบางส่วนไปยังโมเดลที่ไม่ได้รับผลกระทบ
Code scanning autofix และ code quality ซึ่งสร้างขึ้นบนโมเดลเฉพาะตัวหนึ่งโดยไม่มีโมเดลทางเลือกให้สลับไปใช้ ได้รับผลกระทบหนักกว่า
เกิดอะไรขึ้นและทำไม?
Copilot เข้าถึงโมเดลเหล่านี้ผ่านผู้ให้บริการโมเดลต้นทางและใช้ credential ในการพิสูจน์ตัวตนกับผู้ให้บริการรายนั้น credential ดังกล่าวใช้งานไม่ได้ ผู้ให้บริการจึงเริ่มปฏิเสธคำร้องขอของเราว่าไม่ได้พิสูจน์ตัวตน และบริการของเราได้ส่งการปฏิเสธเหล่านั้นกลับไปยัง client เป็นข้อผิดพลาดในการตรวจสอบสิทธิ์ ฟีเจอร์ Copilot ที่ใช้โมเดลเหล่านี้ส่งคำร้องขอผ่านผู้ให้บริการรายนั้น ดังนั้นจึงเริ่มล้มเหลวพร้อมกัน
เราตอบสนองอย่างไร?
- credential ที่เราใช้กับผู้ให้บริการโมเดลต้นทางหยุดทำงาน และคำร้องขอไปยังโมเดลที่ได้รับผลกระทบเริ่มล้มเหลว
- การแจ้งเตือนระบุถึงข้อผิดพลาดที่เพิ่มขึ้นในโมเดลที่ได้รับผลกระทบ และเราได้ประกาศเหตุการณ์
- เราได้โพสต์อัปเดตสถานะสาธารณะและแนะนำให้เลือกโมเดลอื่นชั่วคราว
- เราพบร่องรอยข้อผิดพลาดว่ามาจาก credential ของเราเองและได้สร้างอันใหม่มาทดแทน
- เราเริ่มติดตั้ง credential ใหม่ และคำร้องขอเริ่มได้รับการกู้คืนทันทีที่มีการอัปเดตสภาพแวดล้อมแรก
- เราติดตั้งจนครบในสภาพแวดล้อมที่เหลือ ยืนยันว่าคำร้องขอไปยังโมเดลที่ได้รับผลกระทบกู้คืนแล้ว และปิดเหตุการณ์
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- เราได้ปรับปรุงวิธีที่บริการของเราจัดการกับความล้มเหลวในการพิสูจน์ตัวตนจากผู้ให้บริการโมเดลต้นทาง เพื่อให้สามารถลองใหม่ได้แทนที่จะล้มเหลวไปเลย
- เรากำลังเสริมสร้างการจัดการ credential สำหรับผู้ให้บริการโมเดลต้นทางให้แข็งแกร่งขึ้น
- เรากำลังเพิ่มการแจ้งเตือนสำหรับความล้มเหลวในการพิสูจน์ตัวตนจากผู้ให้บริการโมเดลต้นทาง เพื่อให้เราสามารถระบุและจัดการปัญหาประเภทนี้ได้เร็วขึ้น
30 ตุลาคม 14:31 UTC (ใช้เวลา 31 นาที)
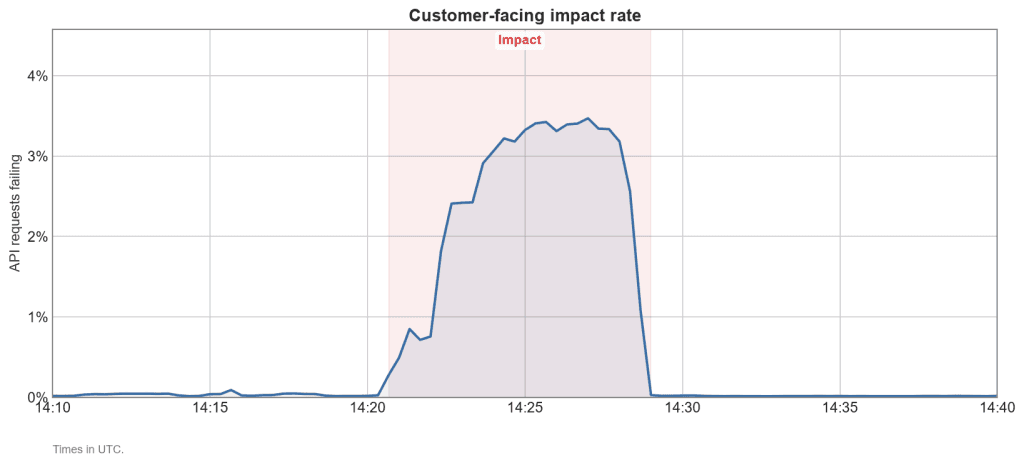
ระยะเวลา: ประมาณ 9 นาที
ลูกค้าอาจเห็นคำร้องขอบางรายการไปยัง github.com ค้างนานถึง 10 วินาทีแล้วล้มเหลวด้วยข้อผิดพลาดของเซิร์ฟเวอร์ การ merge pull request และการทำงานของ Git ผ่าน SSH และ Git LFS ได้รับผลกระทบหนักที่สุด ณ จุดที่แย่ที่สุด ประมาณ 43% ของความพยายาม merge ล้มเหลว เมื่อเทียบกับประมาณ 3.5% ของการเรียก API นอกจากนี้ Issues, GitHub Pages, การแจ้งเตือน และการลงชื่อเข้าใช้สำหรับ GitHub Apps และ OAuth apps ยังพบข้อผิดพลาดเป็นช่วงๆ
เกิดอะไรขึ้นและทำไม?
database connection pool ที่ใช้โดยบริการของ github.com หลายอย่างเต็มขีดจำกัด และในช่วงเวลาไม่กี่นาทีไม่มีการเชื่อมต่อพร้อมใช้งาน คำร้องขอใหม่ที่ต้องการการเชื่อมต่อต้องรอจนกว่าจะหมดเวลาเชื่อมต่อแล้วจึงล้มเหลว
pool ทำงานใกล้ความจุอยู่แล้วเมื่อมีคำร้องขออัปเดตบางส่วนเริ่มถือครองการเชื่อมต่อไว้นานกว่าที่คาดไว้มาก แต่ละรายการเริ่มเขียนการเปลี่ยนแปลง จากนั้นทำการค้นหาข้อมูล (lookup) แยกต่างหากที่อาจใช้เวลาหลายวินาที ทำให้การเชื่อมต่อถูกจองไว้แต่ไม่ได้ใช้งานตลอดเวลานั้น ด้วยพื้นที่ว่างที่เหลือน้อย การเชื่อมต่อที่ถูกถือครองไว้นั้นจึงมีส่วนทำให้ pool รับไม่ไหว
เราตอบสนองอย่างไร?
- คำร้องขอใช้การเชื่อมต่อใน shared database pool จนหมด และคำร้องขอทั่ว github.com เริ่มล้มเหลว
- เราประกาศเหตุการณ์หลังจากพบความล้มเหลว และวิศวกรสแตนด์บายสำหรับบริการที่ได้รับผลกระทบถูกแจ้งเตือน
- pool ถูกระบายออกและอัตราข้อผิดพลาดกลับสู่ภาวะปกติ หลังจากนั้นไม่นาน เรายืนยันได้ว่า connection pool ที่เต็มเป็นสาเหตุของข้อผิดพลาดและได้โพสต์อัปเดตสถานะสาธารณะ
- เราตรวจสอบแล้วว่าการเชื่อมต่อฐานข้อมูลกลับสู่สภาวะปกติและปิดเหตุการณ์หลังจากเฝ้าติดตามความเสถียร
เราจะทำให้เหตุการณ์เช่นนี้มีโอกาสเกิดขึ้นน้อยลงหรือลดผลกระทบได้อย่างไร?
- ขณะนี้เรากำลังรันการ lookup ที่ช้าก่อนที่คำร้องขออัปเดตเหล่านี้จะเริ่มเขียนการเปลี่ยนแปลง เพื่อไม่ให้ถือครองการเชื่อมต่อฐานข้อมูลในขณะที่รออีกต่อไป
- เรากำลังประเมินการจำกัดระยะเวลาที่สามารถถือครอง pooled database connection ได้ เพื่อให้รูปแบบคำร้องขอที่ช้ามีโอกาสน้อยลงที่จะไปผูกมัด pool ไว้
ติดตาม หน้าสถานะ ของเราเพื่อดูการอัปเดตตามเวลาจริงเกี่ยวกับการเปลี่ยนแปลงสถานะและสรุปเหตุการณ์หลังเกิดเรื่อง หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับสิ่งที่เรากำลังดำเนินการอยู่ โปรดดูส่วนวิศวกรรมใน GitHub Blog
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร