
Anthropic เปิดตัว Claude 4 ยกระดับการเขียนโค้ดและ AI Agents
วันนี้ เราขอแนะนำโมเดล Claude รุ่นถัดไป ได้แก่ Claude Opus 4 และ Claude Sonnet 4 ซึ่งเป็นการสร้างมาตรฐานใหม่สำหรับการเขียนโค้ด (coding), การใช้เหตุผลขั้นสูง (advanced reasoning) และ AI agents
Claude Opus 4 คือโมเดลสำหรับการเขียนโค้ดที่ดีที่สุดในโลก ด้วยประสิทธิภาพที่คงเส้นคงวาในงานที่ซับซ้อนและใช้เวลานาน รวมถึงเวิร์กโฟลว์ของ agent ส่วน Claude Sonnet 4 คือการอัปเกรดครั้งสำคัญจาก Claude Sonnet 3.7 โดยเพิ่มความสามารถในการเขียนโค้ดและการใช้เหตุผลที่เหนือกว่า พร้อมตอบสนองต่อคำสั่งได้อย่างแม่นยำยิ่งขึ้น
นอกเหนือจากตัวโมเดลแล้ว เรายังประกาศฟีเจอร์สำคัญดังนี้:
การคิดแบบขยายระยะเวลาพร้อมการใช้เครื่องมือ (Extended thinking with tool use - beta): ทั้งสองโมเดลสามารถใช้เครื่องมือต่างๆ เช่น web search ในระหว่างการคิดแบบขยายระยะเวลา ช่วยให้ Claude สามารถสลับไปมาระหว่างการใช้เหตุผลและการใช้เครื่องมือเพื่อปรับปรุงคำตอบให้ดีขึ้น ความสามารถใหม่ของโมเดล: ทั้งสองโมเดลสามารถใช้เครื่องมือแบบขนานกัน (parallel) ปฏิบัติตามคำสั่งได้แม่นยำขึ้น และเมื่อนักพัฒนาอนุญาตให้เข้าถึงไฟล์ในเครื่อง โมเดลจะแสดงให้เห็นถึงความสามารถด้านความจำที่ปรับปรุงขึ้นอย่างมาก โดยการสกัดและบันทึกข้อเท็จจริงสำคัญเพื่อรักษาความต่อเนื่องและสร้างความรู้เชิงลึก (tacit knowledge) เมื่อเวลาผ่านไป Claude Code เปิดใช้งานทั่วไปแล้ว: หลังจากได้รับผลตอบรับเชิงบวกอย่างล้นหลามในช่วง preview สำหรับการวิจัย เราได้ขยายวิธีการที่นักพัฒนาสามารถทำงานร่วมกับ Claude โดยตอนนี้ Claude Code รองรับงานเบื้องหลังผ่าน GitHub Actions และการรวมเข้ากับ VS Code และ JetBrains แบบ native ซึ่งจะแสดงการแก้ไขโดยตรงในไฟล์ของคุณเพื่อการทำ pair programming ที่ราบรื่น ความสามารถใหม่ของ API: เรากำลังปล่อย ความสามารถใหม่สี่ประการ บน API ของเราที่ช่วยให้นักพัฒนาสามารถสร้าง AI agents ที่ทรงพลังยิ่งขึ้น ได้แก่ เครื่องมือประมวลผลโค้ด (code execution tool), MCP connector, Files API และความสามารถในการทำ cache สำหรับ prompt ได้นานถึงหนึ่งชั่วโมง
Claude Opus 4 และ Sonnet 4 เป็นโมเดลแบบไฮบริดที่มีให้เลือกสองโหมด คือการตอบสนองแบบเกือบจะทันที และการคิดแบบขยายระยะเวลาเพื่อการใช้เหตุผลที่ลึกซึ้งยิ่งขึ้น โดยแผนบริการ Claude Pro, Max, Team และ Enterprise จะรวมทั้งสองโมเดลนี้ไว้ด้วย ส่วน Sonnet 4 จะเปิดให้ผู้ใช้ฟรีใช้งานได้เช่นกัน
โมเดลทั้งสองมีให้บริการบน API ของเรา, Amazon Bedrock และ Google Cloud's Vertex AI โดยราคาจะยังคงเดิมเหมือนกับรุ่นก่อนหน้า คือ Opus 4 อยู่ที่ $15/$75 ต่อล้าน tokens (input/output) และ Sonnet 4 อยู่ที่ $3/$15
Claude 4
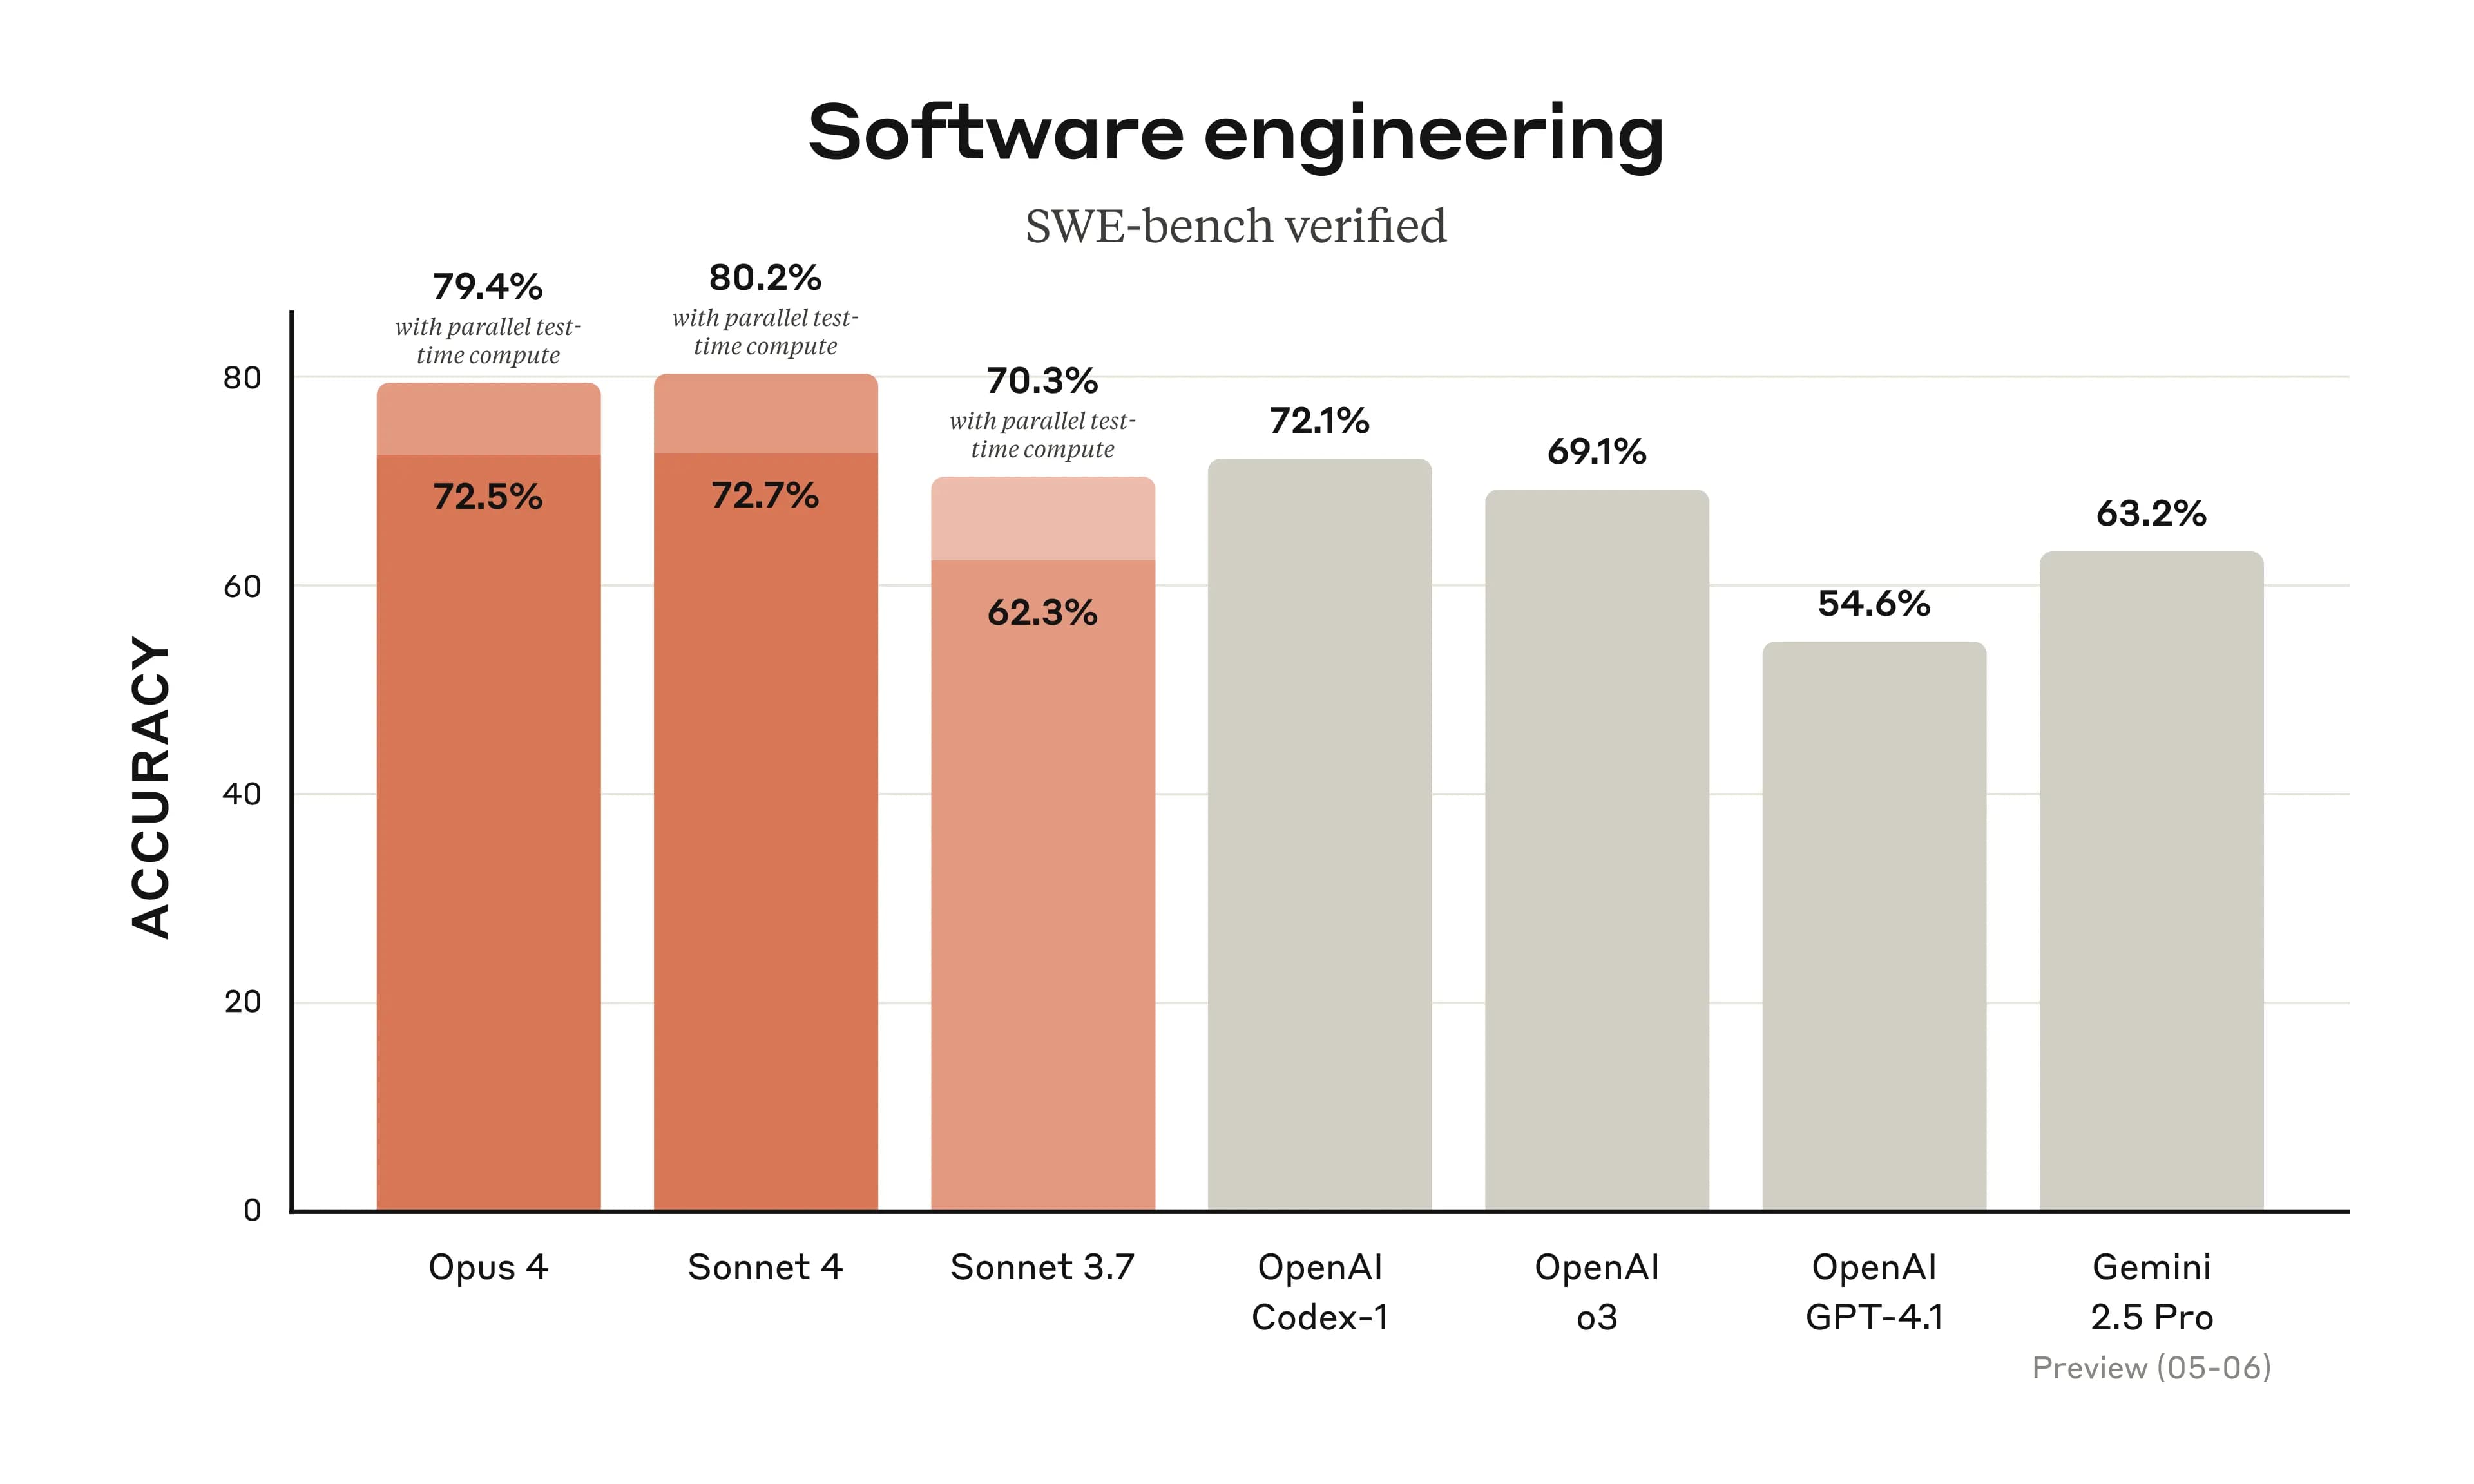
Claude Opus 4 เป็นโมเดลที่ทรงพลังที่สุดและเป็นโมเดลเขียนโค้ดที่ดีที่สุดในโลก โดยเป็นผู้นำใน SWE-bench (72.5%) และ Terminal-bench (43.2%) มอบคุณภาพงานที่คงเส้นคงวาในงานที่ต้องใช้ความพยายามสูงและมีขั้นตอนนับพัน สามารถทำงานต่อเนื่องได้นานหลายชั่วโมง ซึ่งทำได้เหนือกว่าโมเดล Sonnet ทุกรุ่นอย่างชัดเจน และขยายขอบเขตสิ่งที่ AI agents สามารถทำได้อย่างมีนัยสำคัญ
ประสิทธิภาพของ Claude Opus 4 ได้รับการยอมรับจากพันธมิตรชั้นนำมากมาย Cursor ยกให้เป็นระดับแนวหน้า (state-of-the-art) ในการทำความเข้าใจฐานโค้ด (codebase) ที่ซับซ้อน Replit พบความแม่นยำที่เพิ่มขึ้นในการแก้ไขไฟล์จำนวนมากพร้อมกัน ในขณะที่ Block เลือกใช้ใน agent codename goose เพราะช่วยเพิ่มคุณภาพโค้ดระหว่างดีบั๊กได้อย่างน่าเชื่อถือ
ทางด้าน Rakuten ยืนยันความสามารถจากการทำ refactor โอเพนซอร์สที่ท้าทายได้สำเร็จโดยทำงานอิสระนาน 7ชั่วโมง และ Cognition ระบุว่า Opus 4 โดดเด่นในการแก้ปัญหาซับซ้อนที่โมเดลอื่นทำไม่ได้ โดยสามารถจัดการการดำเนินงานสำคัญที่โมเดลก่อนหน้านี้เคยทำพลาด
สำหรับ Claude Sonnet 4 ได้รับการปรับปรุงจาก Sonnet 3.7 อย่างมาก โดยทำคะแนนได้ถึง 72.7% บน SWE-bench โมเดลนี้รักษาสมดุลระหว่างประสิทธิภาพและความคุ้มค่า พร้อมการควบคุม (steerability) ที่ดียิ่งขึ้น แม้ภาพรวมจะไม่ได้เทียบเท่า Opus 4 ในทุกด้าน แต่ก็นับว่าเป็นจุดที่ลงตัวที่สุดระหว่างความสามารถและการนำไปใช้งานจริง
GitHub ระบุว่า Claude Sonnet 4 จะเป็นขุมพลังให้ coding agent ตัวใหม่ใน GitHub Copilot ด้าน Manus เน้นย้ำเรื่องการทำตามคำสั่งซับซ้อนและให้ผลลัพธ์ที่สวยงาม ส่วน iGent พบว่าช่วยลดข้อผิดพลาดในการนำทางฐานโค้ดจาก 20% จนเกือบเป็นศูนย์ Sourcegraph และ Augment Code ต่างเห็นตรงกันว่าโมเดลนี้คือการก้าวกระโดดของการพัฒนาซอฟต์แวร์ที่ช่วยให้จดจ่อกับงานได้นานและแม่นยำขึ้น
โมเดลเหล่านี้ช่วยขับเคลื่อนกลยุทธ์ AI ในทุกมิติ โดย Opus 4 จะเน้นงานวิจัยและการค้นพบทางวิทยาศาสตร์ ส่วน Sonnet 4 จะรองรับกรณีการใช้งานทั่วไปในฐานะการอัปเกรดที่ทรงประสิทธิภาพ
การปรับปรุงโมเดล
นอกจากการคิดแบบขยายระยะเวลาและการปรับปรุงหน่วยความจำ เราได้ลดพฤติกรรมที่โมเดลใช้ทางลัด (shortcuts) หรือช่องโหว่ (loopholes) ลงอย่างมาก โดยทั้งสองโมเดลมีโอกาสเกิดพฤติกรรมดังกล่าวน้อยลง 65% เมื่อเทียบกับ Sonnet 3.7 ในงานประเภท agentic
Claude Opus 4 ยังมีประสิทธิภาพหน่วยความจำที่เหนือกว่ารุ่นเดิมอย่างเห็นได้ชัด เมื่อนักพัฒนาอนุญาตให้เข้าถึงไฟล์ในเครื่อง โมเดลจะสามารถสร้างและรักษา 'ไฟล์หน่วยความจำ' เพื่อเก็บข้อมูลสำคัญ ช่วยให้มีความตระหนักในงานระยะยาวและความสอดคล้องของงาน agent ดียิ่งขึ้น เช่น การสร้าง 'Navigation Guide' ระหว่างการเล่นเกม Pokémon
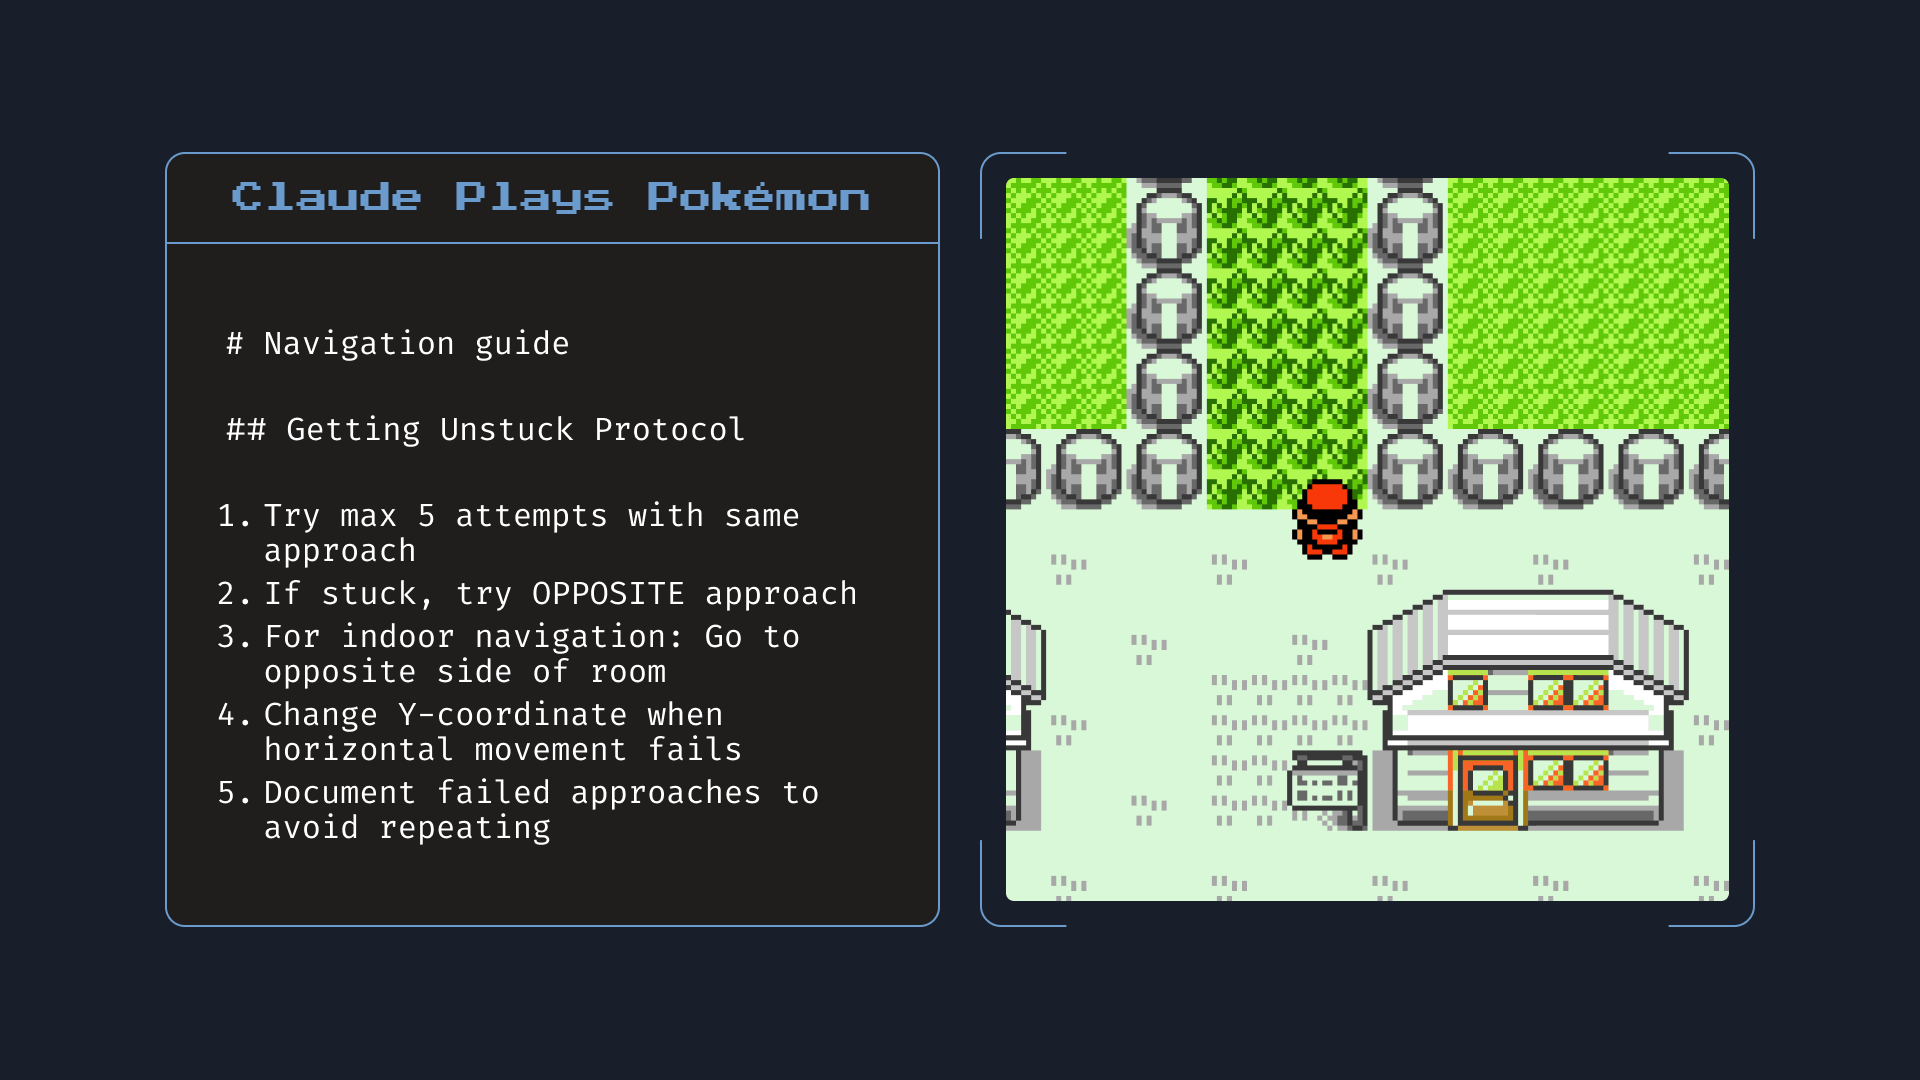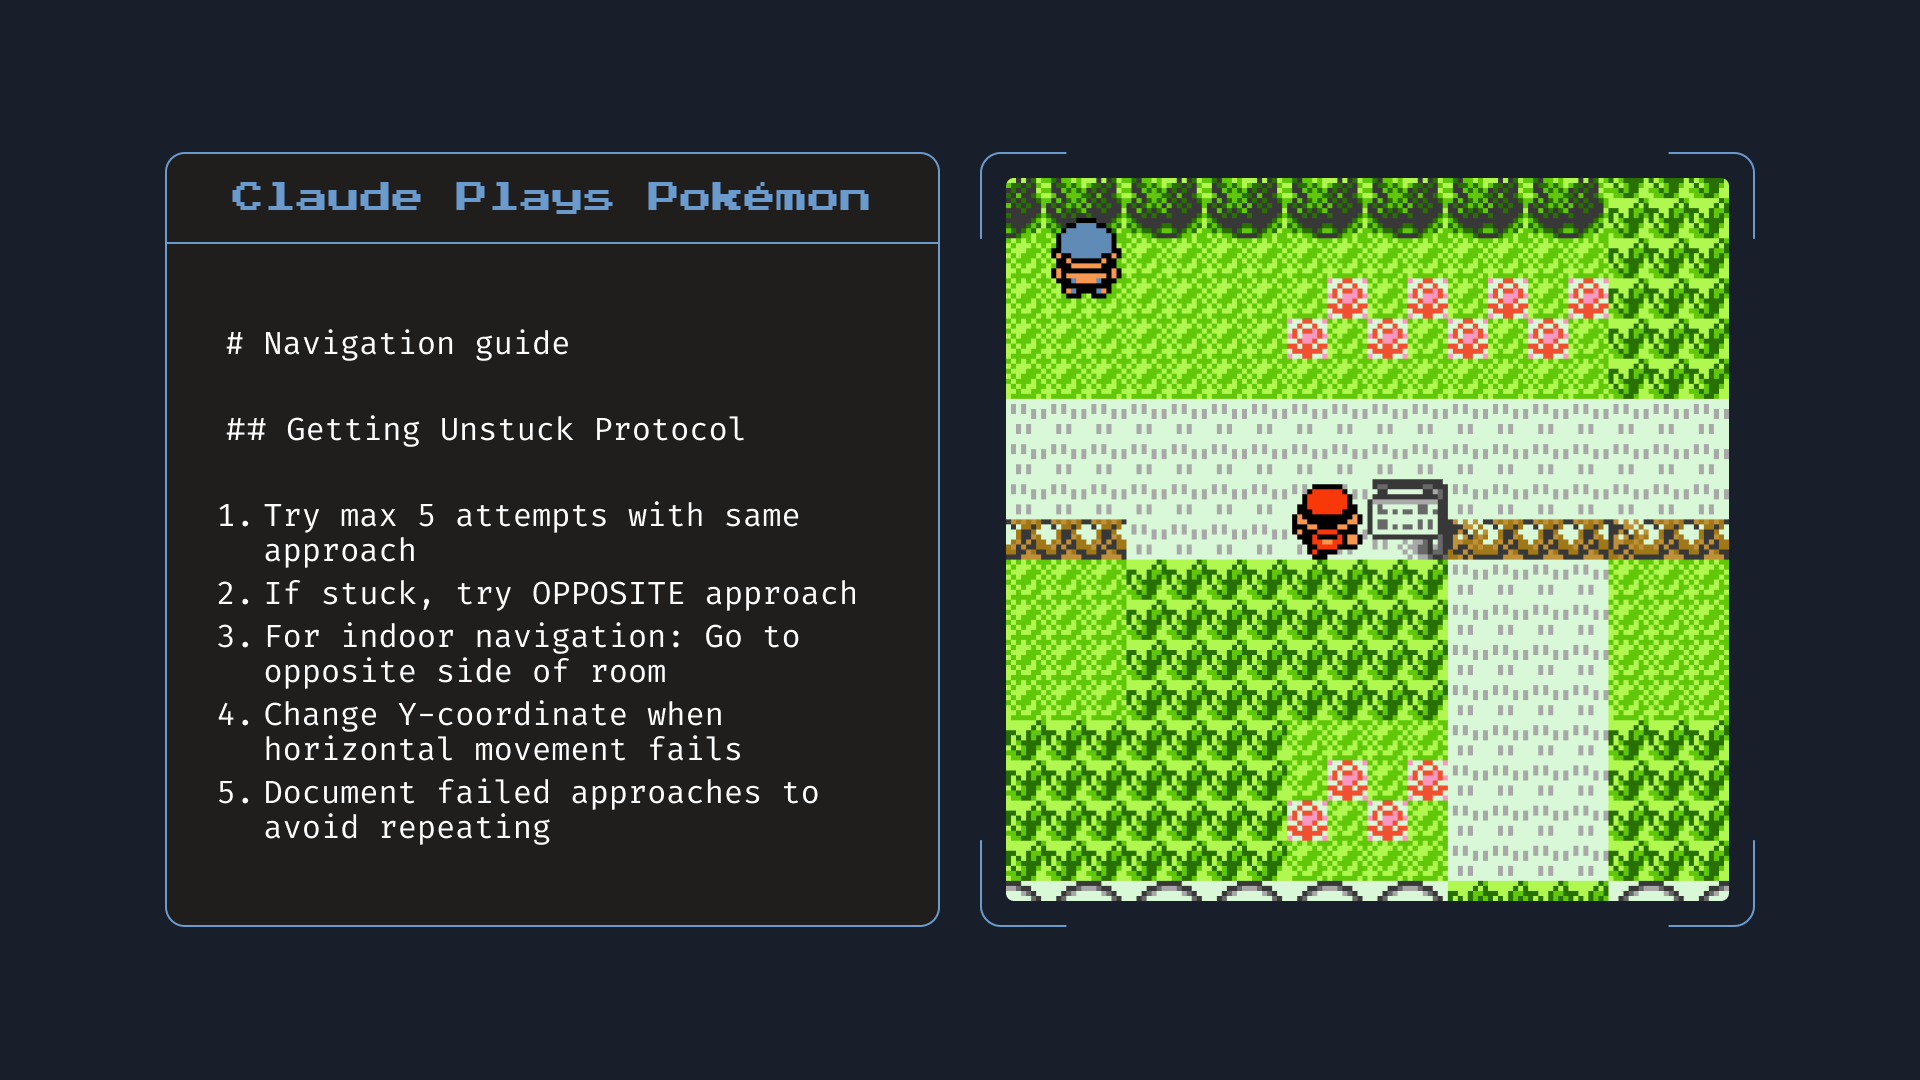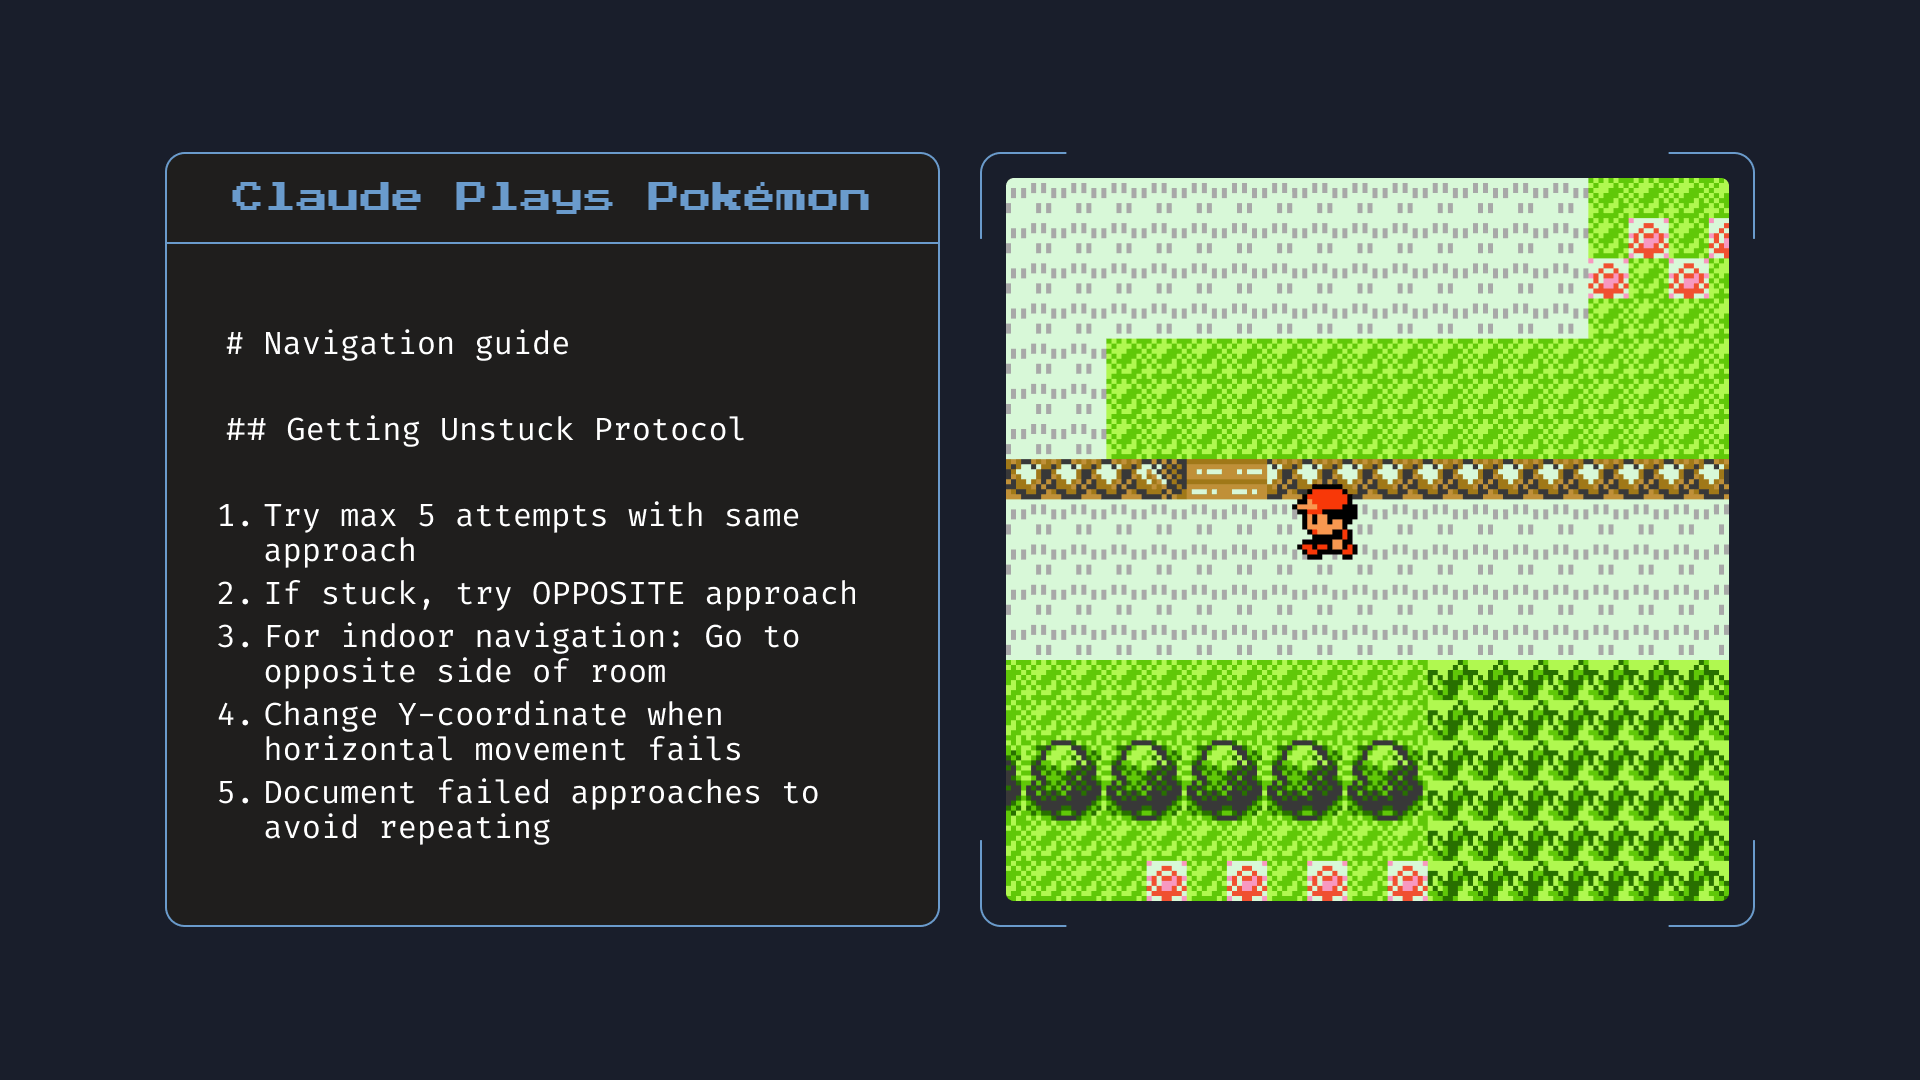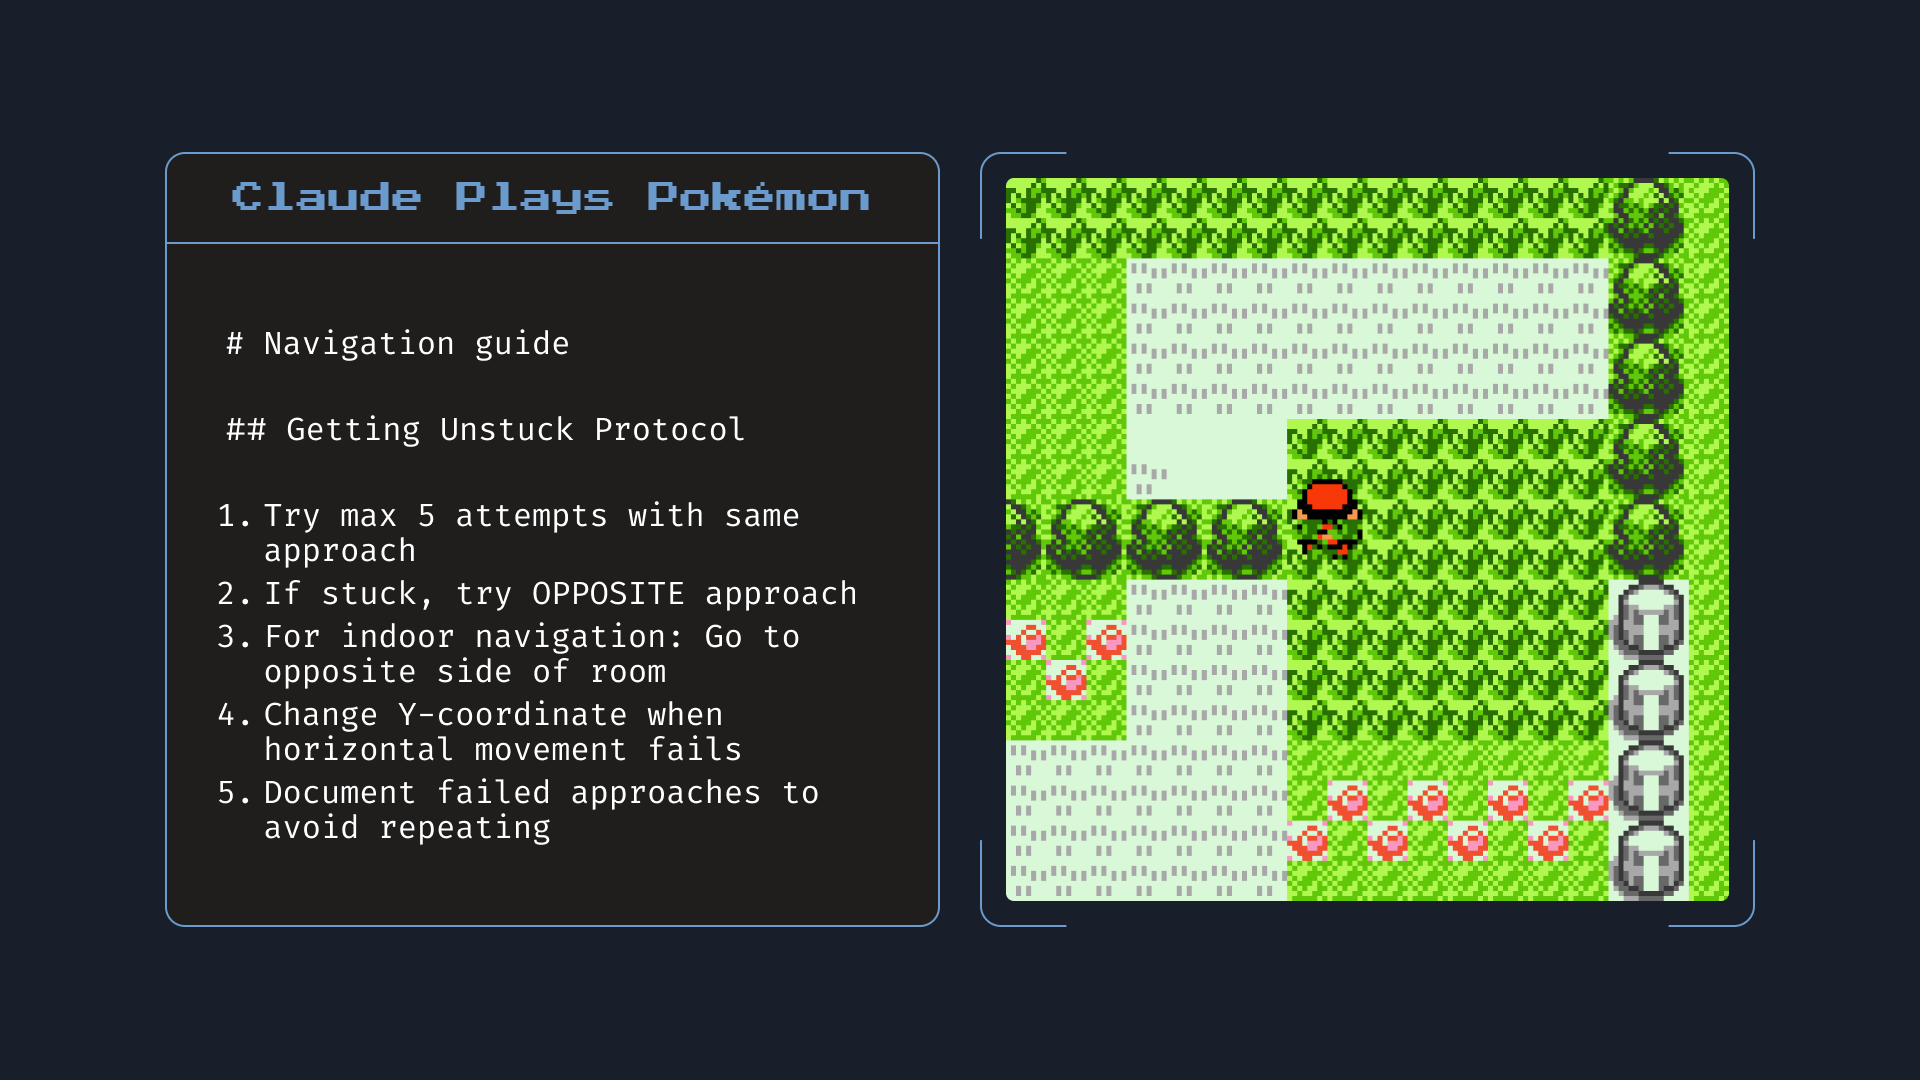
นอกจากนี้ เราได้เปิดตัวการสรุปความคิด (thinking summaries) ที่ใช้โมเดลขนาดเล็กมาย่อยกระบวนการคิดที่ยาวเหยียด ซึ่งช่วยประหยัดเวลาได้มาก ส่วนผู้ที่ต้องการสายธารความคิด (chains of thought) แบบละเอียดเพื่อการทำ prompt engineering ขั้นสูง สามารถ ติดต่อฝ่ายขาย เพื่อเข้าถึง Developer Mode แบบเต็มรูปแบบได้
Claude Code
Claude Code เปิดใช้งานทั่วไปแล้วเพื่อนำพลังของ Claude มาสู่เวิร์กโฟลว์การพัฒนา ทั้งใน terminal, IDE และการรันเบื้องหลังผ่าน Claude Code SDK
ส่วนขยายเบต้าใหม่สำหรับ VS Code และ JetBrains ช่วยให้ Claude สามารถเสนอการแก้ไขโค้ดแบบ inline ในไฟล์ได้โดยตรง ทำให้การตรวจสอบและติดตามงานภายในอินเทอร์เฟซที่คุ้นเคยเป็นเรื่องง่าย เพียงรัน Claude Code ใน IDE terminal เพื่อเริ่มการติดตั้ง
เรายังเปิดตัว Claude Code SDK ที่ขยายขอบเขตได้ เพื่อให้คุณสร้าง agent ของตัวเอง และเปิดตัว Claude Code บน GitHub ช่วงเบต้า ซึ่งสามารถแท็ก Claude ใน PR เพื่อให้ช่วยรีวิวโค้ด แก้ไขข้อผิดพลาดของ CI หรือแก้ไขโค้ดได้ทันที โดยติดตั้งผ่านคำสั่ง /install-github-app ภายใน Claude Code
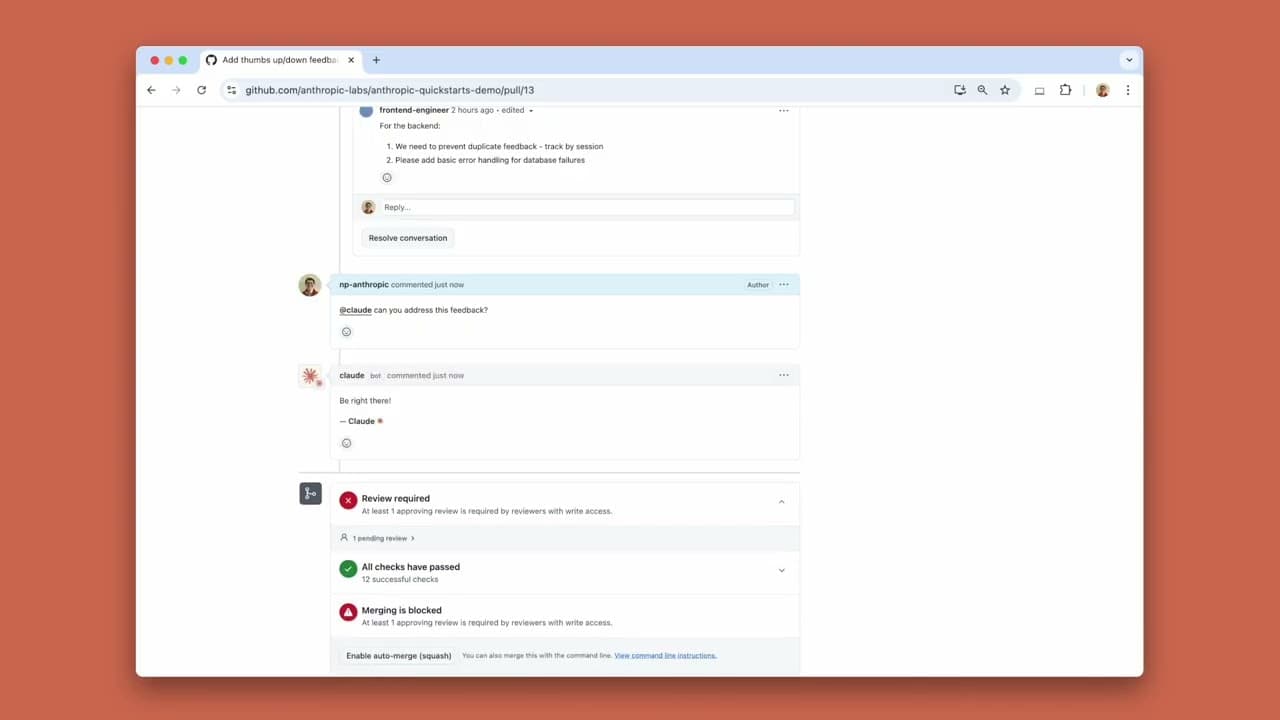
การเริ่มต้นใช้งาน
โมเดลเหล่านี้คือก้าวสำคัญสู่การเป็นผู้ร่วมงานเสมือนจริง (virtual collaborator) ที่รักษาบริบทได้ครบถ้วนและจดจ่อกับโปรเจกต์ระยะยาวได้ต่อเนื่อง โดยผ่านการทดสอบความปลอดภัยอย่างเข้มงวดตามมาตรฐาน ASL-3
เริ่มต้นใช้งานได้ตั้งแต่วันนี้ที่ Claude, Claude Code หรือแพลตฟอร์มที่คุณเลือก
แหล่งที่มาของข้อมูลการทดสอบประสิทธิภาพ (Performance benchmark)
- Open AI: o3 launch post, o3 system card, GPT-4.1 launch post, GPT-4.1 hosted evals - Gemini: Gemini 2.5 Pro Preview model card - Claude: Claude 3.7 Sonnet launch post
รายงานการทดสอบประสิทธิภาพ
ผลการทดสอบแสดงคะแนนสูงสุดทั้งแบบที่มีและไม่มีการคิดแบบขยายระยะเวลา ดังนี้:
- ไม่มีการคิดแบบขยายระยะเวลา: SWE-bench Verified, Terminal-bench
- มีการคิดแบบขยายระยะเวลา (สูงสุด 64K tokens): TAU-bench, GPQA Diamond, MMMLU, MMMU และ AIME (รายละเอียดคะแนนตามที่ระบุในรายงานฉบับเต็ม)
ระเบียบวิธีวิจัย TAU-bench
มีการเพิ่มส่วนขยายใน prompt เพื่อสั่งให้โมเดลใช้เหตุผลได้ดีขึ้นขณะใช้เครื่องมือ โดยเพิ่มจำนวนขั้นตอนสูงสุดจาก 30 เป็น 100 ขั้นตอนเพื่อให้รองรับกระบวนการคิดที่ลึกซึ้งขึ้น
ระเบียบวิธีวิจัย SWE-bench
สำหรับ Claude 4 เราใช้โครงสร้าง scaffold แบบง่ายที่มีเครื่องมือ bash และการแทนที่สตริง โดยรายงานคะแนนจากปัญหาทั้งหมด 500 ข้อ และในส่วนของ "high compute" เราได้เพิ่มการประเมินแบบขนานและการสุ่มแบบปฏิเสธ (rejection sampling) ส่งผลให้ได้คะแนนสูงถึง 79.4% สำหรับ Opus 4 และ 80.2% สำหรับ Sonnet 4
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร