
เอเจนท์ AI ต้องการความจำมากแค่ไหน? ผลวิจัยชี้ต้อง 'ปรับจูน' ให้พอดีกับความสามารถโมเดล
ใน โพสต์ก่อนหน้า ของเรา เราได้เปรียบเทียบ ALTK-Evolve กับ ACE และแสดงให้เห็นว่าวิธีการส่งมอบคำแนะนำที่เอเจนท์กลั่นกรองด้วยตัวเอง (Self-distilled guidelines) ส่งผลต่อทั้งความแม่นยำและต้นทุน โพสต์นี้จะย้อนกลับไปยังคำถามสำคัญคือ คุณควรให้ความจำแก่เอเจนท์มากแค่ไหน?
การติดตั้งหน่วยความจำเชิงเอเจนท์ (Agentic memory) ฟังดูเรียบง่าย โดยการกลั่นกรองบทเรียนจากงานในอดีตและใส่กลับเข้าไปในบริบท (Context) ซึ่งหลายคนเชื่อว่ายิ่งมีประสบการณ์มากก็น่าจะทำงานได้ดีขึ้น แต่ผลการประเมินในโมเดล 8 รุ่น ตั้งแต่ขนาด 30B ไปจนถึงระดับ Frontier พบว่าความจำเชิงเอเจนท์ไม่ใช่ฟีเจอร์ที่แค่เปิดสวิตช์ใช้งาน แต่เป็นสิ่งที่ต้องปรับจูนปริมาณให้เข้ากับแต่ละโมเดล
สรุปประเด็นสำคัญ (TL;DR)
- ALTK-Evolve ช่วยให้เอเจนท์เรียนรู้จากประสบการณ์ในอดีตผ่านการกลั่นกรองคำแนะนำ โดยไม่ต้องอัปเดตน้ำหนักโมเดล (Weight updates) หรือใช้มนุษย์ช่วยเขียนกำกับข้อมูล
- ปริมาณที่เหมาะสมต่างกันตามระดับโมเดล: โมเดลที่แข็งแกร่งจะต้องการชุดคำแนะนำทั้งหมด ส่วนโมเดลที่อ่อนแอกว่าจะทำงานได้ดีที่สุดเมื่อใช้คำแนะนำหลักที่กะทัดรัดร่วมกับการดึงข้อมูลตามงาน (Per-task retrieval)
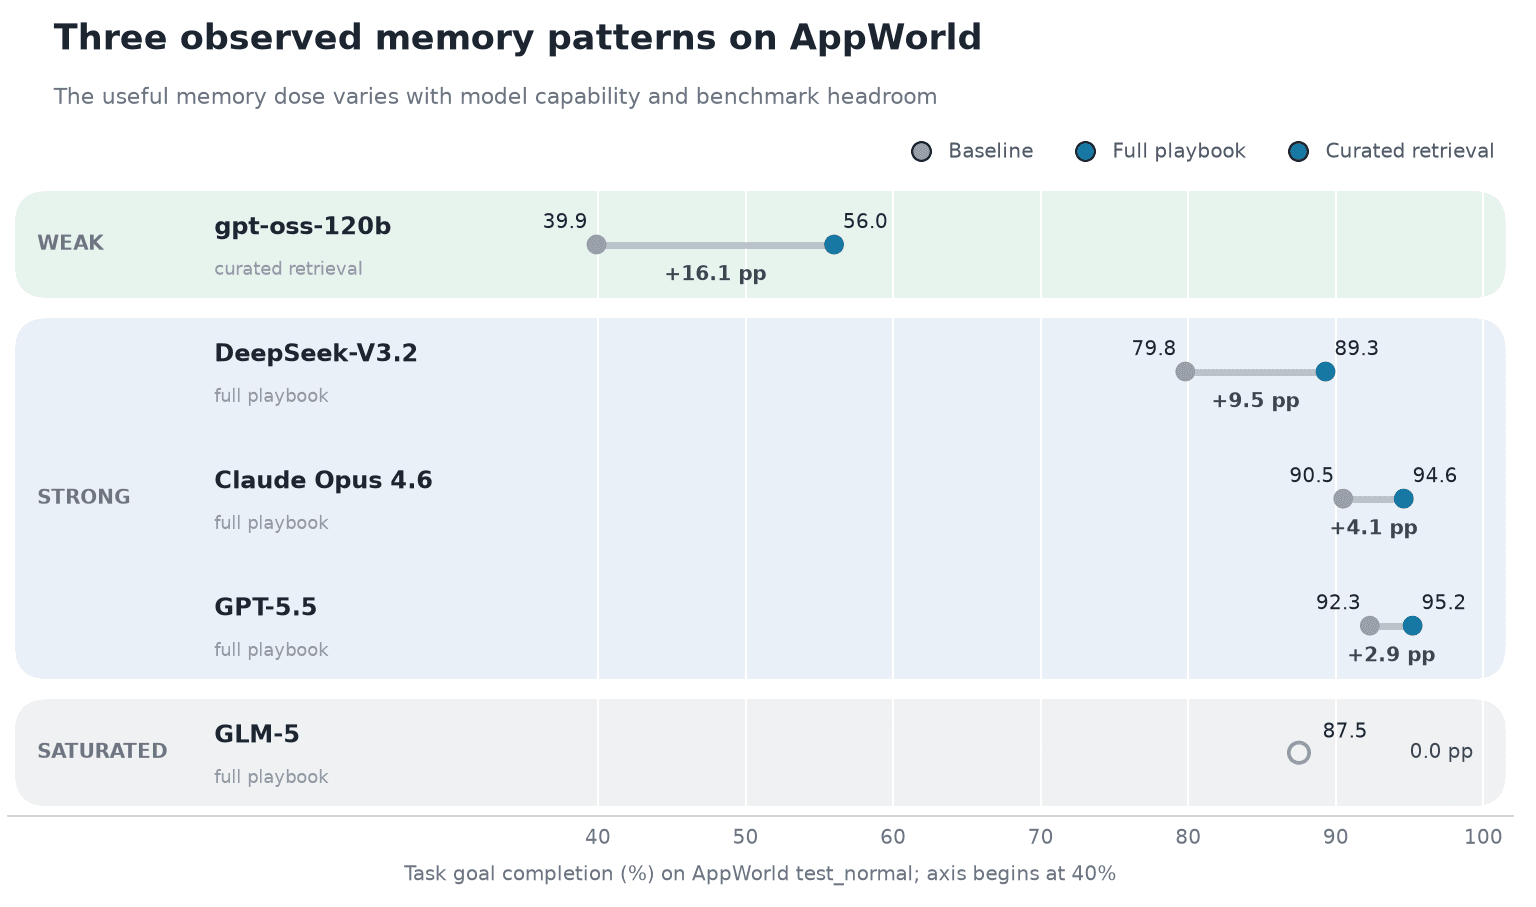
- การดึงข้อมูลแบบคัดสรร (Curated retrieval) แม่นยำและถูกที่สุด: เช่น gpt-oss-120b ทำงานสำเร็จเพิ่มขึ้น +16.1pp โดยใช้ Token เพิ่มเพียง 5% และการใช้ Prompt caching ยังช่วยให้การใส่คำแนะนำทั้งหมดมีราคาถูกลง
ข้อมูลเชิงลึกหลัก: ปริมาณยาขึ้นอยู่กับความสามารถ
จากการทดสอบโมเดล 8 รุ่น เราพบรูปแบบการตอบสนองต่อความจำ 3 รูปแบบหลัก ดังนี้:
-
โมเดลที่แข็งแกร่งและมีศักยภาพ (Strong models with headroom): ต้องการชุดคำแนะนำทั้งหมดรวมถึงกรณีที่หาได้ยาก (Edge-case) เพื่อประสิทธิภาพสูงสุด เช่น DeepSeek-V3.2 มีอัตราความสำเร็จเพิ่มขึ้น +9.5 เปอร์เซ็นต์พอยต์ (pp) เมื่อได้รับคำแนะนำทั้งหมด
-
โมเดลที่เล็กลงมามักถูกกลืนกินโดยชุดคำแนะนำขนาดใหญ่: โมเดลเหล่านี้จะได้ผลดีที่สุดจากการใช้คำแนะนำหลักที่กระชับบวกกับข้อมูลที่เกี่ยวข้องกับงานเพียงไม่กี่ข้อ เช่น gpt-oss-120b ได้คะแนนเพิ่มขึ้น +16.1pp ด้วยแนวทางนี้ ขณะที่การใส่คำแนะนำทั้งหมดให้ผลลัพธ์น้อยกว่าและเสียค่า Token แพงกว่า 50%
-
โมเดลที่อิ่มตัวแล้ว (Saturated): ไม่แสดงผลกำไรที่วัดผลได้ชัดเจน เช่น GLM-5 ซึ่งอาจเป็นเพราะโมเดลเข้าใกล้เพดานความสามารถในงานนั้นๆ อยู่แล้ว หรือคำแนะนำไม่ได้ช่วยแก้ปัญหาที่เหลืออยู่ได้
ปัจจัยที่กำหนดรูปแบบเหล่านี้ไม่ใช่แค่จำนวนพารามิเตอร์ แต่รวมถึงศักยภาพที่เหลือใน Benchmark, ขนาด Context window, สถาปัตยกรรม และคุณภาพของคำแนะนำ ข้อสรุปที่นำไปใช้ได้จริงคือ ปริมาณความจำที่เหมาะสมขึ้นอยู่กับตัวโมเดลและเราสามารถปรับจูนมันได้
การเรียนรู้รอบโมเดล ไม่ใช่ภายในโมเดล
"ความจำ" ในที่นี้ไม่ใช่การเล่นซ้ำเหตุการณ์เดิม แต่คือ ชุดคำแนะนำ (Guideline set) ที่ประกอบด้วยกลยุทธ์ ข้อควรระวัง และกรณีพิเศษที่กลั่นกรองมาจากประสบการณ์ของเอเจนท์เอง โดยมีวงจรการทำงานดังนี้:
- เอเจนท์สร้างเส้นทางการทำงาน (Trajectories)
- ALTK-Evolve ดึงคำแนะนำจากทั้งงานที่สำเร็จและไม่สำเร็จ
- รวมคำแนะนำเหล่านั้นเป็นชุดที่นำกลับมาใช้ใหม่ได้
- ในช่วง Inference เอเจนท์จะได้รับชุดคำแนะนำทั้งหมดหรือเฉพาะส่วนที่เกี่ยวข้อง
กระบวนการนี้เปลี่ยนแค่คำแนะนำที่มีให้เอเจนท์ ไม่ได้เปลี่ยนตัวโมเดลพื้นฐาน ทำให้ประหยัดและสามารถย้ายไปใช้กับโมเดลต่างๆ ได้ง่าย
ผลลัพธ์จากทั่วทั้งสเปกตรัม
เราประเมินผลบน AppWorld ซึ่งมีงาน 585 รายการ ครอบคลุมแอปจำลองหลากหลาย โดยวัดผลสองวิธีคือ TGC (Task Goal Completion - งานสำเร็จหรือไม่) และ SGC (Scenario Goal Completion - ผ่านทุกรูปแบบย่อยหรือไม่ ซึ่งเข้มงวดกว่า)
การกำหนดค่า 3 รูปแบบที่เปรียบเทียบ
| การกำหนดค่า | สิ่งที่อยู่ในบริบทของเอเจนท์ |
|---|---|
| Baseline | ไม่มีหน่วยความจำ — โมเดลตามสภาพเริ่มต้น |
| ชุดคำแนะนำทั้งหมด | ใส่คำแนะนำทุกข้อที่ขุดพบในทุกขั้นตอนการทำงาน |
| การดึงข้อมูลแบบคัดสรร | ใช้คำแนะนำแกนหลักที่มั่นใจสูง บวกกับคำแนะนำเฉพาะงานที่ดึงมาเพิ่ม |
รูปที่ 1. แสดง TGC บน AppWorld test_normal สำหรับ Baseline เทียบกับหน่วยความจำที่ดีที่สุด
| โมเดล | รูปแบบ | Baseline TGC / SGC | Best-memory TGC / SGC | Δ SGC |
|---|---|---|---|---|
| gpt-oss-120b | อ่อนแอ / แบบคัดเลือก | 39.9 / 21.4 | 56.0 / 37.5 | +16.1 |
| DeepSeek-V3.2 | แข็งแกร่ง / มีศักยภาพ | 79.8 / 64.3 | 89.3 / 80.4 | +16.1 |
| Claude Opus 4.6 | แข็งแกร่ง / มีศักยภาพ | 90.5 / 87.5 | 94.6 / 94.6 | +7.1 |
| GPT-5.5 | แข็งแกร่ง (ใกล้เพดาน) | 92.3 / 82.1 | 95.2 / 89.3 | +7.2 |
| GLM-5 | อิ่มตัว | 87.5 / 80.4 | 87.5 / 80.4 | 0.0 |
ผลลัพธ์แสดงให้เห็นว่าเมทริก SGC ที่เข้มงวดมักจะเพิ่มขึ้นมากกว่า TGC โดยเฉพาะใน DeepSeek ที่พุ่งขึ้นถึง +16.1pp เพราะคำแนะนำช่วยให้เอเจนท์รับมือกับสถานการณ์ย่อยๆ ได้แม่นยำขึ้น
กลยุทธ์ที่ประหยัดที่สุดและดีที่สุด
ข้อกังวลเรื่องต้นทุนจากการที่คำแนะนำทำให้ Input บวมขึ้นนั้นถูกแก้ไขได้ด้วย 2 แนวทาง:
- การดึงข้อมูลแบบคัดสรร (Curated Retrieval): ช่วยให้ต้นทุนใกล้เคียงกับ Baseline แต่ได้ประสิทธิภาพเพิ่มขึ้นมหาศาล เช่น gpt-oss-120b ที่สำเร็จเพิ่มขึ้น +16.1pp โดยใช้ Token เพิ่มเพียง 5%
- Prompt Caching: การทำ Cache ในส่วนคำแนะนำที่คงที่ช่วยลดต้นทุนการใช้งานจริงได้มาก ซึ่งคุ้มค่าแก่การลงทุนด้านวิศวกรรม
สรุปคือความจำควรได้รับการปรับจูน ไม่ใช่แค่สะสมไว้ สำหรับโมเดลที่อ่อนแอควรเน้นความกระชับ สำหรับโมเดลที่แข็งแกร่งควรเน้นความครบถ้วนควบคู่กับเทคนิคการประหยัดต้นทุน
ขั้นตอนต่อไป
นี่เป็นเพียงจุดเริ่มต้น ทีมวิจัยกำลังพัฒนาตัวเลือกคำแนะนำที่ชาญฉลาดขึ้น (Learned selector), การศึกษาความจำสำหรับโมเดลขนาดเล็กพิเศษ, การทดสอบกับ Benchmark อื่นๆ ที่กว้างขึ้น และการวิเคราะห์ผลกระทบของ Context window อย่างละเอียด
ลองใช้งานไลบรารี ALTK-Evolve หรืออ่าน รายงานทางเทคนิคฉบับเต็ม สำหรับข้อมูลเจาะลึกเพิ่มเติม
ภาคผนวก: การวัดผล
- TGC (Task Goal Completion): วัดว่างานหลักสำเร็จและถูกต้องหรือไม่
- SGC (Scenario Goal Completion): วัดความน่าเชื่อถือ โดยจะให้คะแนนก็ต่อเมื่อเอเจนท์ผ่านทุกรูปแบบย่อยของงานนั้นๆ ได้ทั้งหมด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร