
IBM เปิดตัว Granite PatchTST-FM-r2 โมเดลพยากรณ์อนุกรมเวลาระดับ SOTA ที่ใช้งานเชิงพาณิชย์ได้ฟรี
[Roman Vaculin
vaculin
Follow](/vaculin)
[Wesley M. Gifford
wmgifford
Follow](/wmgifford)
[Jiri Navratil
jirin1a
Follow](/jirin1a)
[Chandra Reddy
creddyhf
Follow](/creddyhf)
[Ayhan Sebin
ayhansebin
Follow](/ayhansebin)
การพยากรณ์แบบ zero-shot ประสิทธิภาพสูงพร้อมสัญญาอนุญาตแบบเปิดที่เป็นมิตรต่อการใช้งานเชิงพาณิชย์
โมเดลพื้นฐานสำหรับข้อมูลอนุกรมเวลา (Time-series foundation models) กำลังเข้ามาเปลี่ยนโฉมการสร้างระบบพยากรณ์ จากเดิมที่ต้องฝึกฝนและดูแลโมเดลแยกตามชุดข้อมูล ผู้ใช้สามารถเปลี่ยนมาใช้โมเดลที่ผ่านการฝึกล่วงหน้า (pretrained model) เพื่อสร้างการพยากรณ์แบบ zero-shot ได้ทันทีโดยไม่ต้องเทรนใหม่
ล่าสุด IBM ได้ปล่อย Granite Time Series PatchTST-FM-r2 ซึ่งเป็นโมเดลรุ่นใหม่ในตระกูล Granite TSFM (github, blog) โดยเวอร์ชัน r2 นี้พัฒนาต่อยอดจาก PatchTST-FM-r1 ด้วยการอัปเดตสถาปัตยกรรม ขยายคลังข้อมูลฝึกฝน และเพิ่มความสามารถในการพยากรณ์เชิงความน่าจะเป็น (probabilistic forecasting) รวมถึงการเติมค่าที่ขาดหายไป (imputation) ในขนาดโมเดลประมาณ 385M-parameter
ข้อมูล ณ วันที่ 8 กันยายน 2026 ระบุว่าโมเดลนี้เป็นโมเดล zero-shot ที่มีประสิทธิภาพสูงสุดภายใต้สัญญาอนุญาตแบบเปิดที่ใช้งานเชิงพาณิชย์ได้ (Apache 2.0 และ OpenMDW 1.0) ในกลุ่มโมเดลที่ทำซ้ำผลลัพธ์ได้ (replicable) บนตารางผู้นำ GIFT-Eval โดยรั้งอันดับ #2 ในภาพรวมของกลุ่มโมเดล zero-shot ทั้งหมด
สำหรับผู้ที่ต้องการนำไปใช้งาน IBM ได้เปิดเผยทั้งน้ำหนักของโมเดล (model weights), สถาปัตยกรรม, ไปป์ไลน์การอนุมาน (inference pipeline) รวมถึงโค้ดที่จำเป็นสำหรับการทดสอบเกณฑ์มาตรฐานไว้อย่างครบถ้วน
บทความนี้จะเจาะลึกถึงรายละเอียดของโมเดล ผลการทดสอบ สถาปัตยกรรมภายใน ข้อมูลที่ใช้ฝึกฝน พร้อมตัวอย่างโค้ดการใช้งาน นอกจากนี้ยังมีการกล่าวถึงการนำโมเดลตระกูล Granite Time Series ไปประยุกต์ใช้ในแอปพลิเคชันแบบสตรีมมิ่งผ่าน ผลิตภัณฑ์ Confluent ในสภาพแวดล้อมการทำงานจริง
พร้อมที่จะลองหรือยัง? เปิด Granite Time Series PatchTST-FM-r2 บน Hugging Face
TL;DR
- การพยากรณ์แบบ zero-shot ที่หลากหลาย ครอบคลุมตั้งแตความต้องการสินค้า (demand), ราคา, โหลดพลังงาน, การจราจร ไปจนถึงข้อมูลทางไกล (telemetry)
- พารามิเตอร์ประมาณ 385 ล้านตัว รองรับความยาวบริบท (context length) สูงสุด 8,192 และพยากรณ์เชิงความน่าจะเป็นผ่าน prediction head แบบ 99-quantile
- โครงสร้างหลัก (backbone) ใช้ conformer blocks ที่ผสาน multi-head self-attention เข้ากับ temporal convolution เพื่อดึงคุณลักษณะข้อมูลทั้งระยะยาวและระยะสั้น
- ใช้สัญญาอนุญาตแบบผ่อนปรน (Apache-2.0 และ OpenMDW-1.0) ซึ่งผู้ใช้สามารถเลือกได้ตามความเหมาะสม
- เปิดเผยน้ำหนักโมเดล สถาปัตยกรรม และโค้ดสำหรับทำซ้ำผลการทดสอบสู่สาธารณะ
การพยากรณ์แบบ zero-shot ที่แข็งแกร่งบน GIFT-Eval
จุดเด่นของโมเดลพื้นฐานคือความสามารถในการปรับใช้ทั่วไป (generalize) กับข้อมูลที่ไม่เคยเห็นมาก่อน ซึ่ง PatchTST-FM-r2 ทำผลงานได้ยอดเยี่ยมบนเกณฑ์มาตรฐาน GIFT-Eval โดยครองอันดับ 2 ทั้งในด้าน CRPS และ MASE (ข้อมูล ณ 8 กันยายน 2026) เมื่อเทียบในกลุ่มโมเดล zero-shot ที่ทำซ้ำได้ ดังที่แสดงในรูปที่ 1 และ 2 ซึ่งยิ่งค่าต่ำยิ่งสะท้อนประสิทธิภาพที่ดี
ที่สำคัญที่สุดคือ PatchTST-FM-r2 คือโมเดลอันดับหนึ่งในหมวดหมู่นี้หากพิจารณาเฉพาะโมเดลที่มีสัญญาอนุญาตแบบเปิดที่เป็นมิตรต่อภาคธุรกิจ
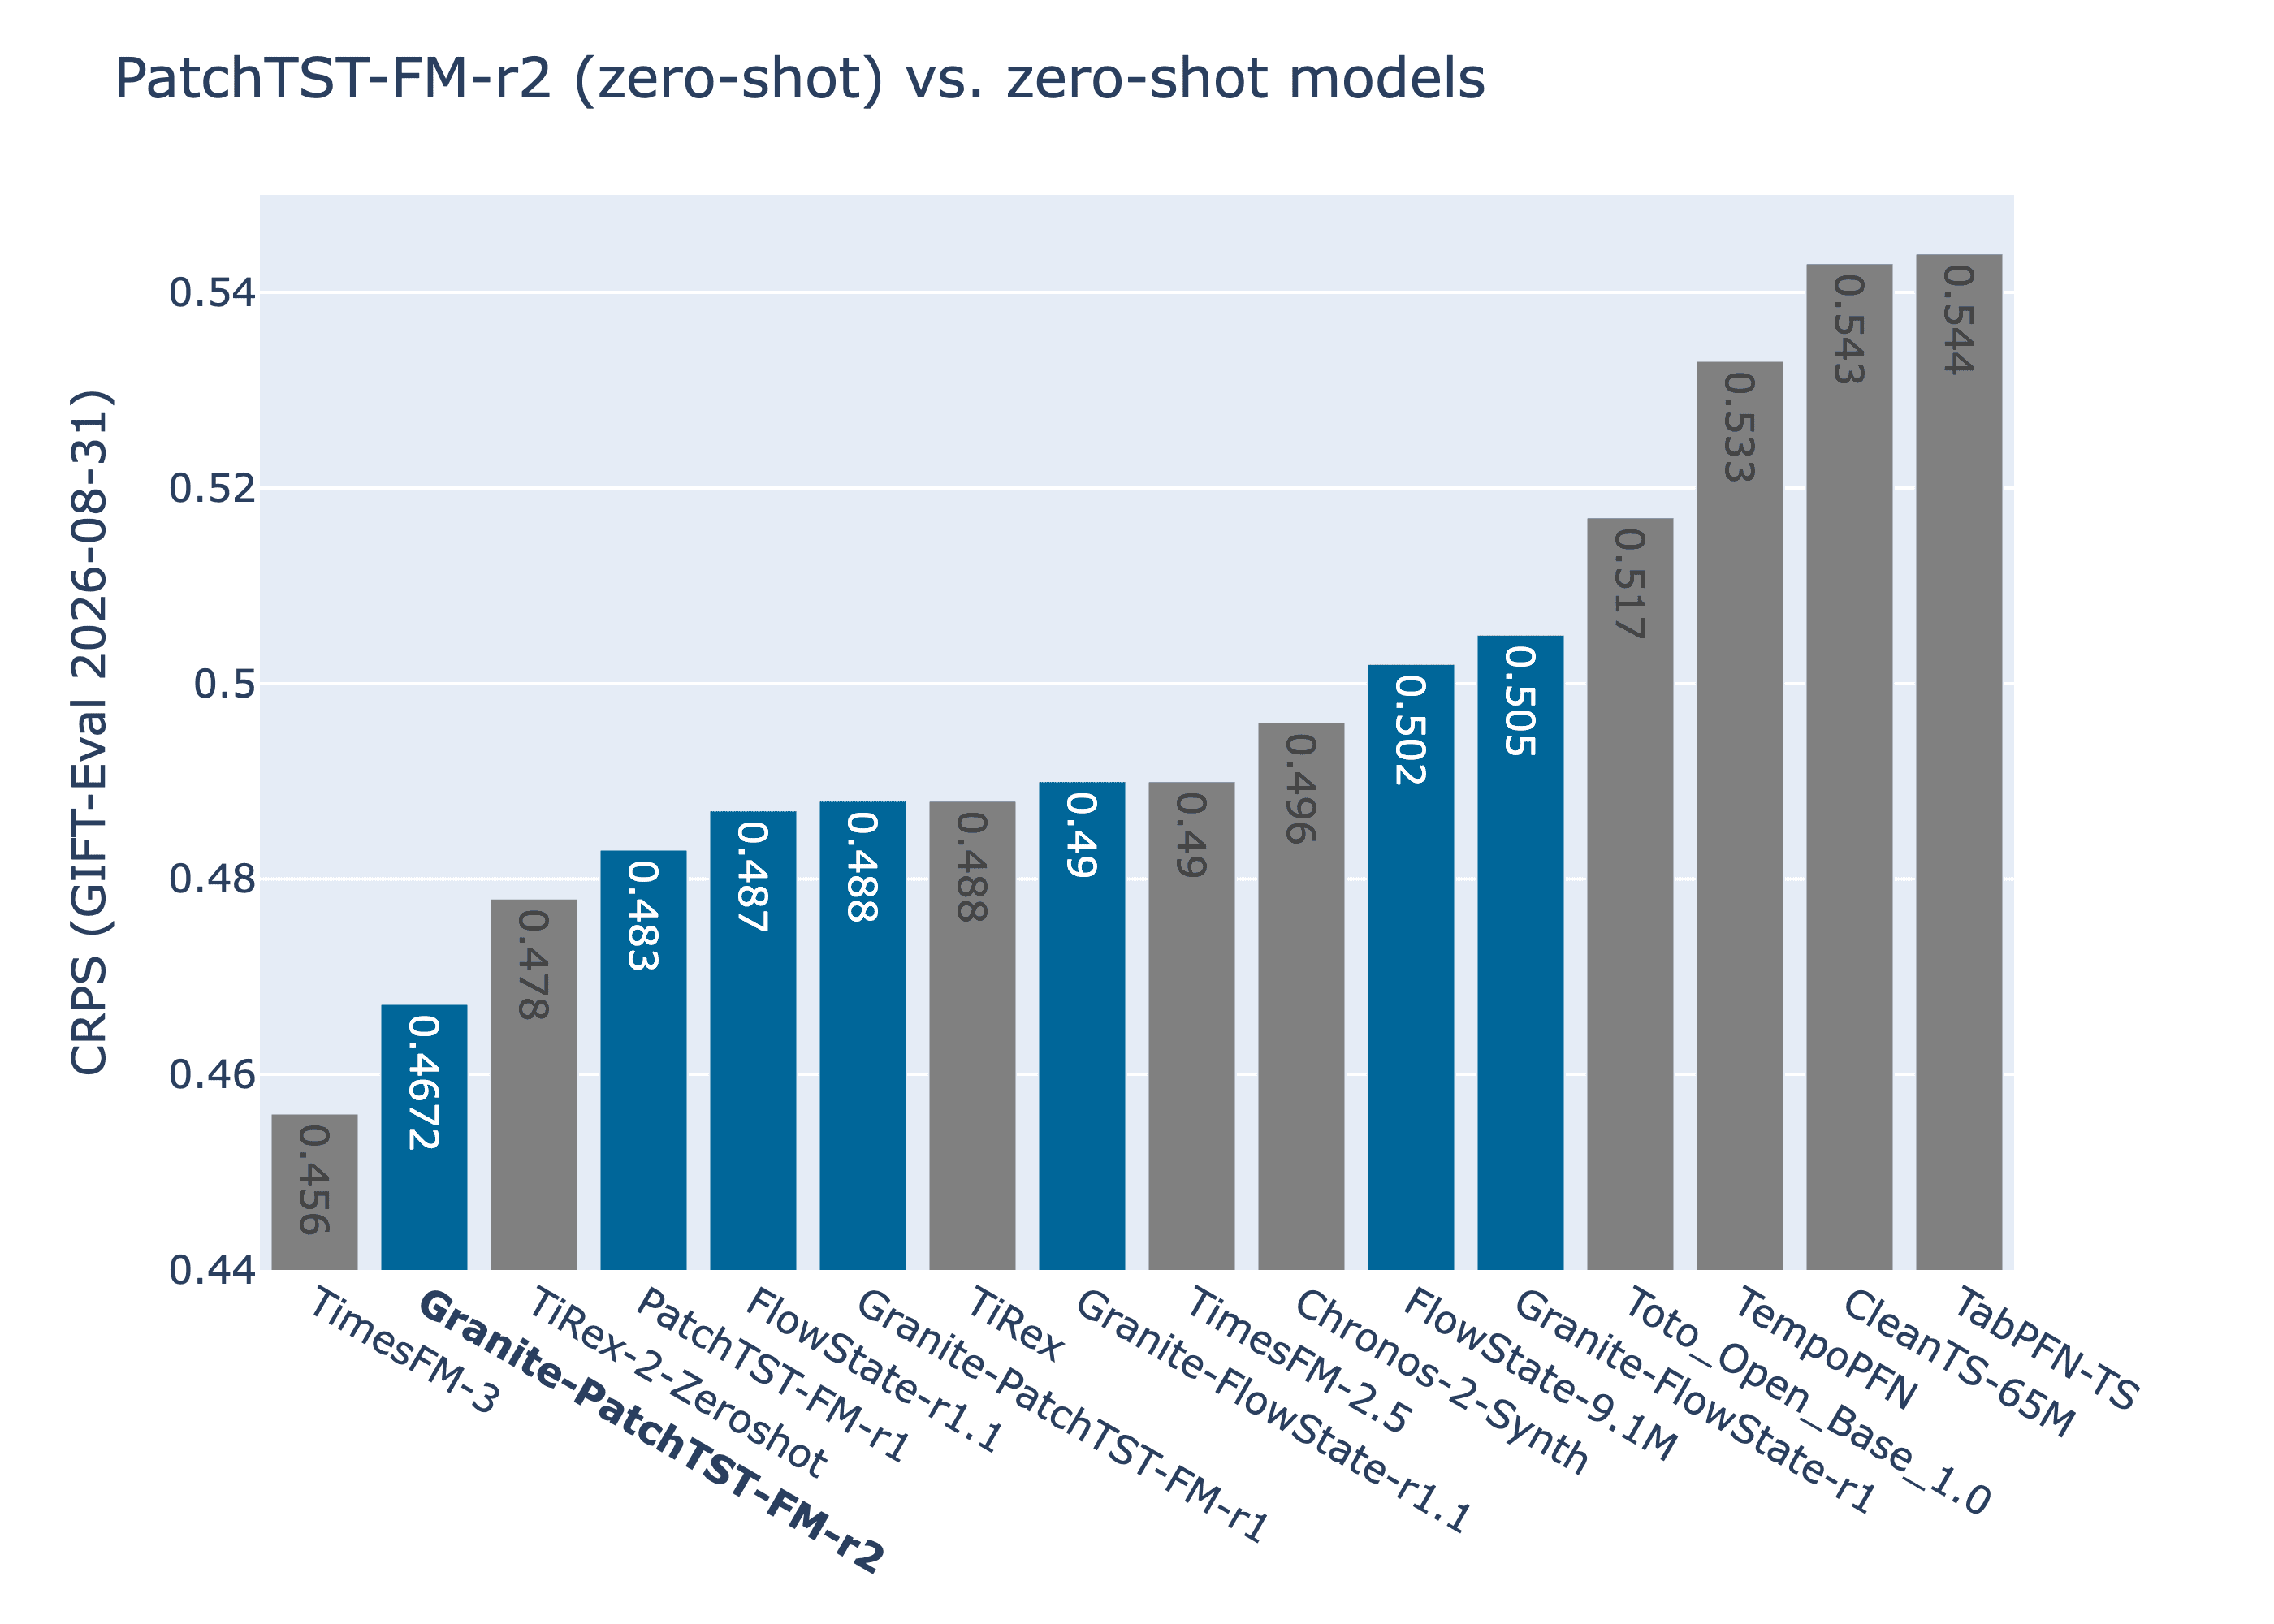
รูปที่ 1. ค่า GIFT-Eval CRPS สำหรับโมเดล zero-shot ชั้นนำ โดย PatchTST-FM-r2 ทำค่าเฉลี่ยเรขาคณิตได้ 0.467 เป็นรองเพียง TimesFM-3 แต่ครองอันดับหนึ่งในกลุ่มสัญญาอนุญาตแบบผ่อนปรน
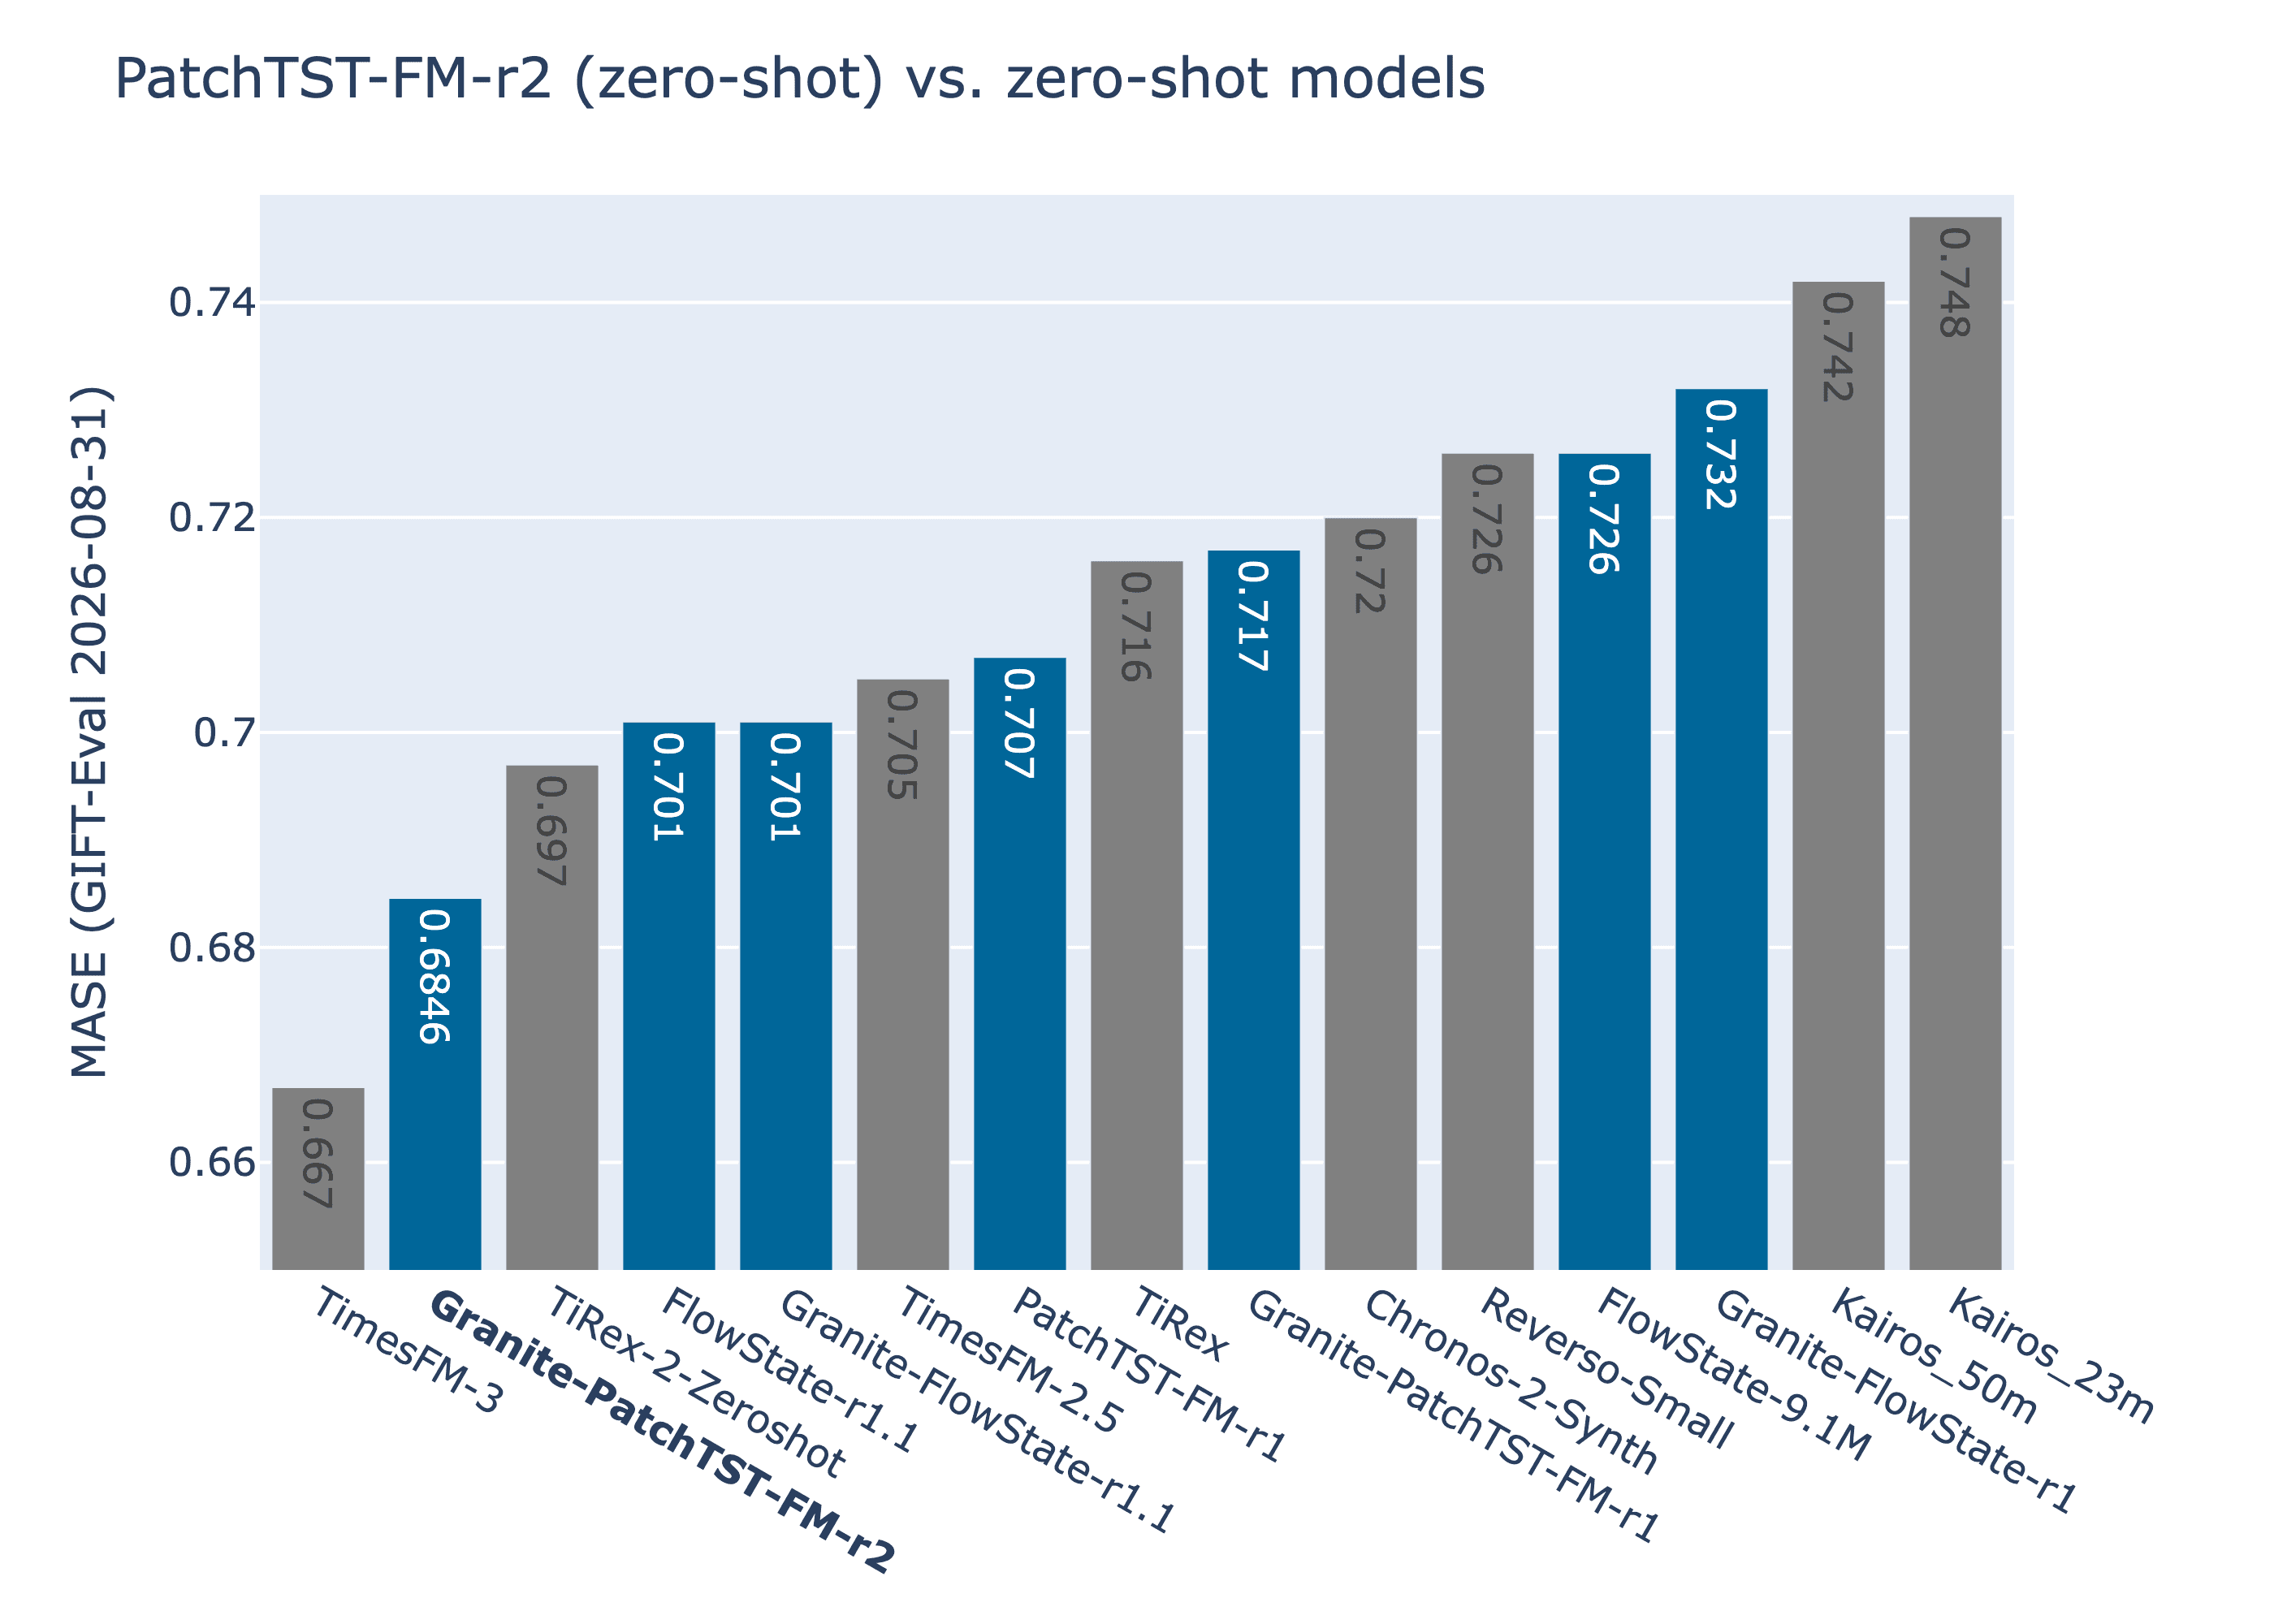
รูปที่ 2. ค่า GIFT-Eval MASE สำหรับโมเดล zero-shot ชั้นนำ โดย PatchTST-FM-r2 ทำค่าเฉลี่ยเรขาคณิตได้ 0.6846 (แถบสีน้ำเงินคือโมเดลจากทีม IBM)
ประสิทธิภาพที่เหนือกว่าแม้เทียบกับโมเดลที่ใช้ข้อมูลทดสอบฝึกฝน
แม้จะนำไปเปรียบเทียบกับโมเดลกลุ่ม pretrained ที่ได้รับอนุญาตให้ใช้ข้อมูลจากชุดประเมิน GIFT-Eval มาฝึกฝนล่วงหน้าได้ PatchTST-FM-r2 ก็ยังคงรักษามาตรฐานอยู่ในระดับต้นๆ โดยคว้า อันดับ 3 สำหรับ CRPS และอันดับ 4 สำหรับ MASE ในกลุ่มโมเดลที่ทำซ้ำได้
ประสิทธิภาพของโมเดลนี้ยังเหนือกว่าโมเดลรุ่นใหญ่อื่นๆ เช่น Chronos-2, Timer-S1 และ Toto ในหลายเวอร์ชัน แม้ว่าโมเดลคู่แข่งเหล่านั้นจะมีขนาดพารามิเตอร์ที่ใหญ่กว่ามากก็ตาม
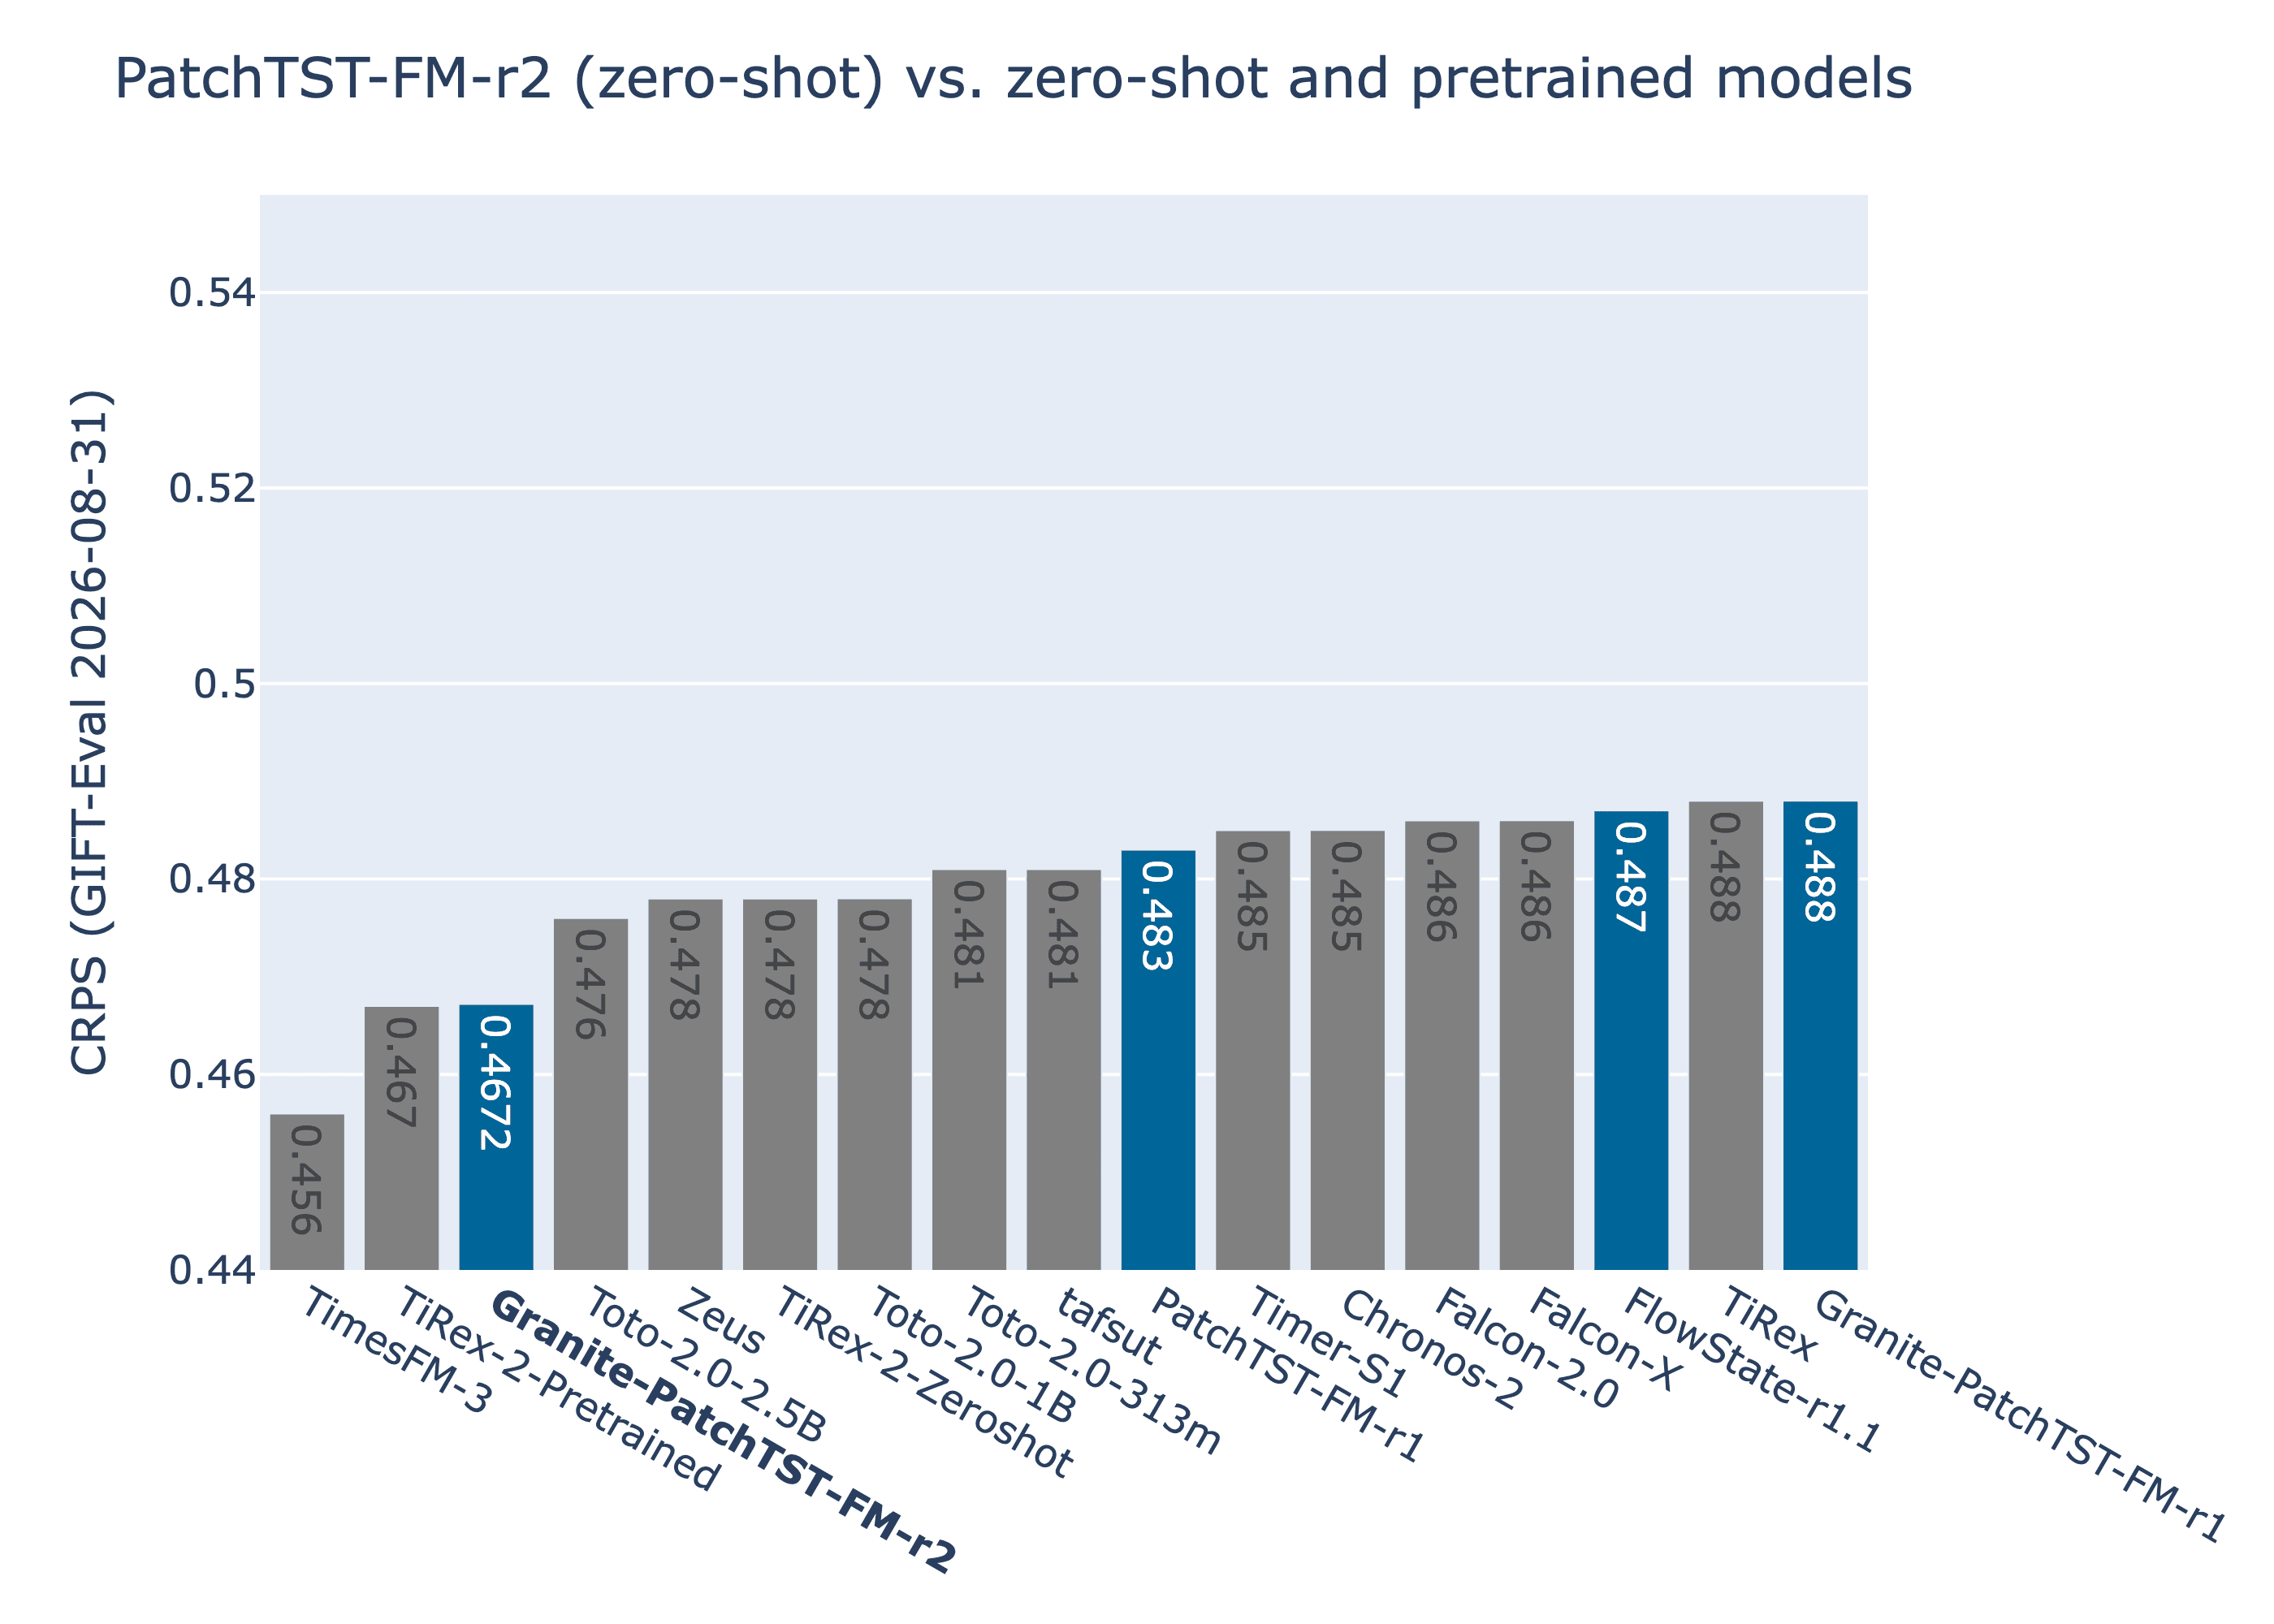
รูปที่ 3. GIFT-Eval CRPS เมื่อเปรียบเทียบระหว่างโมเดล zero-shot และโมเดล pretrained ที่ทำซ้ำได้
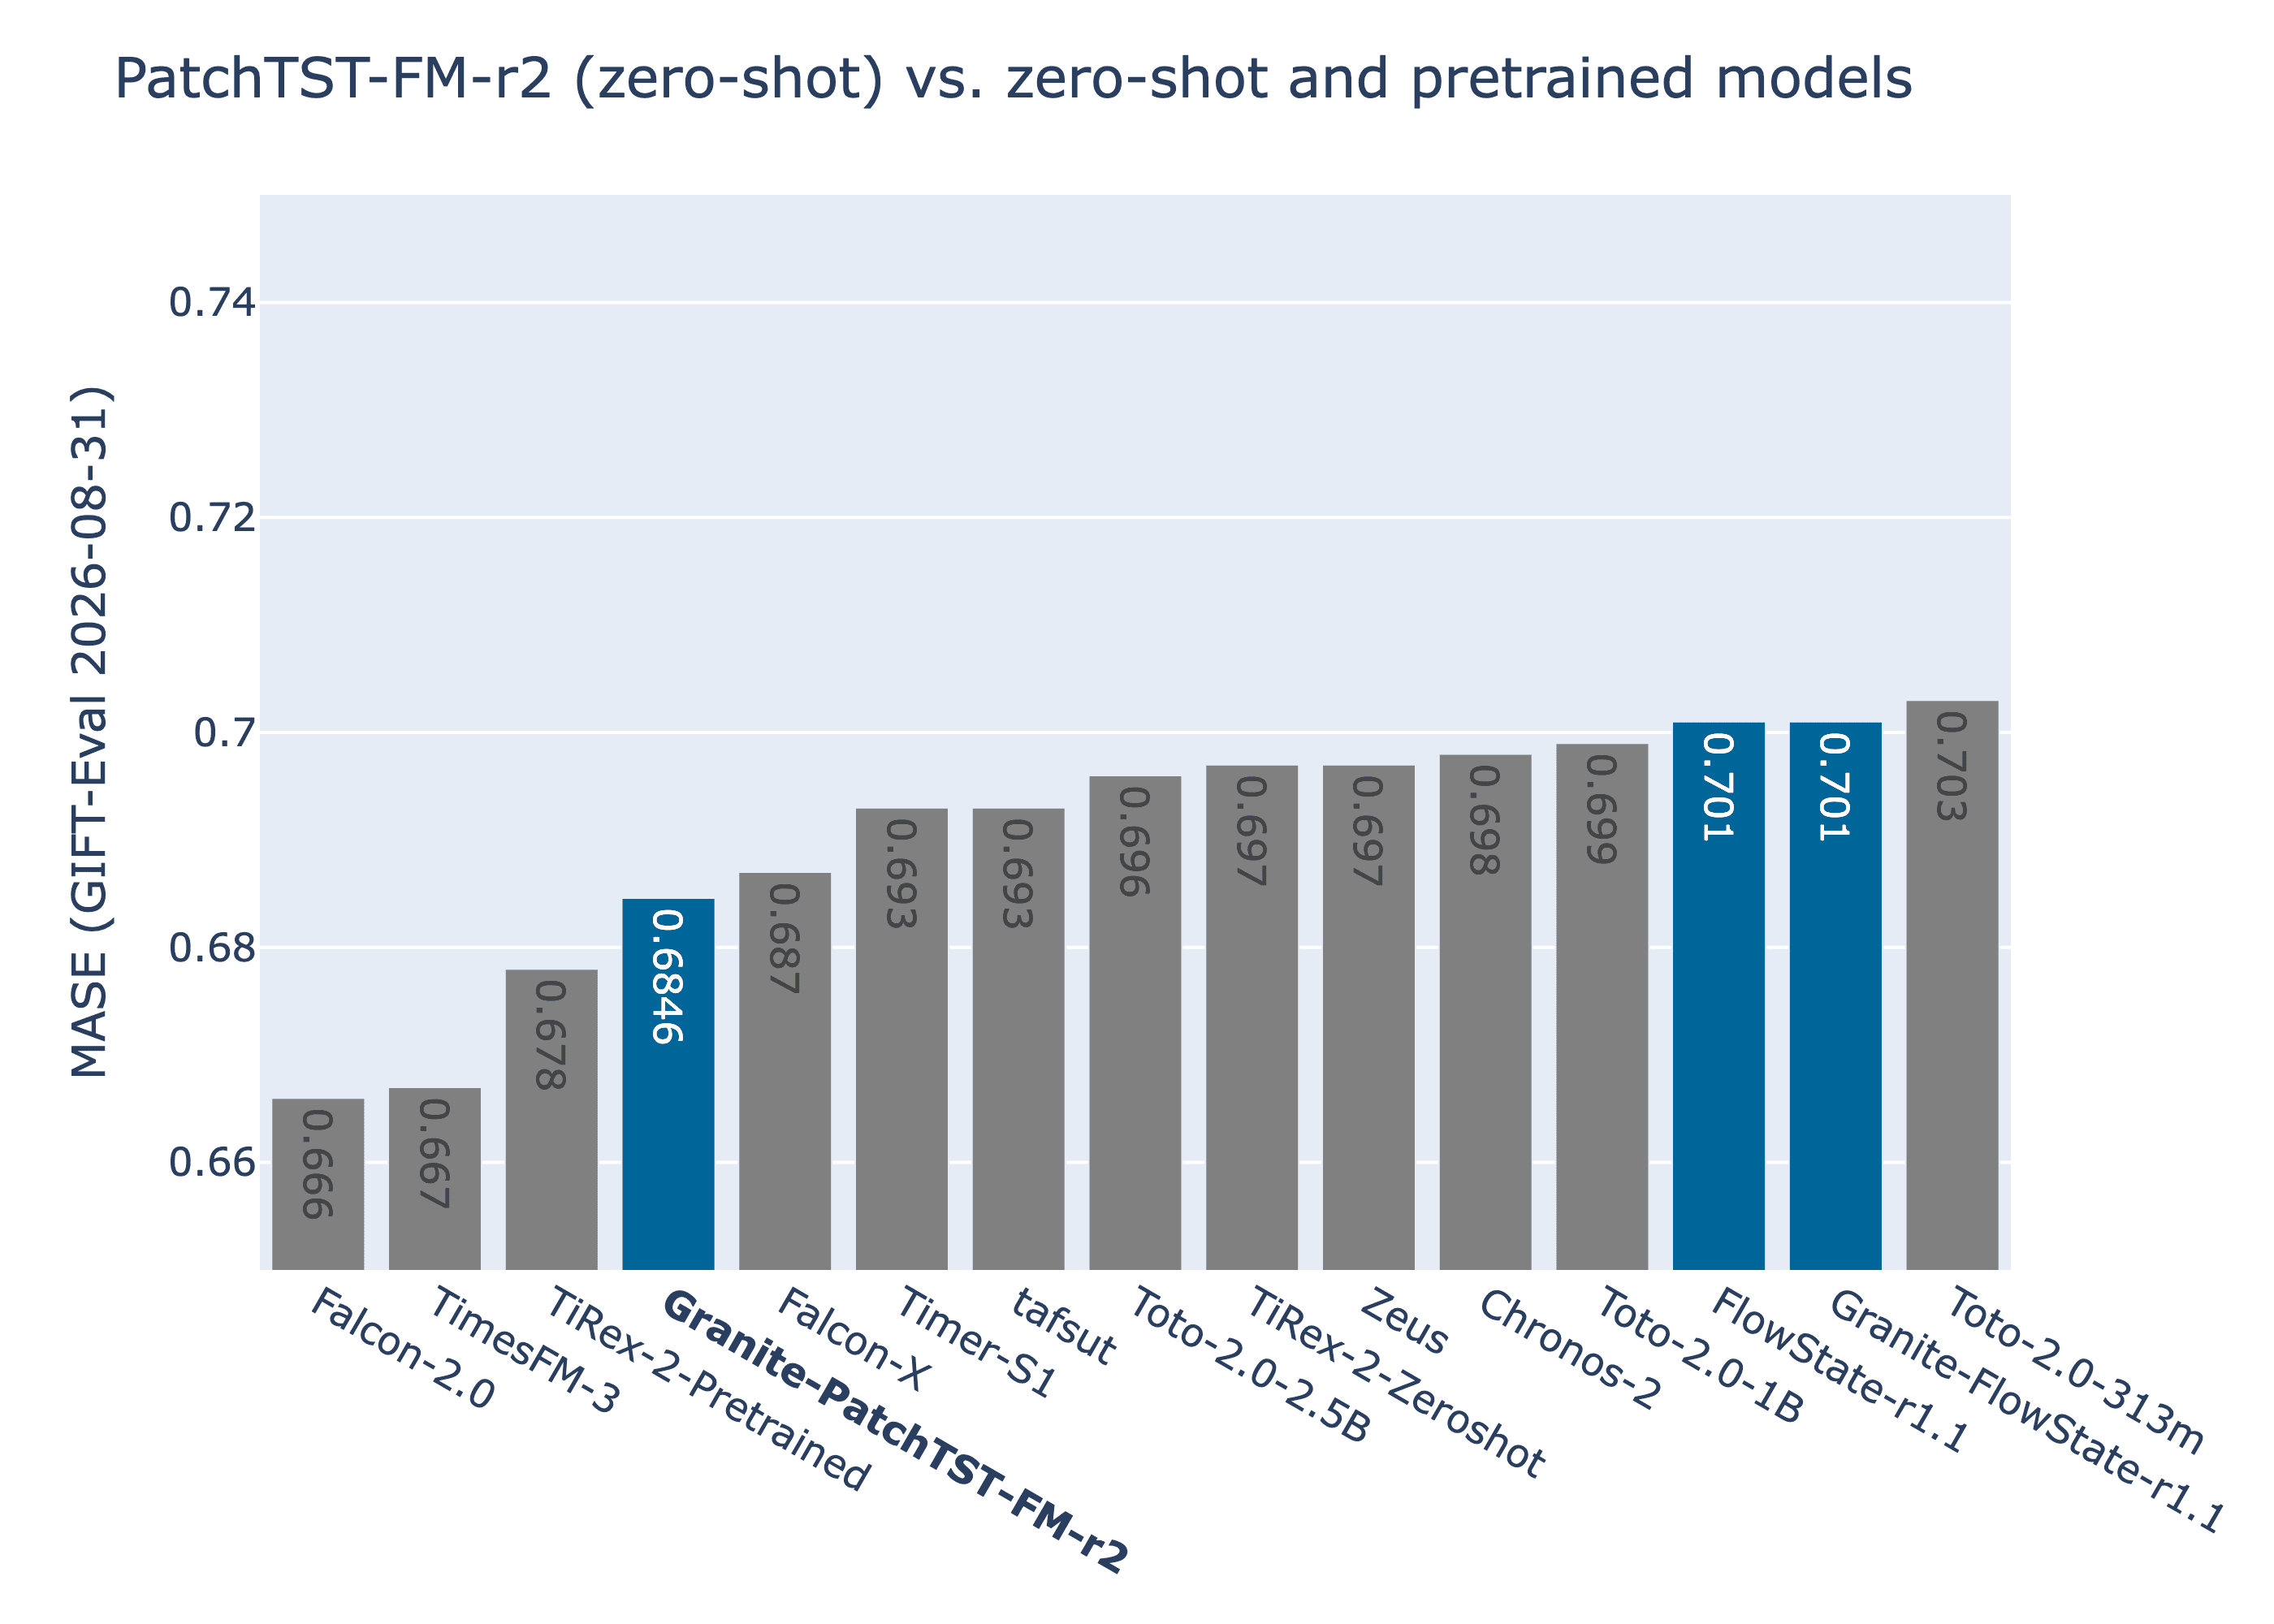
รูปที่ 4. GIFT-Eval MASE เมื่อเปรียบเทียบระหว่างโมเดล zero-shot และโมเดล pretrained ที่ทำซ้ำได้
สถาปัตยกรรม: การเปลี่ยนแปลงจาก PatchTST-FM-r1 สู่ r2
PatchTST-FM-r2 ยังคงใช้พื้นฐานการแทนข้อมูลแบบ patch-based แต่มีการยกเครื่องสถาปัตยกรรมภายในใหม่เพื่อเพิ่มประสิทธิภาพในการจับความสัมพันธ์ของข้อมูล และทำให้การทำนายระหว่างช่วง (patch) มีความต่อเนื่องราบรื่นขึ้น
การเปลี่ยนแปลงที่สำคัญคือการเปลี่ยนจากเลเยอร์ transformer มาตรฐาน ไปใช้เลเยอร์แบบ conformer ที่ผสมผสานการม้วนตัว (convolution) เข้ากับ multi-head self-attention ซึ่งเป็นเทคนิคที่มีต้นกำเนิดมาจากงานประมวลผลเสียง
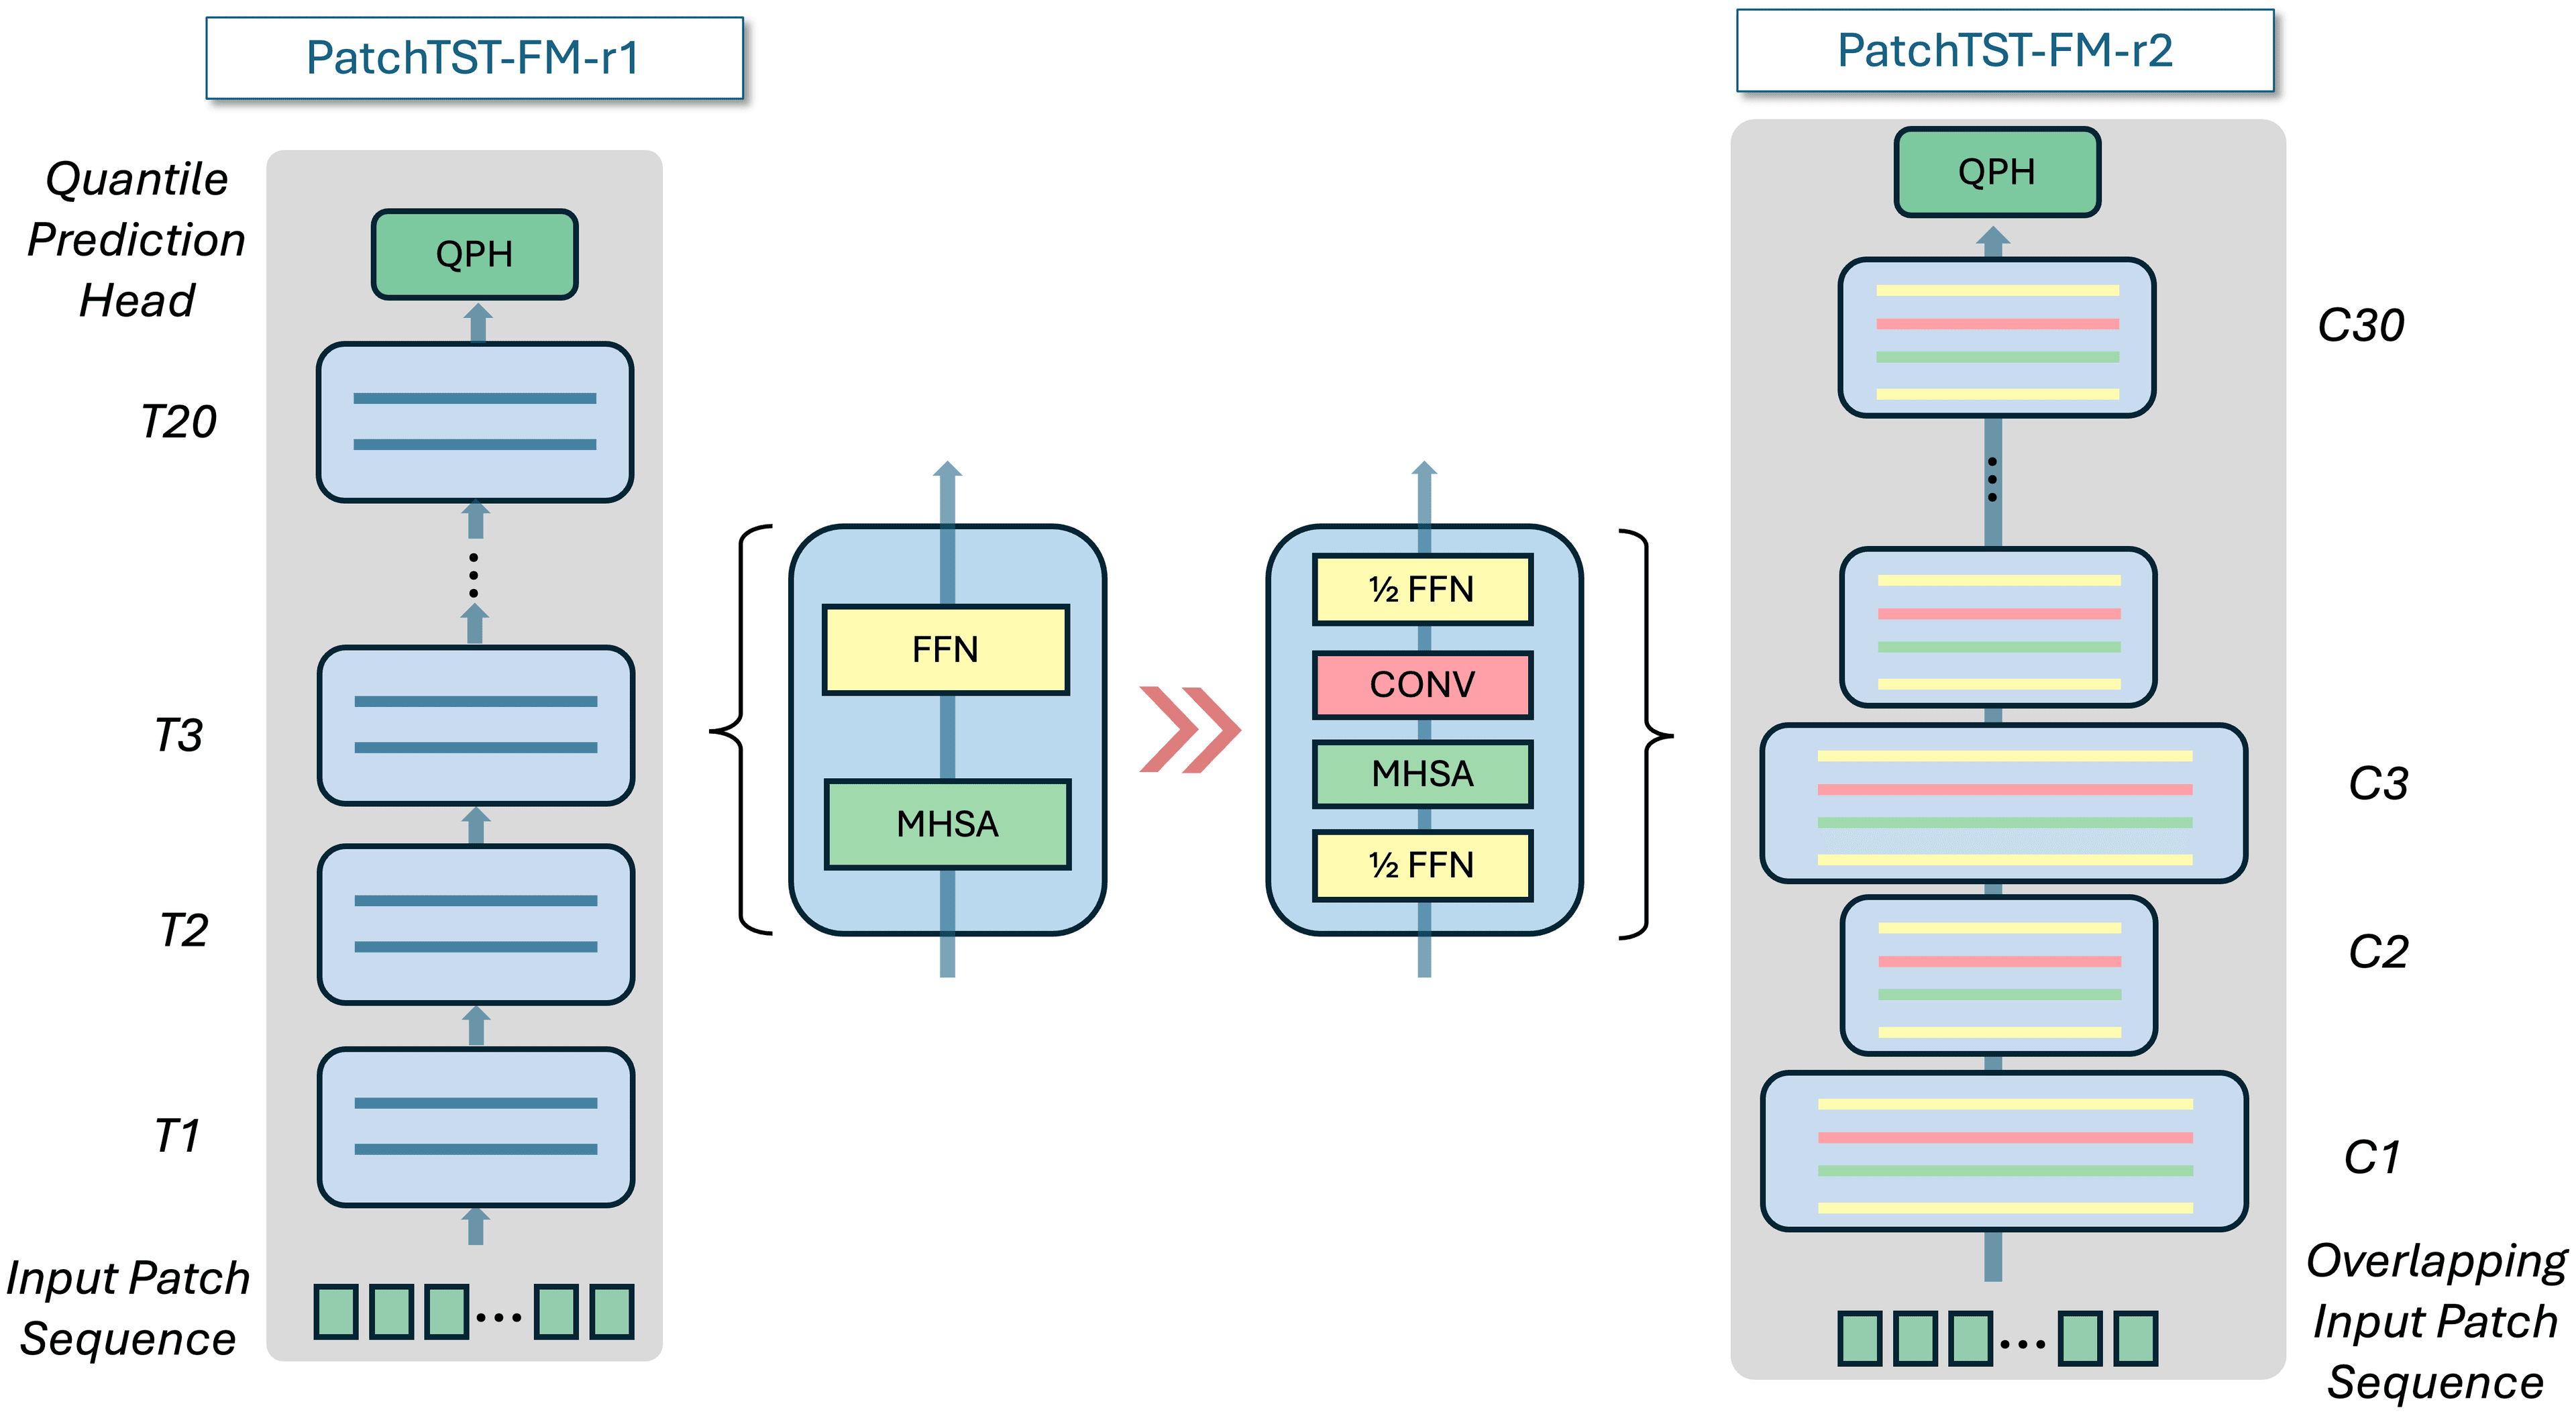
รูปที่ 5. วิวัฒนาการจาก PatchTST-FM-r1 ไปสู่ PatchTST-FM-r2 ที่ใช้โครงสร้าง Conformer
โครงสร้างแบบ conformer ในรุ่น r2 ประกอบด้วยเลเยอร์ feed-forward แบบครึ่งก้าวขนาบข้างเลเยอร์ self-attention และ temporal convolution วิธีนี้ช่วยให้โมเดลมีกลไกคู่ขนาน โดย self-attention จะทำหน้าที่ดูความสัมพันธ์ระยะไกล ขณะที่ convolution ช่วยดึงข้อมูลโครงสร้างระยะสั้น ทำให้โมเดลจดจ่อกับข้อมูลได้แม่นยำขึ้น ดังที่เห็นในรูปแบบ attention patterns ของรูปที่ 6
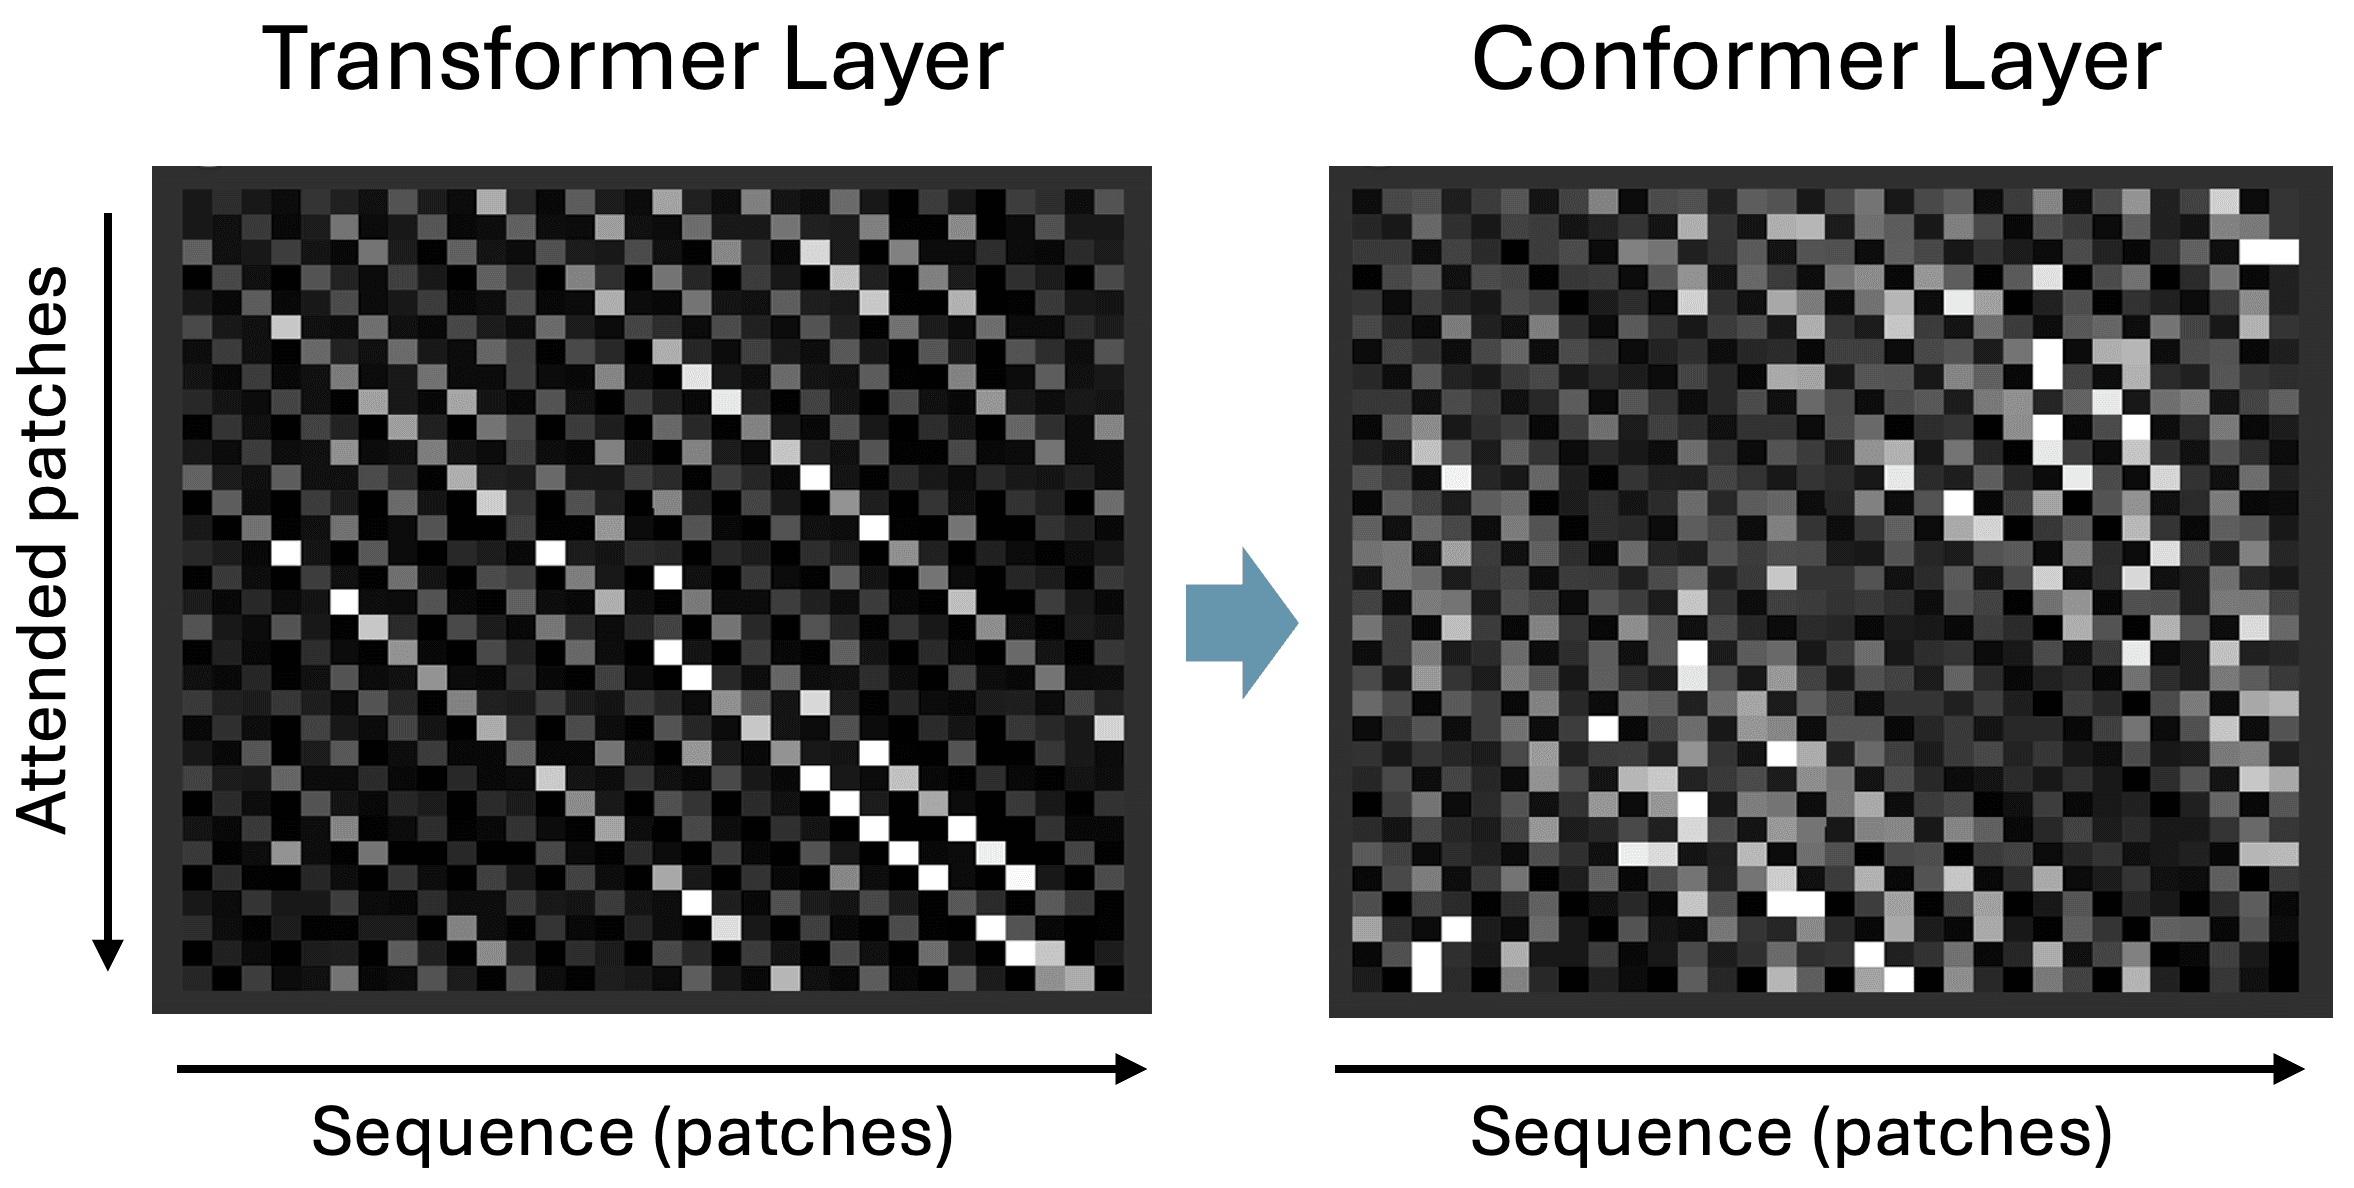
รูปที่ 6. การเปรียบเทียบรูปแบบการจดจ่อ (attention) ระหว่าง transformer (ซ้าย) และ conformer (ขวา) บนชุดข้อมูล ETTh1
นอกจากนี้ r2 ยังใช้เทคนิค patch ที่ทับซ้อนกัน 50% ร่วมกับ Hamming-window และการพยากรณ์แบบ overlap-and-add เพื่อลดรอยต่อระหว่าง patch พร้อมขยายจำนวนบล็อกเพิ่มขึ้นจาก 20 เป็น 30 บล็อก ส่งผลให้โมเดลขนาด 385 ล้านพารามิเตอร์นี้ รองรับบริบทได้ถึง 8,192 ขั้น และให้ผลลัพธ์ทั้งแบบจุดเดียว (point forecasts) และแบบกระจายตัว (quantile)
ความโปร่งใสของข้อมูลการฝึกฝน
IBM ให้ความสำคัญกับความโปร่งใสของคุณภาพข้อมูล โดย PatchTST-FM-r2 ฝึกฝนจากแหล่งข้อมูลที่ระบุที่มาได้ชัดเจน 4 แหล่ง ได้แก่ ชุดข้อมูลที่เลือกจาก GiftEvalPretrain, ข้อมูลสังเคราะห์ KernelSynth, คลังข้อมูล TSMixup (เฉพาะข้อมูลนอกชุดประเมิน) และลำดับสังเคราะห์ CauKer จำนวน 500,000 ชุด
ความโปร่งใสนี้นับเป็นปัจจัยสำคัญสำหรับผู้ใช้งานระดับองค์กรในการตรวจสอบธรรมาภิบาลข้อมูลและสัญญาอนุญาต ซึ่งช่วยให้การนำ AI ไปใช้ในธุรกิจมีความมั่นใจมากกว่าการใช้โมเดลที่ฝึกจากแหล่งข้อมูลที่ไม่เปิดเผย
เปิดกว้างสำหรับการวิจัยและการค้า
Granite Time Series PatchTST-FM-r2 ใช้สัญญาอนุญาตแบบคู่ (Dual License) ระหว่าง Apache 2.0 และ OpenMDW 1.0 เพื่อให้ยืดหยุ่นต่อทั้งนักวิจัยและภาคธุรกิจ
การใช้สัญญาอนุญาตแบบผ่อนปรนนี้มีวัตถุประสงค์เพื่อลดอุปสรรคในการเข้าถึงเทคโนโลยี โดยผู้สนใจสามารถใช้งานสถาปัตยกรรมผ่าน Granite-TSFM repository ซึ่งรองรับการทำงานร่วมกับ checkpoint เดิมของรุ่น r1 ได้ด้วย
เริ่มต้นใช้งาน PatchTST-FM-r2 ด้วย Python
คุณสามารถทดสอบประสิทธิภาพของโมเดลกับข้อมูลของคุณเองได้ง่ายๆ เริ่มจากการติดตั้งแพ็กเกจ:
pip install "granite-tsfm>=0.3.9"จากนั้นโหลดโมเดลจาก Hugging Face Hub มาใช้งานตามตัวอย่างโค้ดนี้:
import pandas as pd
from tsfm_public import PatchTSTFMForPrediction, TimeSeriesForecastingPipeline

# Load model weights
model = PatchTSTFMForPrediction.from_pretrained(
    "ibm-granite/granite-timeseries-patchtst-fm-r2"
)

# Read some sample data from ETTh
df = pd.read_csv(
    "https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
    parse_dates=["date"],
)

# Set up the forecasting pipeline
pipe = TimeSeriesForecastingPipeline(
    model=model,
    id_columns=[],
    timestamp_column="date",
    target_columns=["HUFL"],
    max_context_length=model.config.context_length,
    context_length=512,
    prediction_length=64,
    impute_method=None,
    quantile_levels=[0.1, 0.5, 0.9],
    explode_forecasts=True,
    freq="1h",
)

# Create a forecast from the last 512 samples of the input dataframe
forecast = pipe(df.iloc[-512:])
จุดเด่นคือไม่จำเป็นต้องทำ fine-tuning หรือปรับแต่งค่าพารามิเตอร์ให้ยุ่งยาก ไปป์ไลน์จะคำนวณจากประวัติย้อนหลังและพยากรณ์ผลลัพธ์ในอนาคตให้ทันที เหมาะสำหรับข้อมูลทุกประเภทไม่ว่าจะเป็นปริมาณธุรกรรม, การใช้พลังงาน หรือราคาหุ้นที่มีการจัดเก็บอย่างสม่ำเสมอ
ลองใช้กับข้อมูลของคุณเอง: เปิด PatchTST-FM-r2 บน Hugging Face Hub
จากการวิจัยสู่ระบบสตรีมมิ่งข้อมูลจริง
การเปิดตัวครั้งนี้เป็นส่วนหนึ่งของยุทธศาสตร์ IBM Granite Time Series ในการขยายพอร์ตโฟลิโอโมเดลให้ครอบคลุมการใช้งานในระดับเอนเตอร์ไพรส์
สำหรับระบบที่ต้องการการประมวลผลข้อมูลแบบเรียลไทม์ IBM ได้ร่วมกับ Confluent เปิดตัวโมเดล Granite หลายรุ่นผ่านโปรแกรม Early Access ใน Confluent Cloud ซึ่งรวมถึง PatchTST-FM-r1, FlowState-r1.1, TTM-r3 และ TSPulse
การบูรณาการนี้ช่วยให้สามารถรันโมเดลพยากรณ์และตรวจจับความผิดปกติบน Apache Flink ได้โดยตรงจากสตรีมข้อมูลสด ช่วยลดขั้นตอนที่ซับซ้อนในการย้ายข้อมูลไปยังสภาพแวดล้อม ML อื่นๆ และเพิ่มประสิทธิภาพในการตัดสินใจทางธุรกิจแบบทันท่วงที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร