
NVIDIA เปิดตัว Cosmos 3 Edge โมเดลโลกขนาด 4 พันล้านพารามิเตอร์เพื่อ Physical AI บนอุปกรณ์ Edge
โลกแห่งความเป็นจริงนั้นกว้างใหญ่และซับซ้อน การที่ระบบ Physical AI จะทำงานได้อย่างมีประสิทธิภาพจำเป็นต้องเข้าใจความเปลี่ยนแปลงของสภาพแวดล้อม คาดการณ์ล่วงหน้า และระบุได้ว่าการกระทำหนึ่งๆ จะส่งผลกระทบต่อโลกอย่างไร
ปัจจุบันเครื่องจักรต่างๆ ต้องปฏิบัติงานอยู่ ณ สถานีปลายทาง (edge) เช่น ในโรงงาน คลังสินค้า หรือโรงพยาบาล ซึ่งต้องการโมเดลที่มีประสิทธิภาพสูงระดับดาต้าเซ็นเตอร์ แต่ต้องทำงานภายใต้ข้อจำกัดด้านหน่วยความจำของระบบเหล่านั้นได้
ล่าสุด NVIDIA จึงได้เปิดตัว NVIDIA Cosmos 3 Edge บน Hugging Face โดยเป็นโมเดลโลกแบบเปิด (Open World Model) ขนาด 4 พันล้านพารามิเตอร์ ออกแบบมาเพื่อช่วยให้หุ่นยนต์และ AI เอเจนต์ด้านการมองเห็นสามารถเข้าใจสภาพแวดล้อม ให้เหตุผลในเวลาจริง และสร้างการกระทำของหุ่นยนต์ได้โดยตรงบนอุปกรณ์ edge
ดาวน์โหลดโมเดล: https://huggingface.co/nvidia/Cosmos3-Edge
โมเดลนี้รองรับการทำ Inference ที่ประหยัดหน่วยความจำและมีทรูพุตสูง ครอบคลุมคอมพิวเตอร์ edge ของ NVIDIA หลากหลายรุ่น ตั้งแต่ NVIDIA RTX PRO GPU, NVIDIA DGX, NVIDIA GeForce RTX™ GPU ไปจนถึง NVIDIA Jetson รวมถึงโมดูล Jetson T2000 และ T3000 ที่เพิ่งเปิดตัวใหม่
ด้วยการออกแบบให้เป็นโมเดลขนาดกะทัดรัด Cosmos 3 Edge สามารถทำหน้าที่เป็นโมเดลภาษาและการมองเห็นขนาดเล็ก (VLM) ที่มีความแม่นยำสูงและมีทรูพุตที่ดีที่สุดในระดับเดียวกันสำหรับการใช้งานแบบเวลาจริง
ในฐานะโมเดลการกระทำของโลก (World Action Model หรือ WAM) ที่ผ่านการฝึกฝนขั้นสูงมาแล้ว Cosmos 3 Edge ทำงานที่ความละเอียดระดับการควบคุมหุ่นยนต์ (640×360) สามารถให้เหตุผลและสร้างการกระทำได้ถึง 32 อย่างต่อการทำ inference หนึ่งครั้งบน NVIDIA Jetson Thor โดยยังคงการควบคุมที่ความถี่ 15 Hz
นอกจากนี้ Cosmos 3 Edge ยังครองอันดับ #1 ใน VANTAGE-Bench สำหรับโมเดลขนาด 4B พารามิเตอร์ในด้านการวิเคราะห์การมองเห็น (Vision Analytics) และเป็นผู้นำด้านการเรียนรู้นโยบายหุ่นยนต์ (Robot Policy Learning) ซึ่งถือเป็นการสร้างมาตรฐานใหม่ให้กับโครงสร้างพื้นฐานอัจฉริยะ
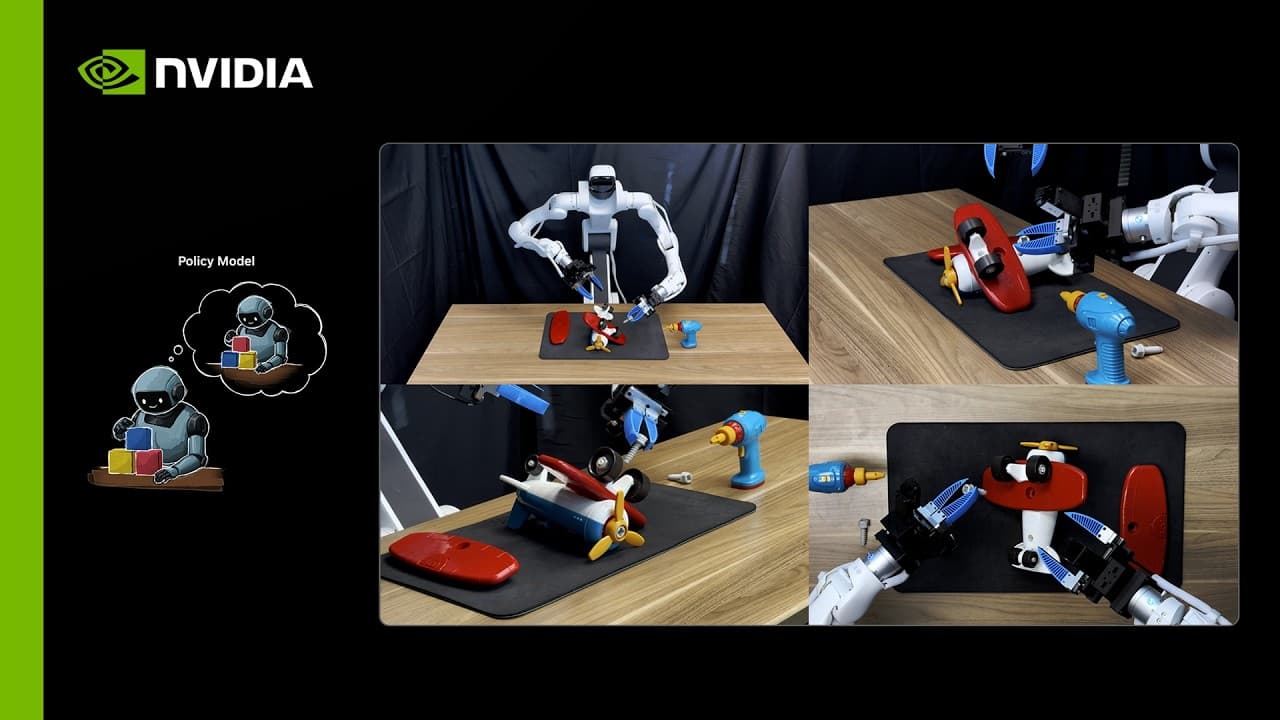
World Modeling คืออะไร?
โมเดลโลก (World Model) คือระบบที่เรียนรู้ว่าสภาพแวดล้อมเปลี่ยนแปลงไปตามกาลเวลาอย่างไร โดยทำหน้าที่เป็นตัวแทนของวัตถุ การเคลื่อนไหว ความสัมพันธ์เชิงพื้นที่ และผลกระทบจากการกระทำต่างๆ
ยกตัวอย่างเช่น เมื่อหุ่นยนต์ต้องหยิบวัตถุ การจดจำวัตถุได้เป็นเพียงขั้นแรก แต่หุ่นยนต์ยังต้องเข้าใจด้วยว่าวัตถุตั้งอยู่ตรงไหน มือจับต้องเคลื่อนที่อย่างไร จะเกิดอะไรขึ้นเมื่อมีการสัมผัส และการกระทำใดที่จะช่วยให้งานสำเร็จได้ดีที่สุด
โมเดลโลกช่วยให้หุ่นยนต์ให้เหตุผลเกี่ยวกับความสัมพันธ์เหล่านี้ได้ โดยสามารถทำนายผลลัพธ์ผ่านภาพจำลอง หรืออนุมานการกระทำที่จำเป็นเพื่อให้ได้ผลลัพธ์ที่ต้องการ ซึ่ง Cosmos 3 Edge ได้รวมความสามารถเหล่านี้ไว้ในโมเดลเดียวเพื่อให้ระบบเข้าใจสถานะปัจจุบันและจำลองอนาคตที่เชื่อมโยงกับการกระทำได้ทันที
Two Transformer Towers, One Shared Representation
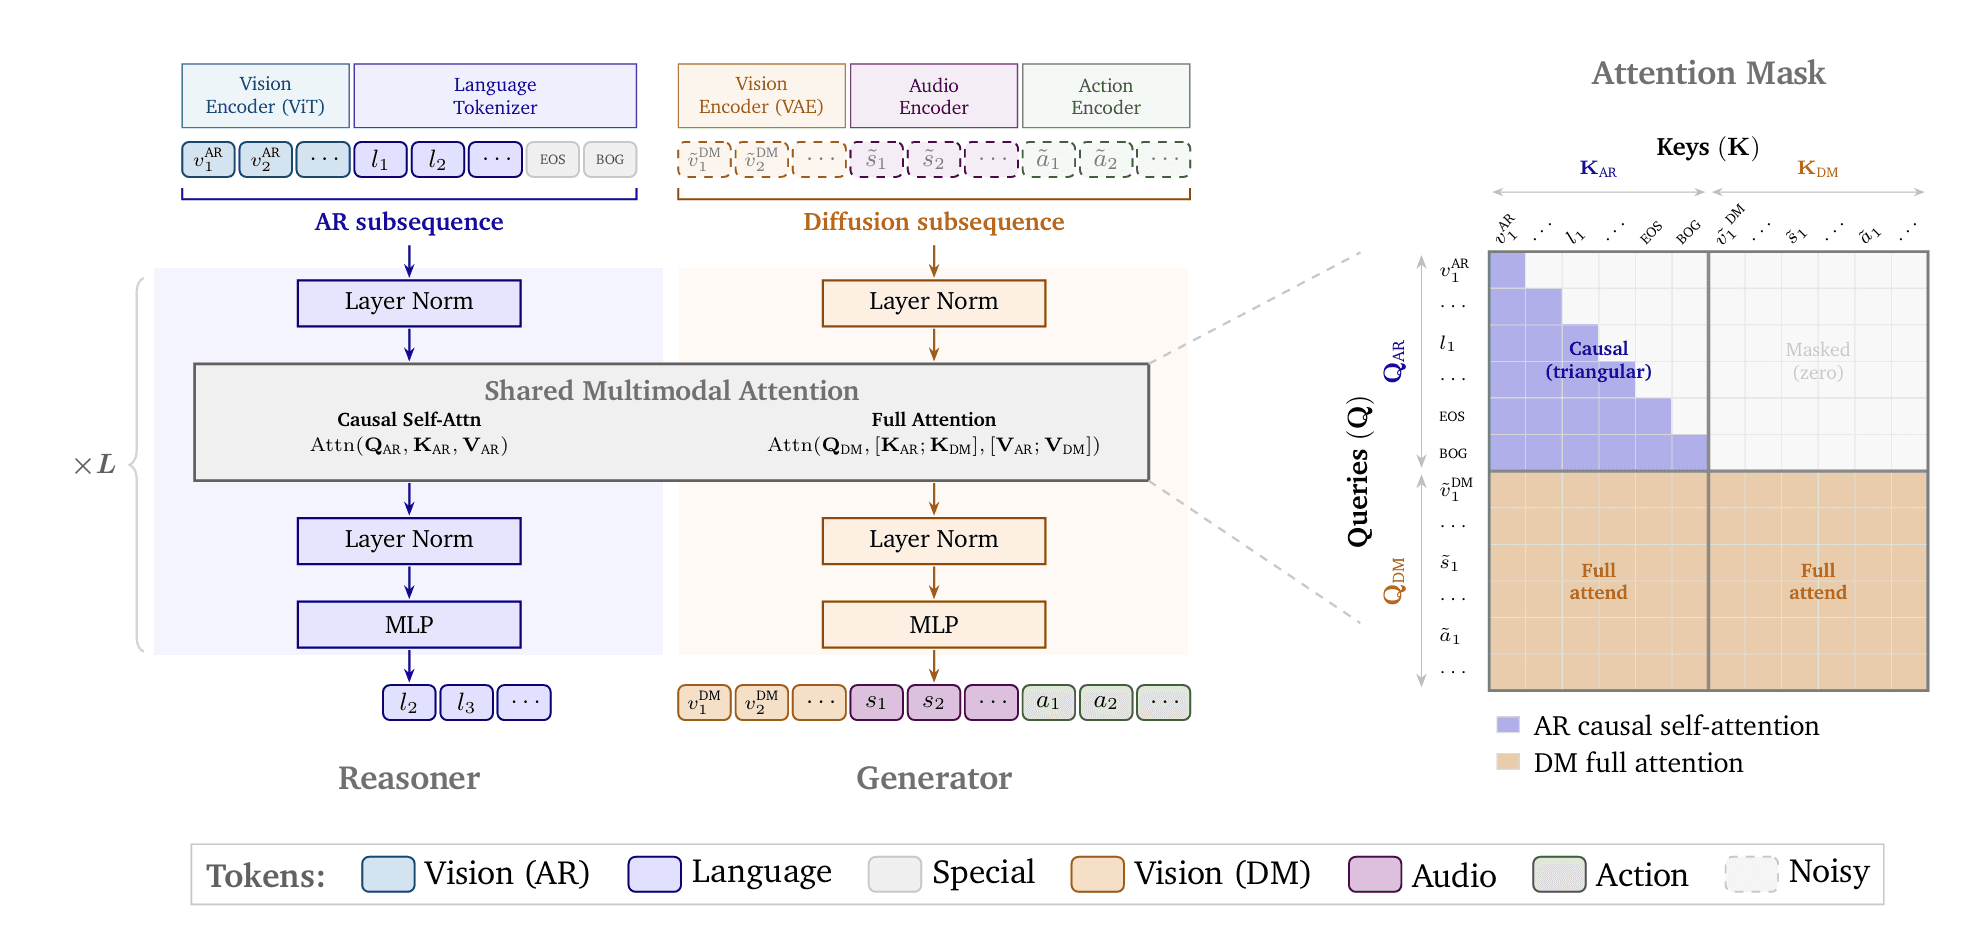
โครงสร้างของ Cosmos 3 ประกอบด้วย Transformer Tower สองส่วนที่ทำงานร่วมกัน:
- Autoregressive tower: ทำหน้าที่ประมวลผลโทเค็นภาพและข้อความ เพื่อความเข้าใจและการให้เหตุผล
- Diffusion tower: ประมวลผลโทเค็นภาพ เสียง และการกระทำ เพื่อการทำนาย การสร้าง และการจำลองผ่านโครงข่ายประสาท (Neural Simulation)
แม้ทั้งสองส่วนจะแยกเลเยอร์การประมวลผลบางส่วนออกจากกัน แต่มีการใช้เลเยอร์ Multimodal Attention ร่วมกัน เพื่อจัดแนวข้อมูลทั้งด้านภาษา วิดีโอ เสียง และการกระทำ ให้สอดคล้องกันอย่างสมบูรณ์
การออกแบบนี้เปิดโอกาสให้โมเดลให้เหตุผลเกี่ยวกับฉากก่อนสร้างผลลัพธ์ โดยสามารถเลือกสร้างโทเค็นการให้เหตุผลจาก Autoregressive Tower หรือสร้างวิดีโอจำลองและการกระทำจาก Diffusion Tower ตามความเหมาะสมของงานนั้นๆ
นอกจากนี้ยังมีการปรับรูปแบบ Attention ให้เหมาะกับประเภทข้อมูล เช่น ภาษาจะใช้ Causal Attention ในขณะที่ข้อมูลแบบ Diffusion จะได้รับบริบทที่กว้างกว่า เพื่อให้การทำนายและการสร้างข้อมูลมีความต่อเนื่องและสมเหตุสมผล
การแสดงแทนข้อมูลร่วมกันสำหรับการกระทำ เนื่องจากระบบกายภาพแต่ละชนิดอธิบายการกระทำต่างกัน เช่น ยานพาหนะใช้ท่าทางการเคลื่อนที่ กล้องใช้การแพน และแขนหุ่นยนต์ใช้ตำแหน่งปลายมือ Cosmos 3 จึงทำการจับคู่รูปแบบที่แตกต่างกันเหล่านี้เข้ากับการแสดงแทนการกระทำร่วมกันในรูปแบบเวกเตอร์ทางเรขาคณิต ซึ่งรวมถึงการเลื่อนตำแหน่ง การหมุน และสถานะการจัดการ
สิ่งนี้สร้างการเชื่อมโยงโดยตรงระหว่างการควบคุมและโครงสร้างทางภาพ ทำให้วิดีโอที่จำลองออกมาไม่ใช่แค่ภาพพยากรณ์ แต่เป็นภาพที่สะท้อนว่าโลกจะเปลี่ยนไปอย่างไรตามการกระทำจริง ช่วยให้นักพัฒนามีข้อมูลการฝึกฝนที่อิงอยู่บนพื้นฐานของเหตุและผล
โหมดนโยบาย (Policy Mode)
ในฐานะนโยบาย (Policy) Cosmos 3 จะทำนายการกระทำควบคู่ไปกับผลลัพธ์ทางภาพที่คาดหวังได้ในคราวเดียว โดยการใส่สถานะปัจจุบันเข้าไป สิ่งที่ได้ออกมาคือการกระทำที่ควรทำและภาพจำลองสถานะถัดไป
ความสามารถนี้ช่วยให้ Cosmos 3 Edge สามารถทำนายผลกระทบของการกระทำ หรือในทางกลับกัน คือการอนุมานหาการกระทำจากผลกระทบที่ต้องการได้ (Inverse Reasoning)
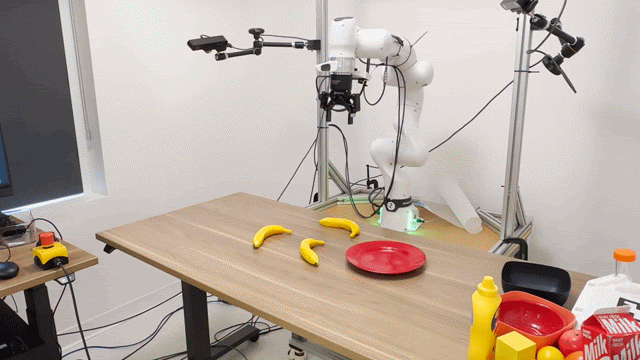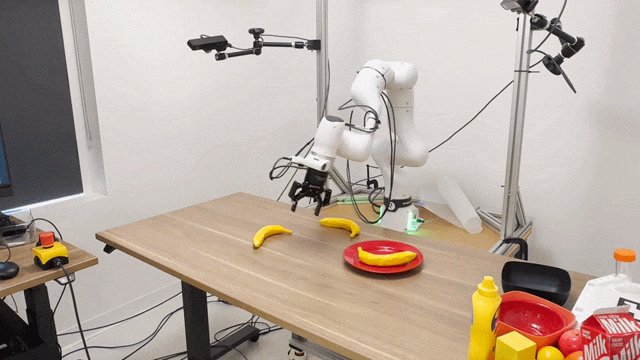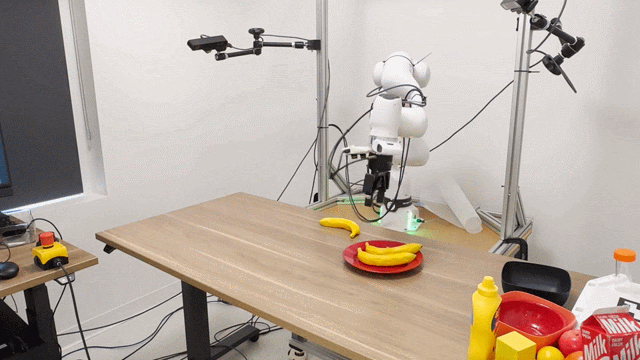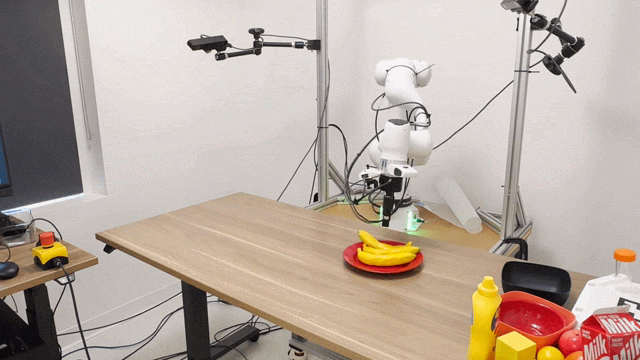
Prompt: หยิบกล้วยและวางลงในจาน
NVIDIA ได้ปล่อย Cosmos 3 Edge Policy (DROID) ซึ่งเป็นนโยบายการจัดการหุ่นยนต์สำหรับการงานหยิบและวางที่ผ่านการฝึกฝนมาแล้ว พร้อมสคริปต์สำหรับให้นักพัฒนานำไปปรับจูน (fine-tune) ต่อได้ด้วยคลัสเตอร์ขนาดเล็กอย่าง H100 ก่อนนำไปติดตั้งจริง
ตัวอย่างที่ผ่านการ Post-trained เพื่อประสิทธิภาพที่เพิ่มขึ้น
นอกจากโมเดลพื้นฐานแล้ว ยังมีการเปิดตัว Checkpoints และสูตรการฝึกฝนที่เป็นการทำ Post-training เพื่อให้เป้าหมายมีความแม่นยำยิ่งขึ้นในแอปพลิเคชันเฉพาะทาง
หนึ่งในตัวอย่างที่สำคัญคือ Cosmos 3 Super 4-Step Distillation ซึ่งมาพร้อมสคริปต์ที่ช่วยลดขั้นตอนการทำ Diffusion จากปกติ 35–50 ขั้นตอน เหลือเพียง 4 ขั้นตอน ทำให้การทำ Inference เร็วขึ้นสูงสุดถึง 25 เท่า โดยที่ยังคงคุณภาพและความสมจริงของภาพและวิดีโอไว้ได้
ลองใช้งาน Cosmos 3 Edge
ดาวน์โหลดโมเดล: https://huggingface.co/nvidia/Cosmos3-Edge
Cosmos 3 Edge พร้อมแล้วที่จะเป็นหัวใจสำคัญในการเชื่อมโยงการทำนายและการกระทำสำหรับนักพัฒนาที่ต้องการติดตั้งระบบไว้ใกล้กับเซ็นเซอร์บนอุปกรณ์
ดูรายละเอียดเพิ่มเติมได้ที่: https://huggingface.co/collections/nvidia/cosmos3
สิ่งที่กำลังจะมาในอนาคต
NVIDIA ยังคงเดินหน้าพัฒนา Cosmos 3 อย่างต่อเนื่อง โดยมุ่งเน้นไปที่การสร้างโลกแบบโต้ตอบ (Interactive World Generation) การจำลองสถานการณ์ขับขี่ และนโยบายหุ่นยนต์รุ่นใหม่ๆ นอกจากนี้ยังมีการลงทุนด้านการทำ Inference ให้เร็วขึ้นและการใช้เครื่องมืออย่าง vLLM เพื่อลดทรัพยากรที่จำเป็นในการสร้างโมเดลสำหรับงานเฉพาะทางต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร