
Iris-mini และ Iris-pro ขึ้นแท่น Search Agents แบบ Open-weight ที่แข็งแกร่งที่สุดในปัจจุบัน
ทีม AllSpark ได้ปล่อย Iris-mini และ Iris-pro สองเสิร์ชเอเจนต์แบบ Open-source พร้อมกับสูตรการฝึกฝน (training recipe) แบบฉบับเต็ม จากข้อมูลในรายงานวิจัย ข้อมูลที่ใช้ฝึกฝนและตัวโมเดลยังช่วยเพิ่มประสิทธิภาพในงานที่ไม่เคยถูกฝึกมาก่อน รวมถึงการใช้เครื่องมือทั่วไปและงานสำนักงาน โดยปกติแล้ว เสิร์ชเอเจนต์ที่สร้างบนโมเดลภาษาจะทำการวิจัยบนเว็บด้วยตนเอง ซึ่งต้องอาศัยความเข้าใจในคำถาม ตัดสินใจเลือกสิ่งที่ควรค้นหา ตีความผลลัพธ์ และประเมินว่ามีหลักฐานเพียงพอสำหรับคำตอบแล้วหรือไม่ อย่างไรก็ตาม สิ่งที่โมเดลทำจริงยังคงเป็นที่ถกเถียงกันในวงการ เนื่องจากผลทดสอบ Benchmark ส่วนใหญ่มักพบว่าระบบ AI ชั้นนำมักใช้เว็บเพื่อ ยืนยันความรู้ที่พวกมันได้รับมาแล้วในระหว่างการฝึกฝน เท่านั้น
ในรายงานวิจัยฉบับใหม่ ห้องปฏิบัติการ AllSpark จากประเทศจีนได้อธิบายถึงเสิร์ชเอเจนต์สองขนาด ได้แก่ Iris-mini ที่มีพารามิเตอร์ 35 พันล้านตัว และ Iris-pro ที่มี 397 พันล้านตัว ทั้งคู่พัฒนาต่อยอดจากโมเดลซีรีส์ Qwen (Qwen3.6-35B-A3B และ Qwen3.5-397B-A17B) โดยมาพร้อมกับ Context Window ขนาด 256,000 โทเคน ซึ่งทีมงานระบุว่าให้ผลลัพธ์ที่แข็งแกร่งที่สุดในบรรดาเสิร์ชเอเจนต์แบบ Open-weight ในระดับเดียวกัน
คำถามสำหรับฝึกฝนถูกทำวิศวกรรมย้อนกลับจากโครงสร้างลิงก์ของเว็บ
กระบวนการฝึกฝน (training pipeline) ของโมเดลนี้ใช้วิธีสร้างงานย้อนกลับจากโครงสร้างลิงก์ของหน้าเว็บ โดยเริ่มจากหน้าตั้งต้น (seed page) และลิงก์ขาออกเพื่อสร้างกราฟความสัมพันธ์ของคำศัพท์ จากนั้นจึงสร้างคำถามแบบหลายขั้นตอนที่ต้องอาศัยการเชื่อมโยงข้อมูลหลายจุดในการหาคำตอบ
นอกจากนี้ ทุกคำศัพท์ยกเว้นคำตอบสุดท้ายจะถูกแทนที่ด้วยการถอดความ (paraphrase) เพื่อป้องกันไม่ให้โมเดลหาคำตอบได้จากการค้นหาข้อความแบบง่ายๆ ทำให้เอเจนต์ต้องใช้ทักษะการใช้เหตุผลจริงจังในการแก้ปัญหา เฉพาะคำถามที่พิสูจน์แล้วว่าไม่สามารถแก้ได้หากไม่มีเครื่องมือ แต่สามารถแก้ได้เมื่อมีแหล่งข้อมูลที่ถูกต้องเท่านั้นที่จะถูกนำมาใช้ฝึกฝน เพื่อให้มั่นใจว่างานมีความยากและตรวจสอบผลได้ชัดเจน
การกรองสองขั้นตอนช่วยกำจัดข้อมูลฝึกฝนที่ไม่ดี
ในขั้นตอนการเตรียมข้อมูล จะมีโมเดลครู (teacher model) ที่แข็งแกร่งกว่าทำหน้าที่สร้างเส้นทางการแก้ปัญหา ซึ่งประกอบด้วยการใช้เหตุผล คำค้นหา และผลลัพธ์ โดยเส้นทางเหล่านี้ต้องผ่านการกรองสองรอบ รอบแรกตรวจสอบความถูกต้องและความลึกของการค้นหา ส่วนรอบที่สองเป็นการตรวจสอบทีละขั้นตอนโดยโมเดลตัดสิน (judge model) ที่ใช้เกณฑ์จากตัวข้อมูลเองแทนการตั้งค่าด้วยมือ
หลังจากนั้น โมเดลจะถูกปรับปรุงผ่านการเรียนรู้แบบเสริมกำลัง (reinforcement learning) กับการค้นหาบนเว็บจริง โดยกระบวนการทั้งหมดทำงานภายในคลัสเตอร์การฝึกฝนของทีมงานเองผ่านโมเดล Qwen ขนาดใหญ่ เพื่อลดการพึ่งพาบริการภายนอก ทีมงานเรียกกระบวนการที่สลับกันระหว่างการปรับจูนแบบมีผู้สอนและการเรียนรู้แบบเสริมกำลังนี้ว่า "SFT-RL climbing" ซึ่งจะช่วยคัดกรองเฉพาะงานที่ยากที่สุดและวิธีแก้ที่มีประสิทธิภาพที่สุดเข้าสู่รอบการฝึกฝนถัดไป
การจัดการบริบทอาจสำคัญกว่าความแตกต่างของโมเดล
ทีมงานให้ความเห็นว่า การจัดการบริบท (context management) มีผลต่อคะแนน Benchmark มากกว่าความแตกต่างของตัวโมเดลเอง เนื่องจากในงานวิจัยที่ใช้เวลานาน บริบท (context) มักจะเต็มก่อนที่เอเจนต์จะแก้คำถามย่อยเสร็จ ซึ่งการใช้เทคนิคอย่างการทิ้งประวัติการสนทนาอาจช่วยให้การวิจัยดำเนินต่อได้ แต่อาจไม่ได้สะท้อนคุณภาพที่แท้จริงของโมเดล เพื่อพิสูจน์เรื่องนี้ ทีมงานได้ทดสอบทุก Benchmark ทั้งแบบที่เปิดและปิดการจัดการบริบท โดยควบคุมปัจจัยอื่นๆ ให้คงที่ พบว่าคะแนนของ Iris มาจากศักยภาพของเอเจนต์ตัวเดียวเพียวๆ โดยไม่มีเอเจนต์ผู้ช่วยหรือขั้นตอนการตรวจสอบเพิ่มเติมในตอนท้าย ซึ่งช่วยให้เห็นประสิทธิภาพที่แท้จริงของตัวโมเดลและระบบสนับสนุน (scaffolding) ได้ชัดเจนขึ้น
ผลลัพธ์จากสี่ Benchmark
การทดสอบครอบคลุม 4 ด้าน ได้แก่ BrowseComp (การค้นหาข้อเท็จจริงที่หายาก), BrowseComp-ZH (เวอร์ชันภาษาจีน), DeepSearchQA (ความครบถ้วนของหลักฐาน) และ Humanity's Last Exam (คำถามวิชาการระดับผู้เชี่ยวชาญ)
เมื่อเปิดการจัดการบริบท Iris-mini ทำคะแนนได้ 82.2, 84.8, 86.9 และ 52.3 ตามลำดับ ส่วน Iris-pro ทำได้ 88.6, 85.1, 92.9 และ 56.4 โดยในกลุ่มโมเดลขนาดเล็ก Iris-mini นำเป็นอันดับหนึ่งใน 3 จาก 4 Benchmark และชนะโมเดลคู่แข่งอย่าง XYZ-Aquila-mini ใน BrowseComp ไปถึง 3.4 คะแนน ขณะที่ Iris-pro ก็มีประสิทธิภาพใกล้เคียงกับระบบที่ใช้ทรัพยากรประมวลผลสูงกว่ามาก
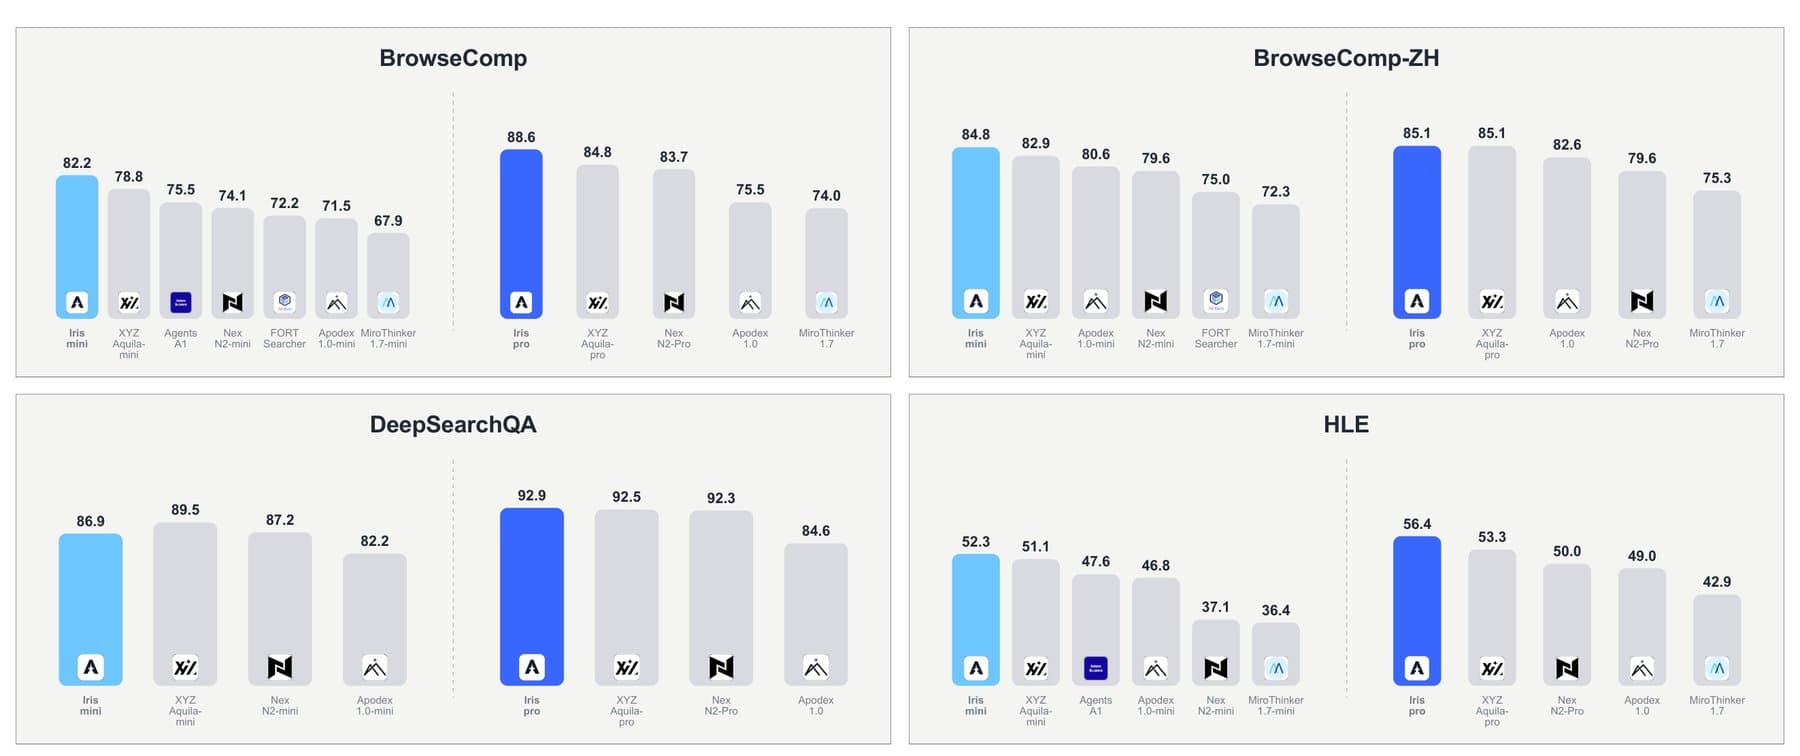
ทั้งนี้ การจัดการบริบทส่งผลต่อโมเดลขนาดเล็กอย่างมาก โดยช่วยเพิ่มคะแนนใน BrowseComp ได้สูงสุดถึง 21.2 คะแนน เนื่องจากโมเดลขนาดเล็กมักใช้ขั้นตอนในการทำงานมากกว่าและใช้พื้นที่บริบทหมดเร็วกว่า ส่วนใน Humanity's Last Exam ผลลัพธ์เพิ่มขึ้นเพียงเล็กน้อยเพราะเน้นความรู้เฉพาะทาง ซึ่งทีมงานใช้วิธีสรุปโน้ตสั้นๆ จากการพยายามครั้งแรกเพื่อช่วยในการรันครั้งถัดไป
เมื่อข้อมูลจริง (Ground Truth) ผิดพลาด
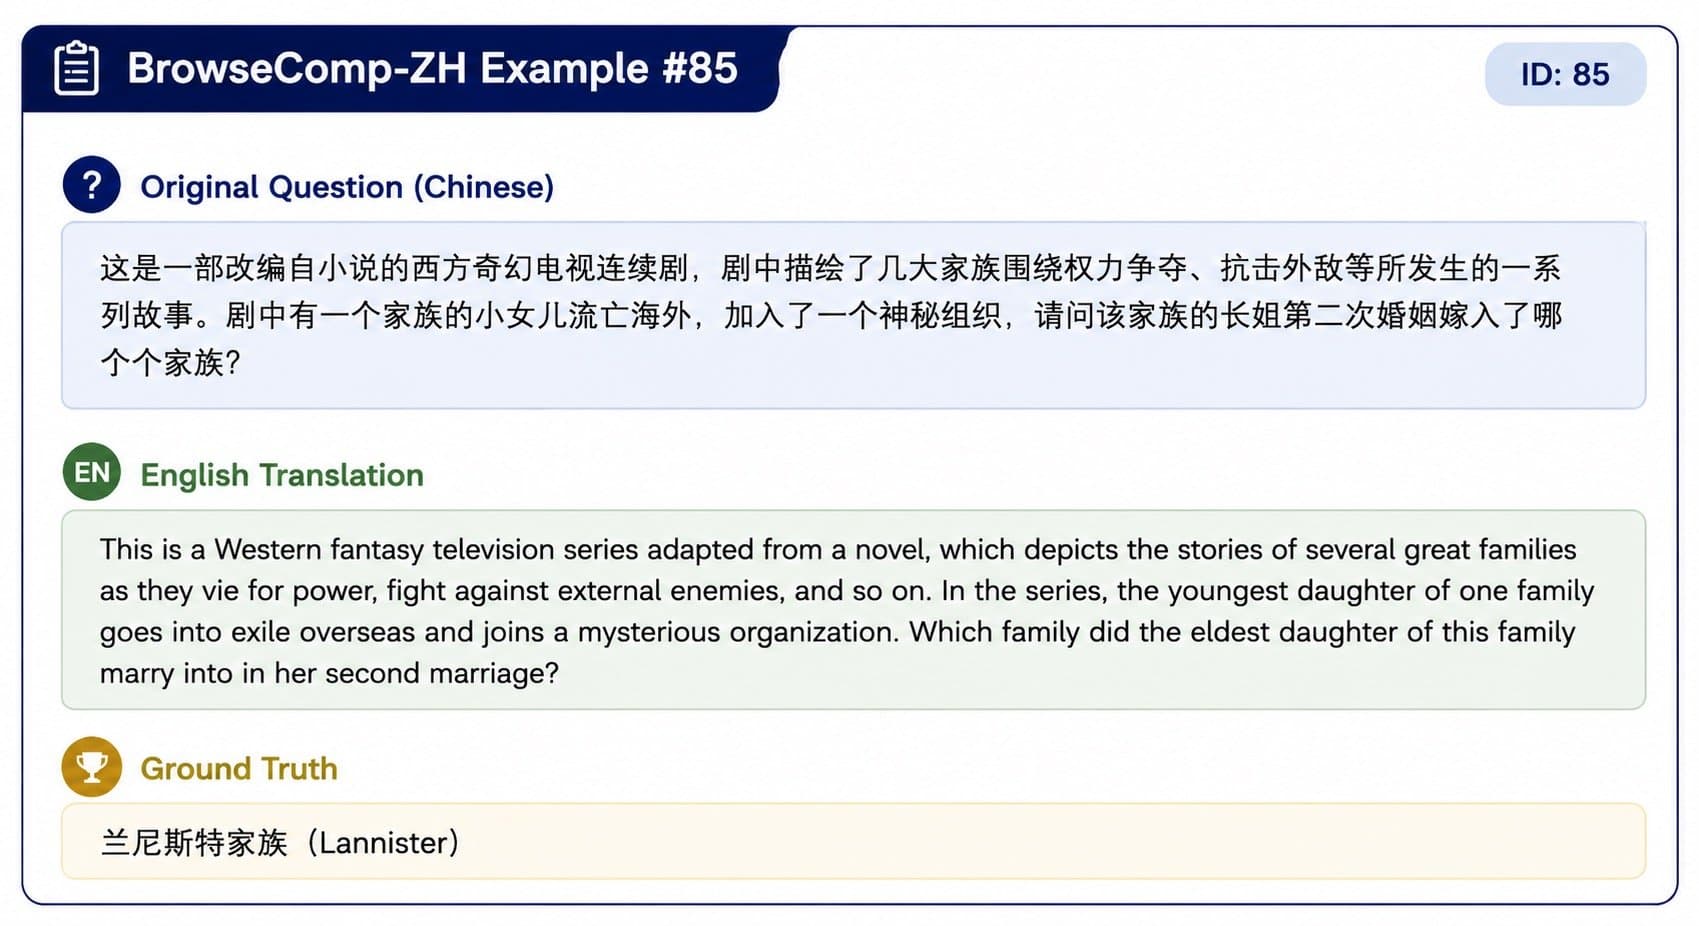
ในภาคผนวกของรายงาน ทีมงานได้ยกตัวอย่างกรณีที่เอเจนต์ตอบถูกแต่ถูกระบบตรวจว่าผิด เช่น คำถามเกี่ยวกับซีรีส์ "Game of Thrones" ซึ่งเอเจนต์ตอบว่าตัวละคร Sansa Stark แต่งงานกับ "Bolton" แต่ข้อมูลอ้างอิงระบุว่า "Lannister" ซึ่งในความเป็นจริง Sansa แต่งงานกับ Ramsay Bolton ในการแต่งงานครั้งที่สอง ความคลาดเคลื่อนนี้ทำให้ทีมงานมุ่งมั่นที่จะสร้าง Benchmark ที่แม่นยำยิ่งขึ้นในอนาคต
นอกจากทักษะการค้นหาแล้ว ทีมงานยังพบว่าโมเดลมีการพัฒนาในงานที่ไม่เคยฝึกมาก่อน เช่น งานสำนักงานและการใช้เครื่องมือทั่วไป ซึ่งชี้ให้เห็นว่าทักษะการค้นหาข้อมูลอาจเป็นรากฐานสำคัญที่ช่วยให้เอเจนต์ทำงานกับข้อมูลที่ไม่สมบูรณ์ได้ดีขึ้นในทุกๆ ด้าน
ปัจจุบันน้ำหนักของโมเดล (model weights) ทั้ง Iris-mini และ Iris-pro เปิดให้ใช้งานแล้วใน คอลเลกชันบน Hugging Face และโค้ดบน GitHub โดยสิ่งที่ปล่อยออกมาประกอบด้วย Iris Harness, ระบบวงจรเอเจนต์, เครื่องมือจัดการบริบท และ Benchmark ทั้งสี่รายการ โดยทีมงานมีแผนจะปล่อยกระบวนการสร้างข้อมูลและขั้นตอนการฝึกฝนฉบับเต็มตามมาในภายหลัง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร