
LeRobot v0.6.0: ยกระดับการเรียนรู้หุ่นยนต์ด้วยระบบ 'จินตนาการ' การประเมินผล และการปรับปรุงประสิทธิภาพ
การเปิดตัวครั้งใหม่นี้มุ่งเน้นไปที่การปิดลูปการเรียนรู้ของหุ่นยนต์ (robot learning loop) ทั้งในส่วนของนโยบาย (policy) ที่สามารถจินตนาการถึงอนาคตก่อนลงมือทำ, reward models ที่ช่วยระบุความสำเร็จของหุ่นยนต์, CLI สำหรับการใช้งานจริงที่เปลี่ยนความผิดพลาดให้กลายเป็นข้อมูลฝึกฝน และเกณฑ์มาตรฐานการจำลองใหม่ 6 รายการเพื่อวัดผลอย่างแม่นยำ นอกจากนี้ยังเพิ่มการรองรับระบบตรวจจับระดับความลึก (depth sensing), การเขียนคำอธิบายชุดข้อมูลอัตโนมัติด้วย VLM, การเข้ารหัสวิดีโอแบบกำหนดเอง, การฝึกบนคลาวด์ผ่าน HF Jobs และขั้นตอนการติดตั้งที่กระชับยิ่งขึ้น
TL;DR
LeRobot v0.6.0 นำเสนอนโยบายโมเดลโลก (VLA-JEPA, FastWAM, LingBot-VA) ที่สามารถจินตนาการถึงอนาคตได้ พร้อมด้วย VLA รุ่นใหม่ล่าสุด (GR00T N1.7, MolmoAct2, EO-1, EVO1, Multitask DiT) และ API สำหรับ reward models ใหม่ (Robometer, TOPReward) มาพร้อมเกณฑ์มาตรฐานการจำลอง 6 รายการภายใต้ lerobot-eval, CLI lerobot-rollout ที่รองรับการแก้ไขแบบ human-in-the-loop สไตล์ DAgger, ระบบฝึกฝนแบบ FSDP และการฝึกบนคลาวด์ผ่าน HF Jobs นอกจากนี้ยังรองรับข้อมูลระดับความลึก (depth), ไปป์ไลน์เขียนคำอธิบายอัตโนมัติ, การเข้ารหัสวิดีโอแบบกำหนดเอง และโหลดข้อมูลได้เร็วขึ้นสูงสุด 2 เท่า บนพื้นฐานการติดตั้งที่สะดวกกว่าเดิม
Table of contents
- LeRobot v0.6.0: Imagine, Evaluate, Improve
- TL;DR
- Table of contents
- World models: policies that imagine
- VLAs: the model zoo keeps growing
- Reward models: knowing when your robot succeeds
- Datasets: faster loading, richer data
- Benchmarks: one CLI to evaluate them all
- Training & inference
- Codebase: leaner and cleaner
- Community & ecosystem
- Final thoughts
World models: policies that imagine
วงการหุ่นยนต์กำลังตั้งคำถามสำคัญว่า โมเดลโลก (World models) ช่วยเสริมประสิทธิภาพให้นโยบายหุ่นยนต์ได้จริงหรือไม่? ในเวอร์ชัน v0.6.0 นี้ LeRobot จึงนำเสนอนโยบาย 3 รูปแบบที่เรียนรู้ที่จะจินตนาการภาพเหตุการณ์ในอนาคตระหว่างการฝึกฝน โดยแต่ละแบบมีวิธีการจัดการต้นทุนการประมวลผลที่แตกต่างกัน
VLA-JEPA
VLA-JEPA ฝึกสอน VLA ขนาดกะทัดรัด (พัฒนาต่อจาก Qwen3-VL-2B) ให้คาดการณ์ภาพเหตุการณ์ในพื้นที่แฝง (latent space) โดยในระหว่างการฝึก โมเดลโลกแบบ JEPA จะต้องทำนายเฟรมที่จะเกิดขึ้นจากการกระทำของตัวมันเอง หัวใจสำคัญคือตัวโมเดลโลกจะถูกถอดออกเมื่อนำไปใช้งานจริง (inference) ทำให้ได้ประโยชน์จากการเรียนรู้โดยไม่ต้องเสียค่าประมวลผลเพิ่มเติม ปัจจุบันมี checkpoint ให้เลือกใช้ 3 รุ่นบน Hub รวมถึงรุ่นพื้นฐานที่ฝึกด้วย DROID สำหรับการทำ fine-tuning:
lerobot-train \
  --policy.path=lerobot/VLA-JEPA-Pretrain \
  --dataset.repo_id=${HF_USER}/my_dataset \
  --policy.repo_id=${HF_USER}/my_finetuned_policy
ศึกษาเพิ่มเติมได้จาก VLA-JEPA documentation และ paper
LingBot-VA
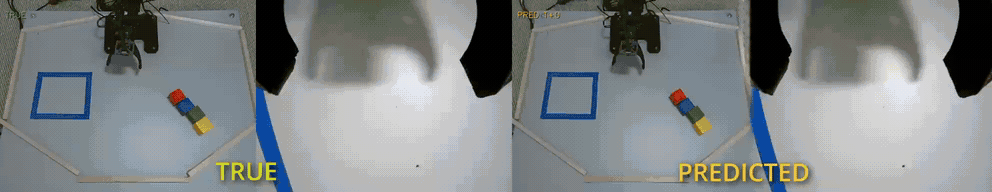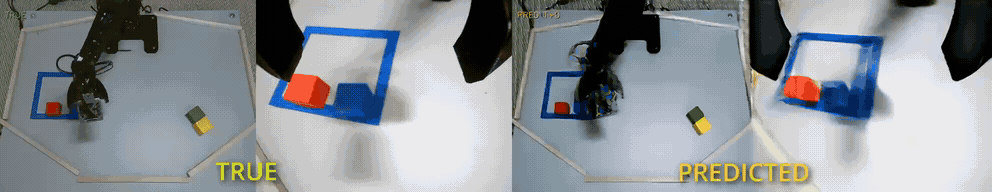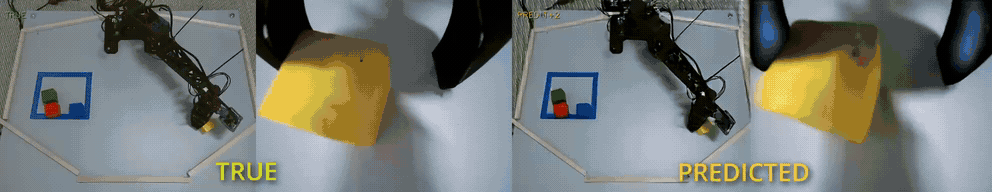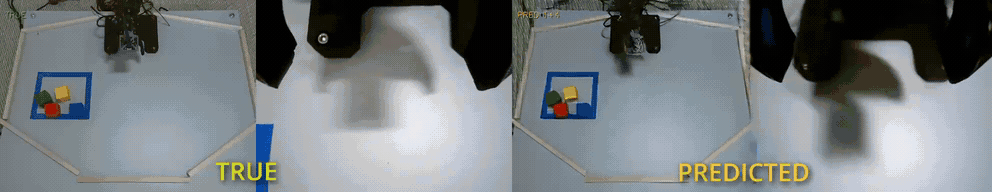
LingBot-VA ก้าวนำไปอีกขั้นด้วยโมเดลวิดีโอ-การกระทำแบบถดถอยในตัวเอง (autoregressive video-action model) ที่คาดการณ์ทั้งวิดีโออนาคตและการกระทำไปพร้อมกันทีละส่วน (chunk by chunk) โดยนำการสังเกตจริงมาป้อนกลับเพื่อให้สิ่งที่จินตนาการยังอยู่ในพื้นฐานความเป็นจริง คุณสามารถบันทึกภาพจินตนาการของหุ่นยนต์ได้ผ่าน --policy.save_predicted_video=true เพื่อเปรียบเทียบกับเหตุการณ์จริง โดยตัวโมเดลรองรับการทำงานบน GPU ขนาด 24–32 GB เพียงตัวเดียว รายละเอียดทางเทคนิคอยู่ที่ documentation และ paper
FastWAM
FastWAM ออกแบบมาเพื่อจำลองพฤติกรรมโดยข้ามขั้นตอนการจินตนาการในเวลาใช้งานจริง โมเดลนี้จับคู่ผู้เชี่ยวชาญการสร้างวิดีโอขนาด ~5B กับผู้เชี่ยวชาญด้านการกระทำขนาดกะทัดรัดไว้ด้วยกัน เมื่อถึงเวลาอินเฟอเรนซ์ โมเดลจะข้ามขั้นตอนการ "ฝัน" และมุ่งไปที่การทำ denoising สำหรับการกระทำโดยตรง สามารถทำ fine-tune ได้จาก lerobot/fastwam_base และศึกษาต่อได้ใน documentation
VLAs: the model zoo keeps growing
GR00T N1.7
เราได้อัปเกรดการผนวกรวม NVIDIA GR00T เป็นเวอร์ชัน N1.7 ซึ่งเป็นโมเดลพื้นฐานข้ามแพลตฟอร์ม (cross-embodiment) รุ่นล่าสุด N1.7 เปลี่ยนมาใช้ Cosmos-Reason2-2B (พื้นฐานจาก Qwen3-VL) เชื่อมต่อกับ action head แบบ flow-matching การทดสอบยืนยันว่าให้ผลลัพธ์เทียบเท่ากับ Isaac-GR00T ต้นฉบับ และด้วยการรองรับ Flash-attention ทำให้ติดตั้งได้ง่ายผ่าน pip install 'lerobot[groot]' และโหลด checkpoint จาก NVIDIA ได้ทันที
GR00T N1.7 จะเข้าแทนที่ N1.5 หากต้องการใช้รุ่นเดิม โปรดระบุเวอร์ชัน
lerobot==0.5.1
MolmoAct2
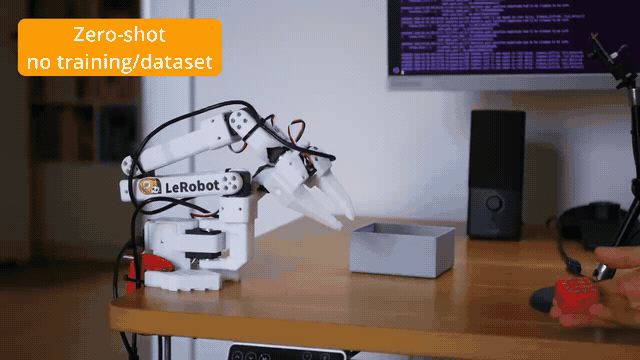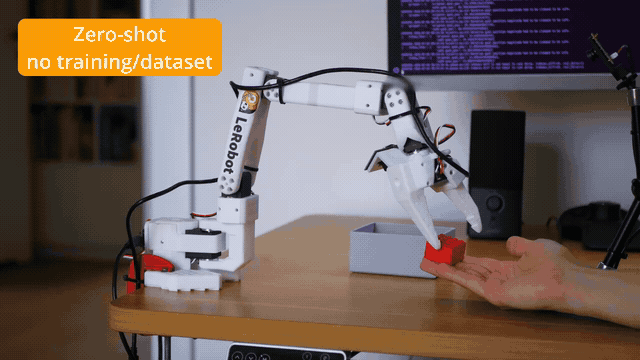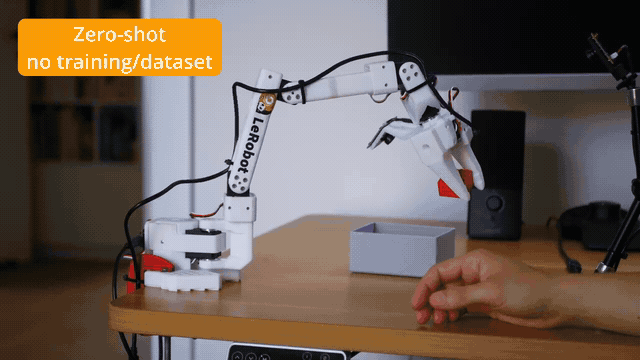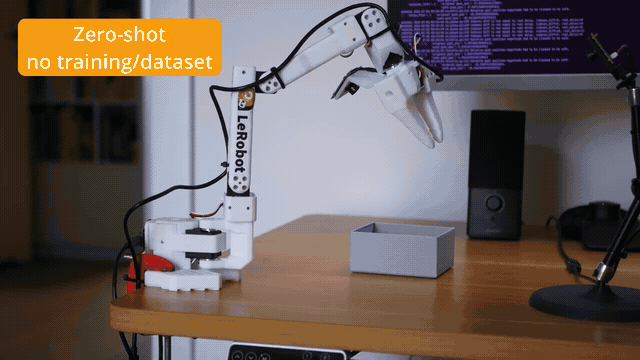
MolmoAct2 จาก Allen Institute for AI ได้รับการพอร์ตเข้าลูปของ LeRobot ครบวงจร ทั้งการ fine-tuning (Full หรือ LoRA), การประเมิน และการใช้งานจริง โดยมาพร้อม checkpoint ที่ปรับจูนความแม่นยำ (calibration correction) มาแล้ว ทำให้พร้อมรันแบบ zero-shot บนหุ่นยนต์ SO-100/101 ได้ทันที:
lerobot-rollout \
  --policy.path=lerobot/MolmoAct2-SO100_101-LeRobot \
  --robot.type=so100_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.cameras='{cam0: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}, cam1: {type: opencv, index_or_path: 2, width: 640, height: 480, fps: 30}}' \
  --task="pick up the red cube" --duration=30
การอินเฟอเรนซ์ใช้ VRAM ประมาณ 12 GB ในโหมด bf16 และการทำ fine-tuning แบบ LoRA ใช้ GPU เพียง 24 GB ตัวเดียว ดูคู่มือฉบับเต็มได้ที่ MolmoAct2 documentation
EO-1
EO-1 คือโมเดล VLA ที่ฝึกฝนบนข้อมูลผสมผสานระหว่างภาพ-ข้อความ-การกระทำ โดยใช้โครงสร้าง Qwen2.5-VL-3B และ action head แบบ flow-matching รองรับเวิร์กโฟลว์ lerobot-train มาตรฐานด้วย --policy.type=eo1 รายละเอียดใน documentation และ paper
Multitask DiT
นโยบาย Multitask Diffusion Transformer นำเทคนิค TRI Large Behavior Models มาสู่ LeRobot ด้วยขนาด ~450 ล้านพารามิเตอร์ที่ปรับตามคำสั่งภาษาและภาพ CLIP ทำให้โมเดลเดียวเรียนรู้งานได้หลากหลายผ่านภาษาธรรมชาติ รองรับทั้งเป้าหมายแบบ diffusion และ flow-matching ศึกษาเพิ่มเติมใน documentation
EVO1
EVO1 พิสูจน์ว่า VLA ไม่จำเป็นต้องใหญ่เสมอไป ด้วยพารามิเตอร์เพียง 0.77B บนพื้นฐาน InternVL3-1B ทำให้สามารถ fine-tune และรันแบบเรียลไทม์บน GPU รุ่นเริ่มต้นได้ พร้อมรองรับ Real-Time Chunking ในตัว ดูรายละเอียดที่ EVO1 documentation และ paper
Reward models: knowing when your robot succeeds
การประเมินความคืบหน้าและความสำเร็จคือจิ๊กซอว์ชิ้นสำคัญที่เคยขาดหายไป ใน v0.6.0 เราได้เปิดตัว API ของ reward models ที่เป็นหนึ่งเดียว (lerobot.rewards) ประกอบด้วย 4 รูปแบบภายใต้อินเทอร์เฟซเดียว:
Robometer
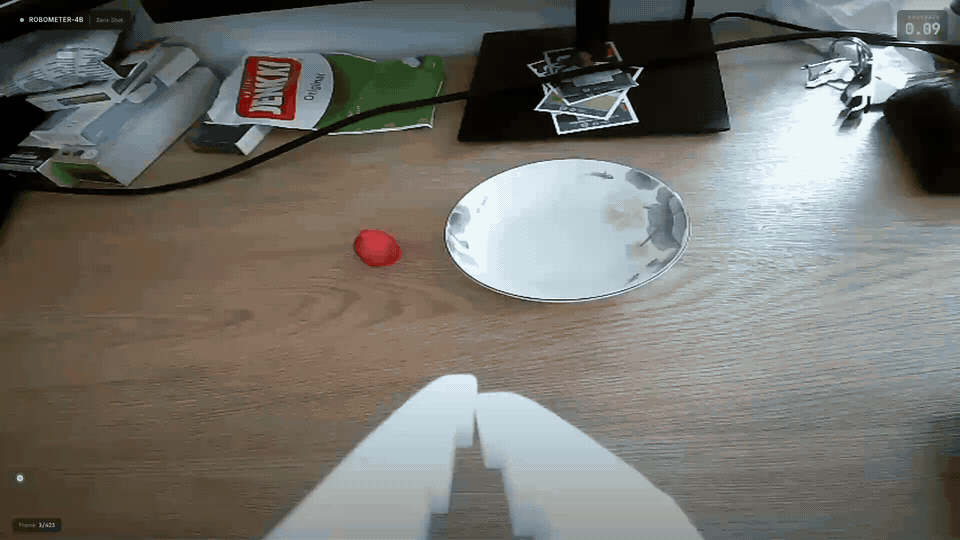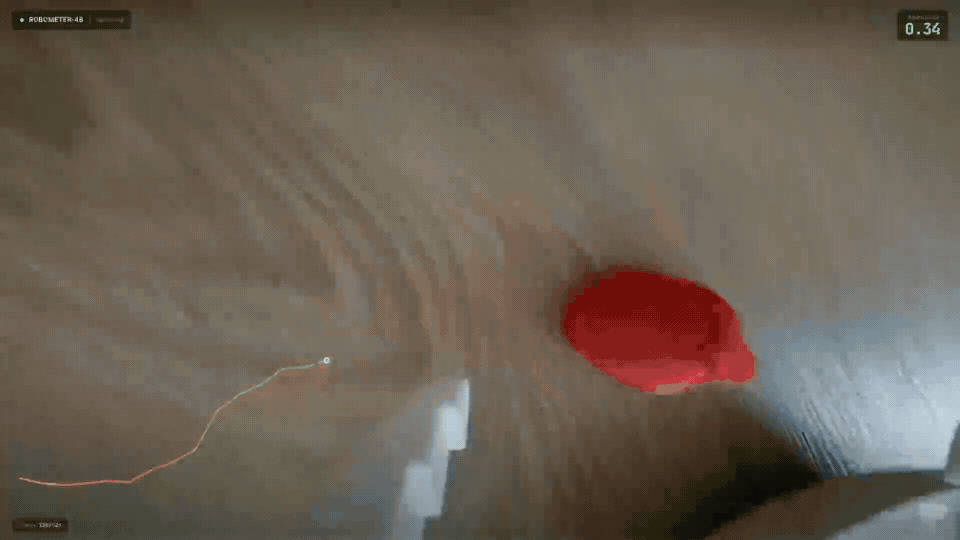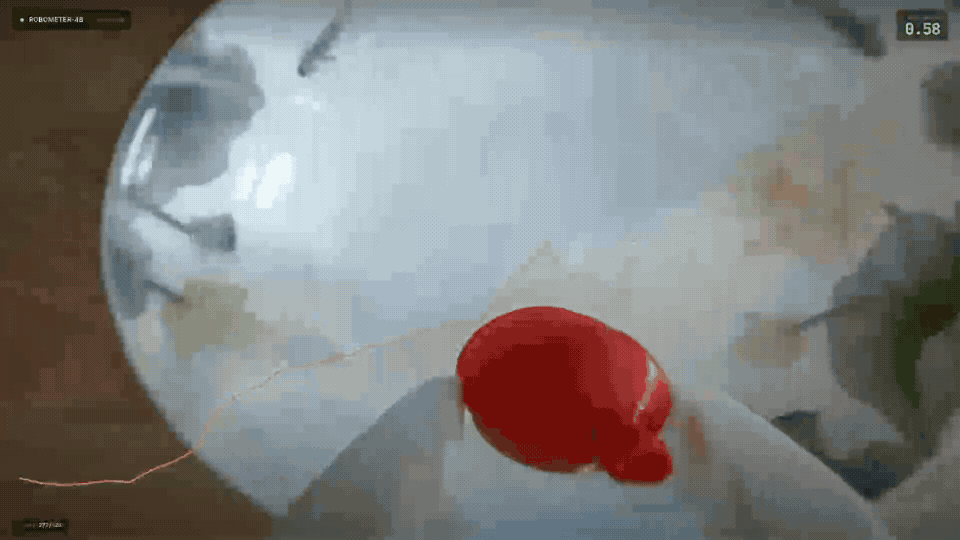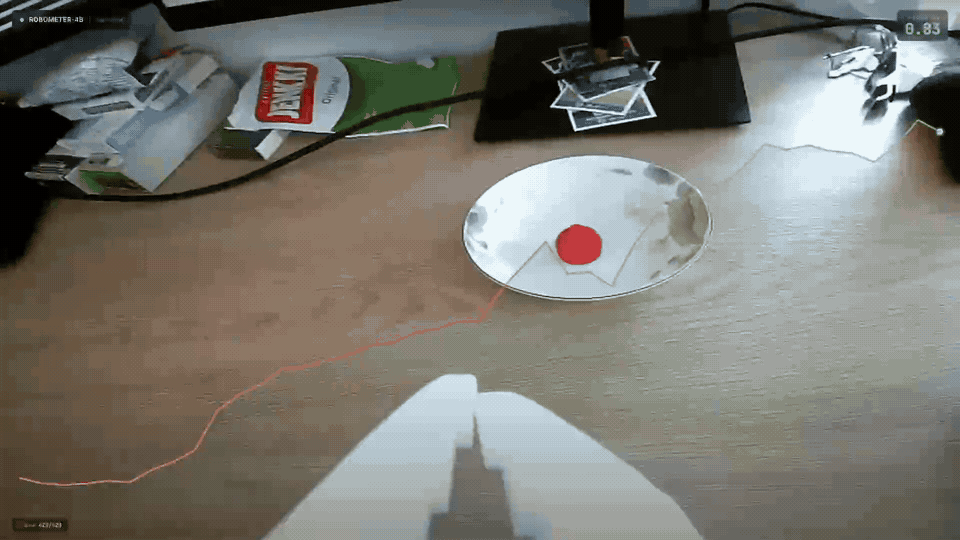
lerobot/Robometer-4B เป็นโมเดลให้รางวัลอเนกประสงค์ที่สามารถให้คะแนนความสำเร็จของงานจากวิดีโอดิบและคำสั่งภาษาได้ทันทีโดยไม่ต้องฝึกฝนเฉพาะงาน (zero-shot) พัฒนาบน Qwen3-VL-4B และฝึกด้วยข้อมูลวิถีการเคลื่อนที่หุ่นยนต์กว่าล้านรายการ (RSS 2026 paper)
TOPReward
TOPReward ทำงานแบบ zero-shot เต็มรูปแบบโดยไม่ต้องใช้ค่าน้ำหนักรางวัลเฉพาะทาง แต่นำ VLM มาตรฐาน (Qwen3-VL) มาใช้อ่านค่าความน่าจะเป็นของโทเค็น "True" จากวิดีโอ เพื่อประเมินความสำเร็จของงานได้ทันที
ทั้งสองรุ่นมาพร้อมสคริปต์ทำป้ายกำกับ (labeling) เพื่อสร้างเส้นโค้งความคืบหน้าในชุดข้อมูลของคุณ เหมาะสำหรับ RA-BC และการตรวจสอบคุณภาพชุดข้อมูล ดูที่ Robometer และ TOPReward
Datasets: faster loading, richer data
Your codec, your rules
ผู้ใช้สามารถเลือกตัวเข้ารหัสวิดีโอ (codec) ได้อย่างอิสระผ่าน --dataset.rgb_encoder.* และด้วยระบบ vcodec=auto โปรแกรมจะมองหาตัวเร่งฮาร์ดแวร์เช่น NVENC หรือ VAAPI ให้อัตโนมัติ หรือจะสั่งเข้ารหัสข้อมูลเดิมใหม่ก็ทำได้ง่ายๆ:
lerobot-edit-dataset \
    --repo_id ${HF_USER}/my_dataset \
    --operation.type reencode_videos \
    --operation.rgb_encoder.vcodec h264 \
    --operation.rgb_encoder.crf 23
รายละเอียดใน video encoding documentation
Depth support, end to end
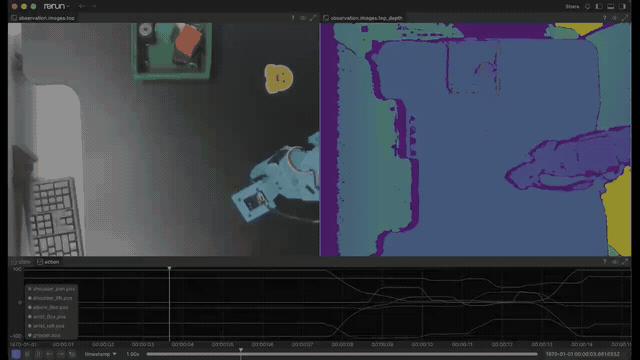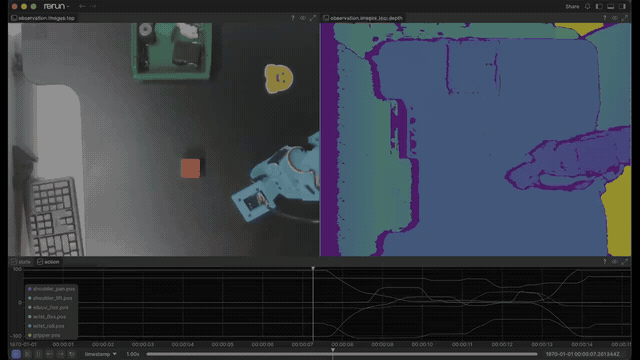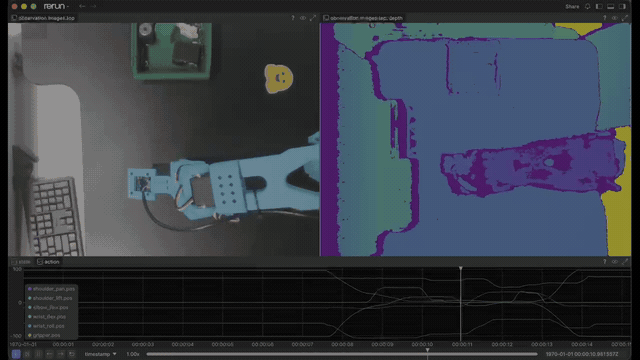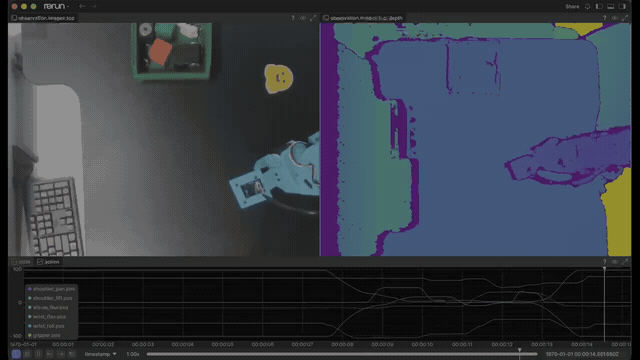
รองรับ Intel RealSense เต็มรูปแบบ เพียงเปิด use_depth: true LeRobot จะบันทึกแผนที่ระดับความลึกแบบ 12 บิตขนาดกะทัดรัดไปพร้อมกับวิดีโอ RGB และถอดรหัสเป็นค่าจริงระหว่างฝึกฝน โดยรองรับทั้ง SO-100, Unitree G1 และอื่นๆ
Language annotations at scale
ตอนนี้คุณสามารถเพิ่มคำอธิบายประกอบภาษาที่ละเอียดขึ้น (เช่น งานย่อย, แผนการทำงาน) ได้โดยอัตโนมัติผ่าน CLI lerobot-annotate ที่ใช้ VLM ช่วยวิเคราะห์:
lerobot-annotate \
    --repo_id=${HF_USER}/my_dataset \
    --new_repo_id=${HF_USER}/my_dataset_annotated \
    --vlm.model_id=Qwen/Qwen2.5-VL-7B-Instruct \
    --push_to_hub=true
ศึกษาเพิ่มเติมที่ annotation pipeline docs
Up to 2x faster data loading
การฝึกฝนวิดีโอเร็วขึ้นสูงสุด 2 เท่าด้วยระบบถอดรหัสขนานและการส่งเฟรมแบบ uint8 ที่ช่วยประหยัดแรมขึ้น 4 เท่า การสุ่มตัวอย่างข้อมูลยังเป็นแบบกำหนดกลุ่ม (deterministic) ทำให้สามารถหยุดและเริ่มฝึกต่อจากจุดเดิมได้อย่างแม่นยำ
Benchmarks: one CLI to evaluate them all
LeRobot v0.6.0 รวบรวมเกณฑ์มาตรฐานการจำลอง 6 รายการที่รันผ่าน CLI lerobot-eval ได้โดยตรง:
- LIBERO-plus ทดสอบความทนทานต่อแสง มุมกล้อง และคำสั่งที่ผันแปร
- RoboTwin 2.0 งานสองมือ 50 รูปแบบ พร้อมข้อมูลฝึกฝนกว่า 100,000 ชุด
- RoboCasa365 365 งานในครัวจำลอง 2,500 แบบ
- RoboCerebra ประเมินงานต่อเนื่องระยะยาว 3-6 เป้าหมาย
- RoboMME ทดสอบความจำและการเลียนแบบ
- VLABench ทดสอบเหตุผลทางฟิสิกส์และงานที่ซับซ้อน
lerobot-eval \
  --policy.path=lerobot/smolvla_robotwin \
  --env.type=robotwin \
  --env.task=beat_block_hammer \
  --eval.n_episodes=100 --eval.batch_size=1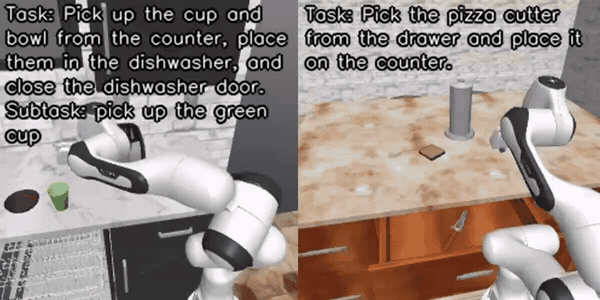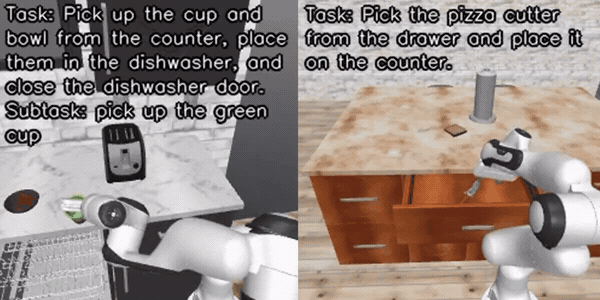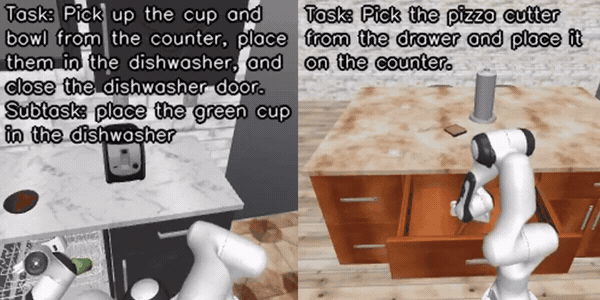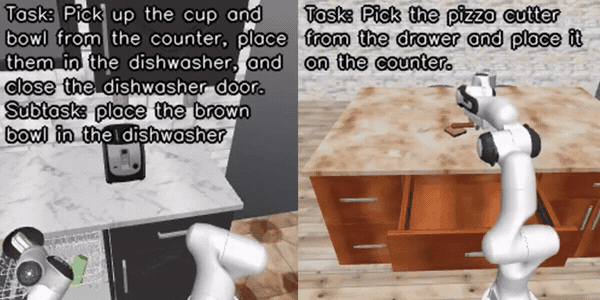
Training & inference
lerobot-rollout: deployment gets its own CLI
การใช้งานหุ่นยนต์มี CLI เฉพาะตัวแล้วคือ lerobot-rollout โดยมีกลยุทธ์ที่น่าสนใจคือ dagger ที่เปิดให้มนุษย์เข้าแก้ไขการเคลื่อนที่ได้ทันทีเมื่อหุ่นยนต์ทำผิดพลาด ข้อมูลการแก้ไขจะถูกบันทึกเพื่อนำไป fine-tune ต่อได้ทันที:
lerobot-rollout \
    --strategy.type=dagger \
    --policy.path=${HF_USER}/my_policy \
    --robot.type=so100_follower \
    --robot.port=/dev/ttyACM0 \
    --teleop.type=so101_leader \
    --teleop.port=/dev/ttyACM1 \
    --dataset.repo_id=${HF_USER}/dagger_corrections \
    --dataset.single_task="Grasp the block"
รายละเอียดใน deployment docs
FSDP: train models bigger than your GPU
รองรับการฝึกฝนแบบ FSDP ผ่าน Accelerate เพื่อแบ่งส่วนข้อมูลและพารามิเตอร์ข้าม GPU หลายตัว ทำให้ฝึกโมเดลขนาดใหญ่เกินความจุ GPU ตัวเดียวได้ ศึกษาที่ multi-GPU training docs
Cloud training with HF Jobs
หากไม่มี GPU แรงๆ สามารถสั่งฝึกบนคลาวด์ได้ด้วยแฟล็กเดียว โดยระบบจะจัดการส่งข้อมูลและพุชนโยบายที่ฝึกเสร็จแล้วกลับเข้าสู่ Hub ให้อัตโนมัติ:
lerobot-train \
  --dataset.repo_id=${HF_USER}/so101_test \
  --policy.type=act \
  --policy.repo_id=${HF_USER}/my_policy \
--job.target=a10g-smallCodebase: leaner and cleaner
pip install lerobotลดการพึ่งพาไลบรารีพื้นฐานลง 40% ช่วยให้ติดตั้งได้เบาขึ้น- รองรับ PyTorch 2.7–2.11 และ CUDA 12.8 ผ่าน
uvบน Linux uv.lockกลายเป็นมาตรฐานหลักสำหรับ Docker และการพัฒนา- รองรับระบบ
--display_mode=foxgloveเพื่อแสดงภาพการทำงานของหุ่นยนต์ผ่านเครื่องมือ Foxglove - การควบคุมผ่านคีย์บอร์ดรองรับการทำงานบน Wayland, SSH และ macOS เป็นที่เรียบร้อย
Community & ecosystem
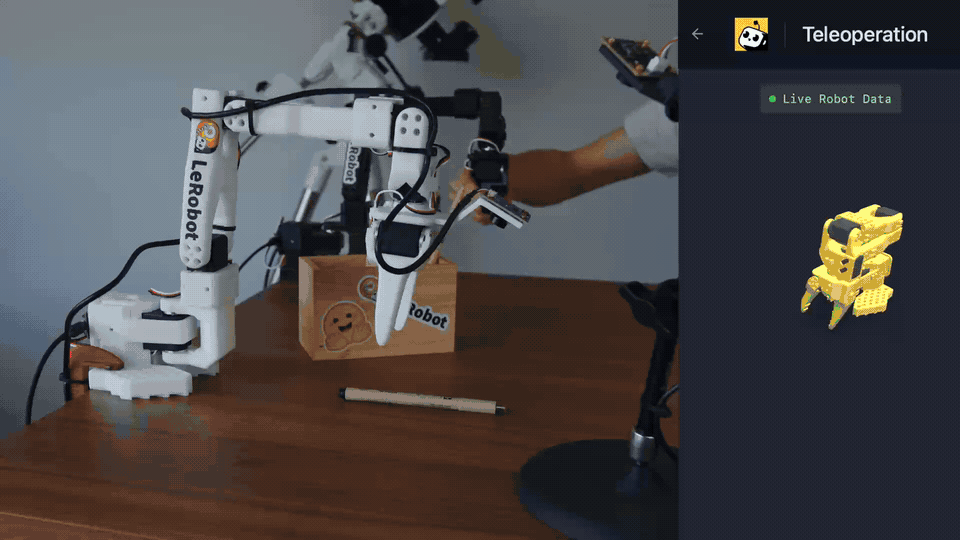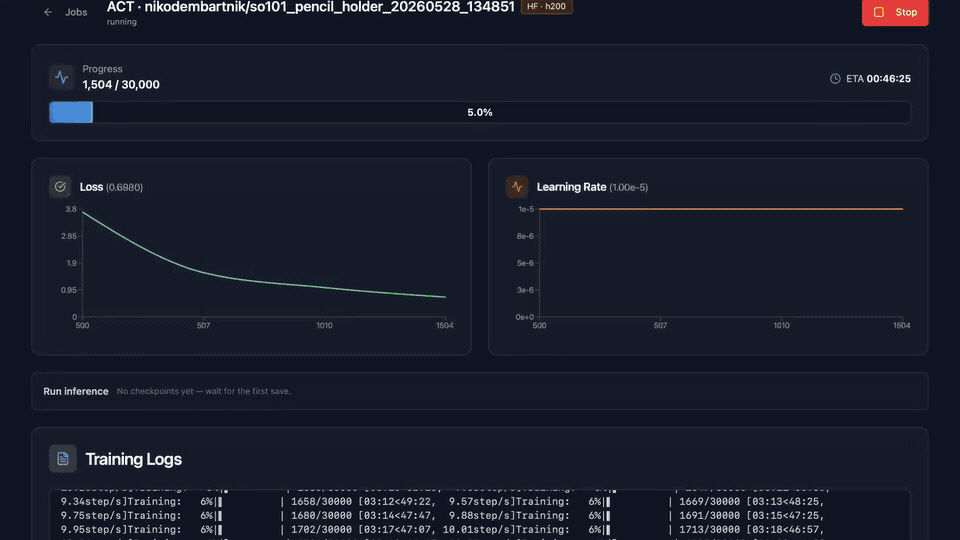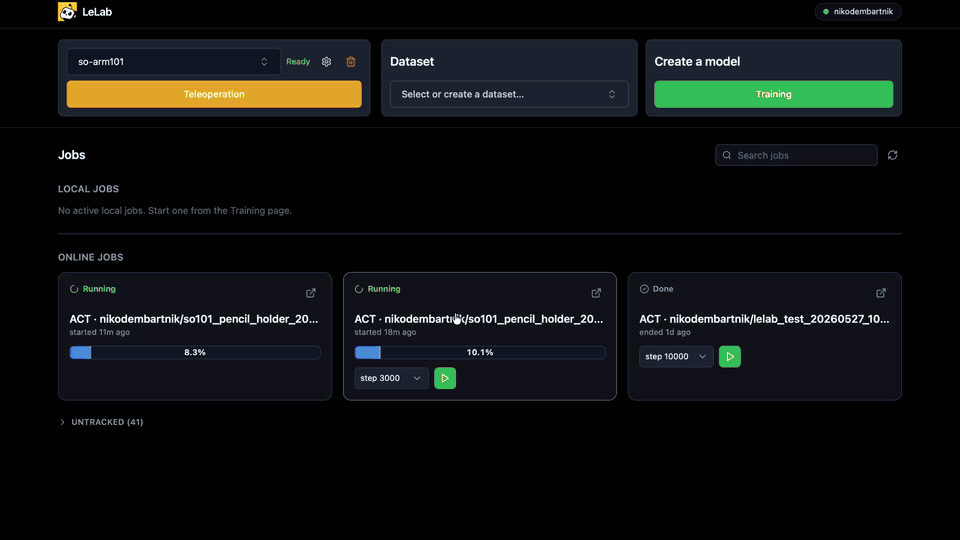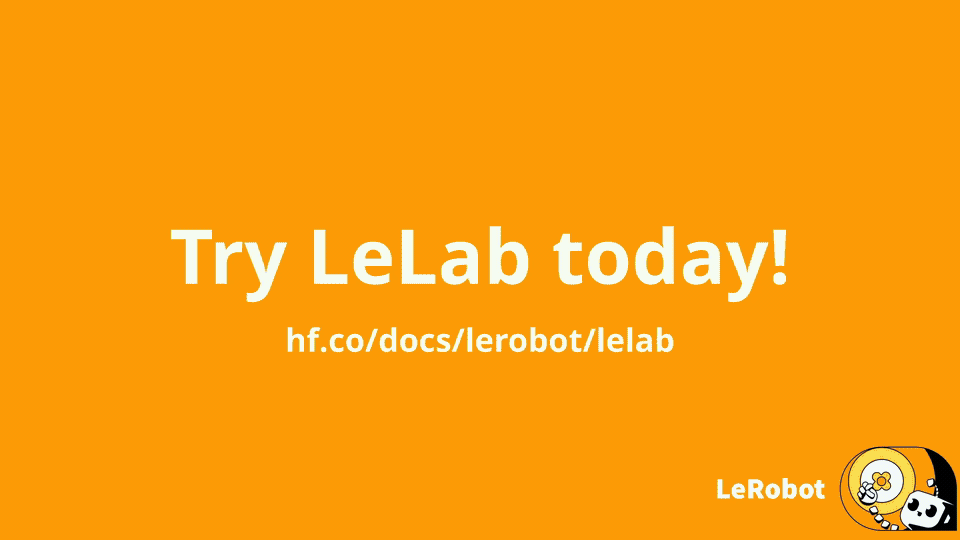
- LeLab: อินเทอร์เฟซบนเบราว์เซอร์สำหรับควบคุม ชูนิ่ง และฝึกฝนหุ่นยนต์โดยไม่ต้องใช้ CLI ลองใช้ที่นี่!
- Isaac Teleop: ควบคุม SO-101 ด้วย VR ผ่านความร่วมมือกับ NVIDIA ดูเอกสาร
- Hardware Guide: คู่มือใหม่สรุปการใช้ VRAM และระยะเวลาฝึกฝนบน GPU รุ่นต่างๆ ศึกษาที่นี่
- Adding a Policy: คู่มือการเขียนนโยบายใหม่เพื่อนำมาใช้ในระบบ ดูคู่มือ
Final thoughts
v0.6.0 คือก้าวสำคัญที่รวบรวมการปรับปรุงและแก้บัฟเฟอร์นับร้อยรายการ เราขอขอบคุณชุมชนผู้พัฒนาทุกคนที่ช่วยขับเคลื่อนหุ่นยนต์โอเพนซอร์สให้ก้าวไปข้างหน้า
เริ่มต้นใช้งานได้ ที่นี่ 🤗 – ทีม LeRobot ❤️
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร