
เผยเทคนิค Knowledge Distillation ใหม่: ลดใช้ VRAM 15 เท่า ฝึก AI ขนาดใหญ่ได้บน GPU ตัวเดียว
Knowledge distillation คือกระบวนการฝึกโมเดลนักเรียน (student model) ขนาดเล็กให้มีประสิทธิภาพเทียบเท่ากับโมเดลครู (teacher model) ที่มีขนาดใหญ่กว่า เทคนิคนี้กำลังกลับมาเป็นที่สนใจอย่างมากในยุคของโมเดลภาษาขนาดใหญ่ (LLM) แบบโอเพนซอร์ส เช่น gpt-oss, Qwen, GLM, หรือ Kimi เนื่องจากโมเดลเหล่านี้มีค่าใช้จ่ายในการรันสูงมาก ตัวอย่างเช่น Kimi-K3 รุ่นล่าสุดที่มีพารามิเตอร์ถึง 2.8 ล้านล้านตัว ต้องใช้ VRAM สูงถึง 3TB เพียงแค่โหลดโมเดล การบีบอัดโมเดลและฟื้นฟูความสามารถผ่านกระบวนการนี้จึงกลายเป็นมาตรฐานใหม่ที่บริษัทอย่าง Nvidia และ Multiverse Computing เลือกใช้
อย่างไรก็ตาม ขั้นตอนการ Distillation มักเป็นส่วนที่สิ้นเปลืองทรัพยากรที่สุดในกระบวนการทั้งหมด เนื่องจากการต้องโหลดทั้งโมเดลครูและนักเรียนไว้พร้อมกัน รวมถึงการสร้างการกระจายความน่าจะเป็น (probability distribution) ของคำศัพท์ทั้งหมดสำหรับทุก Token ต้องใช้ VRAM มหาศาล ซึ่งปกติแล้วจะทำได้เฉพาะบนคลัสเตอร์ GPU ขนาดใหญ่เท่านั้น
งานวิจัยล่าสุดของเราเรื่อง Efficient Knowledge Distillation for LLMs: Offline Top-K Logits and a Fused Chunked KL Loss ได้เข้ามาแก้ปัญหานี้ผ่านการปรับปรุงระบบ 2 ส่วนหลัก คือการทำแคช Top-K Logits ของโมเดลครูเพื่อลดภาระในหน่วยความจำ และการใช้เทคนิค KL-divergence loss แบบใหม่ที่ช่วยหลีกเลี่ยงการสร้างเมทริกซ์ขนาดใหญ่ การเปลี่ยนแปลงนี้ช่วยลดต้นทุนการฝึกฝนจนสามารถทำ Long-context healing ได้บน GPU เพียงตัวเดียว และทำให้การทดลองขนาดใหญ่กลายเป็นเรื่องที่ทำได้จริงในราคาถูกลง
ทำไมการฟื้นฟูด้วย distillation ถึงมีราคาแพง
การตั้งค่ามาตรฐานที่เรียกว่า Online Distillation โดยใช้ Kullback-Leibler divergence loss (KL loss) จะโหลดทั้งโมเดลครูและนักเรียนไว้พร้อมกัน โดยโมเดลครูจะรัน Forward Pass ทุกขั้นตอนเพื่อสร้าง Output Distribution ให้นักเรียนเลียนแบบ แม้วิธีนี้จะได้ประสิทธิภาพสูงสุด แต่ก็กินหน่วยความจำมหาศาลเพราะต้องถือ Tensor ของคำศัพท์ทั้งหมดสองชุดและคำนวณโมเดลครูซ้ำๆ ทั้งที่ค่าไม่เคยเปลี่ยน
ยกตัวอย่างเช่นโมเดล gpt-oss-120b ที่มีความยาว Sequence 32K เฉพาะ Tensor ความน่าจะเป็นของครูก็ใช้ VRAM ไปแล้ว 50GB เมื่อรวมข้อมูลส่วนอื่นๆ เช่น Gradients และ Optimizer States การฝึกเพียงรอบเดียวอาจต้องใช้ VRAM สูงถึง 250GB ซึ่งเกินความสามารถของ GPU รุ่นท็อปอย่าง H200 หรือ B200 เพียงตัวเดียวจะรับได้ เราจึงนำเสนอการปรับสูตร KL loss ใหม่ให้ประมวลผลเป็นส่วนๆ (Chunks) เพื่อลดต้นทุนนี้ลง
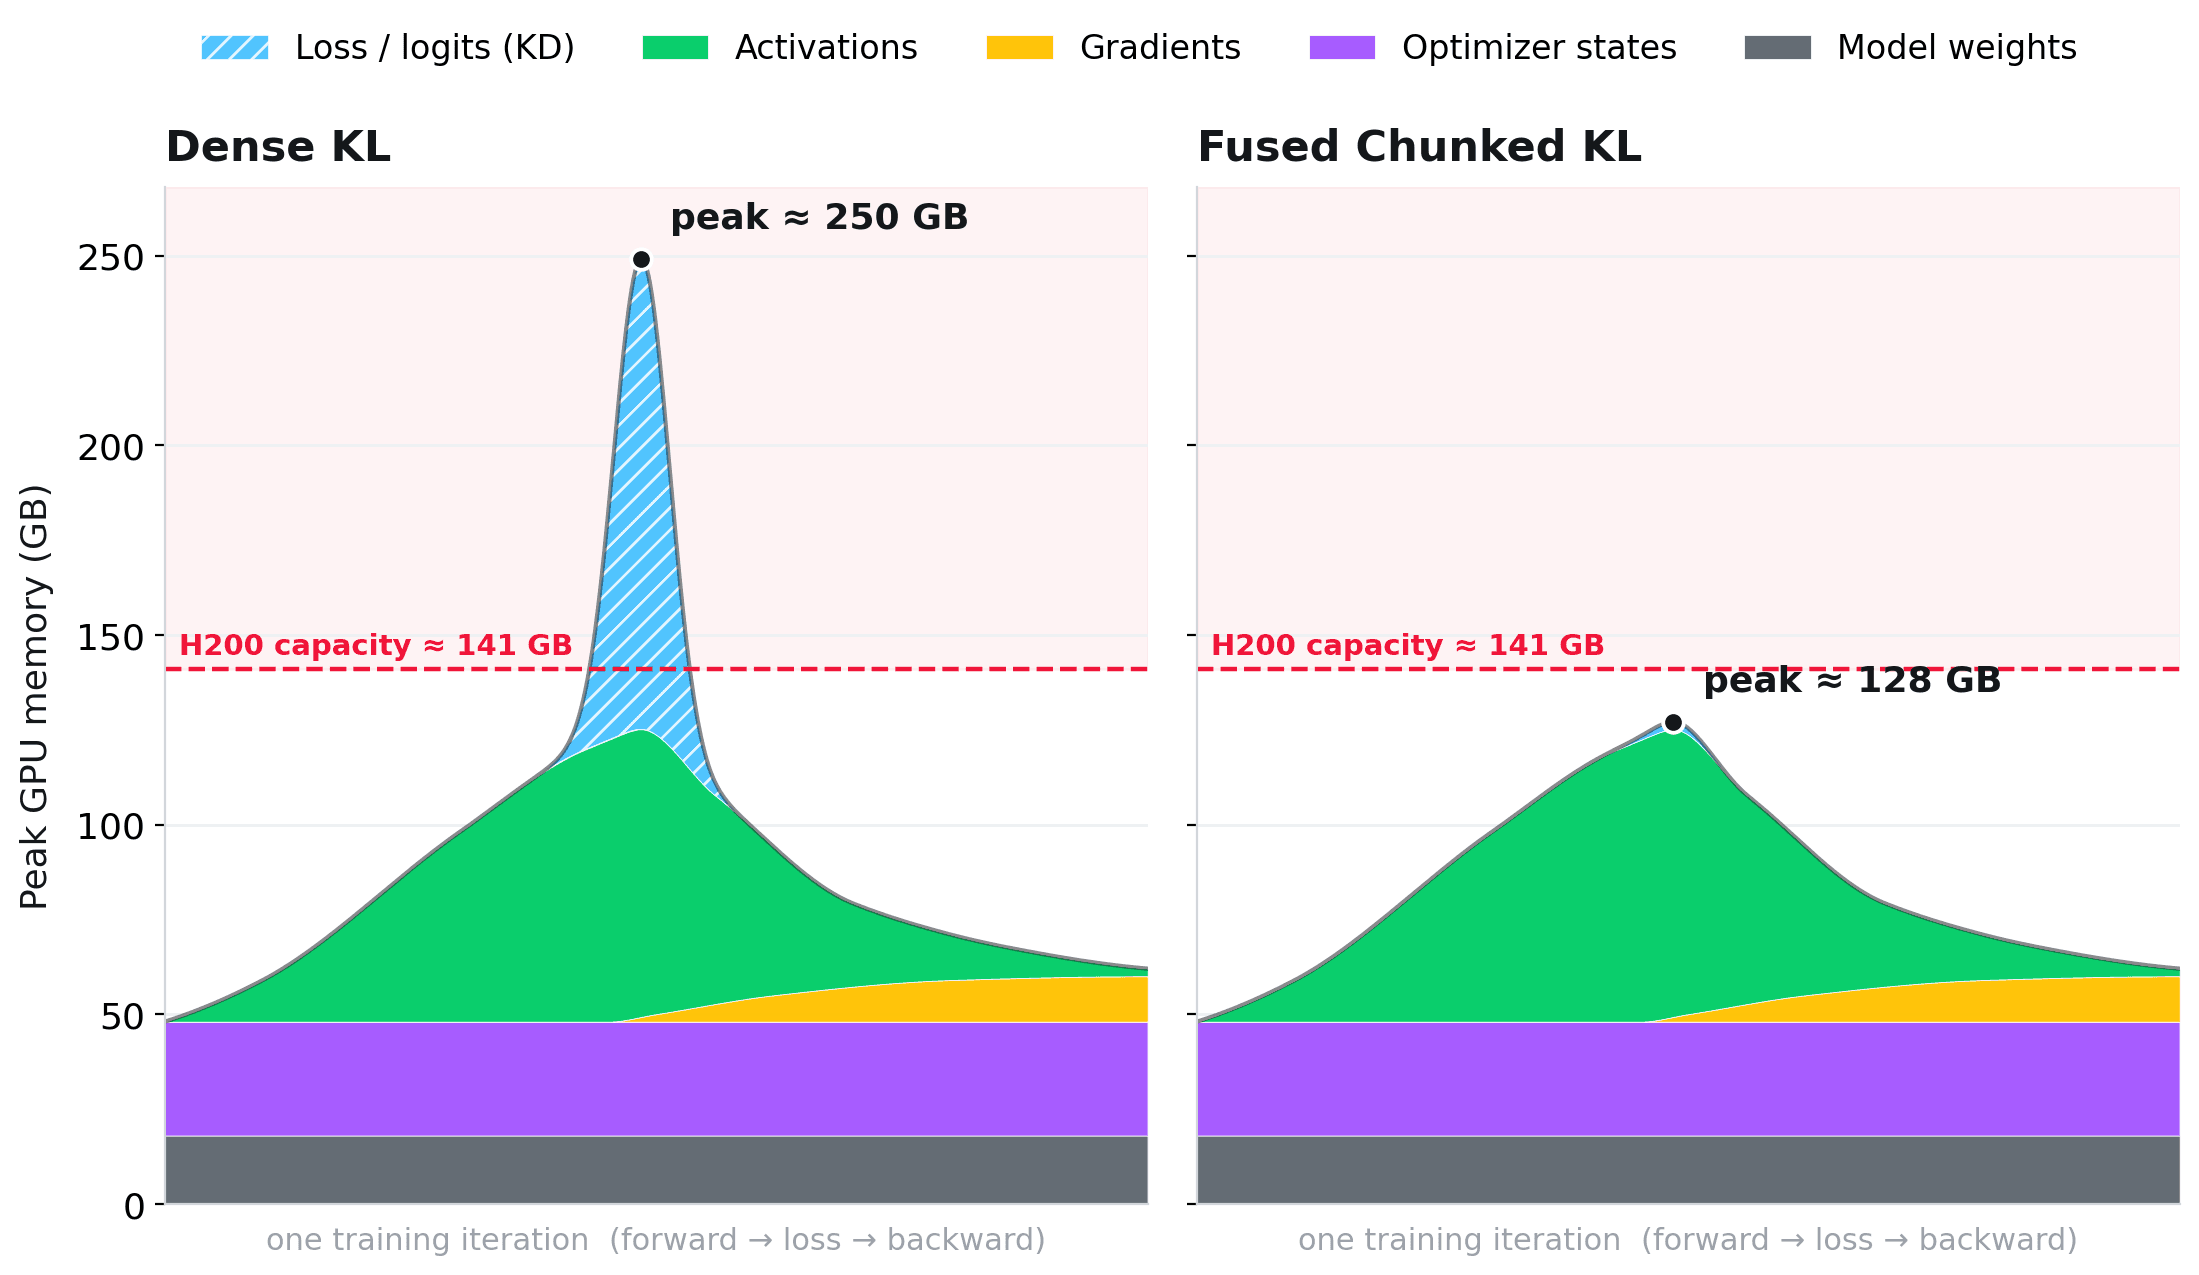
Dense KL พุ่งสูงถึงประมาณ 250GB ซึ่งเกินความจุ 141GB ของ H200 ตัวเดียว ส่วน fused chunked loss จะไม่เกิดการพุ่งสูงนั้นและมีจุดสูงสุดที่ประมาณ 128GB ที่มา: รูปที่ 1 ในงานวิจัย
การเปลี่ยนแปลงระบบสองประการ
Offline distillation: แทนที่จะคำนวณโมเดลครูใหม่ทุกครั้ง เราเลือกคำนวณเพียงครั้งเดียวแล้วแคชข้อมูล Top-100 Logits เก็บไว้ ทำให้ไม่จำเป็นต้องโหลดโมเดลครูไว้ในหน่วยความจำระหว่างการฝึกนักเรียน และยังสามารถนำแคชนี้กลับมาใช้ซ้ำในการทดสอบอื่นๆ ได้ทันที
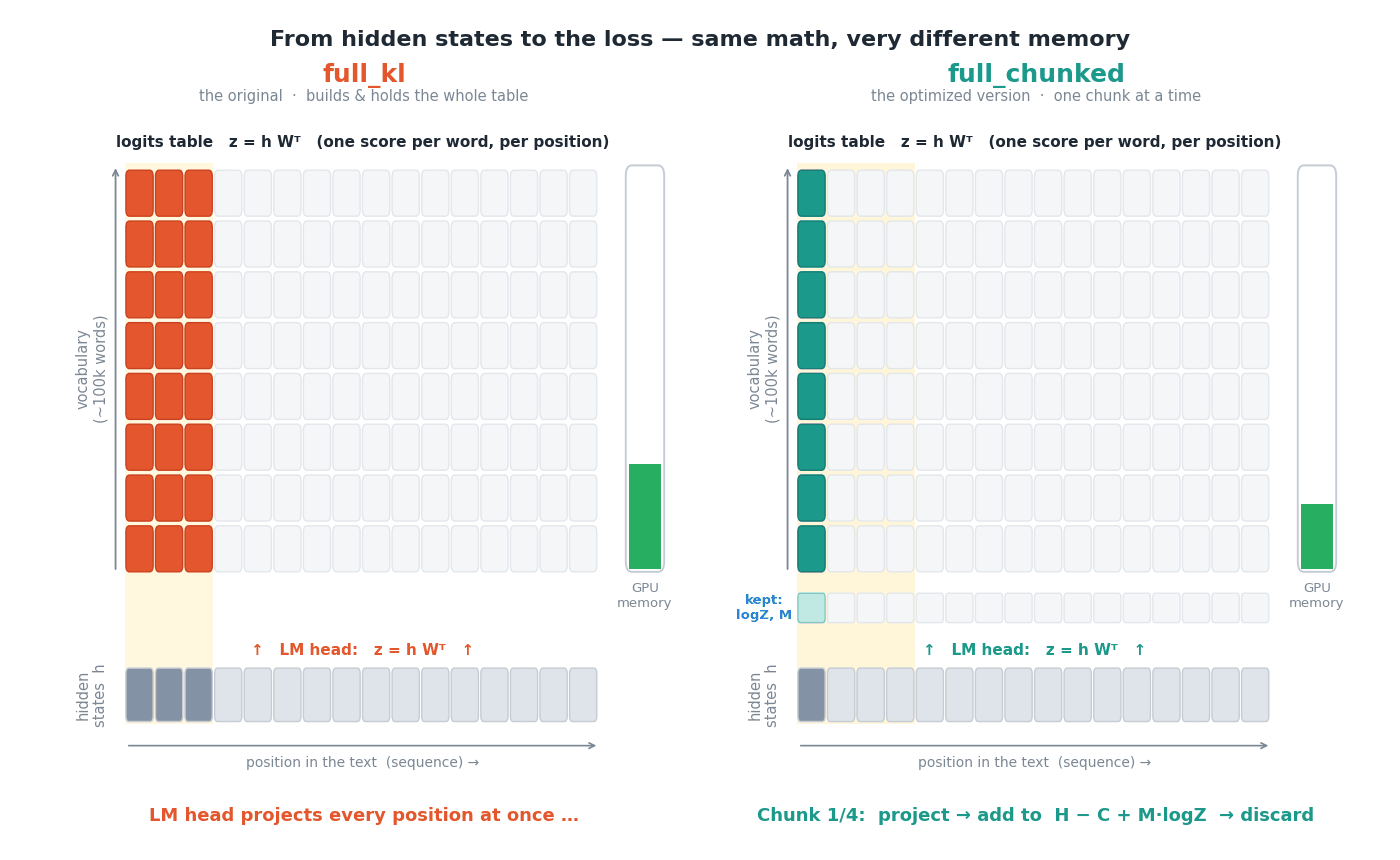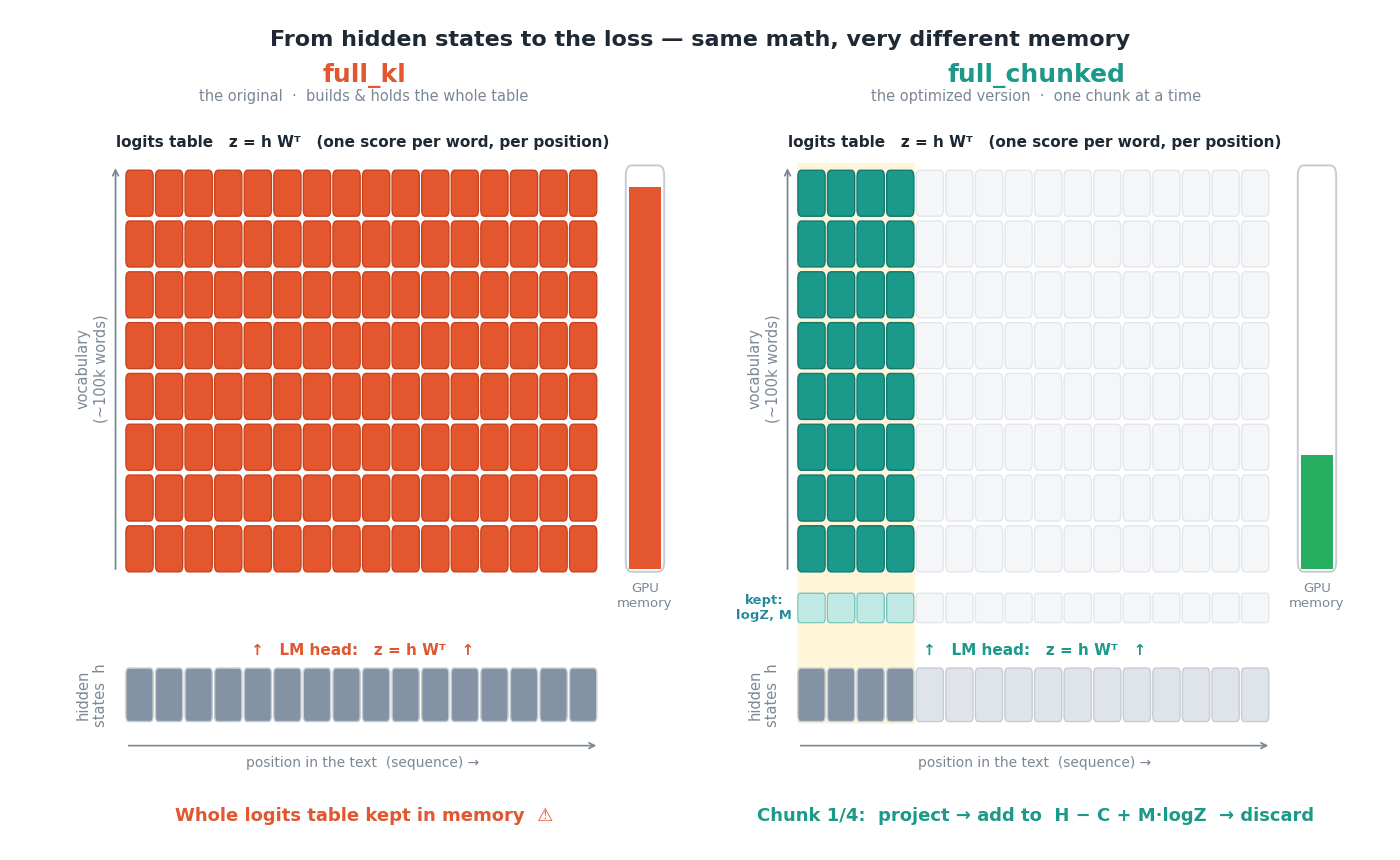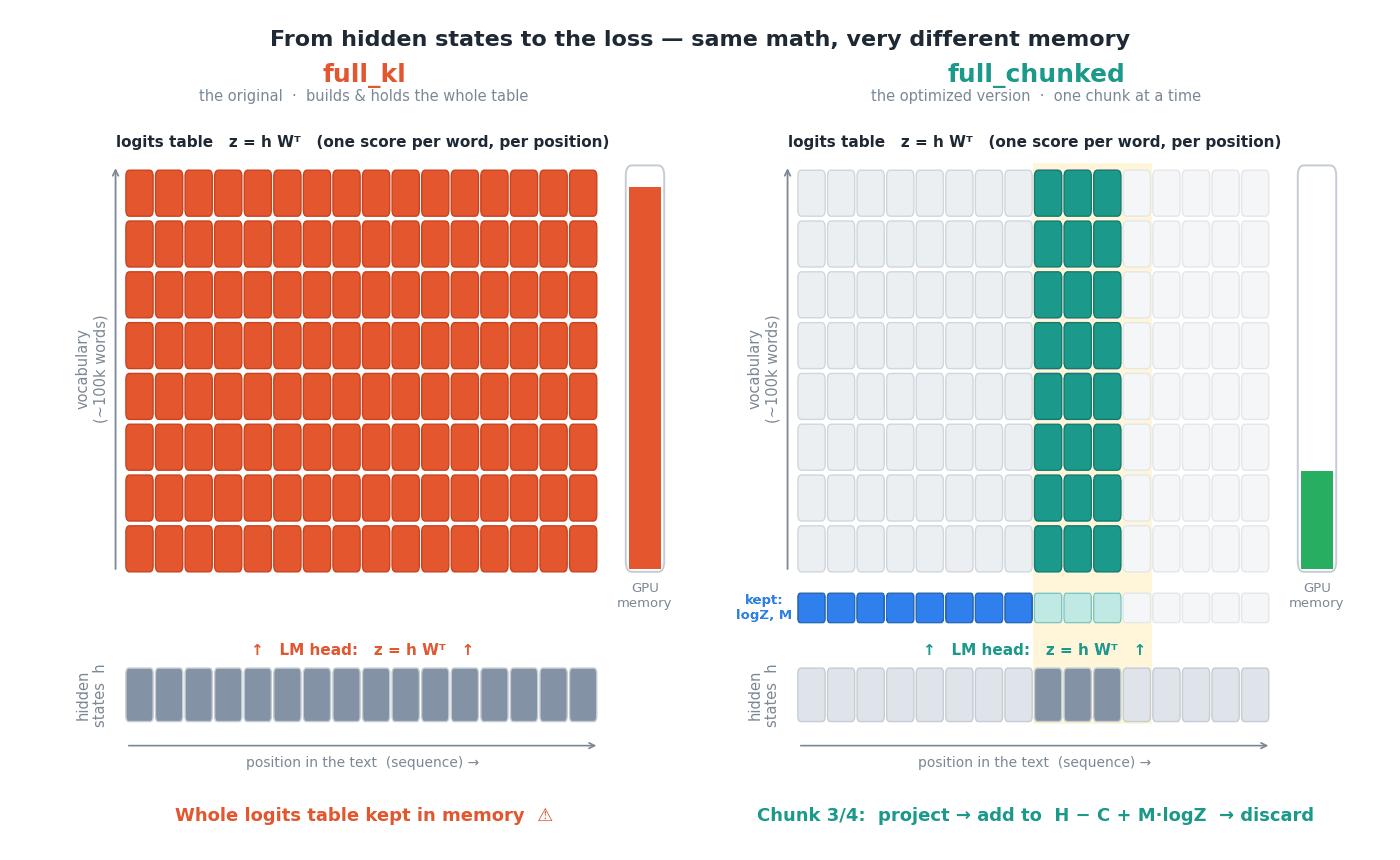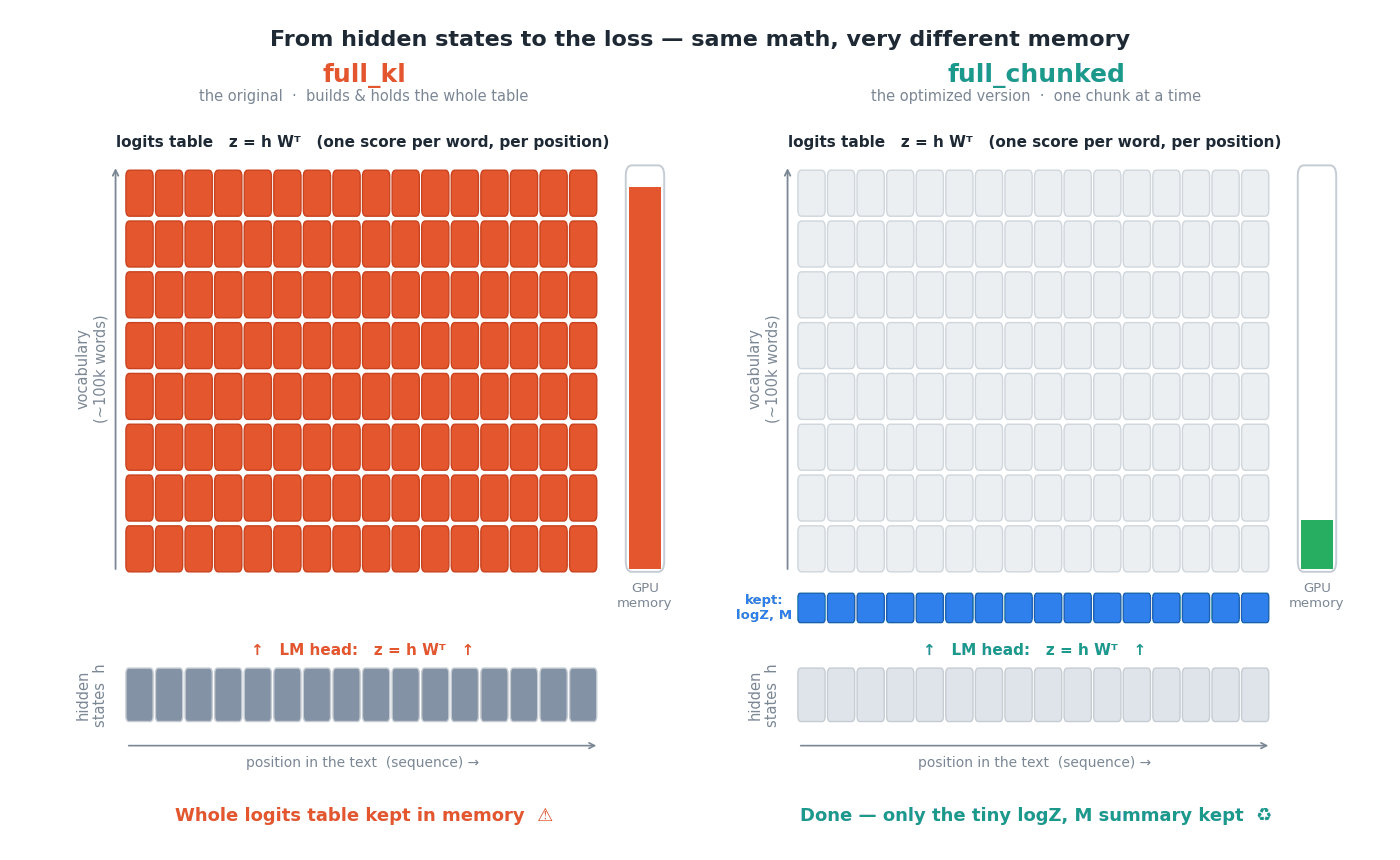
Fused, chunked KL loss: วิธีการคำนวณ Loss ปกติจะสร้างตารางขนาดมหาศาลเพื่อเปรียบเทียบความแตกต่างระหว่างครูและนักเรียน ซึ่งเราได้เปรียบเทียบ 3 วิธีที่ให้ผลทางคณิตศาสตร์เท่ากัน:
- Dense KL: วิธีมาตรฐานที่สร้างตารางหนาแน่นขึ้นมาใหม่ทั้งหมด ซึ่งกินหน่วยความจำสูงมาก
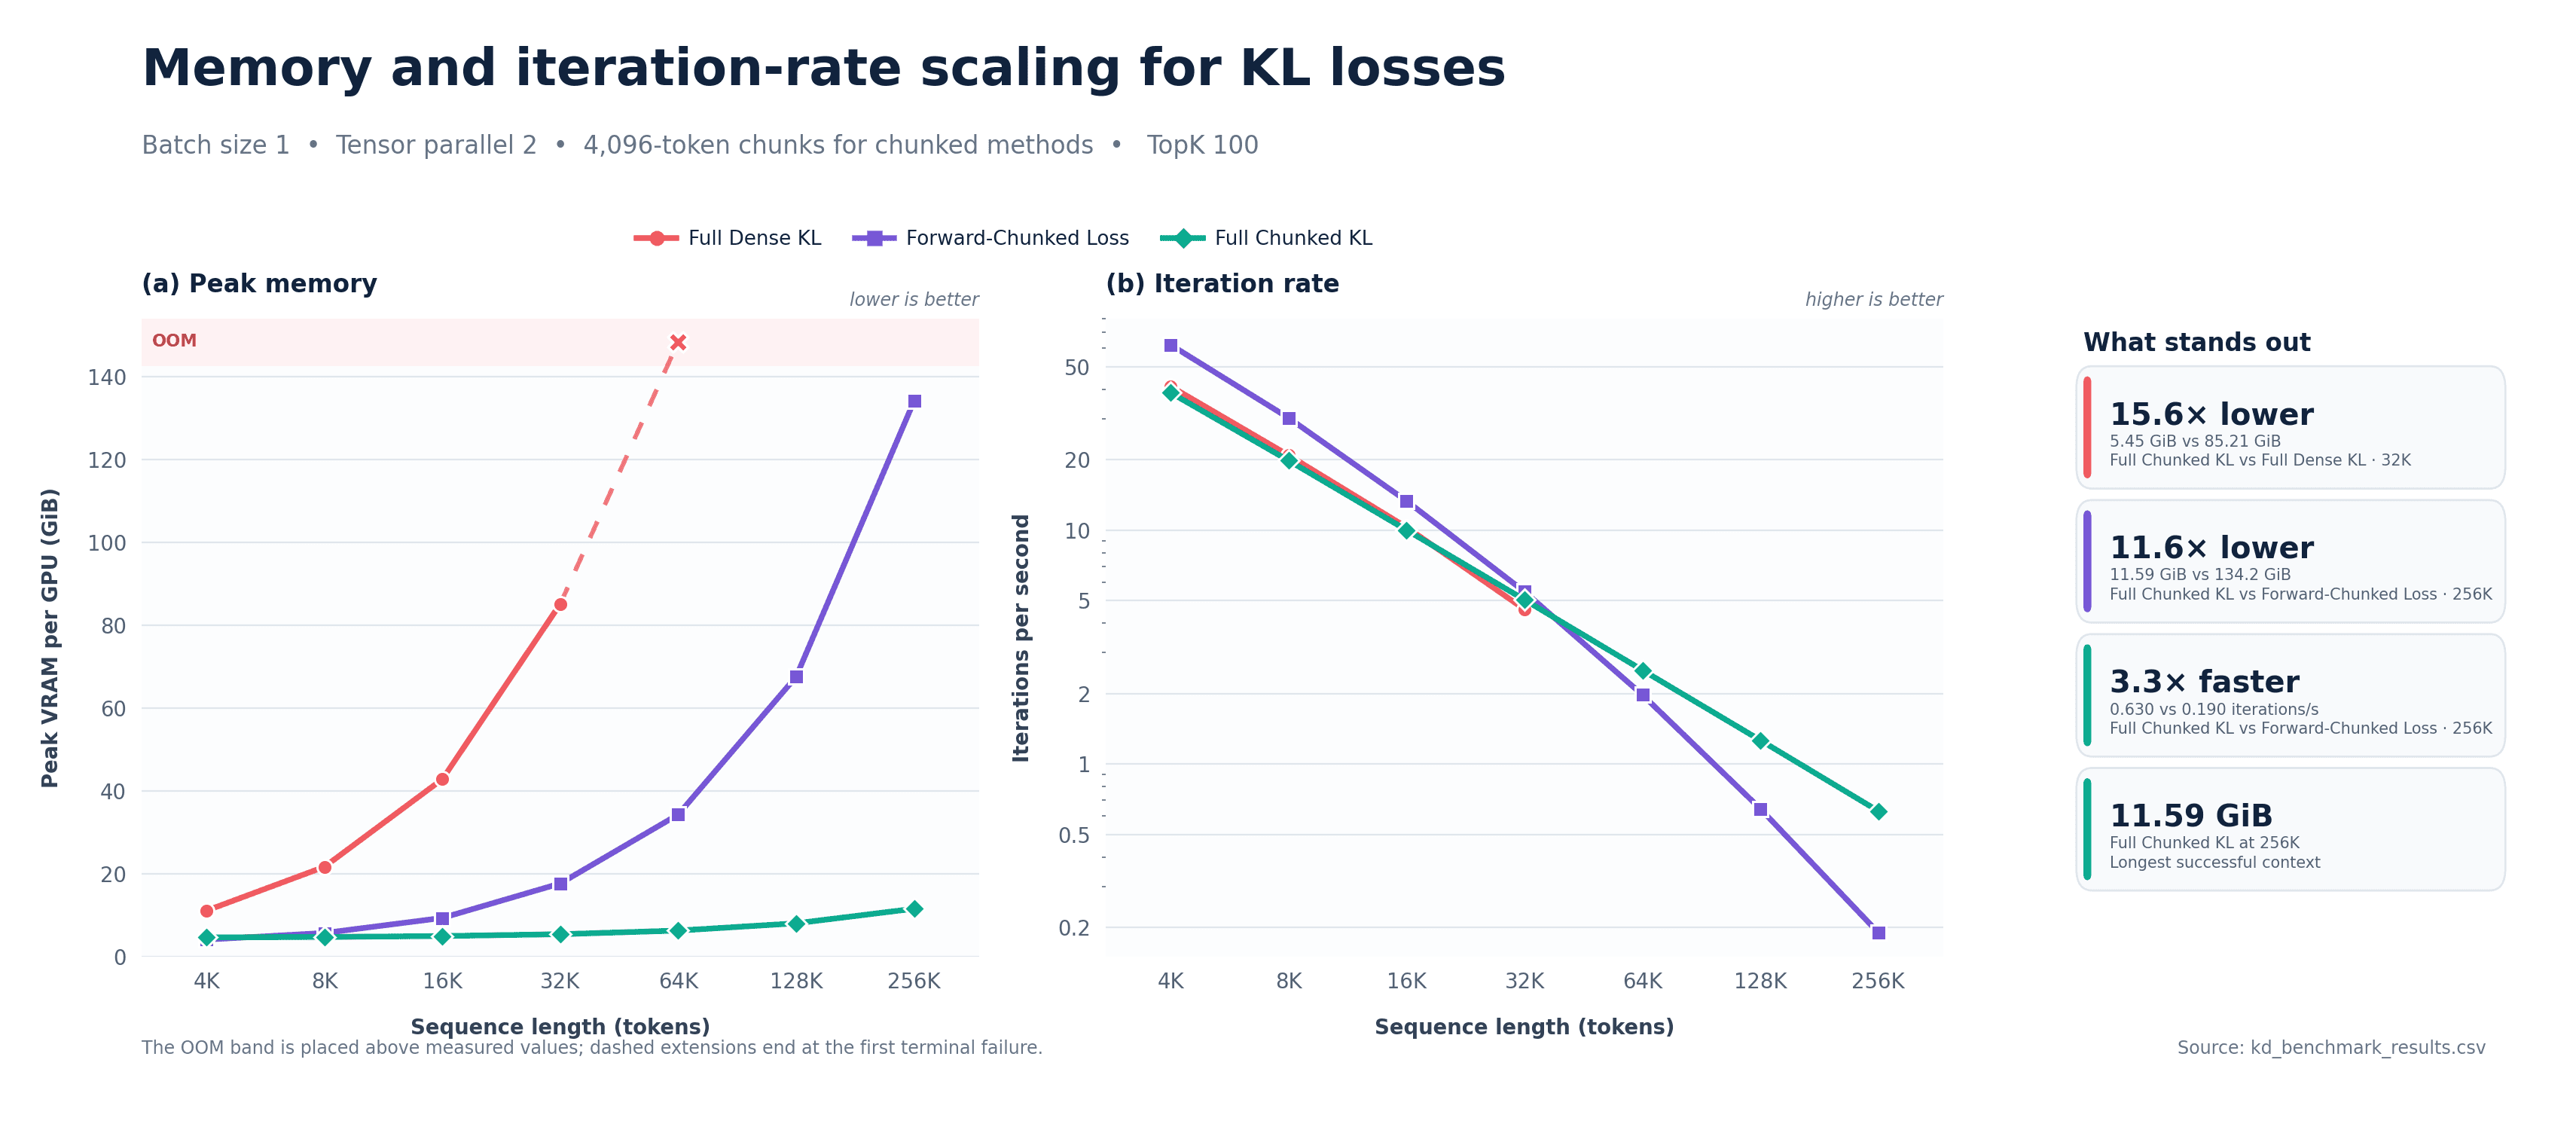
- Forward-chunked KL: ใช้วิธีคำนวณทีละส่วนตามตำแหน่ง Sequence ทำให้เร็วขึ้นและใช้ข้อมูลแบบเบาบาง (Sparse) แต่ยังมีจุดอ่อนที่ Logits ของนักเรียนยังคงกินหน่วยความจำตามความยาว Sequence
- Fused chunked KL: นวัตกรรมหลักของเราที่รวมการโปรเจกต์เอาต์พุตเข้ากับการคำนวณ Loss โดยตรง โดยจะไม่สร้างตาราง Logits ทั้งหมดของนักเรียนเลย แต่จะประมวลผลทีละส่วนแล้วทิ้งไปก่อนเริ่มส่วนถัดไป ทำให้หน่วยความจำสูงสุดเพิ่มขึ้นเป็นเส้นตรงตามความยาว Sequence เท่านั้น ไม่ได้พุ่งสูงตามขนาดคำศัพท์
เราได้เปิดให้ใช้งานโค้ดสำหรับการติดตั้งใช้งาน chunked-loss แล้วที่: github.com/CompactifAI/Full-Chunked-KL-Loss
สิ่งที่เปลี่ยนแปลงในการใช้งานจริง
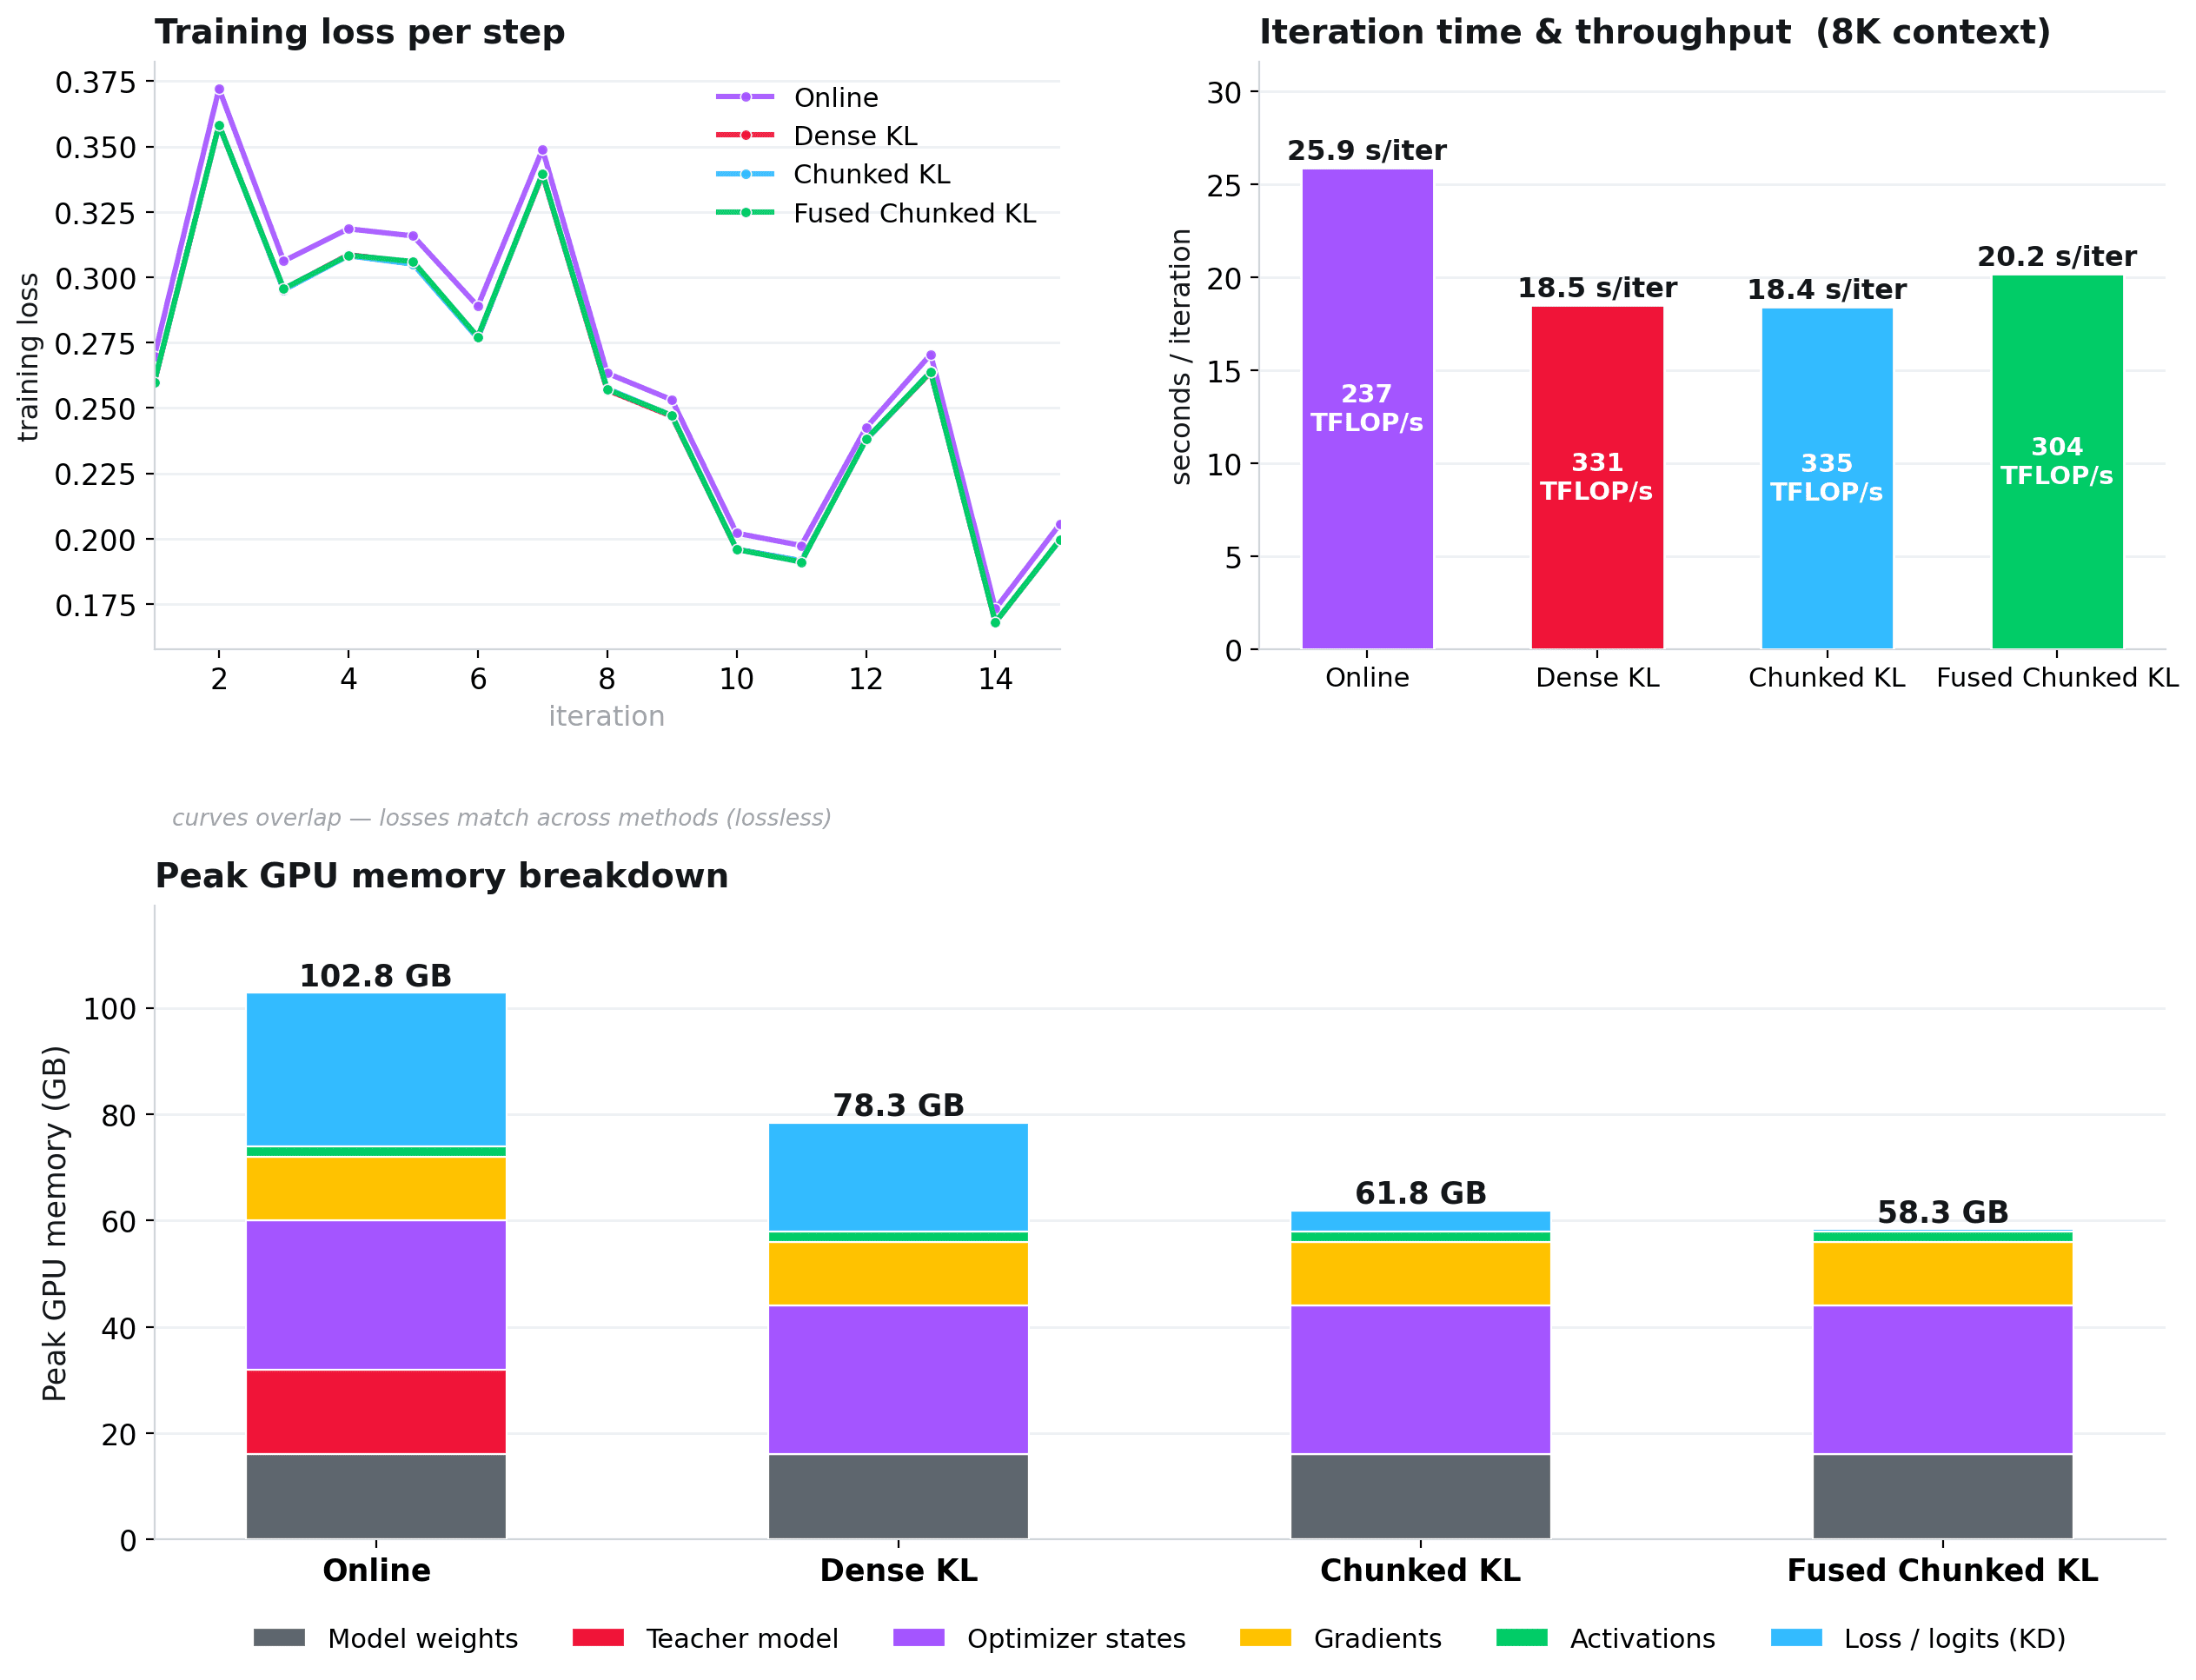
จากการทดสอบบน GPU H200 ตัวเดียว โดยใช้ Llama 3.1 8B Instruct เป็นครู และ Llama 3.2B เป็นนักเรียน ที่บริบท 8K พบว่าทั้งสี่วิธีให้ค่า Training Loss แทบไม่ต่างกัน ซึ่งยืนยันว่าการใช้ Offline Distillation กับแคช Top-100 Logits ไม่ได้ทำให้คุณภาพลดลง
| วิธีการ (บริบท 8K, H200 ตัวเดียว) | หน่วยความจำสูงสุด | เวลาต่อรอบ (Iteration time) | Throughput |
|---|---|---|---|
| Online distillation | 102.8 GB | 25.9 s | 237 TFLOP/s |
| Offline, dense KL | 78.3 GB | 18.5 s | 331 TFLOP/s |
| Offline, forward-chunked KL | 61.8 GB | 18.4 s | 335 TFLOP/s |
| Offline, fused chunked KL | 58.3 GB | 20.2 s | 304 TFLOP/s |
การสเกลไปยังความยาวบริบทที่มากขึ้น
เมื่อทดสอบที่บริบท 32K พบว่าหน่วยความจำสูงสุดลดลงจาก 85.2 GiB เหลือเพียง 5.45 GiB หรือลดลงถึง 15.6 เท่า และในระดับ 256K ตัว Fused Chunked ยังทำงานได้ในขณะที่วิธีอื่นล้มเหลว
สำหรับการทำ Distillation ของ GPT-OSS 20B เทคนิคนี้ช่วยให้เราลดการใช้ทรัพยากรจากโหนด GPU 4 โหนด เหลือเพียงโหนดเดียว พร้อมเพิ่มความเร็วขึ้นประมาณ 5 เท่า และมี Throughput เพิ่มขึ้นอย่างมหาศาล
ผลลัพธ์ของโมเดลนักเรียน
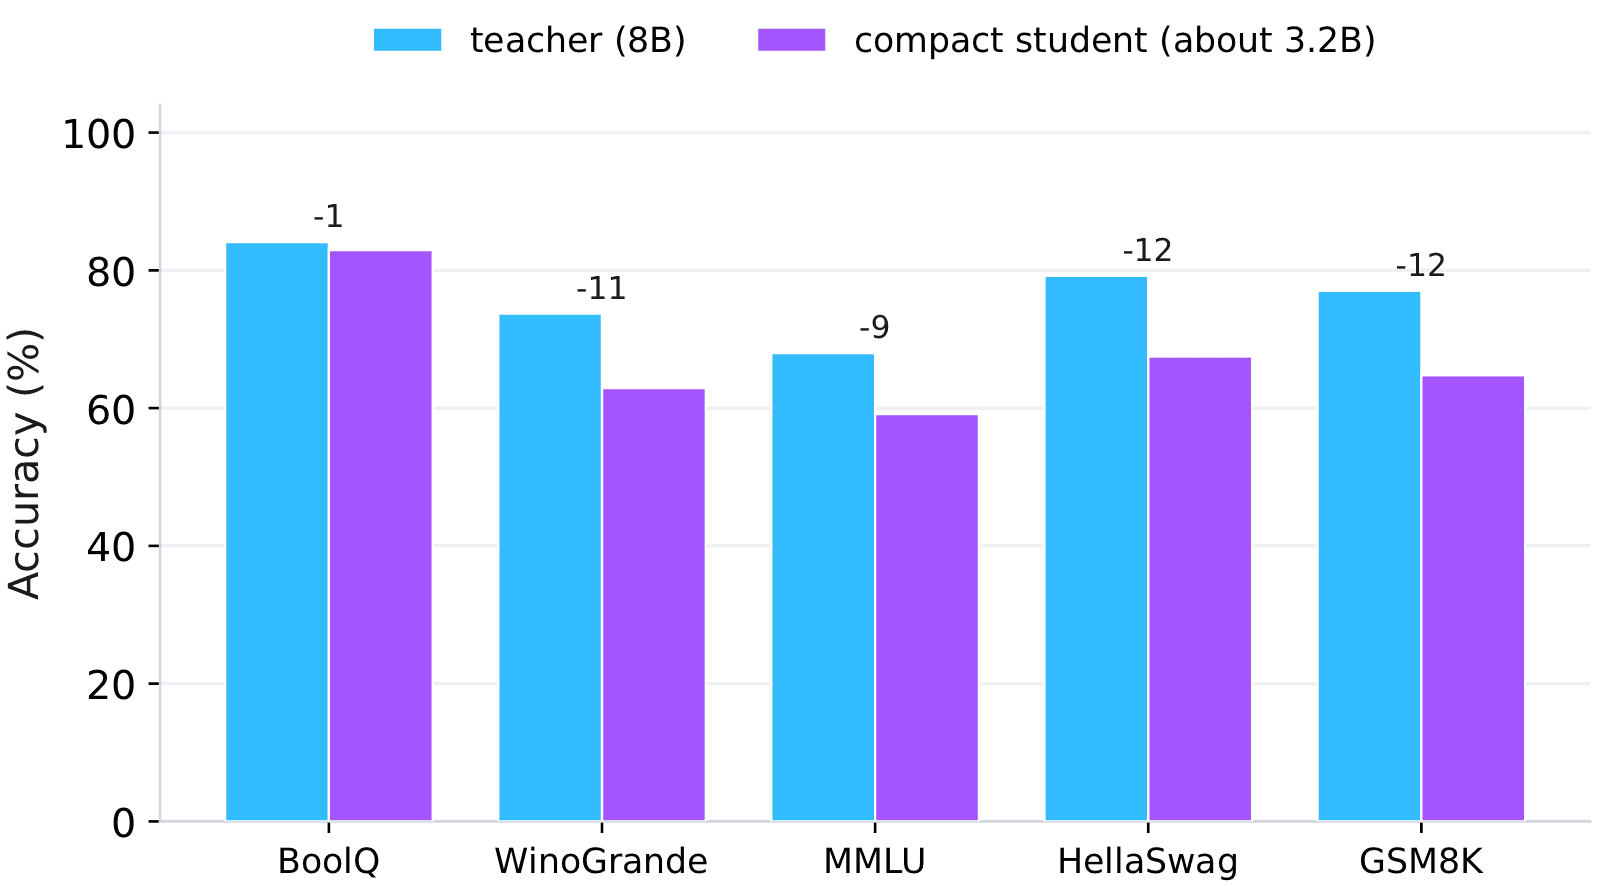
เทคนิค Offline Distillation ประสิทธิภาพสูงนี้ช่วยให้สร้างโมเดลนักเรียนขนาด 3.2B ที่มาจาก Llama 3.1 8B Instruct ได้โดยยังรักษาความแม่นยำส่วนใหญ่ไว้ได้ ทั้งใน BoolQ, HellaSwag และ MMLU แม้จะมีขนาดพารามิเตอร์น้อยกว่าครึ่งหนึ่งก็ตาม
งานวิจัยชิ้นนี้เป็นส่วนหนึ่งของความพยายามโดย Multiverse Computing เพื่อให้การ Distillation และ Healing โมเดล AI สามารถทำซ้ำได้จริงในราคาที่ถูกลง ผู้ที่สนใจสามารถอ่าน งานวิจัยฉบับเต็ม หรือลองใช้งานโค้ดได้ที่ GitHub ของเรา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร