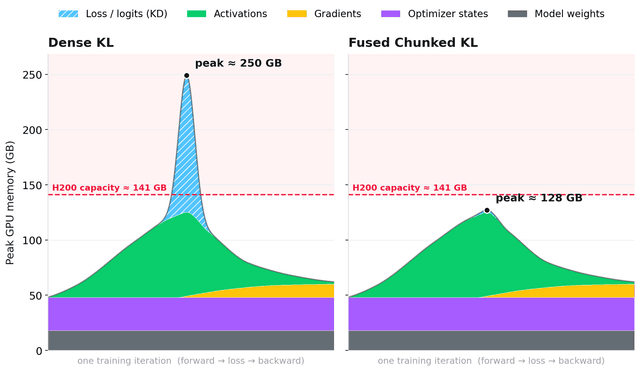
เผยเทคนิค Knowledge Distillation ใหม่: ลดใช้ VRAM 15 เท่า ฝึก AI ขนาดใหญ่ได้บน GPU ตัวเดียวtag: KL Loss, Knowledge Distillation, LLM, Machine Learning, Multiverse Computing, VRAMAug 10, 2026 · By: AttapolKMultiverse Computing พัฒนาเทคนิค Fused Chunked KL Loss ช่วยลดการใช้หน่วยความจำในการฝึกโมเดล AI ขนาดเล็กลงได้มหาศาล ทำให้การทำ Distillation ระดับสเกลใหญ่ประหยัดและเข้าถึงได้ง่ายขึ้น