
รู้จัก qwenGPU: เมื่อ Qwen3.5-2B รัน CUDA ได้ด้วยเลเยอร์ GPU 45 ชั้น
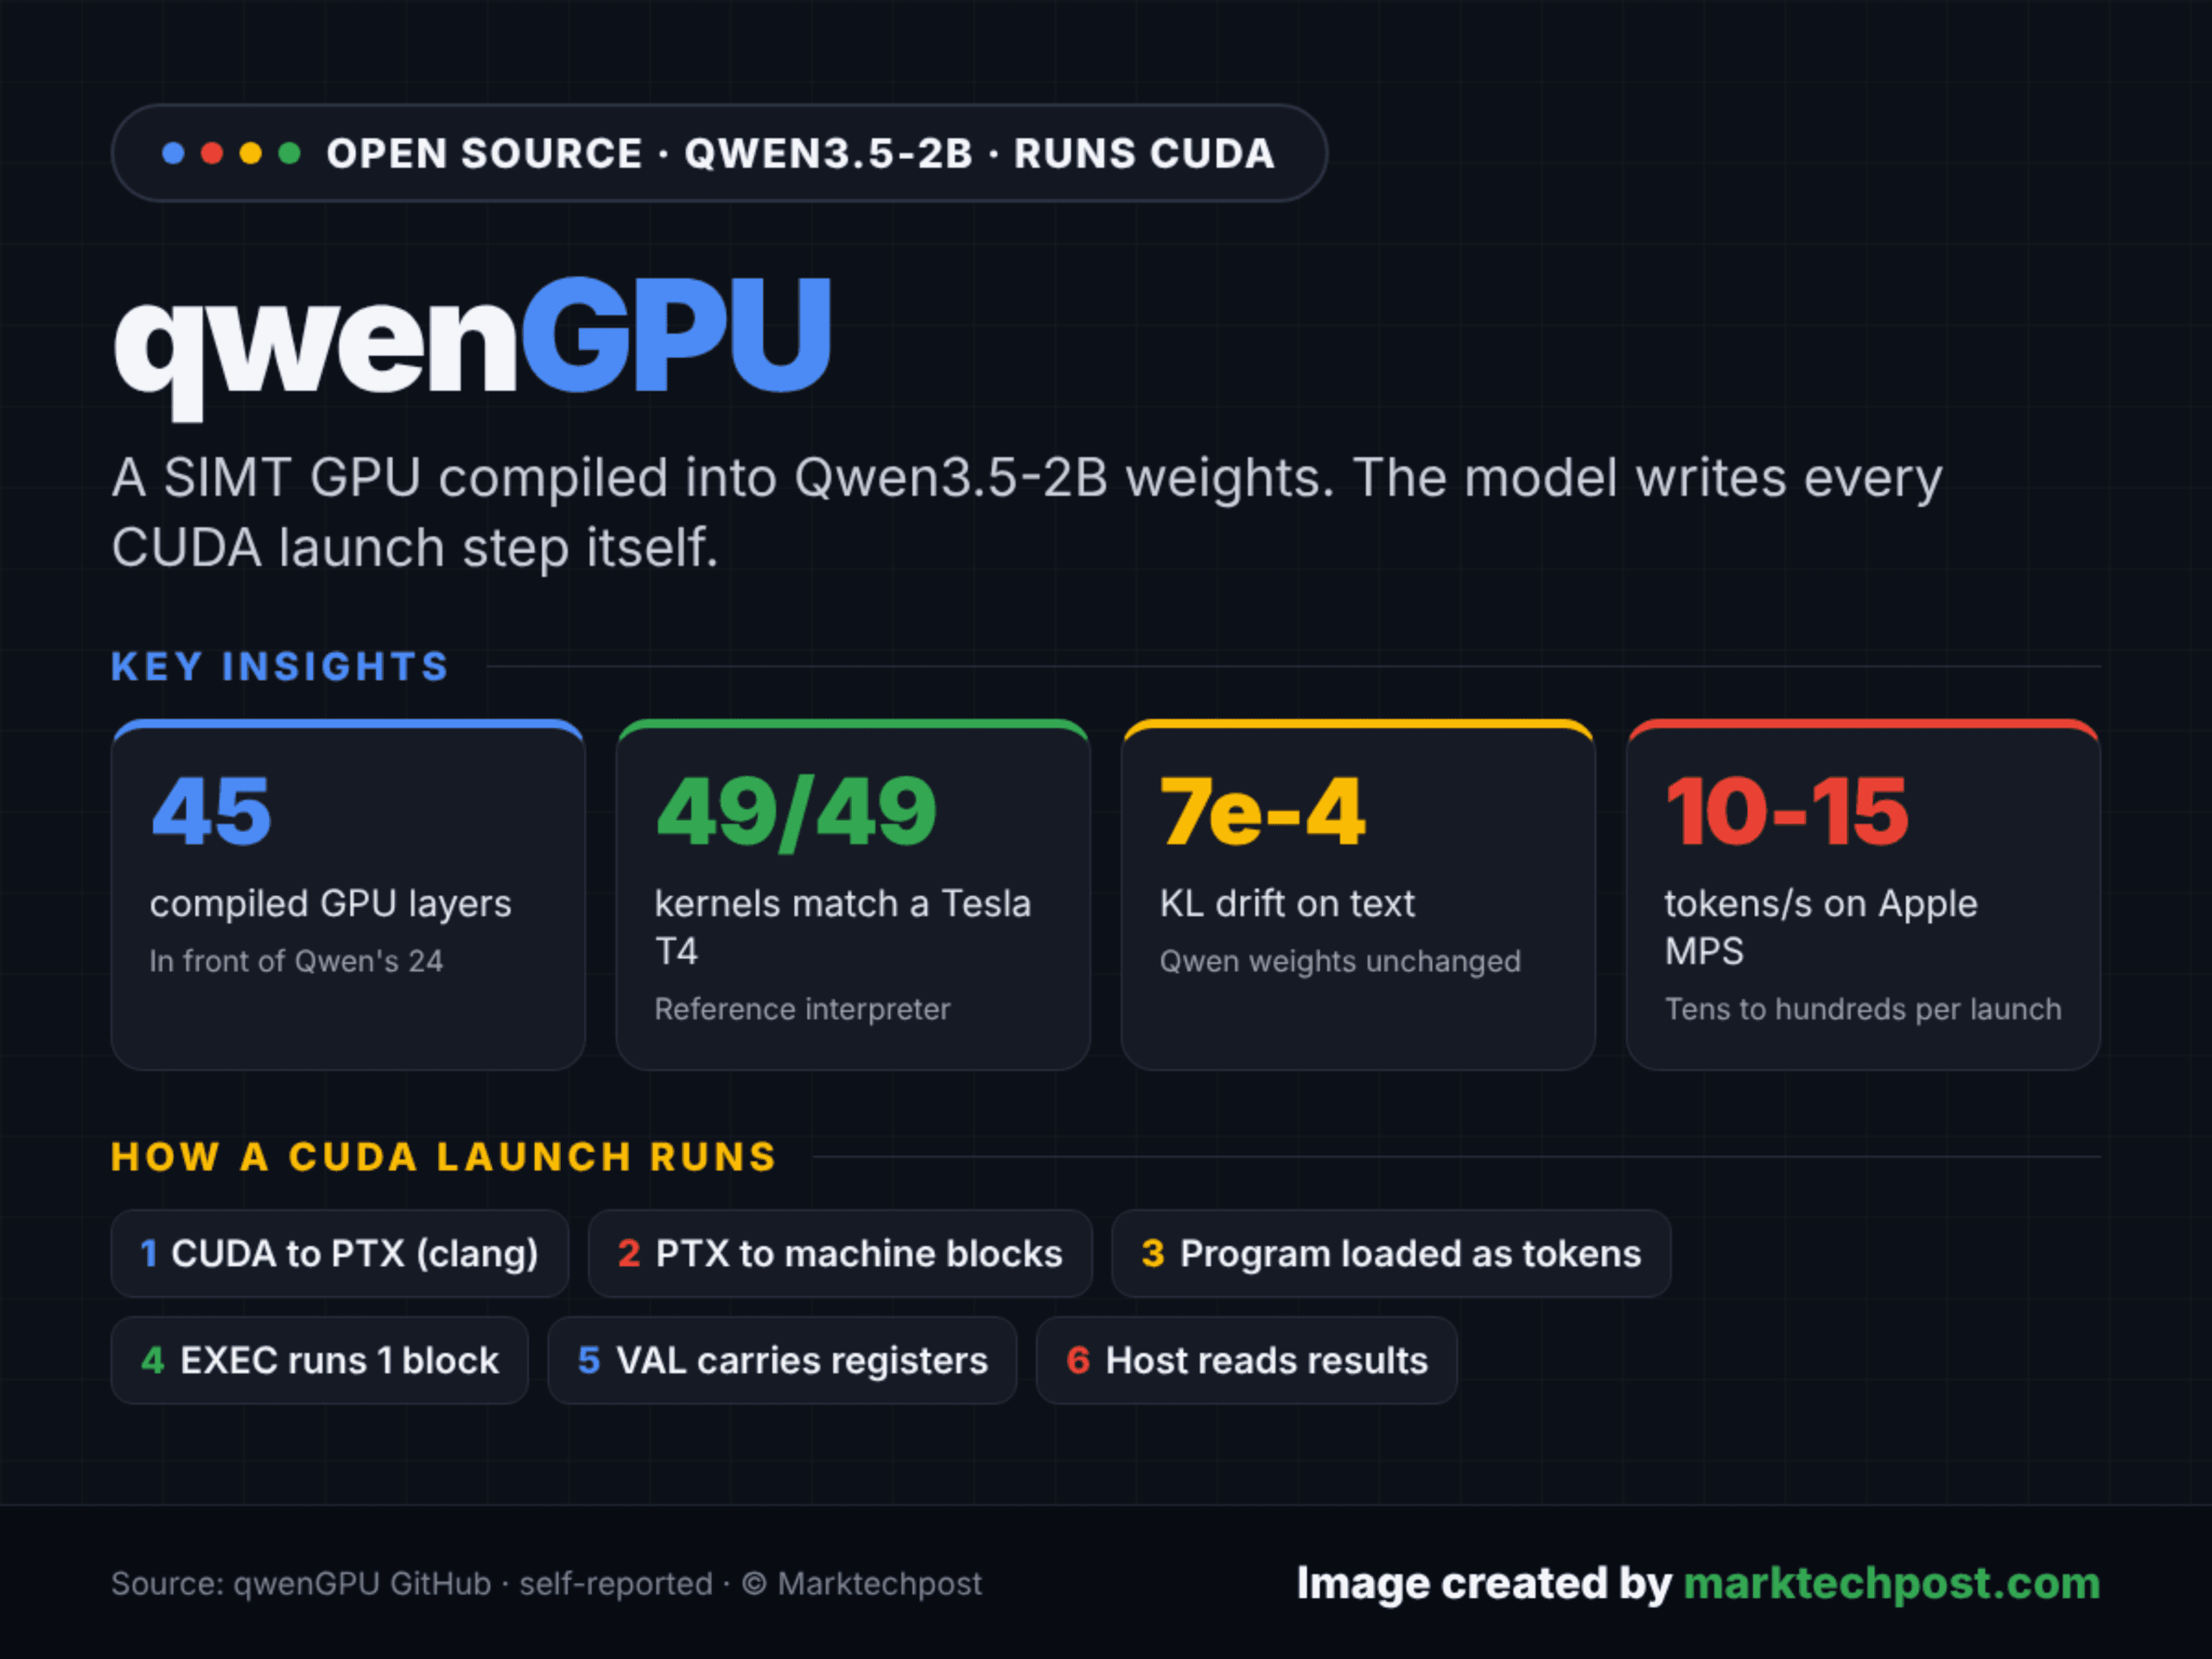
qwenGPU เป็นโมเดลเชิงทดลองที่คอมไพล์ SIMT GPU ลงใน weight ของ Qwen3.5-2B โดยตรง ผู้พัฒนา Vixhal (@TheVixhal) ได้ปล่อยโปรเจกต์นี้บน GitHub ภายใต้ใบอนุญาต MIT โดยโมเดลสามารถรัน CUDA จริงที่คอมไพล์เป็น NVIDIA PTX ภายใน forward passes ของตัวเอง
สำหรับนักพัฒนา โปรเจกต์นี้เป็นการพิสูจน์แนวคิดว่า LLM ที่ผ่านการ pretrained มาแล้ว สามารถคำนวณอย่างแม่นยำภายในโมเดลได้โดยตรง แทนที่จะเป็นการคำนวณแยกส่วนกันแบบทั่วไป
สรุปข้อมูลสำคัญ (TL;DR)
- ขนาด: Qwen3.5-2B (24 เลเยอร์) เสริมด้วยเลเยอร์ GPU แบบคอมไพล์ 45 เลเยอร์ รวมเป็น 69 เลเยอร์ รองรับ Context 262,144 tokens
- ความต้องการระบบ: รันบน Apple silicon, NVIDIA GPU หรือ CPU โดยใช้หน่วยความจำว่างประมาณ 16 GB (ยังไม่มีเวอร์ชัน quantized)
- ประสิทธิภาพ: ให้ผลลัพธ์การคำนวณที่แม่นยำ (exact) โดยมีความคลาดเคลื่อนของข้อความ (text drift) ต่ำมากที่ค่า KL ประมาณ 7e-4
- ความแม่นยำ: ตัวถอดรหัสอ้างอิงให้ผลลัพธ์ตรงกับ NVIDIA Tesla T4 จริงใน 49 จาก 49 kernels
- ความเร็ว: ทำงานได้ประมาณ 10-15 tokens ต่อวินาทีบน Apple MPS โดย CUDA ที่เขียนโดย Qwen ผ่านการทดสอบ 4 จาก 5 ครั้ง
qwenGPU คืออะไร?
qwenGPU คือการนำ Qwen3.5-2B มาเพิ่มเลเยอร์ transformer แบบคอมไพล์จำนวน 45 เลเยอร์ไว้ด้านหน้าเลเยอร์เดิม 24 เลเยอร์ โดยเลเยอร์ที่เพิ่มมานี้ไม่ผ่านการเทรน แต่ใช้คอมไพเลอร์คำนวณค่า weight ทุกตัวขึ้นมา
GPU เข้าไปอยู่ใน weight ของโมเดลได้อย่างไร?
GPU ที่ถูกสร้างขึ้นเป็นเครื่องจักร SIMT แบบ 4-lane ประกอบด้วย 15 รีจิสเตอร์ต่อเลน, pipeline 4 ขั้นตอน, ROM 32 บล็อก และหน่วยความจำ 126 เวิร์ด โดยใช้เพียงโครงสร้างเลเยอร์เดิมของ Qwen3.5 อย่าง Gated DeltaNet linear attention และ SwiGLU MLPs
เทคนิคสำคัญคือการใช้สถานะย้อนกลับ (recurrent state) ของ Gated DeltaNet โดยเปิดวงจร gate ค้างไว้และตั้งค่าความแรงในการเขียนเป็น 1 เพื่อใช้แต่ละแถวทำหน้าที่เป็นเซลล์หน่วยความจำสำหรับเก็บโปรแกรม ROM, รีจิสเตอร์ และหน่วยความจำส่วนกลาง (global memory)
GPU นี้รองรับทั้งการคำนวณทางคณิตศาสตร์แบบจำนวนเต็ม, predicates, divergent branches และ loops รวมถึงฟังก์ชันขั้นสูงอย่าง shared memory, atomicAdd, __syncthreads() และ warp shuffles
กระบวนการเมื่อเรียกใช้ CUDA
ในระบบนี้ โฮสต์จะทำหน้าที่เป็น NVRTC และ CUDA driver โดยคอมไพล์ CUDA เป็น PTX ด้วย clang จากนั้นจะลดระดับลงเป็น machine blocks และส่งโปรแกรมพร้อมอาเรย์อินพุตไปยังโมเดลในรูปแบบโทเคน
เมื่อถึงจุดนั้น โมเดลจะเขียนขั้นตอนการเรียกใช้ (launch) ด้วยตัวเอง โดยแต่ละโทเคน EXEC(b, w) จะรันบล็อกข้อมูลใน 1 forward pass ส่วนโทเคน VAL จะเก็บผลลัพธ์รีจิสเตอร์ โดยโฮสต์จะทำหน้าที่เพียงอ่านผลลัพธ์จาก recurrent state เท่านั้น ไม่ได้เป็นผู้คำนวณเอง
จากการทดสอบในวิดีโอสาธิต การหาผลคูณ dot product ของ [1, 2, 3] และ [4, 5, 6] ได้ผลลัพธ์เป็น 32 อย่างถูกต้อง โดยโมเดลเขียนคำสั่งเรียกใช้ผ่าน 47 tokens
ความสามารถในการแชทยังเหมือนเดิมหรือไม่?
ผู้พัฒนายืนยันว่าความสามารถในการแชทไม่เสียหาย เนื่องจากวงจรที่เพิ่มมาจะถูกปิดเสียง (muted) เมื่อประมวลผลโทเคนข้อความ และ weight เดิมของ Qwen ไม่ถูกแก้ไข ส่งผลให้การกระจายโทเคนถัดไป (next-token distribution) ยังคงใกล้เคียงกับโมเดลต้นฉบับมาก
ความแม่นยำของ qwenGPU
จากการทดสอบบน Apple silicon ด้วย MPS ในรูปแบบ bf16 พบว่า:
- ทุกการเรียกใช้ให้ผลลัพธ์แม่นยำภายใต้โหมดตรวจสอบ
- ตัวถอดรหัสให้ผลตรงกับ NVIDIA Tesla T4 ใน 49 kernels ที่ทดสอบ
- ในโหมดปกติ (Normal mode) สามารถตอบคำถามแชทที่สุ่มมา 20 จาก 24 ข้อด้วยตัวเลขที่คำนวณจาก GPU
- ในโหมดขั้นสูง (Advanced mode) สามารถเขียน kernel ที่ถูกต้องในการลองครั้งแรกได้ 4 จาก 5 คำถาม
เปรียบเทียบกับเทคโนโลยีใกล้เคียง
qwenGPU พัฒนาต่อยอดจาก transformer compiler ของ Qwenputer ที่เคยคอมไพล์ 32-bit RISC-V CPU เข้าไปใน Qwen3.5-4B ขณะที่ Percepta เป็นอีกหนึ่งงานวิจัยที่สร้างตัวถอดรหัส WebAssembly เข้าไปใน transformer
| คุณสมบัติ | qwenGPU | Qwenputer (RISC-V) | Percepta |
|---|---|---|---|
| โมเดลฐาน | Qwen3.5-2B | Qwen3.5-4B | Custom transformer |
| เครื่องจักรที่คอมไพล์เข้าไป | 4-lane SIMT GPU | 32-bit RISC-V | WebAssembly interpreter |
| โปรแกรมที่รัน | CUDA (จาก PTX) | C และ MicroPython | C (เป็น WebAssembly) |
| เลเยอร์ที่คอมไพล์ | 45 | 11 | ไม่ระบุ |
| ตำแหน่งของสถานะ | Gated DeltaNet | Gated DeltaNet | Execution trace ใน context |
| Text drift (ค่า KL) | ประมาณ 7e-4 | 6e-4 | ไม่ระบุ |
เริ่มต้นใช้งาน
ผู้ที่สนใจต้องมี Python 3.11+, uv, just และหน่วยความจำว่าง 16 GB โดยสามารถใช้คำสั่ง just build เพื่อดาวน์โหลด Qwen3.5-2B และคอมไพล์ GPU ลงไปได้ทันที ทั้งนี้ผู้พัฒนาไม่ได้แจกจ่าย checkpoint สำเร็จรูป แต่ตัวไฟล์ที่สร้างขึ้นจะอยู่ภายใต้ใบอนุญาต Apache-2.0 ของ Qwen
บทสรุปสำคัญ
qwenGPU เป็นการสาธิตศักยภาพของ LLM ในการทำหน้าที่เป็นฮาร์ดแวร์ประมวลผลผ่านเลเยอร์ที่ไม่ต้องเทรนใหม่ โดยใช้สถานะ Gated DeltaNet เป็นหน่วยความจำหลัก แม้ความเร็ว 10-15 tokens ต่อวินาทีจะยังไม่เหมาะกับการใช้งานจริง แต่ก็นับเป็นก้าวสำคัญในงานวิจัยด้านการประมวลผลภายในโมเดลภาษา
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร