
เปิดตัว Saluki 27B: โมเดลจิ๋ว 2-bit ที่เก่ง Tool Calling กว่ารุ่นพี่
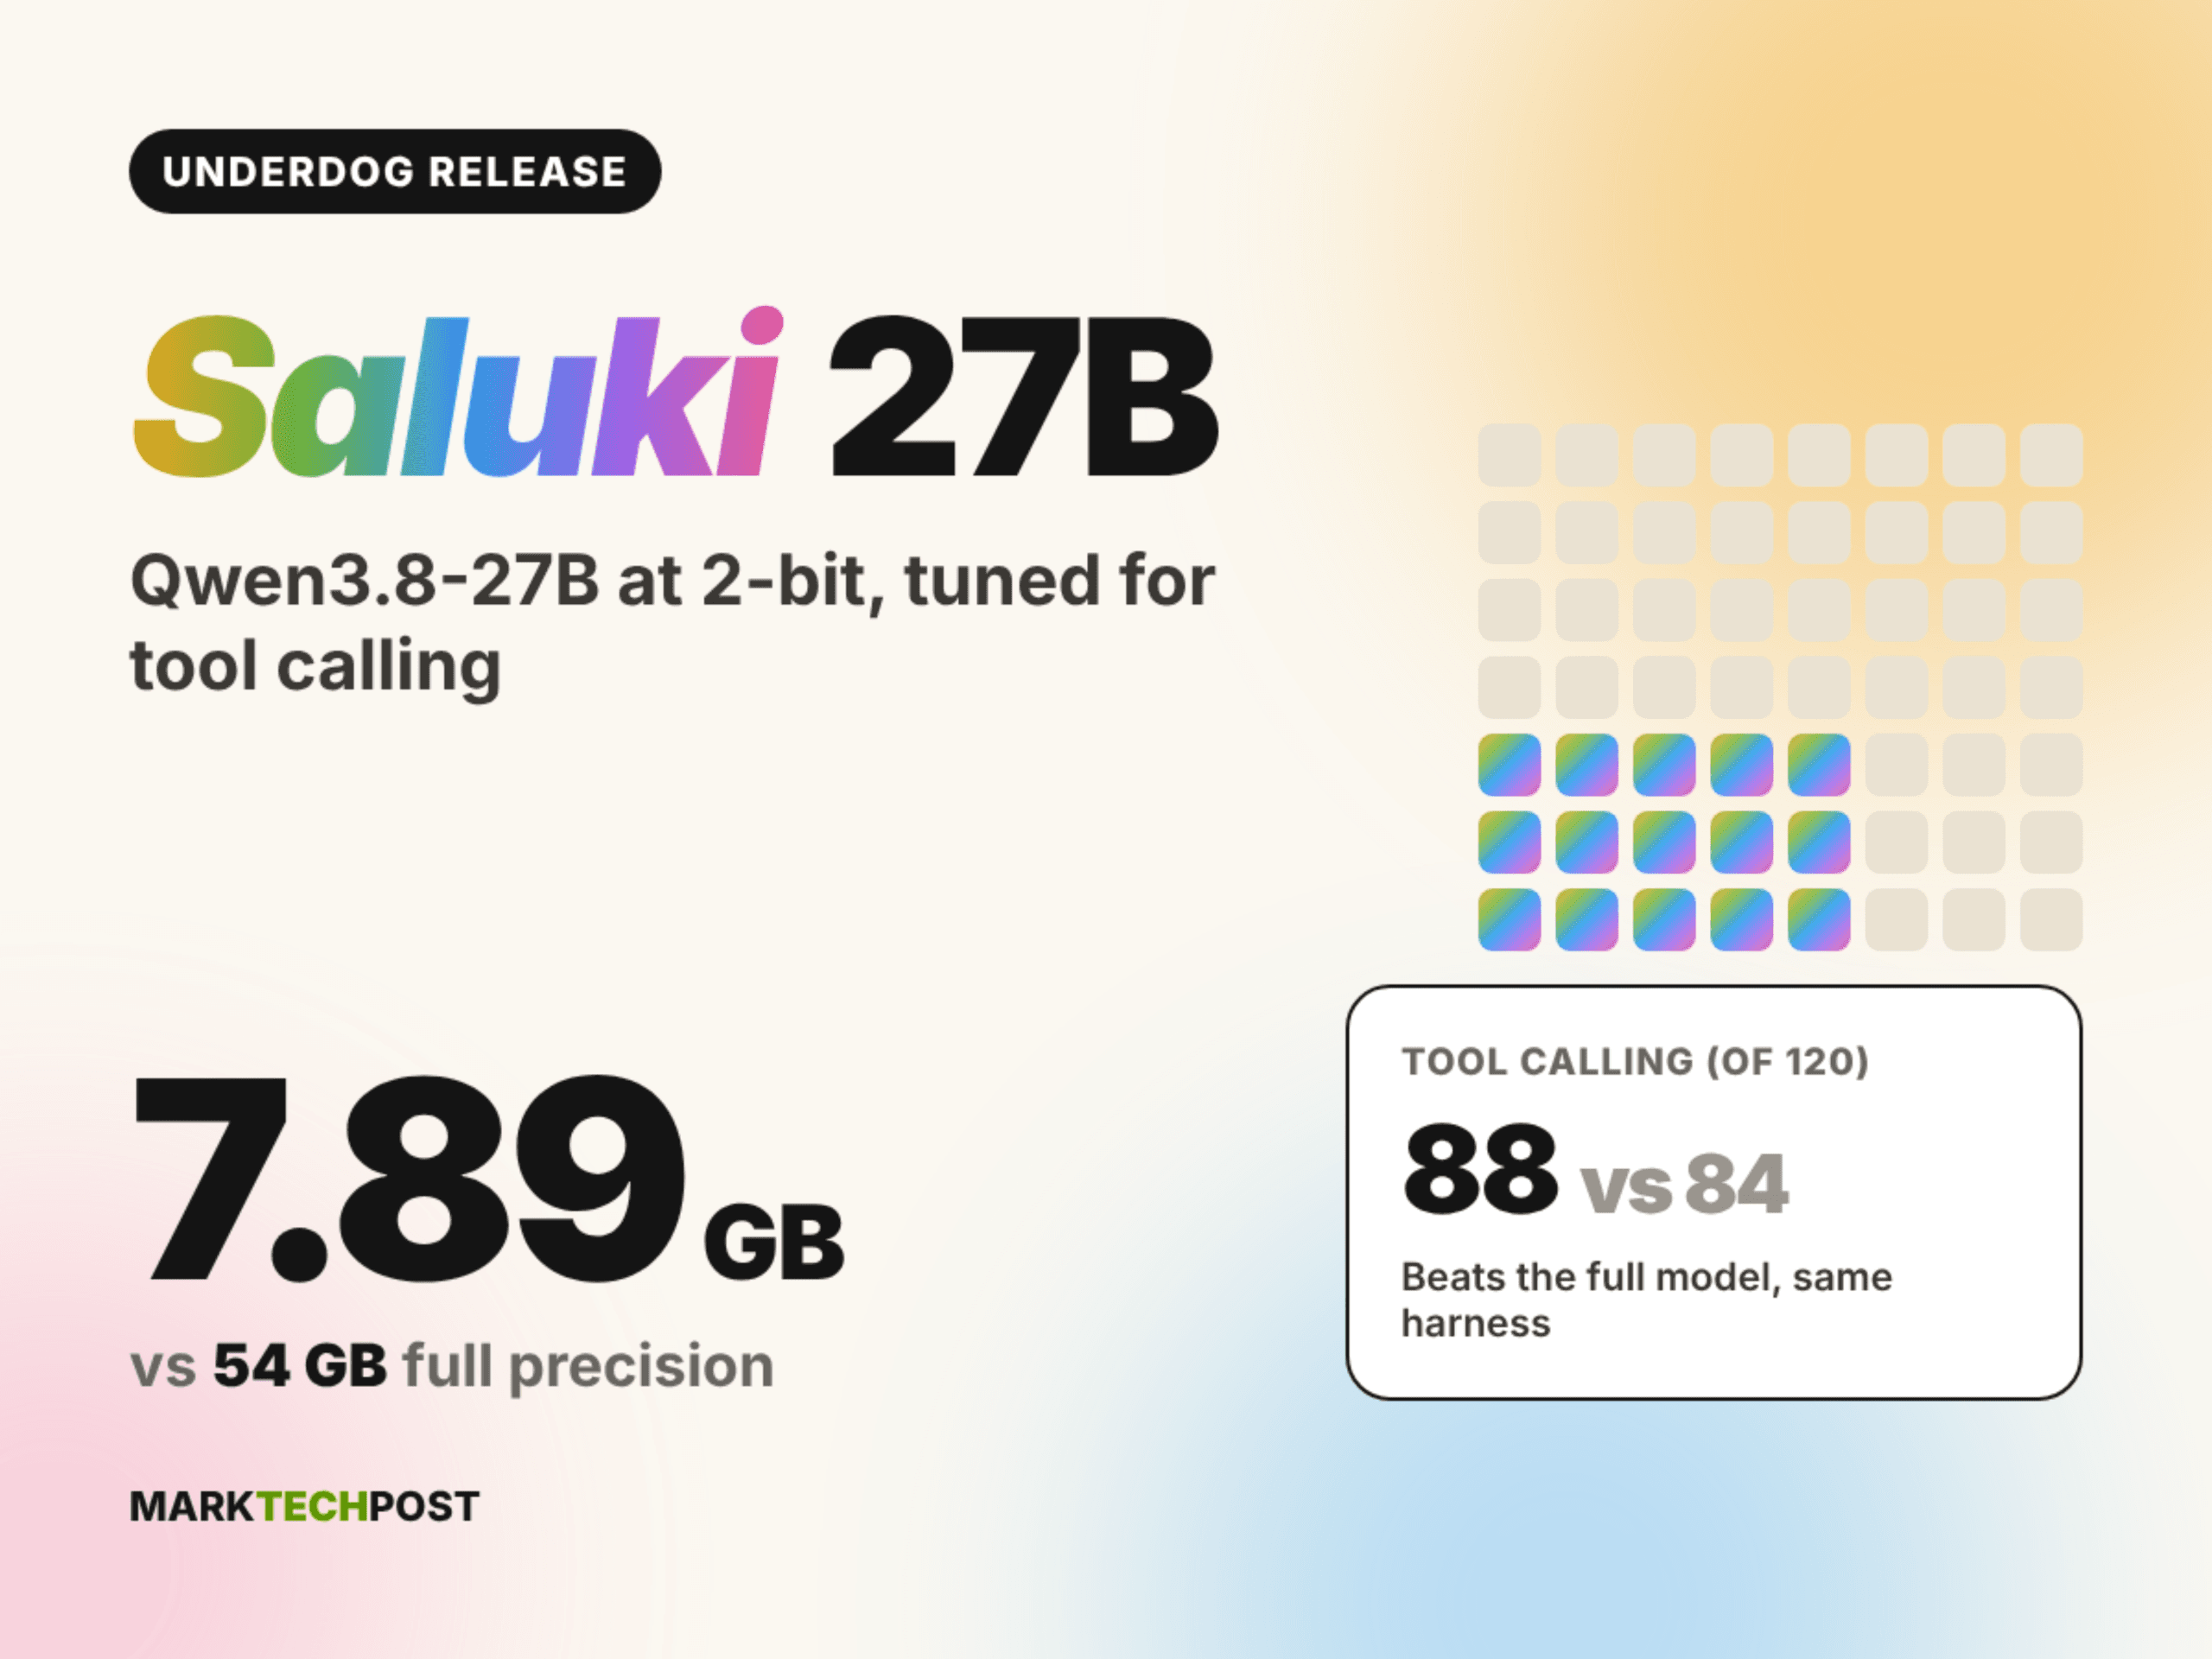
Underdog ผู้ช่วยส่วนตัวบนอุปกรณ์ (on-device assistant) จาก Conway Research ได้ทำการ released Saluki 27B ภายใต้สัญญาอนุญาต Apache 2.0 โดยโมเดลนี้เป็นเวอร์ชัน GGUF แบบ 2-bit ของ Qwen3.8-27B ที่มีขนาดไฟล์เพียง 7.89 GB ลดลงอย่างมากเมื่อเทียบกับโมเดล BF16 ตัวเต็มที่ต้องใช้พื้นที่ถึง 54 GB
ทาง Underdog ได้ปรับแต่งเทคนิคการบีบอัดเพื่อเน้นรักษาความสามารถด้าน tool calling ซึ่งเป็นหัวใจสำคัญในการเปลี่ยนโมเดลแชทให้กลายเป็น agent สำหรับนักพัฒนา ส่งผลให้โมเดลระดับ 27B นี้สามารถทำงานเป็น agent ได้อย่างมีประสิทธิภาพบน stock llama.cpp
TL;DR
- Size: พารามิเตอร์แบบ dense ขนาด 27B โดยมีขนาดไฟล์ GGUF 7.89 GB เทียบกับ 54 GB สำหรับ BF16
- Runs on: รองรับ stock llama.cpp และแอปพลิเคชันที่สร้างบนนี้ พร้อมรองรับ full GPU offload และมีส่วนเสริมด้าน vision ขนาด 629 MB หรือ 928 MB ให้เลือก
- Performance: รักษาประสิทธิภาพเฉลี่ยได้ 96% จาก 9 benchmark เมื่อเทียบกับ Qwen3.8-27B ตัวเต็ม
- Best: การเรียกเครื่องมือแบบขนาน (Parallel tool calls) ทำได้ 42 ครั้ง เทียบกับ 35 ครั้งในโมเดลตัวเต็ม (คิดเป็น 120% ของประสิทธิภาพเดิม)
- Worst: AIME 2025 ได้คะแนน 79.2 เทียบกับ 96.7 (รักษาประสิทธิภาพได้ประมาณ 82%)
- Bottom line: ข้อดีคือชนะรุ่นต้นฉบับขนาด 54 GB ในด้าน tool calling ด้วยขนาดไฟล์ที่เล็กกว่า 8 GB แต่ต้องแลกกับคะแนนคณิตศาสตร์ระดับการแข่งขันและการใช้เหตุผลหลายขั้นตอนที่ลดลง 12 ถึง 18 จุด
Underdog Saluki 27B คืออะไร?
Saluki 27B คือ Qwen3.8-27B ในรูปแบบ GGUF แบบ mixed-precision 2-bit ที่ออกแบบมาสำหรับ local agents โดยเฉพาะ โดยมีโครงสร้างการทำงานซ้อนกัน 3 ชั้น ดังนี้:
ชั้นแรกคือฐานจาก Qwen3.8-27B ซึ่งเป็นโมเดล dense ขนาด 27B จากทีม Qwen ประกอบด้วย 64 เลเยอร์ ผสมผสาน Gated DeltaNet linear attention เข้ากับ gated attention และรองรับ 262,144 tokens โดยกำเนิด
ชั้นที่สองเป็นการนำ Qwen3.8-27B-GSQ-RCO-GGUF ของ ISTA-DASLab มาใช้ โดยเทคโนโลยี GSQ จะเรียนรู้ scalar grids บิตต่ำที่แม่นยำต่อหนึ่ง tensor และ RCO จะกำหนดประเภท quantization ให้กับแต่ละ tensor ตามงบประมาณขนาดไฟล์ที่กำหนด
ชั้นสุดท้ายคือการประมวลผลเฉพาะของ Underdog ที่ช่วยรีดขนาดไฟล์ลงเหลือ 7.89 GB โดยมุ่งเน้นไปที่ประสิทธิภาพ tool calling ไฟล์นี้ใช้ชื่อว่า IQ2-mix และมี imatrix tag กำกับไว้ แม้ว่าทาง Underdog จะยังไม่ได้เปิดเผยสูตรการประมวลผลทั้งหมดในส่วนนี้ก็ตาม
ประสิทธิภาพของ Saluki บน Benchmark เป็นอย่างไร?
Underdog ได้เปรียบเทียบผลลัพธ์โดยแบ่งเป็น 2 กลุ่มการทดสอบ
กลุ่มแรก รันทั้งสองโมเดลในสภาพแวดล้อมเดียวกัน:
- Underdog Bench: ทดสอบ 120 งานจาก BFCL v4 (ปิดการคิดและตั้งค่า temperature เป็น 0) Saluki ทำได้ 88 คะแนน ชนะโมเดลตัวเต็มที่ได้ 84 คะแนน และ Bonsai 2 ของ PrismML ที่ได้ 70 คะแนน
- Parallel tool calls: ทดสอบงานขนาน 100 งานจาก BFCL v4 ปรากฏว่า Saluki ทำได้ 42 ครั้ง ขณะที่โมเดลตัวเต็มทำได้ 35 ครั้ง
- SWE-bench Verified: ในการแก้ปัญหา 50 รายการ Saluki แก้ได้ 30 ปัญหา ส่วนโมเดลตัวเต็มแก้ได้ 33 ปัญหา
กลุ่มที่สอง เปรียบเทียบ Saluki กับคะแนนสาธารณะของรุ่นตัวเต็ม:
| Benchmark | Saluki 27B | Qwen3.8-27B (สาธารณะ) |
|---|---|---|
| IFEval (prompt-loose) | 93.5 | 91.5 |
| IFBench (prompt-loose) | 72.7 | 71.0 |
| MBPP+ | 78.0 | 83.9 |
| MuSR | 67.5 | 79.6 |
| AIME 2025 (avg@4) | 79.2 | 96.7 |
| AIME 2026 (avg@4) | 80.0 | 94.6 |
Saluki เปรียบเทียบกับ Qwen3.8-27B รุ่นคอมแพคอื่นๆ อย่างไร?
| Feature | Underdog Saluki 27B | Qwen3.8-27B (BF16) | ISTA GSQ-RCO IQ2_XS | PrismML Bonsai 2 27B (PTQ1_0) |
|---|---|---|---|---|
| องค์กร | Underdog (Conway Research) | ทีม Qwen | ISTA-DASLab | PrismML |
| พารามิเตอร์ | 27B | 27B | 27B | 27.36B |
| ขนาดไฟล์ | 7.89 GB | 54 GB | 8.4 GB | 5.95 GB |
| Bits per weight | ไม่เปิดเผย (2-bit mix) | 16 | 2.50 | 1.75 |
| บริบท (Context) | ไม่เปิดเผย | 262,144 native | ไม่เปิดเผย | 262K |
| Vision | ส่วนเสริม 629 หรือ 928 MB | มีในตัว | 0.9 GB mmproj | ตัวเลือกเสริม 0.63 GB |
| รันไทม์ | Stock llama.cpp | Transformers, vLLM, SGLang | Stock llama.cpp, Ollama, LM Studio | PrismML llama.cpp fork |
| Underdog Bench (จาก 120) | 88 | 84 | ไม่เปิดเผย | 70 |
| จุดเด่น | รักษาประสิทธิภาพเฉลี่ย 96% | พื้นฐาน | 100.3% zero-shot recovery | 98.2% ของ FP16 |
| สัญญาอนุญาต | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
แม้ Bonsai 2 จะมีขนาดเล็กกว่าและมีคะแนนคณิตศาสตร์ที่แข็งแกร่งกว่าใน AIME25 แต่จำเป็นต้องใช้ llama.cpp เวอร์ชันดัดแปลงของ PrismML เท่านั้น ในขณะที่ Saluki สามารถรันบน stock llama.cpp มาตรฐานได้ทันที อย่างไรก็ตาม ควรระวังว่าคะแนนจากผู้ผลิตแต่ละรายอาจเปรียบเทียบกันโดยตรงไม่ได้เนื่องจากสภาพแวดล้อมการทดสอบที่ต่างกัน
สรุปประเด็นสำคัญ
Saluki 27B สามารถบีบอัด Qwen3.8-27B ให้เหลือขนาดไม่ถึง 8 GB แต่ยังคงความสามารถด้าน tool calling ได้อย่างยอดเยี่ยมจนชนะโมเดลตัวเต็ม แม้ว่าประสิทธิภาพด้านคณิตศาสตร์และการใช้เหตุผลจะลดลงเหลือประมาณ 82-85% ของเดิม แต่การรองรับ stock llama.cpp ภายใต้สัญญาอนุญาต Apache 2.0 ก็ทำให้มันเป็นตัวเลือกที่น่าสนใจสำหรับนักพัฒนา local agents
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร