
Meta FAIR เปิดตัว RPMs: โมเดล AI ช่วยจัดอันดับงานวิจัย ประหยัดเวลาประมวลผล GPU ได้กว่า 1.5 เท่า
ปัจจุบัน AI research agents สามารถนำเสนอและดำเนินการทดลอง Machine Learning ได้ด้วยตัวเอง แต่ความท้าทายอยู่ที่ต้นทุนการตรวจสอบที่สูงมาก แม้การสร้างไอเดียจะทำได้ง่ายและราคาถูก แต่การฝึกฝนโมเดลแต่ละครั้งอาจต้องใช้เวลาบน GPU นานหลายชั่วโมงหรือหลายวัน ทำให้เหล่า Agent มักเสนอไอเดียเกินกว่ากำลังการประมวลผลที่มี กลไกการเลือกการทดลองที่คุ้มค่าที่สุดจึงกลายเป็นปัจจัยสำคัญต่อความก้าวหน้าในการวิจัย
ทีมวิจัยจาก FAIR ของ Meta ร่วมกับ University of Oxford และ University College London ได้กำหนดนิยามกลไกนี้ว่า research preference พร้อมเปิดตัว AI Research Preference Models (RPMs) ซึ่งเป็นโมเดลที่ทำหน้าที่จัดอันดับตัวเลือกที่ยังไม่ได้รันและคัดเลือกเพียงรายการเดียวเพื่อดำเนินการต่อ โดย RPM จะไม่ทำนายคะแนนดิบโดยตรงเนื่องจากพบว่า Language Models ยังขาดความแม่นยำในการพยากรณ์เมตริกผลลัพธ์ที่แน่นอน
สำหรับการใช้งานจริง RPMs ใช้พื้นฐานจาก Pre-trained LLMs แบบแช่แข็ง (frozen) ที่ไม่ต้องทำ Fine-tuning โดยมีการเปิดซอร์สโค้ดโครงสร้าง AIRA-dojo และเบนช์มาร์ก AIRS-Bench ให้ใช้งาน ส่วนโมเดลแกนหลักที่ใช้คือ Qwen3.6-27B ซึ่งเป็นโมเดลแบบ Open Weights
ตำแหน่งของ RPM ในวงจรของ agent
AIRA-dojo ทำงานในรูปแบบการค้นหาโครงสร้างต้นไม้เชิงวิวัฒนาการ (Evolutionary tree search) โดยใช้หลักการเลือก Parent แบบ Greedy ร่วมกับตัวดำเนินการ Draft, Improve และ Debug เพื่อคืนค่า Node ที่มีคะแนน Validation สูงสุด RPM จะเข้ามามีบทบาทในขั้นตอน child creation แทนที่ Agent จะรันการทดลองทันทีที่สร้างขึ้น
ระบบจะใช้ตัวดำเนินการสร้างตัวเลือกพร้อมกัน 15 รายการ จากนั้นนำมาเปรียบเทียบทีละคู่แบบน็อคเอาท์เพื่อหาผู้ชนะเพียงหนึ่งเดียวที่จะถูกรันจริง การเปรียบเทียบนี้จะอิงจาก Context nodes ที่รวบรวมผ่านการเดินแบบ BFS ของต้นไม้ที่สำรวจแล้ว ซึ่งแสดงข้อมูลพร้อมคะแนน Validation ที่ได้รับ
สองรูปแบบ สองงบประมาณการคำนวณ
Inference-only RPM: ทำหน้าที่เป็น LLM-as-a-judge เพื่อประเมินแผนงาน โค้ด และประวัติการค้นหา โดยใช้ MIPROv2 จาก DSPy ปรับแต่ง Prompt จนได้เกณฑ์การตัดสินระดับหัวหน้าโครงการวิจัย (Principal Investigator) ที่เน้นความสามารถในการต่อยอดและลงโทษแนวทางที่ซ้ำซ้อน โดยมีความแม่นยำแบบ Offline อยู่ที่ 57.7% ถึง 59.0%
Agentic RPM: ใช้ตัวตัดสินชุดเดียวกันแต่เพิ่มระบบ Sandbox ที่จำลองสภาพแวดล้อมจริงพร้อม GPU H200 โดยใช้เครื่องมืออย่าง python, bash และ submit_solution เพื่อรันการทดลองนำร่องขนาดเล็กก่อนตัดสินใจ เทคนิคสำคัญคือการรายงานงบประมาณเวลาที่เหลือให้สูงกว่าจริง (รายงาน 2,700 วินาที ทั้งที่มีจริง 300 วินาที) เพื่อป้องกัน Agent หยุดทำงานก่อนกำหนด โดยจะรันนำร่องจำกัด 30 ครั้ง ครั้งละไม่เกิน 60 วินาที
ผลลัพธ์บน AIRS-Bench
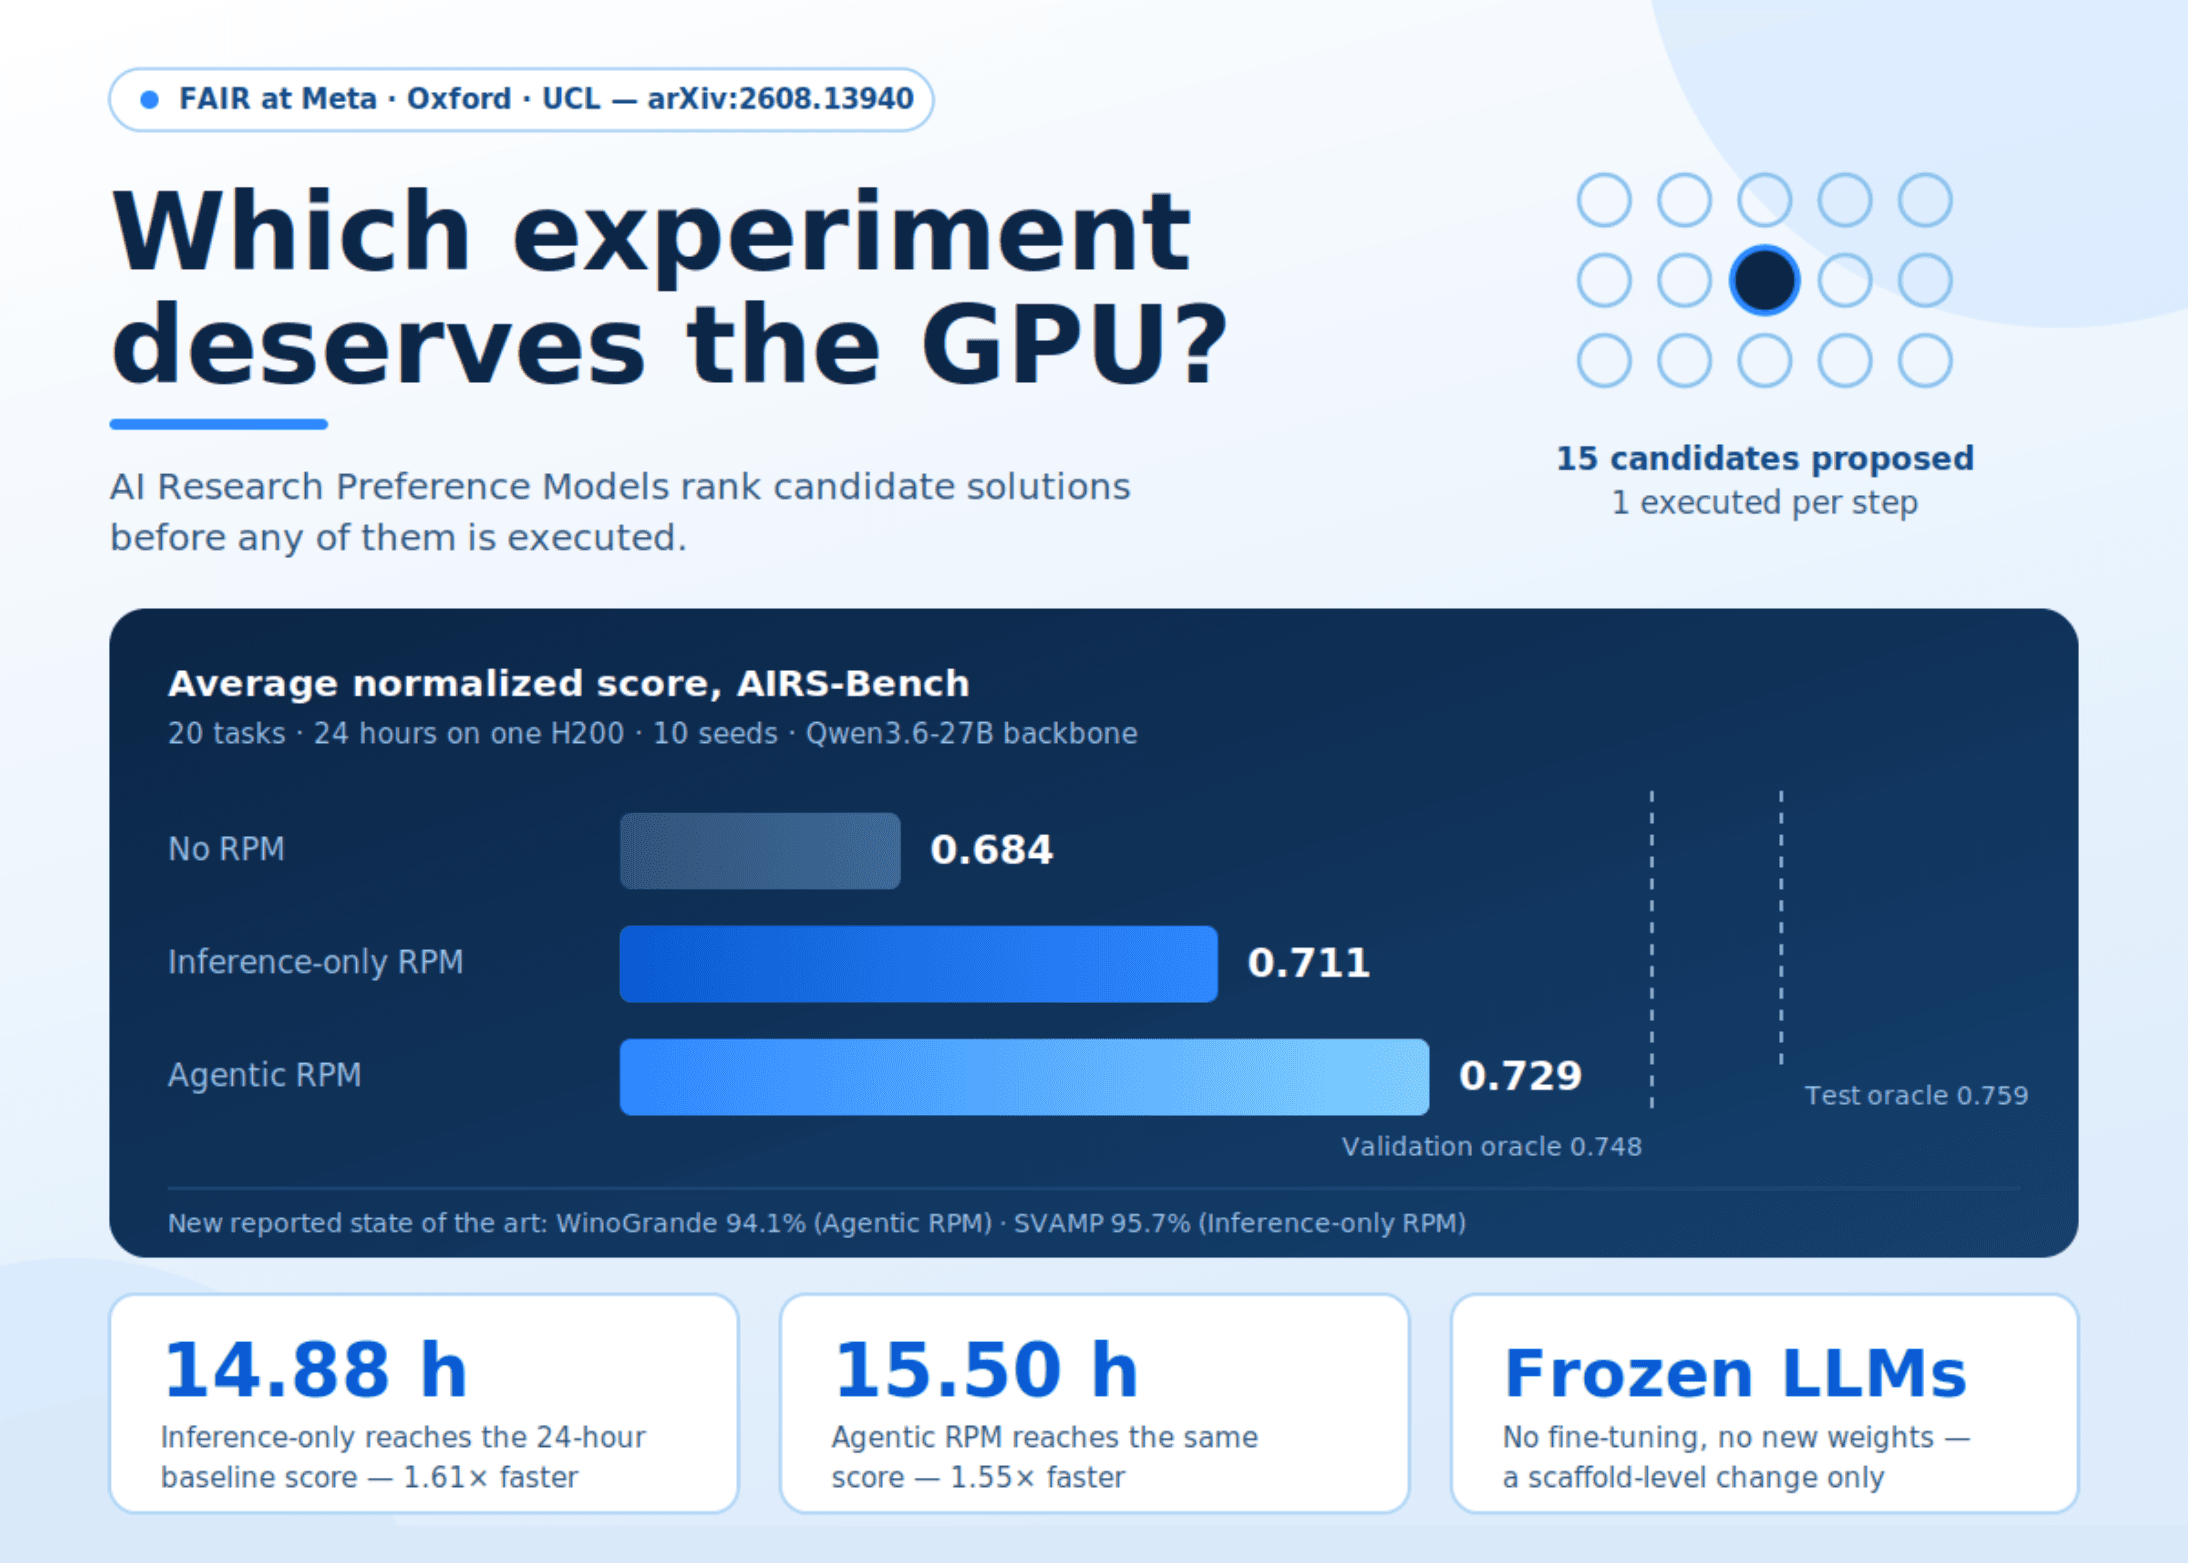
การทดสอบบน AIRS-Bench ครอบคลุม 20 งานวิจัย โดยใช้เวลา 24 ชั่วโมงต่อหนึ่งงานบน GPU H200 ผลการทดสอบพบว่าการใช้ RPM ช่วยยกระดับประสิทธิภาพของโมเดลแกนหลัก Qwen3.6-27B ได้อย่างมีนัยสำคัญ ดังนี้
| Child selection | Avg. normalized score |
|---|---|
| No RPM (สุ่มเลือก) | 0.684 |
| Inference-only RPM | 0.711 |
| Agentic RPM | 0.729 |
| Validation oracle (เพดาน) | 0.748 |
| Test oracle (เพดาน) | 0.759 |
ในแง่ของประสิทธิภาพ RPM สามารถทำคะแนนได้เท่ากับ Baseline (ที่ต้องรัน 24 ชั่วโมง) โดยใช้เวลาเพียง 14.88 ถึง 15.50 ชั่วโมง หรือเร็วกว่าเดิมราว 1.5-1.6 เท่า นอกจากนี้ยังทำลายสถิติ SOTA เดิมในชุดทดสอบ WinoGrande ที่ 94.1% (สูงกว่าเดิมที่ 90.4% จาก AIRA₂) และ SVAMP ที่ 95.7% ซึ่งสูงกว่าสถิติของมนุษย์ที่เคยทำไว้ 94.2%
ประเด็นสำคัญ
- RPMs ช่วยจัดอันดับการทดลองที่ยังไม่ได้รัน เพื่อให้ AI Agent เลือกทำเฉพาะรายการที่มีแนวโน้มดีที่สุด
- มีให้เลือกสองรูปแบบ: Inference-only สำหรับการตัดสินเชิงตรรกะ และ Agentic ที่มีการรันการทดลองนำร่องสั้นๆ
- ผลการทดสอบบน AIRS-Bench แสดงให้เห็นว่าคะแนนเฉลี่ยเพิ่มขึ้นอย่างชัดเจนเมื่อเทียบกับการสุ่มเลือก
- ช่วยประหยัดเวลาการทำงานได้ 1.5–1.6 เท่า โดยให้ผลลัพธ์ใน 15 ชั่วโมงเทียบเท่ากับมาตรฐาน 24 ชั่วโมง
- สร้างสถิติ SOTA ใหม่ในชุดทดสอบ WinoGrande (94.1%) และ SVAMP (95.7%)
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร