
Nous Research เปิดตัวระบบติดตั้งโมเดลโลคอลแบบ 'คลิกเดียว' บน Hermes Desktop
อุปสรรคสำคัญของการใช้งานโมเดลโอเพนซอร์ส (Open-weights model) แบบโลคอลมักไม่ใช่ตัวโมเดลเอง แต่เป็นขั้นตอนที่ซับซ้อนก่อนเริ่มใช้งาน ตั้งแต่การตรวจสอบ VRAM การเลือกค่า Quantization ที่เหมาะสม ไปจนถึงการตั้งค่า Context Length และเลเยอร์บน GPU ซึ่งบ่อยครั้งผู้ใช้มักพบปัญหาไฟล์ใหญ่เกินความจุหน่วยความจำหลังจากดาวน์โหลดเสร็จแล้ว
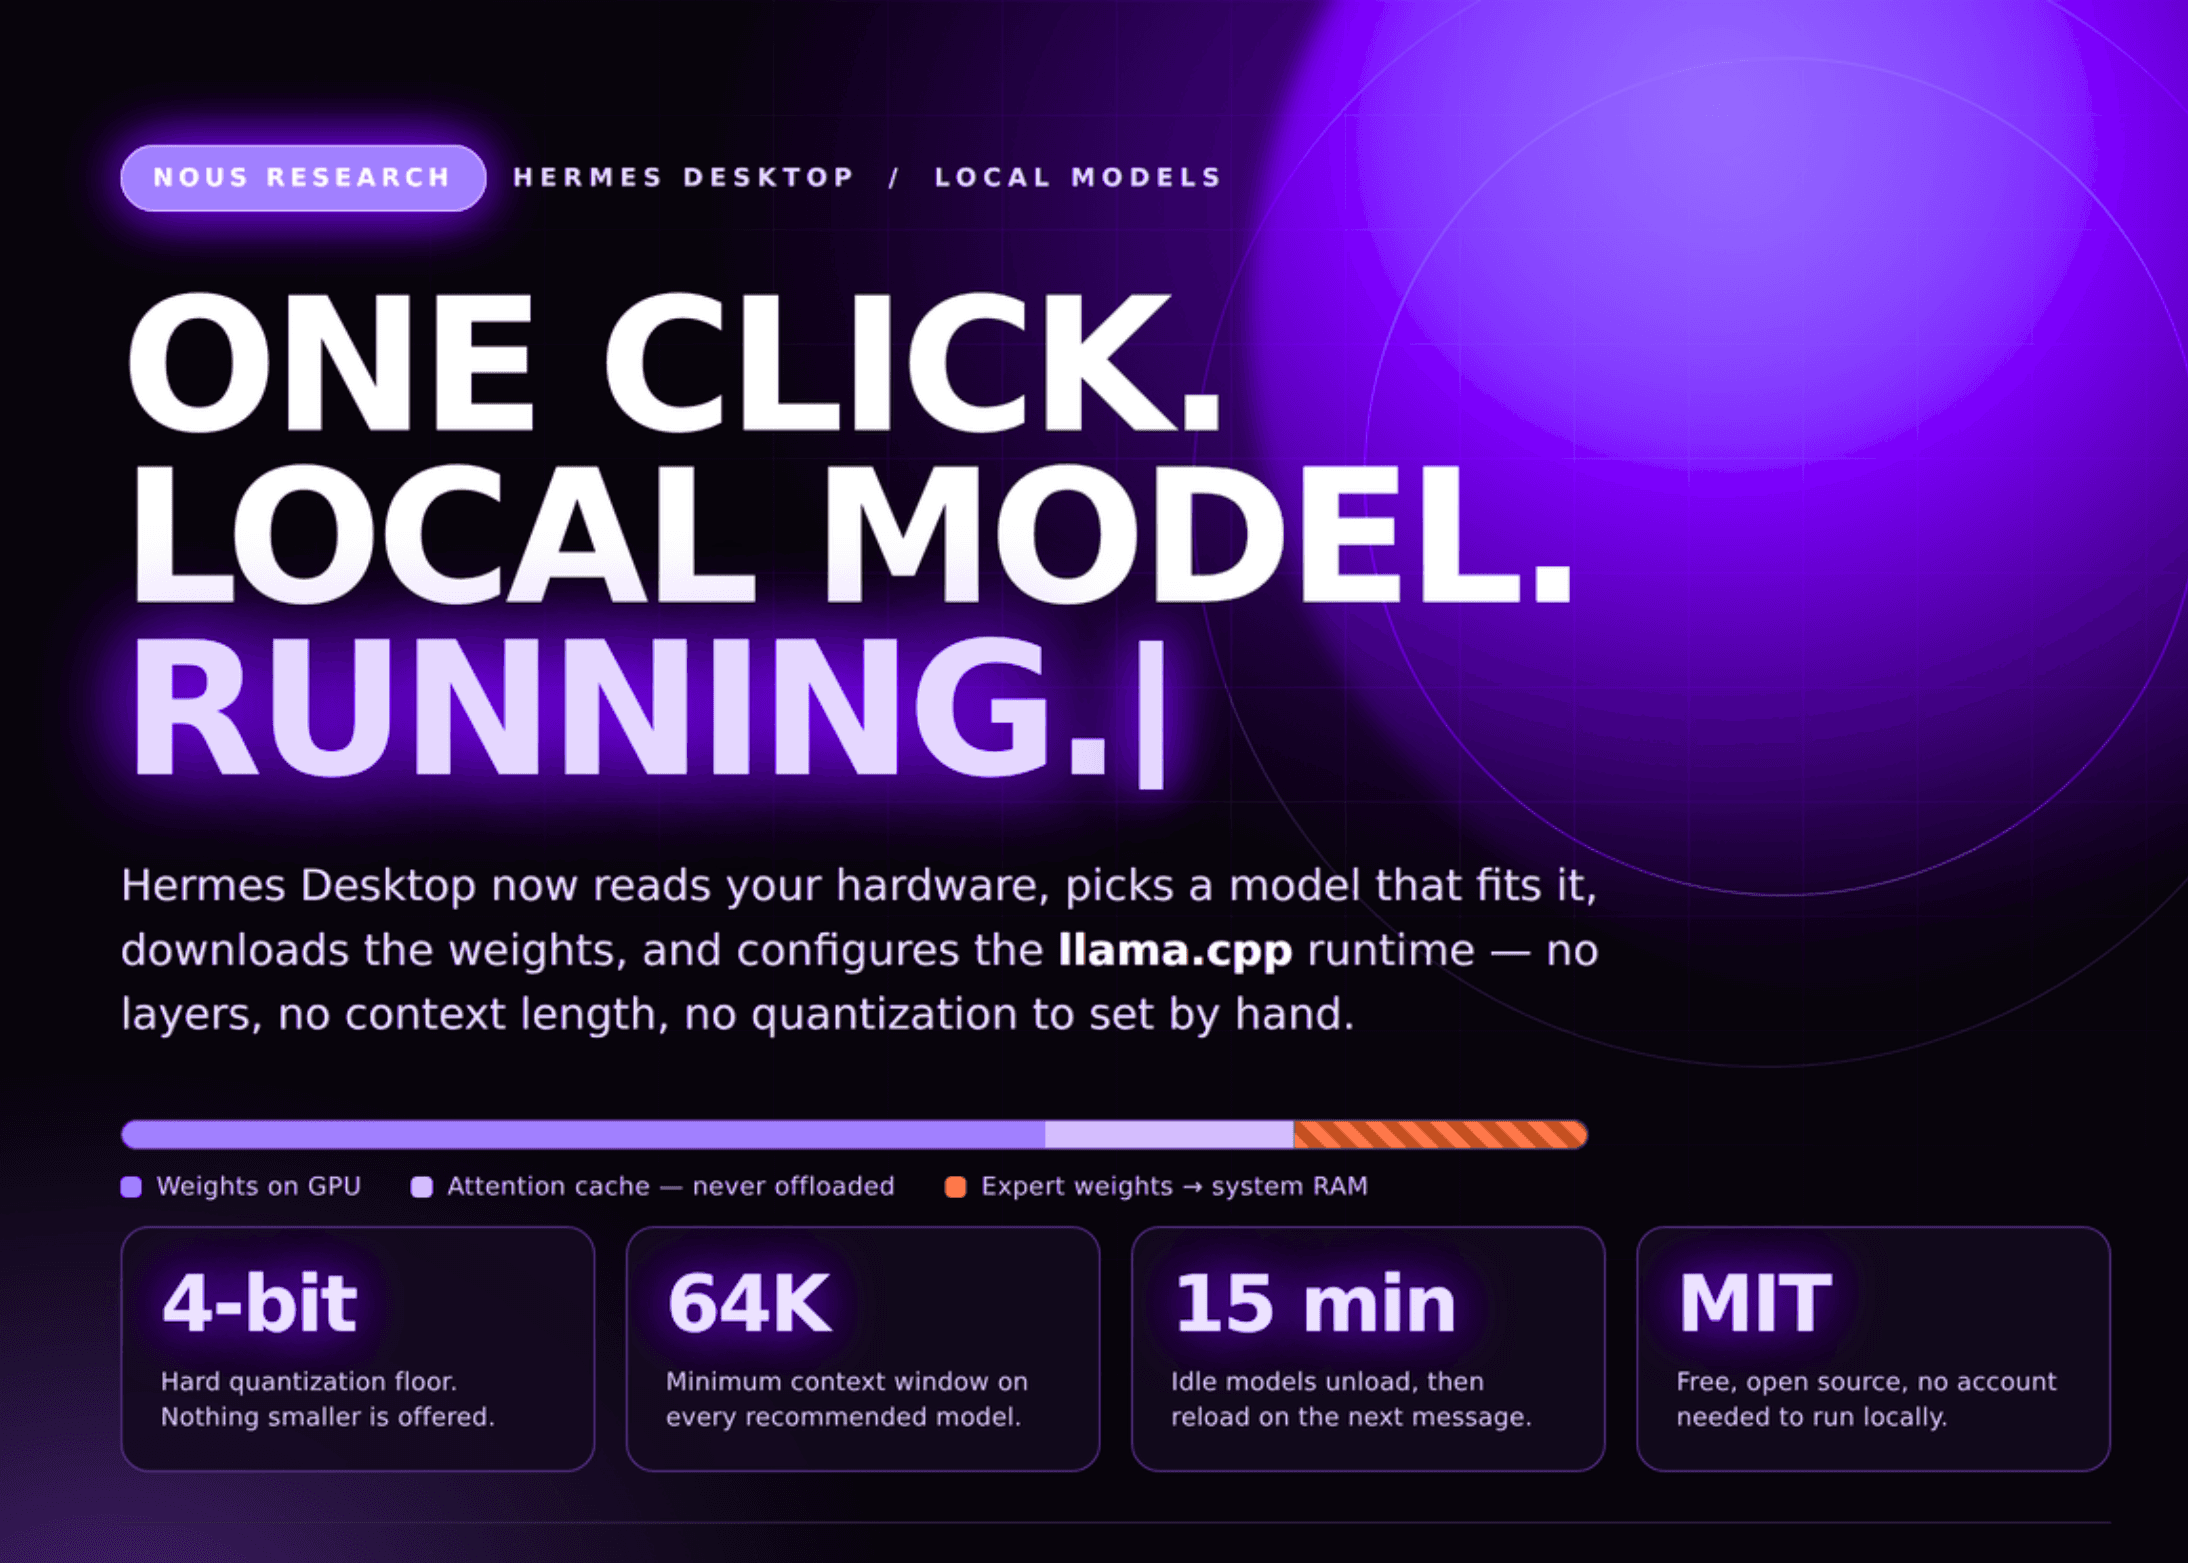
Nous Research จึงได้แก้ปัญหานี้ด้วยการย่อขั้นตอนทั้งหมดให้เหลือเพียงคลิกเดียวภายใน Hermes Desktop โดยระบบใหม่นี้จะทำหน้าที่อ่านข้อมูลฮาร์ดแวร์ เลือกโมเดลที่เหมาะสมที่สุด ดาวน์โหลดค่าน้ำหนัก (Weights) และตั้งค่า Inference Runtime ให้เสร็จสรรพ
Hermes Desktop เปิดให้ใช้งานฟรีภายใต้สัญญาอนุญาตโอเพนซอร์สแบบ MIT โดยรองรับทั้ง macOS 12+, Windows 10/11 และ Linux ทุกเวอร์ชัน ที่สำคัญคือผู้ใช้ไม่จำเป็นต้องสร้างบัญชีเพื่อใช้งานโมเดลแบบโลคอล
รายละเอียดฟีเจอร์ใหม่
การประกาศครั้งนี้มุ่งเน้นความง่ายในการใช้งาน โดยระบบจะเริ่มกระบวนการตั้งค่าอัตโนมัติเมื่อเปิดแอปครั้งแรก หรือสามารถเข้าไปตั้งค่าเองได้ที่ Settings → Providers → Local Models ซึ่งจะครอบคลุมตั้งแต่การตรวจสอบฮาร์ดแวร์ไปจนถึงการกำหนดค่า Runtime
เบื้องหลังความสะดวกนี้ Hermes จะจัดการเอนจิน Inference ด้วยตนเอง อ้างอิงจากเอกสารประกอบ Local Models ระบบจะดึง llama.cpp เวอร์ชันทางการที่ตรงกับฮาร์ดแวร์ของผู้ใช้มาติดตั้ง พร้อมรองรับ Backend ที่หลากหลายทั้ง CUDA, Metal, Vulkan, HIP และ CPU นอกจากนี้ ผู้ใช้ระดับสูงยังสามารถปรับแต่งค่าผ่านไฟล์ config.yaml ในส่วน local_runtime ได้อีกด้วย
ระบบประเมินประสิทธิภาพโมเดลอัจฉริยะ
ก่อนที่จะมีการดาวน์โหลดใดๆ เกิดขึ้น Hermes จะทำการประเมินโมเดลในแคตตาล็อกเทียบกับสเปกเครื่องของคุณ โดยแสดงผลผ่านแถบสีเพื่อให้เข้าใจง่าย ได้แก่ สีเขียว (รันบน GPU ได้ทั้งหมด), สีส้ม (ต้องใช้ RAM ระบบช่วยทำให้ทำงานช้าลง) และสีแดง (ขนาดใหญ่เกินกว่าที่เครื่องจะรับได้) พร้อมแสดงข้อมูลหน้าต่างบริบท (Context Window) และขนาดไฟล์ที่จะดาวน์โหลดจริง
สำหรับการเลือก Quantization นั้น Hermes ใช้เกณฑ์การเลือกเวอร์ชันที่มีคุณภาพสูงสุดที่สามารถรันบน GPU ได้จบในตัว โดยมีเกณฑ์ขั้นต่ำที่ 4-bit หากเครื่องไม่สามารถรันระดับ 4-bit ได้ ระบบจะระบุว่าไม่สามารถรันโมเดลนั้นได้เนื่องจากคุณภาพจะลดลงเกินไป ซึ่งการแสดงผลโมเดลที่ไม่เหมาะสมพร้อมเหตุผลแนบไว้ จะช่วยให้ผู้ใช้เห็นภาพชัดเจนว่าการเพิ่ม VRAM จะช่วยพัฒนาการใช้งานอย่างไรได้บ้าง
การจัดการหน่วยความจำเพื่อประสิทธิภาพสูงสุด เพื่อให้การประมวลผลแบบโลคอลราบรื่นที่สุด Hermes จึงจัดการการวางตำแหน่งหน่วยความจำโดยไม่อาศัยการปรับแต่งจากผู้ใช้ โมเดลจะเริ่มต้นด้วยหน้าต่างบริบทที่พอดีกับ GPU และขยายตัวตามความต้องการของการสนทนา โดยทุกโมเดลที่แนะนำจะได้รับหน้าต่างบริบทขั้นต่ำที่ 64K เสมอ
ในด้านการจัดการทรัพยากร (Offload order) เมื่อหน่วยความจำ GPU เต็ม Hermes จะย้ายส่วนที่เกินไปไว้ที่ RAM ของระบบ โดยเริ่มจาก Expert weights ก่อน และจะเก็บ Attention cache ไว้บน GPU เสมอเพื่อรักษาคุณภาพการสนทนา นอกจากนี้ยังมีระบบนำโมเดลออกจากหน่วยความจำหากไม่ได้ใช้งานเกิน 15 นาที เพื่อคืนทรัพยากรให้ระบบ และจะโหลดใหม่ทันทีเมื่อมีการส่งข้อความ
ประเด็นสำคัญ
- ระบบติดตั้งแบบคลิกเดียวช่วยจัดการทั้งการวิเคราะห์ฮาร์ดแวร์ เลือกโมเดล และตั้งค่า Runtime อัตโนมัติ
- Hermes จัดการ llama.cpp ให้ภายในตัว โดยที่ผู้ใช้ไม่ต้องกังวลเรื่องการตั้งค่าเลเยอร์ GPU หรือค่า Quantization
- มีระบบแถบสี (เขียว, ส้ม, แดง) เพื่อประเมินความเหมาะสมของโมเดลกับเครื่องก่อนดาวน์โหลด
- การันตีหน้าต่างบริบทขั้นต่ำ 64K สำหรับโมเดลที่แนะนำ พร้อมระบบจัดการการถ่ายโอนข้อมูลลง RAM ที่มีประสิทธิภาพ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร