
NVIDIA เปิดตัว BioIR เร่งความเร็วการทำนายโครงสร้างโปรตีน Boltz-2 สูงขึ้น 2.9 เท่าบน GPU H100
การทำนายโครงสร้างชีวโมเลกุลในปัจจุบันได้เปลี่ยนจากการรันเป้าหมายเดี่ยวไปสู่งานระดับโปรตีโอมที่ซับซ้อนขึ้น ซึ่งคอขวดสำคัญไม่ได้อยู่ที่ความสามารถในการ Fold โปรตีนของโมเดล แต่อยู่ที่ความเร็วในการเคลื่อนย้ายข้อมูลผ่านกระบวนการ parsing, featurization, GPU inference และการเขียน output
technical deep dive ใหม่ของ NVIDIA ได้นำเสนอ BioNeMo Inference Runtime (BioIR) ซึ่งเป็นไลบรารี Python ที่ออกแบบมาเพื่อเร่งความเร็วโมเดลการทำนายโครงสร้างบน NVIDIA GPU โดยยังคงรักษา workflow ของ PyTorch มาตรฐานไว้ได้อย่างครบถ้วน
BioIR ได้รับการพิสูจน์ประสิทธิภาพผ่านการใช้งานจริงในระดับการผลิต โดยเป็นขุมพลังสำคัญให้กับการ recent expansion of the AlphaFold Database ที่เพิ่งผ่านมา ซึ่งสามารถสร้างโครงสร้างโปรตีนคอมเพล็กซ์ได้ประมาณ 31 ล้านรายการจาก 4,777 โปรตีโอม โดยมี 1.81 ล้านรายการที่ถูกปล่อยออกมาเป็นการทำนายที่มีความเชื่อมั่นสูง
สำหรับนักพัฒนาและนักวิจัย BioIR พร้อมใช้งานแล้วในรูปแบบ open GitHub repository พร้อมไฟล์ wheel ที่คอมไพล์ CUBINs ไว้ล่วงหน้า การใช้งานต้องการเพียง Python 3.12 ขึ้นไป ร่วมกับ NVIDIA GPU และไดรเวอร์ที่เข้ากันได้ โดยไม่จำเป็นต้องติดตั้ง nvcc, CUDA source, CMake หรือ CUDA toolkit เพิ่มเติม
BioIR คืออะไร
BioIR มุ่งเน้นไปที่การเพิ่มประสิทธิภาพในส่วนที่ stack การอนุมานทั่วไปมักทำได้ไม่เต็มที่ เช่น Pairformer, Evoformer, triangle operations, pairwise attention, diffusion transformers และโมดูลระดับอะตอม โดยตัวโมเดลยังคงสถานะเป็น torch.nn.Module ตามปกติ ไม่จำเป็นต้องสร้าง engine หรือขั้นตอนการส่งออกข้อมูลแยกต่างหาก
ผู้ใช้สามารถเลือกใช้งานได้ 2 วิธี คือแบบตัวประมวลผล end-to-end ที่จัดการตั้งแต่ InputRequest ไปจนถึงการเขียนไฟล์ PDB/mmCIF หรือการรวมเข้ากับ PyTorch โดยตรงเพื่อนำโมดูลที่ปรับแต่งแล้วไปใช้ในโค้ดส่วนตัว ตัวรันไทม์รองรับ Boltz-2 (model_source="boltz-2") และรองรับการทำนายโครงสร้างลิแกนด์ แต่ยังไม่ครอบคลุมการทำนายความสัมพันธ์ของลิแกนด์ (ligand-affinity)
การเร่งความเร็วสามระดับ
BioIR ได้รับการปรับแต่งใน 3 ระดับเพื่อกำจัดคอขวดในจุดต่างๆ ดังนี้:
- Kernel selection: เลือกใช้ custom kernel ของ BioIR, cuEquivariance หรือ PyTorch fallback ให้เหมาะสมกับโมเดลและรูปทรงของ tensor
- Module optimization: ใช้กลไก
optimize()เพื่อจับ CUDA Graph สำหรับโมดูลที่เข้ากันได้ ช่วยลด overhead ในการทำงาน - Pipeline scaling: ใช้ Ray ในการวางโมเดลฉบับเต็มลงบนแต่ละ GPU เพื่อขยายกำลังการผลิต โดยให้ขั้นตอนของ CPU ทำงานขนานไปกับการ Folding บน GPU
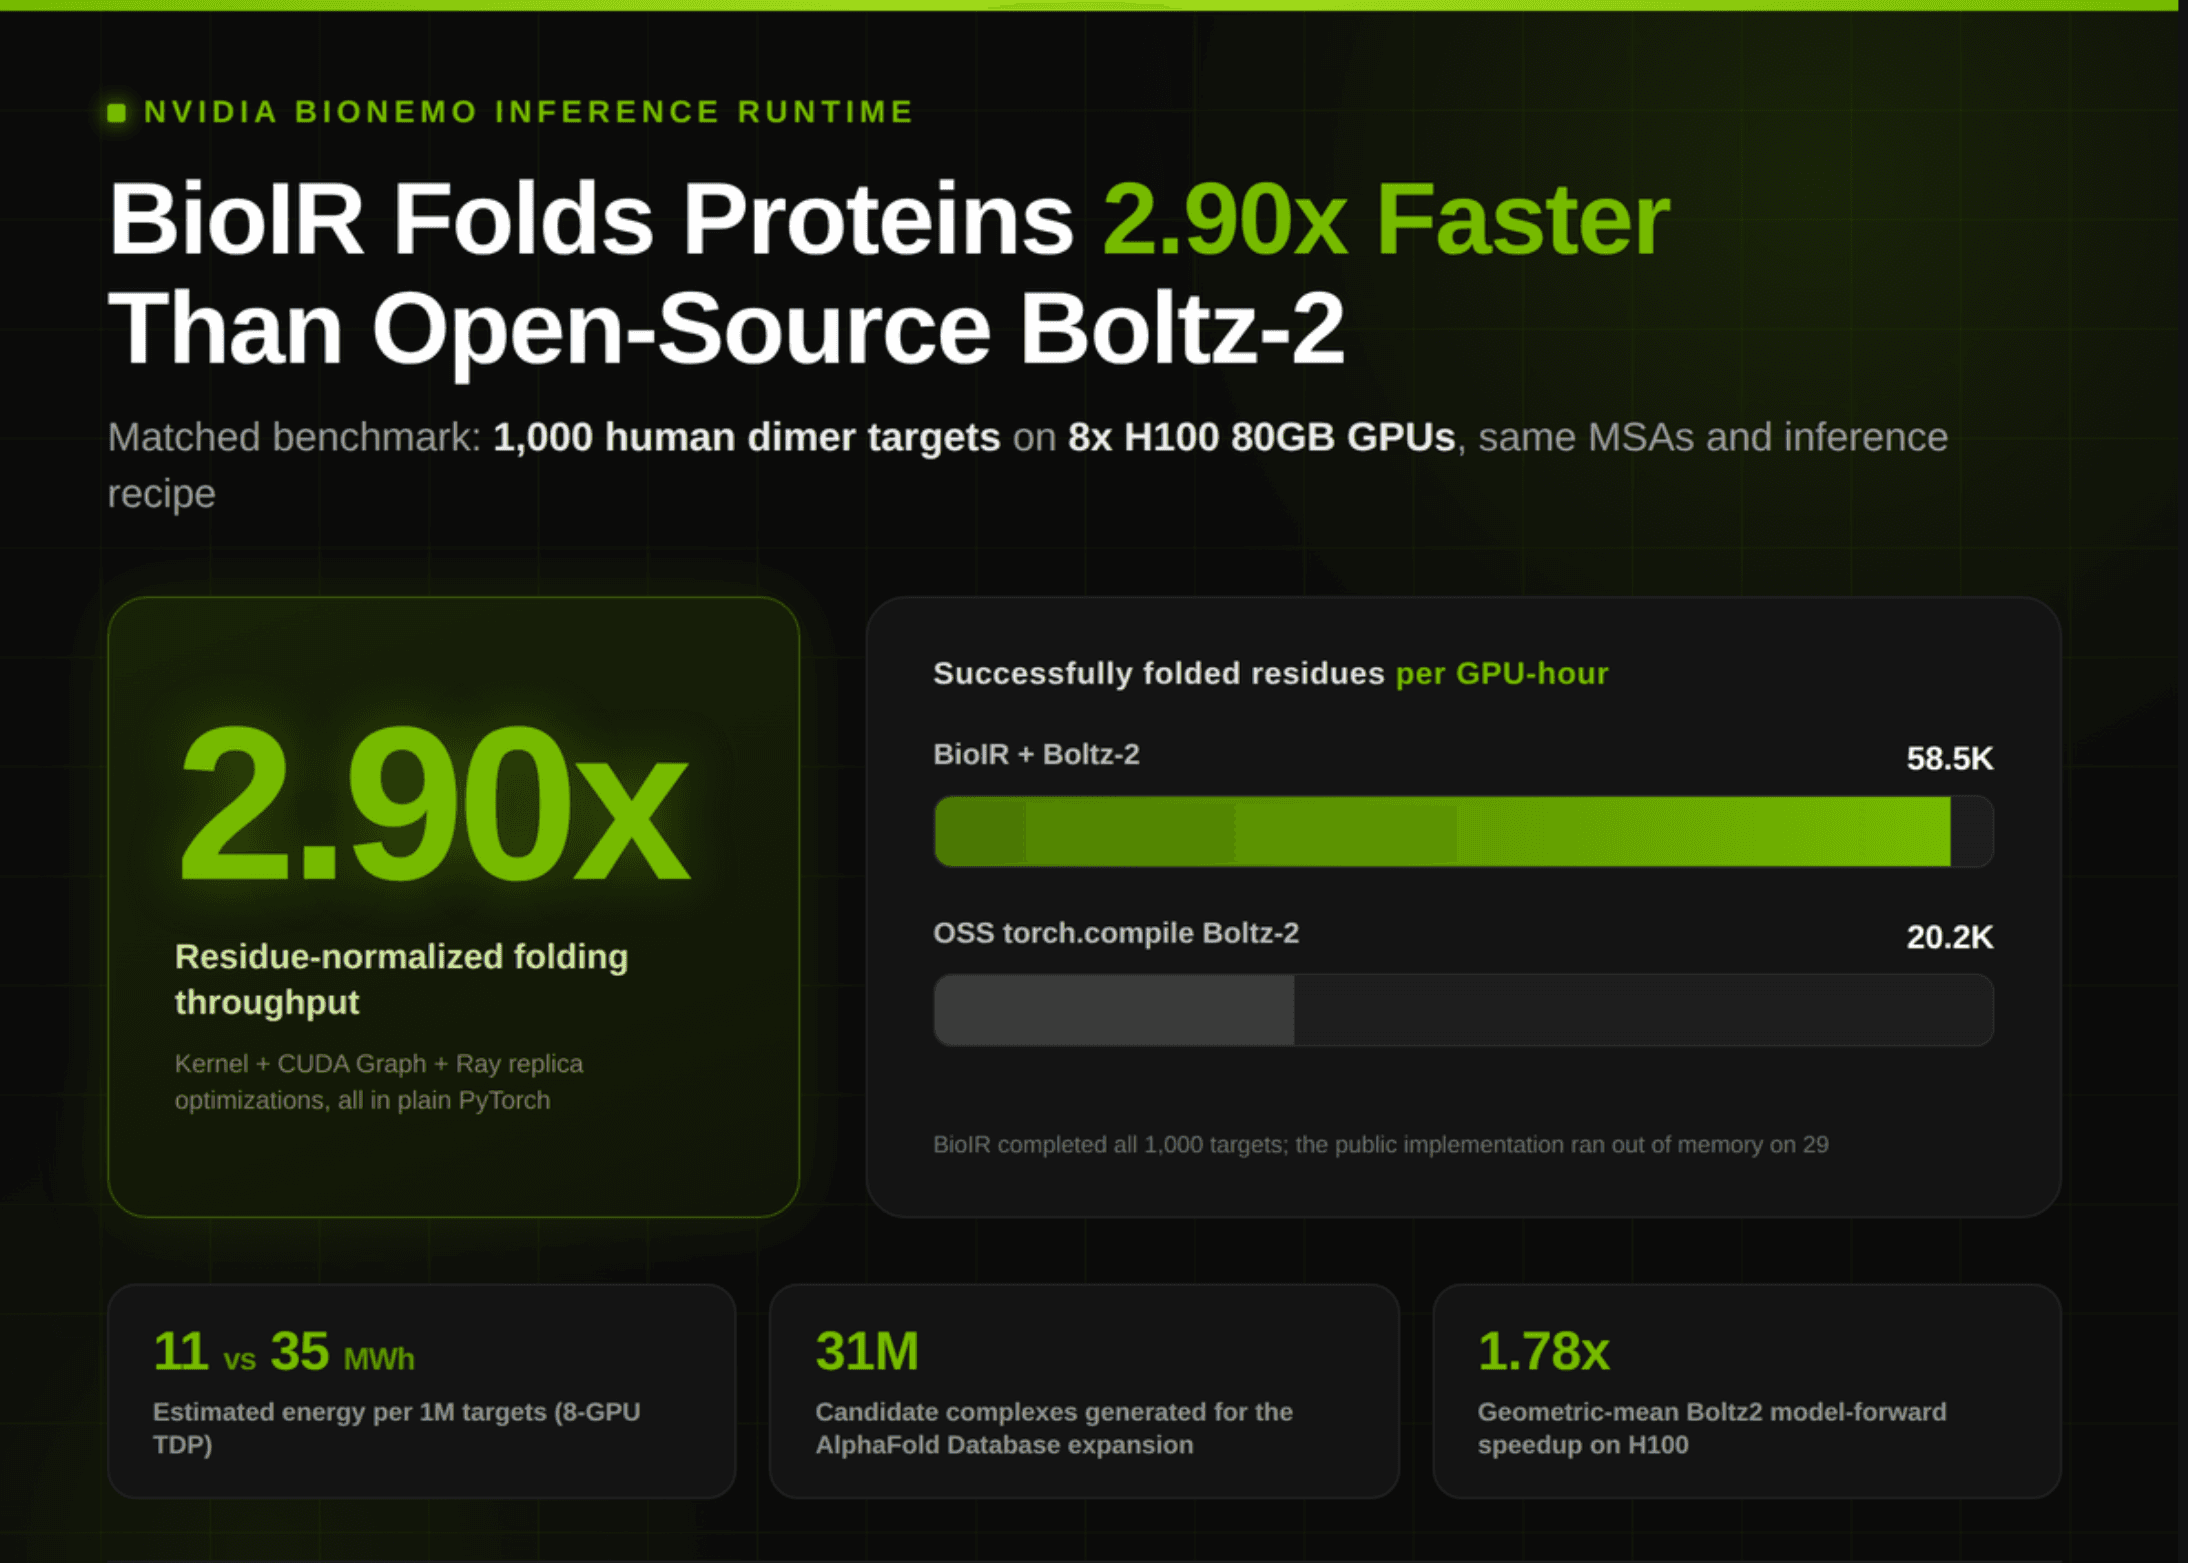
จากการทดสอบเบื้องต้นของ NVIDIA พบว่า BioIR ให้ความเร็วเพิ่มขึ้นแบบค่าเฉลี่ยเรขาคณิตเมื่อเทียบกับ torch.compile ของมาตรฐาน Open-source โดยเพิ่มขึ้น 1.55 เท่าใน OpenFold3, 1.78 เท่าใน Boltz2 และสูงสุด 2.56 เท่าใน OpenFold2 monomer บนหน่วยประมวลผล H100
การทดสอบ: Human Dimers 1,000 รายการบน 8xH100
ทีม NVIDIA ได้ทำการวัดผลการส่งมอบแบบ end-to-end บนเป้าหมาย human dimer 1,000 รายการ โดยเปรียบเทียบ Boltz-2 ที่เร่งด้วย BioIR กับเวอร์ชัน open-source ปกติบนระบบ 8xH100 80GB GPU ผลลัพธ์ที่ได้มีความน่าสนใจอย่างมาก
BioIR สามารถส่งมอบผลลัพธ์ได้ถึง 58.5K residue ที่ fold สำเร็จต่อ GPU-hour ในขณะที่การใช้งานแบบทั่วไปทำได้เพียง 20.2K residue และยังประสบปัญหาหน่วยความจำเต็มในบางเป้าหมาย ส่งผลให้ BioIR มี throughput ที่ดีกว่าถึง 2.90 เท่า อย่างไรก็ตาม ตัวเลขนี้เป็นการวัดเฉพาะขั้นตอน Folding เท่านั้น ไม่รวมขั้นตอนการเตรียมข้อมูลอื่นๆ
พลังงานต่อหนึ่งล้านเป้าหมาย
เมื่อประมาณการไปที่เป้าหมาย 1 ล้านรายการ BioIR คาดว่าจะใช้พลังงานเพียง 11 MWh เทียบกับ 35 MWh ของการใช้งานแบบปกติ การประหยัดพลังงานได้ถึง 23-43 MWh ต่อล้านเป้าหมายถือเป็นความก้าวหน้าที่มีนัยสำคัญมากสำหรับโครงการวิจัยขนาดใหญ่ในระดับโปรตีโอม ช่วยลดทั้งต้นทุนและผลกระทบต่อสิ่งแวดล้อม
สรุปประเด็นสำคัญ
- BioIR เร่งความเร็วการอนุมาน Boltz-2, OpenFold2 และ OpenFold3 โดยยังคงรูปแบบ PyTorch เดิม
- เพิ่ม Throughput ได้สูงสุด 2.90 เท่า บนระบบ 8xH100 (58.5K vs 20.2K residues/GPU-hour)
- ระบบ Ray replica ช่วยขยายปริมาณงานได้อย่างมีประสิทธิภาพแม้จะไม่แบ่งงานเดี่ยวข้าม GPU
- ลดการใช้พลังงานได้มหาศาลในการทำงานระดับสเกลล้านเป้าหมาย
- ผ่านการใช้งานจริงในการสร้างคอมเพล็กซ์ต้นแบบ 31 ล้านรายการให้ AlphaFold Database
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร