
เจาะลึกความปลอดภัย AI Agent: ความท้าทายและแนวทางเชิงบริบท
เรากำลังเปลี่ยนผ่านเข้าสู่ยุคการประมวลผลที่ขับเคลื่อนด้วย autonomous agents ซึ่งมีความสามารถทั่วไปสูงและทำงานได้เป็นอิสระมากขึ้น ระบบเหล่านี้ทำงานผ่านโมเดลภาษาขนาดใหญ่ (LLMs) ที่สร้างแผนการทำงานแบบไดนามิกและเรียกใช้เครื่องมือภายนอกได้ ช่วยให้ AI จัดการงานซับซ้อนหลายขั้นตอนแทนมนุษย์ได้อย่างราบรื่น อย่างไรก็ตาม การจะไปถึงจุดนั้นจำเป็นต้องแก้โจทย์สำคัญ คือการเพิ่มขีดความสามารถของเอเจนท์ควบคู่ไปกับการรับประกันความปลอดภัย
ล่าสุดเราได้เผยแพร่รายงานจากการประชุมเชิงปฏิบัติการฉบับใหม่ในหัวข้อ "Open and Emergent Problems in Agentic Privacy and Security: A Contextual Angle" ซึ่งเป็นความร่วมมือของผู้นำภาควิชาการและอุตสาหกรรมกว่า 50 ท่านจาก Google Contextual Agent Privacy and Security (CAPS) Workshop ณ นิวยอร์กซิตี้ เมื่อปลายปี 2025 โดยรายงานฉบับนี้ได้จำแนกความท้าทายด้านความเป็นส่วนตัวและความปลอดภัยที่เอเจนท์เผชิญ ซึ่งต้องอาศัยการป้องกันที่ประสานกันทั้งในระดับระบบ โมเดล ผู้ใช้ และระบบนิเวศ
Agentic trade-offs
ความท้าทายหลักของ AI แบบเอเจนท์ (agentic AI) คือการที่เอเจนท์จำเป็นต้องเข้าถึงข้อมูลส่วนบุคคลและมีอำนาจดำเนินการในบริบทที่หลากหลายเพื่อให้เกิดประโยชน์สูงสุด แต่การเข้าถึงข้อมูลและความยืดหยุ่นนี้กลับต้องการแนวทางความปลอดภัยที่ต่างจากซอฟต์แวร์แบบเดิมอย่างสิ้นเชิง เนื่องจากเอเจนท์มีความแตกต่างจากซอฟต์แวร์ทั่วไปใน 3 มิติสำคัญ ดังนี้:
- อินเทอร์เฟซที่ไม่มีโครงสร้างและความคลุมเครือของอินพุต (Unstructured interfaces and input ambiguity): เอเจนท์รับคำสั่งผ่านภาษาธรรมชาติหรือรูปภาพ ทำให้ยากต่อการกำหนดขอบเขตพฤติกรรมที่เหมาะสม และเสี่ยงต่อการถูกโจมตี เช่น prompt injection
- ผังการควบคุมแบบความน่าจะเป็น (Probabilistic control flows): การวางแผนงานแบบ Generative นำไปสู่เส้นทางการทำงานที่คาดเดาได้ยาก ซึ่งวิธีการทดสอบความปลอดภัยแบบดั้งเดิมไม่สามารถรับรองได้โดยง่าย
- ความเป็นอิสระและการมอบหมายงาน (Autonomy and delegation): เมื่อเอเจนท์ต้องจัดการงานระยะยาวและมอบหมายงานย่อยให้เอเจนท์ตัวอื่น การกำกับดูแลโดยผู้ใช้อาจไม่เพียงพอและนำไปสู่ "ความล้าจากการยืนยัน" (confirmation fatigue)
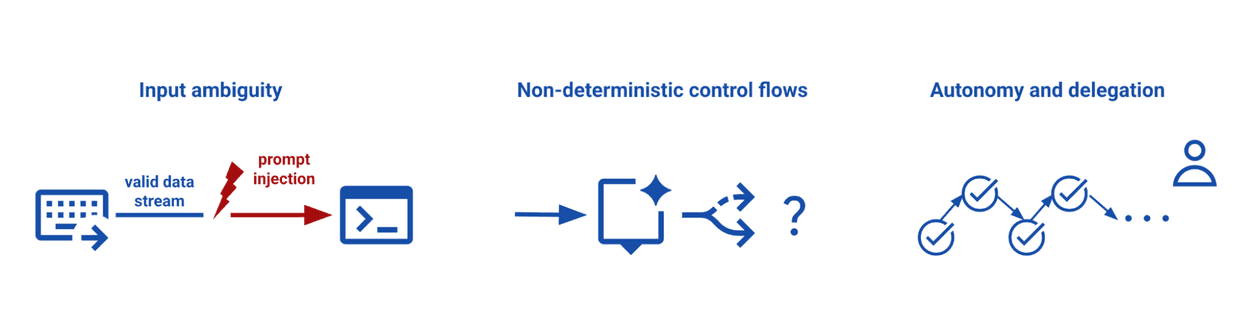
ความท้าทายด้านความเป็นส่วนตัวและความปลอดภัยของ AI แบบเอเจนท์
The contextual lens
เราเชื่อว่าอนาคตของเอเจนท์ที่น่าเชื่อถือขึ้นอยู่กับความสามารถในการใช้เหตุผลและทำความเข้าใจภายใต้บรรทัดฐานทางสังคม รวมถึงความเหมาะสมของการกระทำในแต่ละ "บริบทเฉพาะ" ที่ทำงานอยู่
รายงานของเรายึดตามทฤษฎี Contextual Integrity (CI) ซึ่งนิยามความเป็นส่วนตัวว่าคือ "การไหลเวียนของข้อมูลที่เหมาะสม" ตามบรรทัดฐานสังคม โดยประกอบด้วยปัจจัยด้าน ผู้มีส่วนเกี่ยวข้อง, ประเภทของข้อมูล และ หลักการส่งต่อข้อมูล เช่น คุณอาจยอมรับได้ที่จะแชร์รายการของขวัญกับเอเจนท์ช้อปปิ้ง แต่ไม่อยากแชร์ให้คนในครอบครัวรู้ รายงานนี้จึงขยายขอบเขตจากความเป็นส่วนตัวไปสู่ "ความปลอดภัยเชิงบริบท" (contextual security) เพื่อประเมินความเหมาะสมของการกระทำก่อนที่เอเจนท์จะลงมือจริง
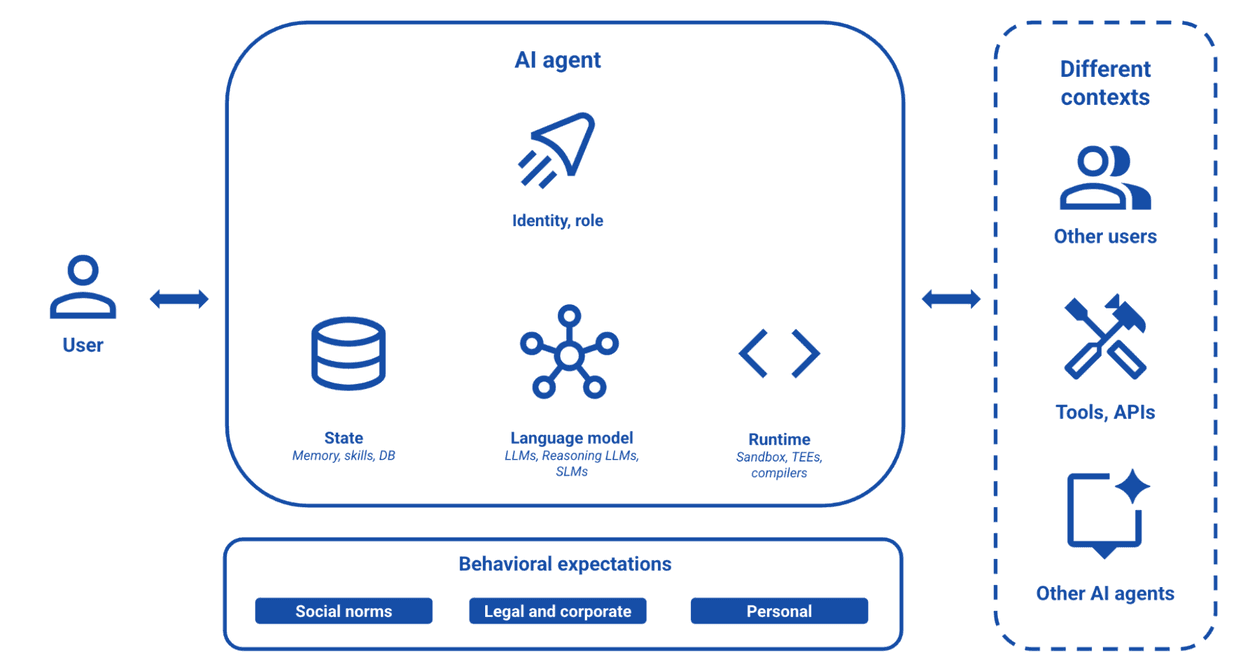
แบบจำลองของ AI agent ทั่วไปที่โต้ตอบกับผู้ใช้ เครื่องมือ และเอเจนท์รายอื่นในบริบทต่างๆ
Operationalizing Contextual Integrity
เป็นครั้งแรกที่ LLMs ช่วยให้เราสร้างนโยบายที่เครื่องอ่านได้โดยอิงตามบริบทจริง ในอดีตมักมีช่องว่างระหว่างนโยบายระดับสูงกับสิทธิ์ของระบบระดับต่ำ เช่น คำสั่ง "ปกป้องข้อมูลของฉันระหว่างจัดทริปประชุม" ซึ่งต้องการการตัดสินใจที่ละเอียดอ่อนว่าข้อมูลส่วนใดควรแชร์กับสายการบินหรือผู้จัดงาน
รายงานของเราสนับสนุนการใช้ "เครื่องมือนโยบายเชิงบริบท" (contextual policy engine) ในเลเยอร์ผู้ควบคุม (supervisor layer) เพื่อตรวจสอบการกระทำแบบเรียลไทม์ เครื่องมือนี้จะปรับแต่งนโยบายตามคำขอของผู้ใช้และบริบทที่เปลี่ยนแปลงตลอดเวลา ช่วยให้ระบบประเมินความเหมาะสมของการไหลเวียนข้อมูลได้ก่อนที่ข้อมูลจะออกจากพื้นที่ส่วนตัวของผู้ใช้
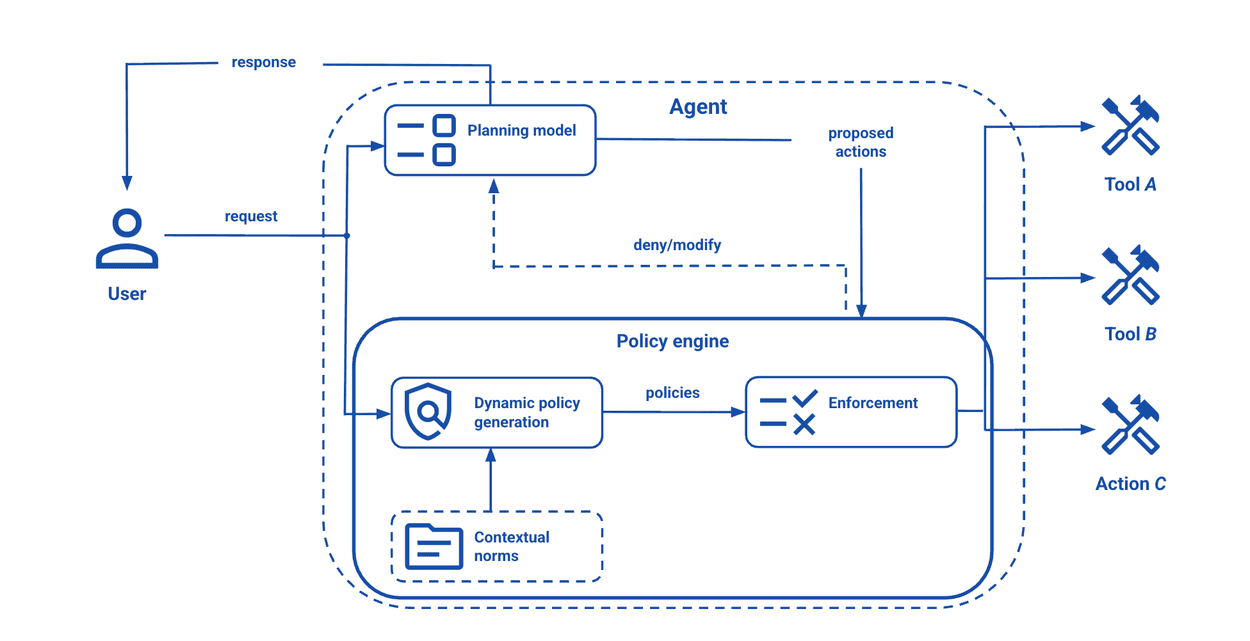
ตัวอย่างประกอบแสดงให้เห็นว่าสถาปัตยกรรมเครื่องมือนโยบายเชิงบริบทสามารถนำมาใช้ภายในระบบเอเจนท์ได้อย่างไร
Multi-layered approach to agentic privacy and security
เรานำเสนอแนวทางป้องกันแบบหลายเลเยอร์ที่ครอบคลุมนวัตกรรมในทุกระดับ:
- การสร้าง Sandbox ในระดับระบบ (System-level sandboxing): จำกัดขอบเขตการทำงานของเอเจนท์เพื่อลดผลกระทบหากเกิดความผิดพลาด โดยใช้การจำกัดความสามารถแบบไดนามิกตามการเปลี่ยนแปลงของบริบท
- การใช้เหตุผลในระดับโมเดล (Model-level reasoning): พัฒนาให้โมเดลสามารถวิเคราะห์ความคลุมเครือของคำสั่งและตัดสินความเหมาะสมภายใต้บรรทัดฐานที่แตกต่างกันได้
- การควบคุมที่เน้นผู้ใช้เป็นศูนย์กลาง (User-centric controls): เปลี่ยนจากหน้าจอคำยืนยันแบบเดิม ไปสู่กลไกการควบคุมแบบไดนามิกที่สอดคล้องกับโมเดลความคิดของผู้ใช้ (mental models)
- การปฏิสัมพันธ์ระหว่างหลายเอเจนท์ (Multi-agent interactions): พัฒนาเกราะป้องกันเพื่อไม่ให้เอเจนท์หลายตัวสมรู้ร่วมคิดกันละเมิดบรรทัดฐานเชิงบริบท
- ธรรมาภิบาลของระบบนิเวศ (Ecosystem governance): สร้างกลไกแบ่งปันบรรทัดฐานระหว่างเอเจนท์และแก้ไขข้อขัดแย้งของนโยบายในแต่ละองค์กร
Measuring privacy and security dynamically
เราเสนอการพัฒนาเกณฑ์มาตรฐานสำหรับหลายเอเจนท์ (multi-agent benchmarks) ในรูปแบบสภาพแวดล้อม "Agent Gym" แบบไดนามิก เพื่อให้นักวิจัยจำลองการปฏิสัมพันธ์ที่ซับซ้อนและส่งผลกระทบต่อเนื่องได้อย่างปลอดภัย ซึ่งจะเป็นรากฐานสำคัญด้านความปลอดภัยให้แก่ภาควิชาการและอุตสาหกรรม
A call to action
การสร้างระบบนิเวศเอเจนท์ที่น่าเชื่อถือเป็นงานใหญ่ที่เกินกว่าองค์กรใดจะทำลำพัง รายงานฉบับนี้จึงเป็นคำร้องขอให้ชุมชนการวิจัย ทั้งภาครัฐ ภาคเอกชน และประชาสังคม ร่วมกันพัฒนารากฐานเชิงบริบทเพื่อความปลอดภัยที่ยั่งยืน โดยผู้ที่สนใจสามารถอ่านรายละเอียดได้ใน technical report
Acknowledgements
ขอขอบคุณ Lillian Tsai ผู้เขียนหลักร่วม และ Sarah de Haas สำหรับการประสานงาน รวมถึงคณะผู้จัดทำและที่ปรึกษาจากหลายสถาบันที่ช่วยขับเคลื่อนรายงานฉบับนี้ งานนี้ได้รับการสนับสนุนจากผู้นำและนักวิจัยกว่า 50 ท่าน เพื่อเป้าหมายในการสร้างมาตรฐานใหม่ให้กับความปลอดภัยของ AI
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร