
OpenBMB เปิดตัว MiniCPM5-2B โมเดลจิ๋วประสิทธิภาพสูง ทุบสถิติ Qwen3.5-4B ในขนาดที่เล็กกว่า
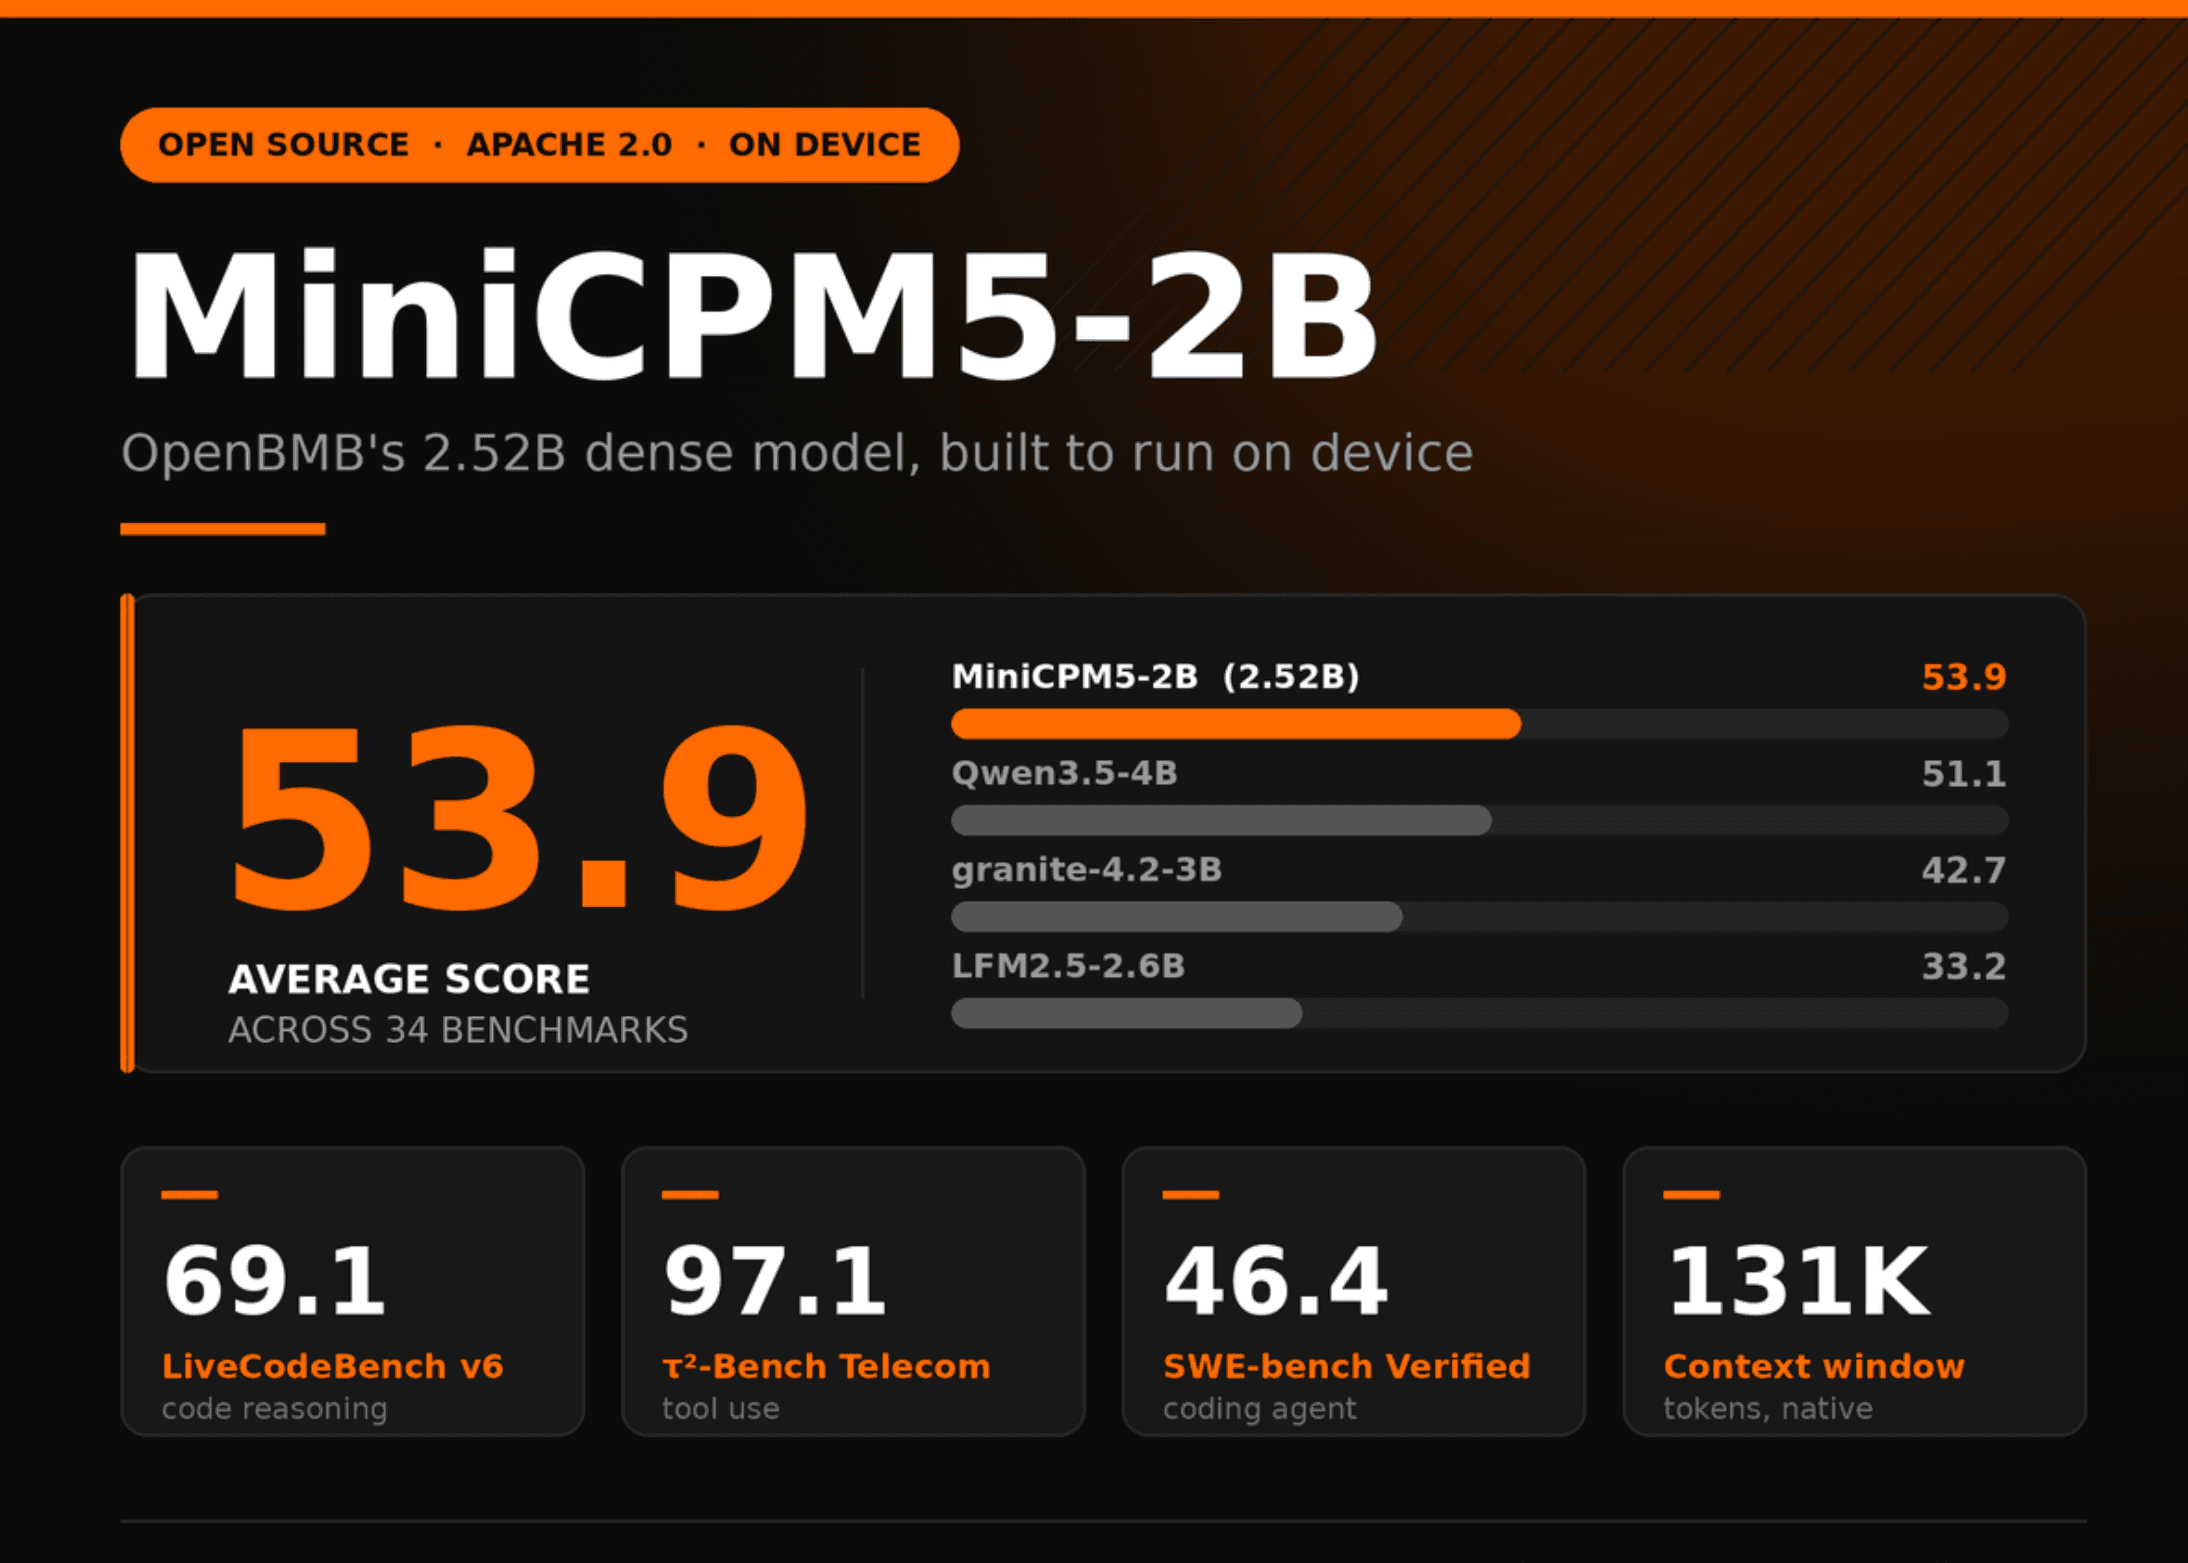
OpenBMB ได้ประกาศเปิดตัว MiniCPM5-2B ซึ่งเป็นโมเดลลำดับที่สองในซีรีส์ MiniCPM5 ต่อจาก MiniCPM5-1B โดยเป็นโมเดลภาษาแบบ dense causal ที่มีพารามิเตอร์รวม 2,516,756,480 ตัว (โดยมี 1,981,982,720 ตัวอยู่นอก embeddings) มาพร้อมกับ 42 เลเยอร์ และระบบ grouped-query attention ที่มี 16 query heads และ 2 key/value heads รองรับ context window พื้นฐานสูงถึง 131,072 tokens
โมเดลนี้ใช้สถาปัตยกรรมมาตรฐาน LlamaForCausalLM ทำให้เอนจินประมวลผลกระแสหลักสามารถโหลดใช้งานได้ทันทีโดยไม่ต้องพึ่งพา custom kernels หรือแยก code fork ใหม่ ส่งผลให้นำไปใช้งานจริงได้สะดวกผ่านแพลตฟอร์มอย่าง vLLM, SGLang, Transformers, llama.cpp, Ollama, LM Studio, MLX และ FlagOS ภายใต้สัญญาอนุญาตแบบ Apache 2.0
สิ่งที่ตาราง Benchmark แสดงให้เห็นจริงๆ
จากการทดสอบผ่าน 34 benchmarks พบว่า MiniCPM5-2B ทำคะแนนเฉลี่ยได้ 53.9 ซึ่งสูงกว่าคู่แข่งในระดับเดียวกันและรุ่นที่ใหญ่กว่าอย่าง Qwen3.5-4B ที่ทำได้ 51.1 โดยจุดเด่นที่สุดคือการใช้เหตุผลด้านโค้ด (code reasoning) ซึ่งทำคะแนนได้ 69.1 ใน LiveCodeBench v6 และ 46.4 ใน SWE-bench Verified เหนือกว่าคู่แข่งอย่างเห็นได้ชัด
ในด้านการใช้งานเครื่องมือ (Tool use) ถือเป็นจุดแข็งที่สุดของโมเดลนี้ โดยทำคะแนนได้ 97.1 ใน τ²-Bench Telecom และ 66.6 ใน BFCL v4 อย่างไรก็ตาม ในด้านความรู้ทั่วไปพบว่ายังมีข้อจำกัดตามขนาดของโมเดล โดยทำคะแนน MMLU-Pro ได้ 70.8 ซึ่งยังตามหลังโมเดลขนาดใหญ่กว่าบางตัวในตลาด
สูตรการฝึกฝน: SFT, ตามด้วย RL, แล้วต่อด้วย on-policy distillation
กระบวนการฝึกฝนใช้แนวทาง UltraData ตามที่ระบุใน งานวิจัยต้นฉบับ เริ่มจากการฝึกแบบ Base training ตามด้วยการปรับจูน (mid-training) และเข้าสู่ช่วง post-training ที่ใช้ SFT แบบ deep-thinking ถึง 400B tokens จากนั้นจึงฝึกฝนด้วย RL teachers ที่เชี่ยวชาญเฉพาะด้านผ่านอัลกอริทึม JustRL II
ขั้นตอนสุดท้ายคือ on-policy distillation (OPD) ที่รวมโมเดลผู้เชี่ยวชาญด้าน RL ถึง 16 ตัวเข้าเป็นหนึ่งเดียว โดยใช้การคำนวณ reverse KL divergence เพื่อส่งต่อความสามารถจากโมเดลครูสู่โมเดลนักเรียน วิธีการนี้ช่วยให้คะแนนเฉลี่ยด้านการใช้เหตุผลเพิ่มขึ้น 10.96 จุด และด้านความสามารถแบบ agentic เพิ่มขึ้น 6.96 จุด
ข้อมูลก็เป็นแบบเปิดเช่นกัน
OpenBMB ไม่ได้ปล่อยเพียงแค่น้ำหนักโมเดล แต่ยังแจกจ่ายชุดข้อมูลจำนวนมหาศาล เช่น Ultra-FineWeb, UltraX, UltraData-Code, UltraData-SFT-Agent-2609 และ UltraData-RL-2609 รวมถึง checkpoint ระหว่างทาง เพื่อให้ชุมชนนักพัฒนาสามารถตรวจสอบและวัดผลในแต่ละขั้นตอนได้อย่างโปร่งใส
สรุป
MiniCPM5-2B คือตัวเลือกที่ยอดเยี่ยมสำหรับการใช้งานบนอุปกรณ์ (On-device) โดยเฉพาะงานที่ต้องการความฉลาดด้าน agentic และการเรียกใช้เครื่องมือ แม้จะยังตามหลังโมเดลขนาดใหญ่ในด้านความรู้ทั่วไป แต่ประสิทธิภาพในด้านการเขียนโค้ดและการประมวลผลบริบทที่ยาวแบบ NoLiMa ทำให้มันเป็นโมเดลขนาดเล็กที่น่าจับตามองอย่างยิ่ง
ประเด็นสำคัญ
- โมเดลแบบ dense ขนาด 2.52B, context window 131,072 token สัญญาอนุญาต Apache 2.0 สถาปัตยกรรม Llama
- คะแนนเฉลี่ย 53.9 จาก 34 benchmarks ชนะ Qwen3.5-4B
- โดดเด่นด้าน Tool use และ Coding agents แต่มีข้อจำกัดด้านความรู้ทั่วไป
- ใช้เทคนิคการฝึกแบบ SFT 400B tokens ควบคู่กับ RL teachers และ on-policy distillation
- ปล่อยชุดข้อมูล Pre-training, SFT และ RL ออกสู่สาธารณะพร้อมตัวโมเดล
ตรวจสอบได้ที่ ** HF**,
และ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร