
Perplexity เปิดโอเพนซอร์ส Lily: Inference Engine ประสิทธิภาพสูงด้วย Rust + Metal สำหรับชิป Apple Silicon
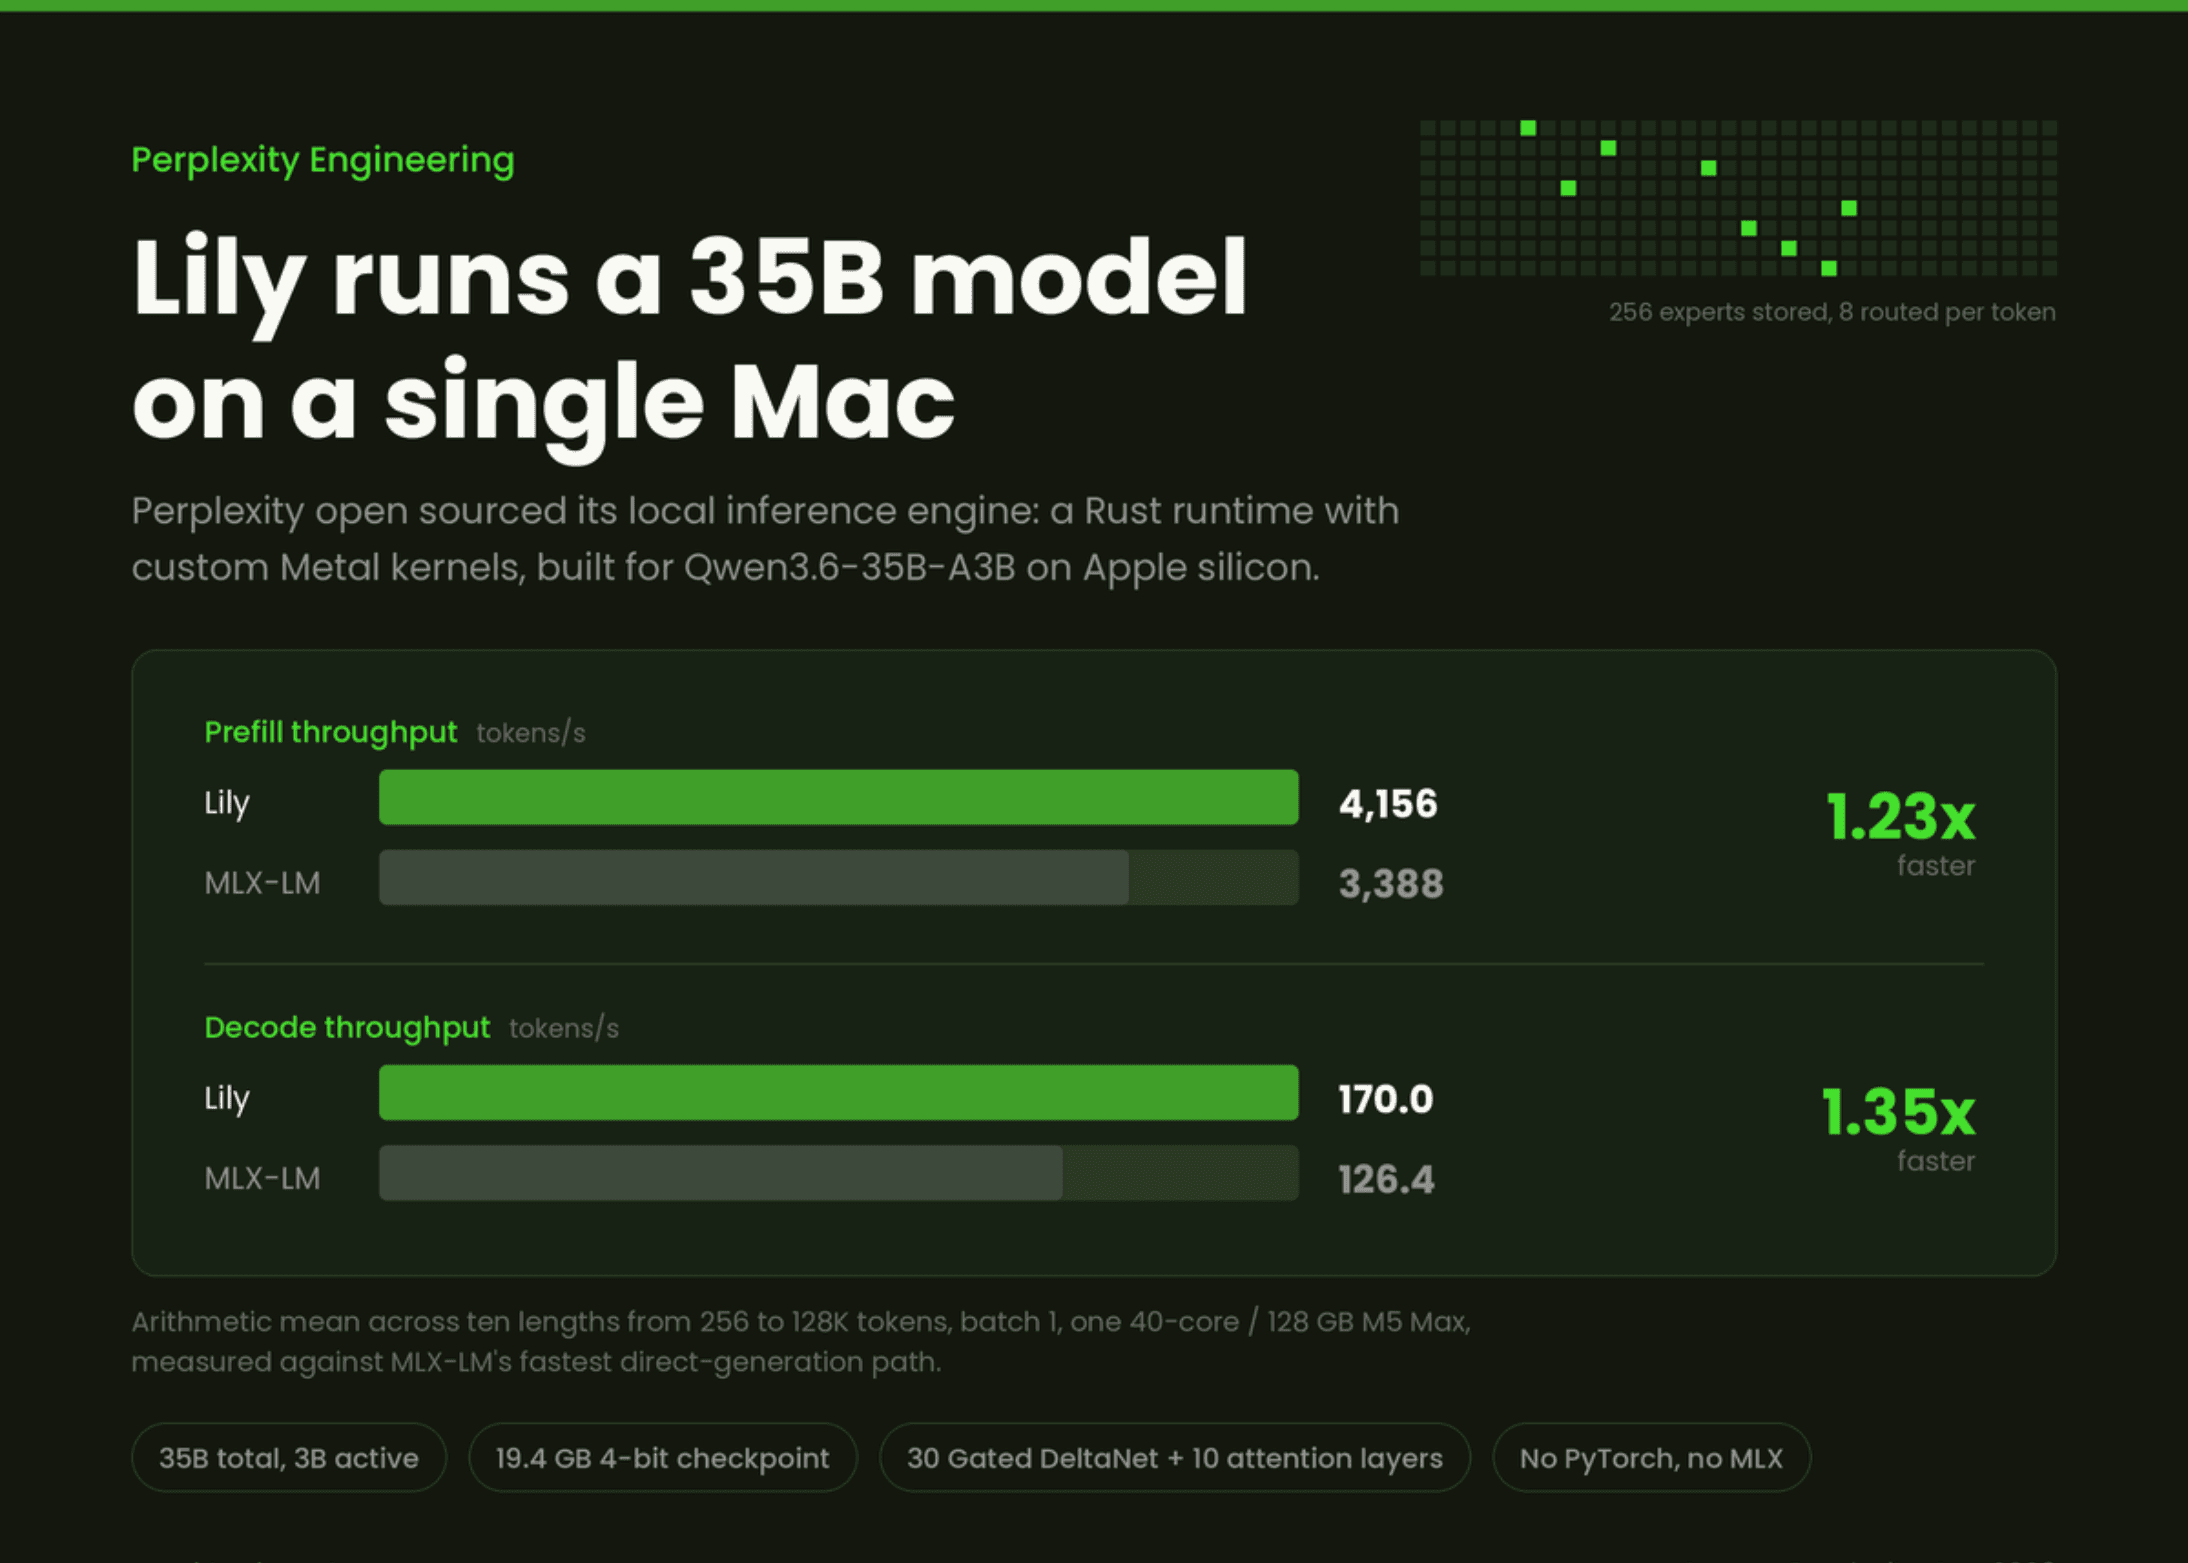
Perplexity ประกาศเปิดโอเพนซอร์ส Lily, ซึ่งเป็น local inference engine สำคัญที่อยู่เบื้องหลังระบบ Hybrid Compute ใน Perplexity Computer โดยตัวระบบเป็น runtime แบบ single-process ที่ใช้ภาษา Rust ในการโหลด checkpoint และขับเคลื่อนวงรอบการสร้างข้อความ (generation loop) พร้อมรองรับ chat-completions API ของ OpenAI สำหรับการส่งข้อมูลแบบ streaming token
ความโดดเด่นของ Lily คือการใช้ Metal kernels ที่เขียนขึ้นเองเพื่อรันโมเดลโดยเฉพาะ โดยตัดความจำเป็นในการใช้ PyTorch หรือ MLX ออกจากกระบวนการประมวลผลทั้งหมด ซึ่งทีมพัฒนาตั้งใจจำกัดขอบเขตให้รองรับเพียงโมเดล Qwen3.6-35B-A3B บนฮาร์ดแวร์ตระกูลเดียว เพื่อรีดประสิทธิภาพสูงสุดออกมาให้ได้มากที่สุด
ปัจจุบันมีเดโมแบบ standalone ให้ผู้ที่สนใจสามารถนำไปใช้งานได้จริงผ่าน pplx-garden repository ซึ่งเป็นเซิร์ฟเวอร์ inference ที่ให้บริการผ่าน HTTP API ขนาดเล็ก สำหรับ checkpoint แบบ 4-bit จะมีขนาด 19.4 GB ดังนั้นอุปกรณ์ขั้นต่ำที่แนะนำคือ Apple Silicon Mac ที่มี unified memory ขนาด 32 GB ขึ้นไป ส่วนผลิตภัณฑ์ Hybrid Compute ของ Perplexity ระบุความต้องการระบบขั้นต่ำเป็น macOS 15+ พร้อมแรม 24 GB และแนะนำที่ 32 GB เพื่อประสิทธิภาพที่ดีที่สุด
ทำไมต้องทำให้เฉพาะทางขนาดนี้?
แม้ว่าซอฟต์แวร์มาตรฐานบน Mac อย่าง MLX และ MLX-LM จะมีการรองรับ การใช้งาน Qwen อยู่แล้ว แต่เครื่องมือเหล่านั้นต้องรักษาความสามารถในการใช้งานได้กับหลายสถาปัตยกรรม ในขณะที่ Lily ยอมทิ้งความยืดหยุ่นดังกล่าวเพื่อรวมโครงสร้างโมเดล แผนการประมวลผล และการเลือก kernel ไว้ใน runtime เดียวเพื่อให้ได้ความเร็วสูงสุด
รูปแบบงานสามลักษณะ
โมเดล Qwen3.6-35B-A3B มีการจัดเก็บพารามิเตอร์รวม 35B และเปิดใช้งานจริงประมาณ 3B ต่อ token โดยใช้ระบบ router ให้คะแนนจาก 256 experts และคัดเลือกมา 8 ตัว พร้อมกับ shared expert อีกหนึ่งตัว นอกจากนี้ยังมีการผสมผสานเลเยอร์ full-attention 10 เลเยอร์ด้วยเทคนิค grouped-query attention เข้ากับเลเยอร์ Gated DeltaNet อีก 30 เลเยอร์ ทำให้เกิดโครงสร้างงานที่ซับซ้อนทั้งแบบกลุ่ม expert ที่ไม่เท่ากันและการประมวลผลที่ต้องทำซ้ำ
Prefill: เก็บน้ำหนักแบบอัดแน่น รักษาการทำ routing ไว้บน GPU
ในการประมวลผลช่วง Prefill ตัว checkpoint จะใช้ 4-bit quantization ซึ่งช่วยบีบอัดน้ำหนักจาก 70 GB เหลือเพียง 19.4 GB โดย Lily จะทำการสร้างน้ำหนักใหม่ (dequantization) ทีละ tile ภายใน grouped GEMM และเก็บผลลัพธ์ไว้ใน threadgroup memory เพื่อลดการส่งข้อมูลไปยัง unified memory ซึ่งเทคนิคนี้ช่วยเพิ่มความเร็ว prefill ได้ถึง 77.4% สำหรับ prompt ขนาด 512 token
นอกจากนี้ การย้ายกระบวนการ routing ทั้งหมดไปไว้ใน GPU command buffer เพียงตัวเดียว ยังช่วยลดการรอคอยระหว่าง CPU (CPU synchronization) ส่งผลให้ความเร็วเพิ่มขึ้นอีก 89% ในขณะที่การปรับขนาด tile และการใช้ Gated DeltaNet scan แบบพิเศษช่วยเสริมประสิทธิภาพรวมให้ดียิ่งขึ้น โดยเฉพาะในงาน Expert GEMMs ซึ่งกินเวลาถึง 90% ของช่วง prefill ทั้งหมด
Decode: ลดการย้ายไบต์ต่อ token ให้เหลือน้อยที่สุด
สำหรับการ decode แบบ Batch-1 ซึ่งมักจะติดปัญหาคอขวดที่ bandwidth ของหน่วยความจำ Lily ได้จัดการให้ kernels ที่เป็นอิสระต่อกันสามารถทำงานซ้อนทับกันได้ (parallel execution) และเชื่อมโยงสายโซ่ kernel เข้าด้วยกันเพื่อรักษาค่ากลางไว้ใน register ช่วยลดการรับส่งข้อมูลระหว่าง CPU ในแต่ละ token ลงได้อย่างมาก
เทคนิค Coalesced cache reads ยังช่วยเพิ่ม bandwidth ของ key และ value ได้อย่างมีนัยสำคัญ ร่วมกับการทำ GQA packing ที่ช่วยให้การโหลดข้อมูล KV ต่อแถวทำเพียงครั้งเดียว ซึ่งปรับปรุงความเร็วการ decode ได้ 23.8% ที่ 32K และเห็นผลชัดเจนขึ้นเรื่อยๆ เมื่อ context ยาวขึ้น โดยสามารถเพิ่มความเร็วได้สูงสุดถึง 40.2% ที่ระดับ 128K tokens
ผลลัพธ์
จากการทดสอบบนชิป M5 Max 40-core แรม 128 GB เปรียบเทียบกับ MLX-LM พบว่า Lily ทำความเร็ว prefill เฉลี่ยได้ 4,156 tokens/s (เร็วกว่า 1.23 เท่า) และ decode เฉลี่ยที่ 170.0 tokens/s (เร็วกว่า 1.35 เท่า) โดยในบางจุดทดสอบสามารถทำความเร็วได้สูงกว่าถึง 1.42 เท่า โดยที่ผลลัพธ์ความถูกต้อง (perplexity) ยังคงใกล้เคียงเดิมและให้ token อันดับสูงสุดตรงกันถึง 96.35% ของเวลาทั้งหมด
ประเด็นสำคัญ
- Lily เป็น engine เฉพาะทางที่ใช้ Rust + Metal สำหรับ Qwen3.6-35B-A3B บน Apple silicon โดยไม่พึ่งพา PyTorch หรือ MLX
- ให้ความเร็วเฉลี่ยสูงกว่า MLX-LM ทั้งในส่วน prefill (1.23 เท่า) และ decode (1.35 เท่า) บนฮาร์ดแวร์ M5 Max
- การเพิ่มประสิทธิภาพสูงสุดเกิดจากการย้าย expert routing ไปไว้บน GPU และการทำ dequantization ร่วมกับ grouped GEMM
- เทคนิค GQA packing และ fixed-block attention ช่วยให้การประมวลผล context ยาว (สูงสุด 128K) ทำได้รวดเร็วขึ้นอย่างมาก
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร