
Perplexity เปิดตัว Portable Computer บน NVIDIA DGX Spark: ประมวลผล AI ภายในเครื่องแบบไร้ค่า Token
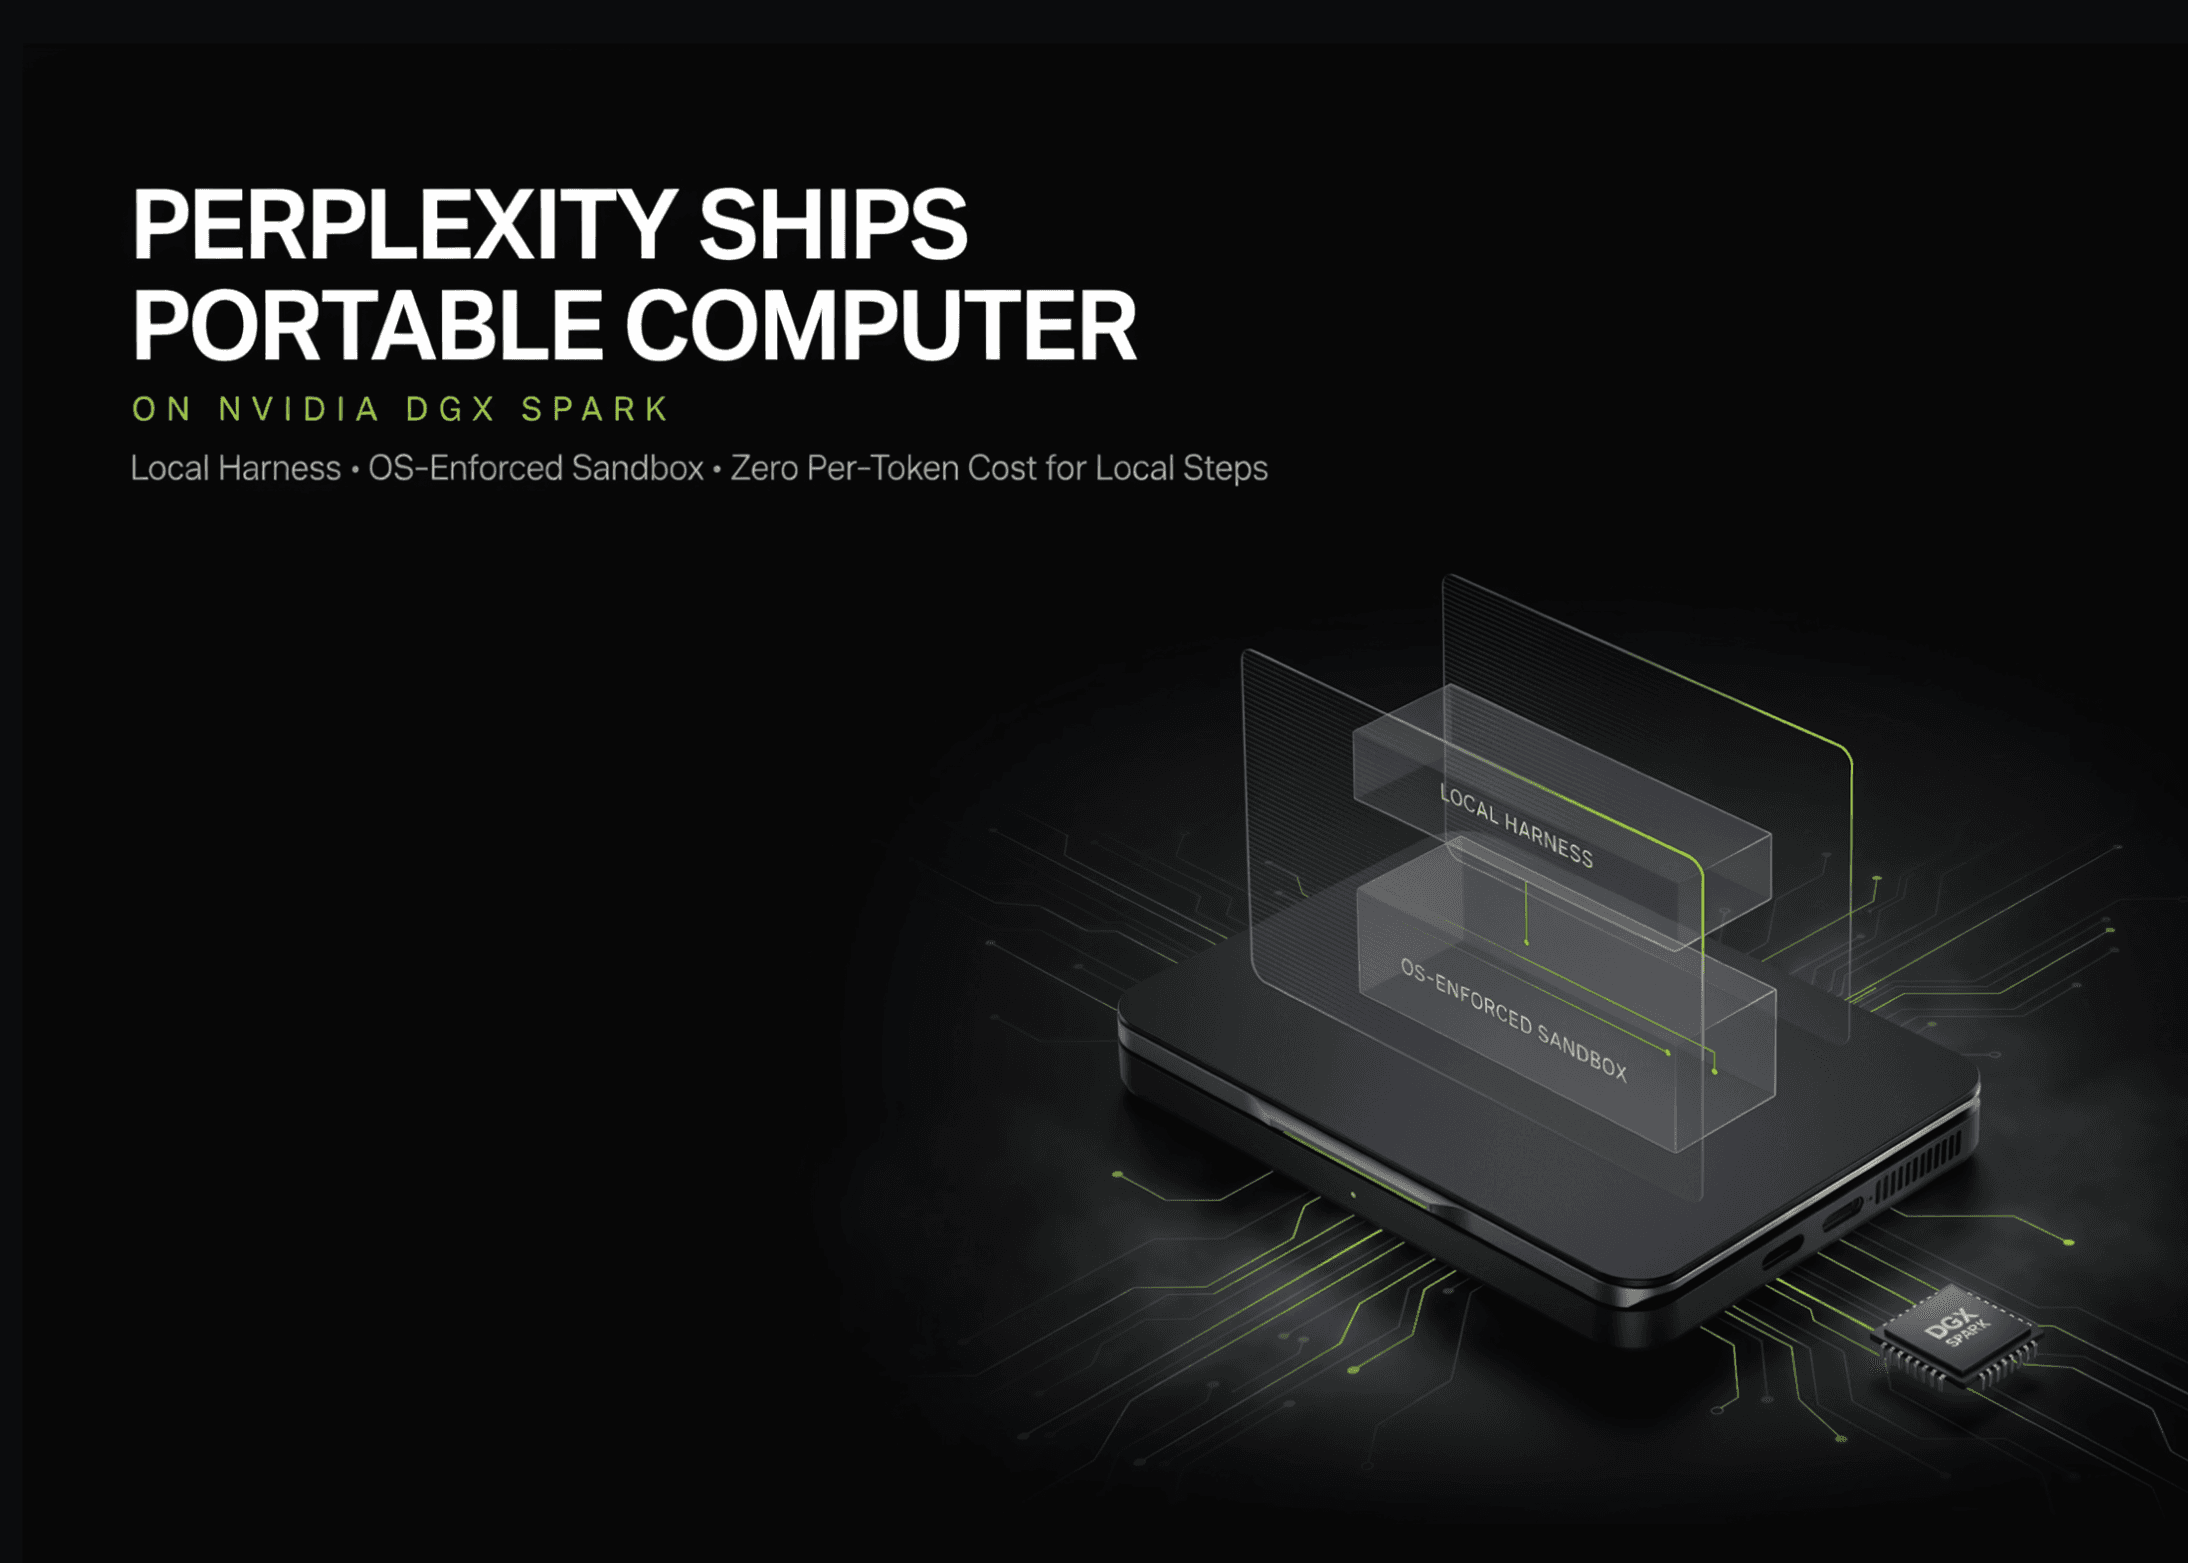
Perplexity ได้เปิดตัว Portable Computer ซึ่งเป็นแพลตฟอร์ม Computer แบบ Agentic รุ่นที่เน้นการทำงานภายในเครื่อง (Local-first) โดยระบบจะรันทั้ง agent harness, orchestrator, planner, tool router และโมเดลที่ผ่านการทำ post-trained โดยตรงบน NVIDIA DGX Spark ทั้งนี้ โมเดลภายในเครื่อง, inference engine, tool sandbox และตัวเชื่อมต่อแอปถูกจัดส่งมาเป็นระบบสำเร็จรูปชุดเดียว
จุดเด่นสำคัญคือทุกภารกิจจะเริ่มต้นประมวลผลบนตัวเครื่อง ซึ่งงานที่จัดการด้วยโมเดลภายในเครื่องจะไม่มีค่าธรรมเนียมต่อ token (zero cost per token) แต่หากขั้นตอนใดจำเป็นต้องเข้าถึงข้อมูลเว็บแบบเรียลไทม์หรือต้องการการให้เหตุผลระดับสูง (frontier reasoning) ตัว orchestrator จะหยุดทำงานชั่วคราวเพื่อสอบถามผู้ใช้ ก่อนจะส่งเฉพาะขั้นตอนนั้นไปยังโมเดลบนคลาวด์ที่มีให้เลือกกว่า 15 โมเดล
สามารถติดตั้งใช้งานได้จริงหรือไม่?
คำตอบคือ ใช่ แต่มีข้อจำกัดเรื่องฮาร์ดแวร์ที่สูงมาก เนื่องจากเป็นซอฟต์แวร์ระดับ Production ไม่ใช่แค่ไฟล์ทดสอบ ระบบจึงต้องการเครื่องระดับ GB10 หรือ GPU ตระกูล RTX ที่มี VRAM ขนาด 24 GB เป็นอย่างน้อยในการทำงาน
ใน ระดับบริษัท ระบบนี้เหมาะสำหรับองค์กรขนาดกลางที่มีเวิร์กสเตชัน NVIDIA อยู่แล้ว หรือสตาร์ทอัพสาย AI-native ที่มีงบประมาณ เนื่องจากราคาฮาร์ดแวร์คือด่านแรกในการเข้าสู่ระบบ โดยกลุ่ม อุตสาหกรรม ที่จะได้ประโยชน์สูงสุดคือ การเงิน, กฎหมาย, การดูแลสุขภาพ และหน่วยงานรัฐที่ให้ความสำคัญกับความมั่นคง ซึ่งมีข้อจำกัดด้านการเก็บรักษาความลับของข้อมูลจนไม่สามารถใช้ cloud inference ได้
สำหรับการ ประยุกต์ใช้งาน นั้นครอบคลุมตั้งแต่การตรวจสอบเอกสารจำนวนมาก, การวิจัยที่มีข้อมูลระบุตัวตน (PII), การย้ายฐานข้อมูลซอร์สโค้ด (repo-scale migrations) ไปจนถึงการสรุปเนื้อหาภายในเครื่องแบบกลุ่ม และการตรวจสอบ Pull Request (PR) ผ่าน Slack
สิ่งที่ติดตั้งมาให้ในเครื่องจริง ๆ คืออะไร
Portable Computer ไม่ได้เป็นเพียงแอปแชทธรรมดา แต่ Perplexity ได้รวมแพ็กเกจโมเดล, inference engine, agent harness และ tool sandbox มาให้เบ็ดเสร็จ ช่วยลดความยุ่งยากในการตั้งค่า server และการเชื่อมต่อเครื่องมือด้วยตัวเอง ผู้ใช้สามารถเลือกใช้ระหว่าง Qwen 3.8 27B หรือ PPLX 27B ซึ่งเป็นโมเดลที่ Perplexity ปรับแต่งมาเป็นพิเศษ โดยมี NVIDIA Nemotron 3.5 Lightning ที่เป็นโมเดล MoE ขนาด 30B เตรียมรองรับในอนาคต รวมถึงเปิดให้ผู้ใช้นำโมเดลมาเอง (Bring-your-own) ได้ด้วย
ความปลอดภัยในการรันโค้ดจะถูกจัดการภายใต้ Sandbox ที่ควบคุมโดยระบบปฏิบัติการ (OS-enforced) ซึ่งจำกัดการเข้าถึงไฟล์และเครือข่าย หากระบบ Sandbox มีปัญหา การทำงานจะหยุดลงทันทีเพื่อความปลอดภัยแทนที่จะฝืนทำงานต่อ ส่วนตัวเชื่อมต่อบริการต่างๆ เช่น Gmail, Outlook, Slack และ GitHub จะถูกควบคุมผ่าน local orchestrator ทั้งหมด
การตัดสินใจออกแบบที่แท้จริงคือจุดเชื่อมต่อการยกระดับ (Escalation Gate)
แม้จะเป็น Local-first แต่ก็ไม่ใช่ Local-only เมื่อระบบต้องการการคำนวณที่ซับซ้อนขึ้น ตัว orchestrator จะทำหน้าที่เป็นจุดคัดกรอง โดยจะเลือกบริบทที่เกี่ยวข้องและรันระบบตรวจจับข้อมูลส่วนบุคคล (PII) ก่อนจะแสดงให้ผู้ใช้เห็นชัดเจนว่าข้อมูลใดจะถูกส่งออกนอกเครื่องบ้าง ขั้นตอนที่ได้รับอนุมัติจะถูกส่งไปยังโมเดลคลาวด์ โดยที่ปรึกษาทางไกลจะส่งกลับมาเพียงคำแนะนำในรูปแบบข้อความ และไม่สามารถเข้าถึงไฟล์หรือเครื่องมือในเครื่องได้โดยตรง
นอกจากนี้ Perplexity ยังแก้ปัญหาขีดจำกัดด้านบริบท (context limits) ของโมเดลขนาดเล็ก แม้ Qwen 3.8 27B จะรองรับได้ถึง 260K token แต่ประสิทธิภาพมักลดลงหลังจาก 100K ตัวระบบจึงออกแบบให้ system prompt และชุดเครื่องมือมีขนาดเล็กที่สุด โดยจะโหลดทักษะเฉพาะทางตามความต้องการ และใช้การบีบอัดบริบทที่เก่าแล้วในระหว่างการทำงานเพื่อให้ระบบยังคงรวดเร็ว
ผลการทดสอบ (Benchmarks)
จากการทดสอบบน Local Knowledge Work Bench ซึ่งครอบคลุมภารกิจการวิจัยเชิงลึกและการวิเคราะห์ทางการเงิน 53 รายการ พบว่า Computer ที่รัน Qwen 3.8 27B บน DGX Spark ทำคะแนนได้ 82.6% เหนือกว่า Pi harness (77.6%) และ Hermes (74.0%) บนโมเดลเดียวกัน ขณะที่ PPLX 27B สามารถทำคะแนนได้สูงถึง 85.4%
ในส่วนของ BrowseComp ระบบทำได้ 66.7% โดยใช้เวลาและ token น้อยลงกว่าคู่แข่งอย่างเห็นได้ชัด และใน ParseBench-100 สำหรับการวิเคราะห์เอกสารผ่านภาพ ระบบทำคะแนนได้ 65.1% ซึ่งสูงกว่าเครื่องมืออื่นๆ ในตลาดอย่างมาก
สิ่งที่น่าสนใจคือการทดสอบแบบไฮบริดใน Terminal Bench 2.1 การทำงานในเครื่องทั้งหมดทำคะแนนได้ 59.6% โดยไม่มีค่าใช้จ่าย แต่เมื่อเปิดใช้งานระบบยกระดับ (adviser escalation) คะแนนจะพุ่งขึ้นเป็น 73.0% โดยมีต้นทุนประมาณ $0.415 ต่อรอบ เทียบกับการใช้ Claude Opus 5 เพียงอย่างเดียวที่ทำได้ 82.4% แต่มีราคาสูงถึง $0.65 แสดงให้เห็นว่าการทำงานแบบไฮบริดช่วยลดช่องว่างด้านประสิทธิภาพในราคาที่คุ้มค่ากว่า
ฮาร์ดแวร์ โมเดลราคา และข้อจำกัด
การติดตั้งบน DGX Spark ต้องการสเปกขั้นสูง ได้แก่ ชิป GB10 superchip, RAM 128 GB และพื้นที่เก็บข้อมูล 1 TB สำหรับโมเดล Qwen 3.8 27B จะเป็นเวอร์ชัน 3-bit quantization ขนาด 17.4 GB ซึ่งต้องการ RAM อย่างน้อย 32 GB ส่วน Nemotron 3.5 Lightning จะเป็น 4-bit ต้องการ RAM 36 GB โดยระบบรองรับทั้ง Ubuntu บน ARM และ x64 ที่มี GPU RTX VRAM 24 GB ขึ้นไป
ปัจจุบันเริ่มเปิดใช้งานบน Linux สำหรับสมาชิกกลุ่ม Pro และ Enterprise ก่อน ส่วน Windows มีกำหนดในช่วงเดือนกันยายน ขณะที่ macOS ยังไม่มีแผนในตอนนี้ การประมวลผลภายในเครื่องที่ไม่มีค่าธรรมเนียมต่อ token นี้ จะช่วยให้การจัดการข้อมูลขนาดใหญ่และลูปการทำงานที่ยาวนานมีความคุ้มค่าทางเศรษฐกิจมากขึ้นสำหรับองค์กรที่มีฮาร์ดแวร์เป็นของตัวเอง
ประเด็นสำคัญ
- Portable Computer รันทั้ง agent harness, orchestrator และ sandbox ภายในเครื่องบน DGX Spark
- ทุกขั้นตอนเริ่มต้นบนตัวเครื่อง และการส่งข้อมูลไปคลาวด์ต้องผ่านการอนุมัติและตรวจสอบ PII ทุกครั้ง
- PPLX 27B ทำคะแนนทดสอบได้สูงถึง 85.4% ในภารกิจความรู้เฉพาะทาง
- ระบบไฮบริดช่วยให้ได้ประสิทธิภาพใกล้เคียงโมเดลระดับ Frontier ในราคาที่ประหยัดกว่าเกือบ 40%
ดูข้อมูลเพิ่มเติมได้ที่ ** Perplexity Portable Computer ** และ
NVIDIA local AI blog นอกจากนี้ อย่าลืมติดตามเราบน ** Twitter** และอย่าลืมเข้าร่วม
และกดติดตาม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร