
PrismML เปิดตัว Ternary Bonsai 2 27B จิ๋วแต่แจ๋วขนาด 5.9 GB
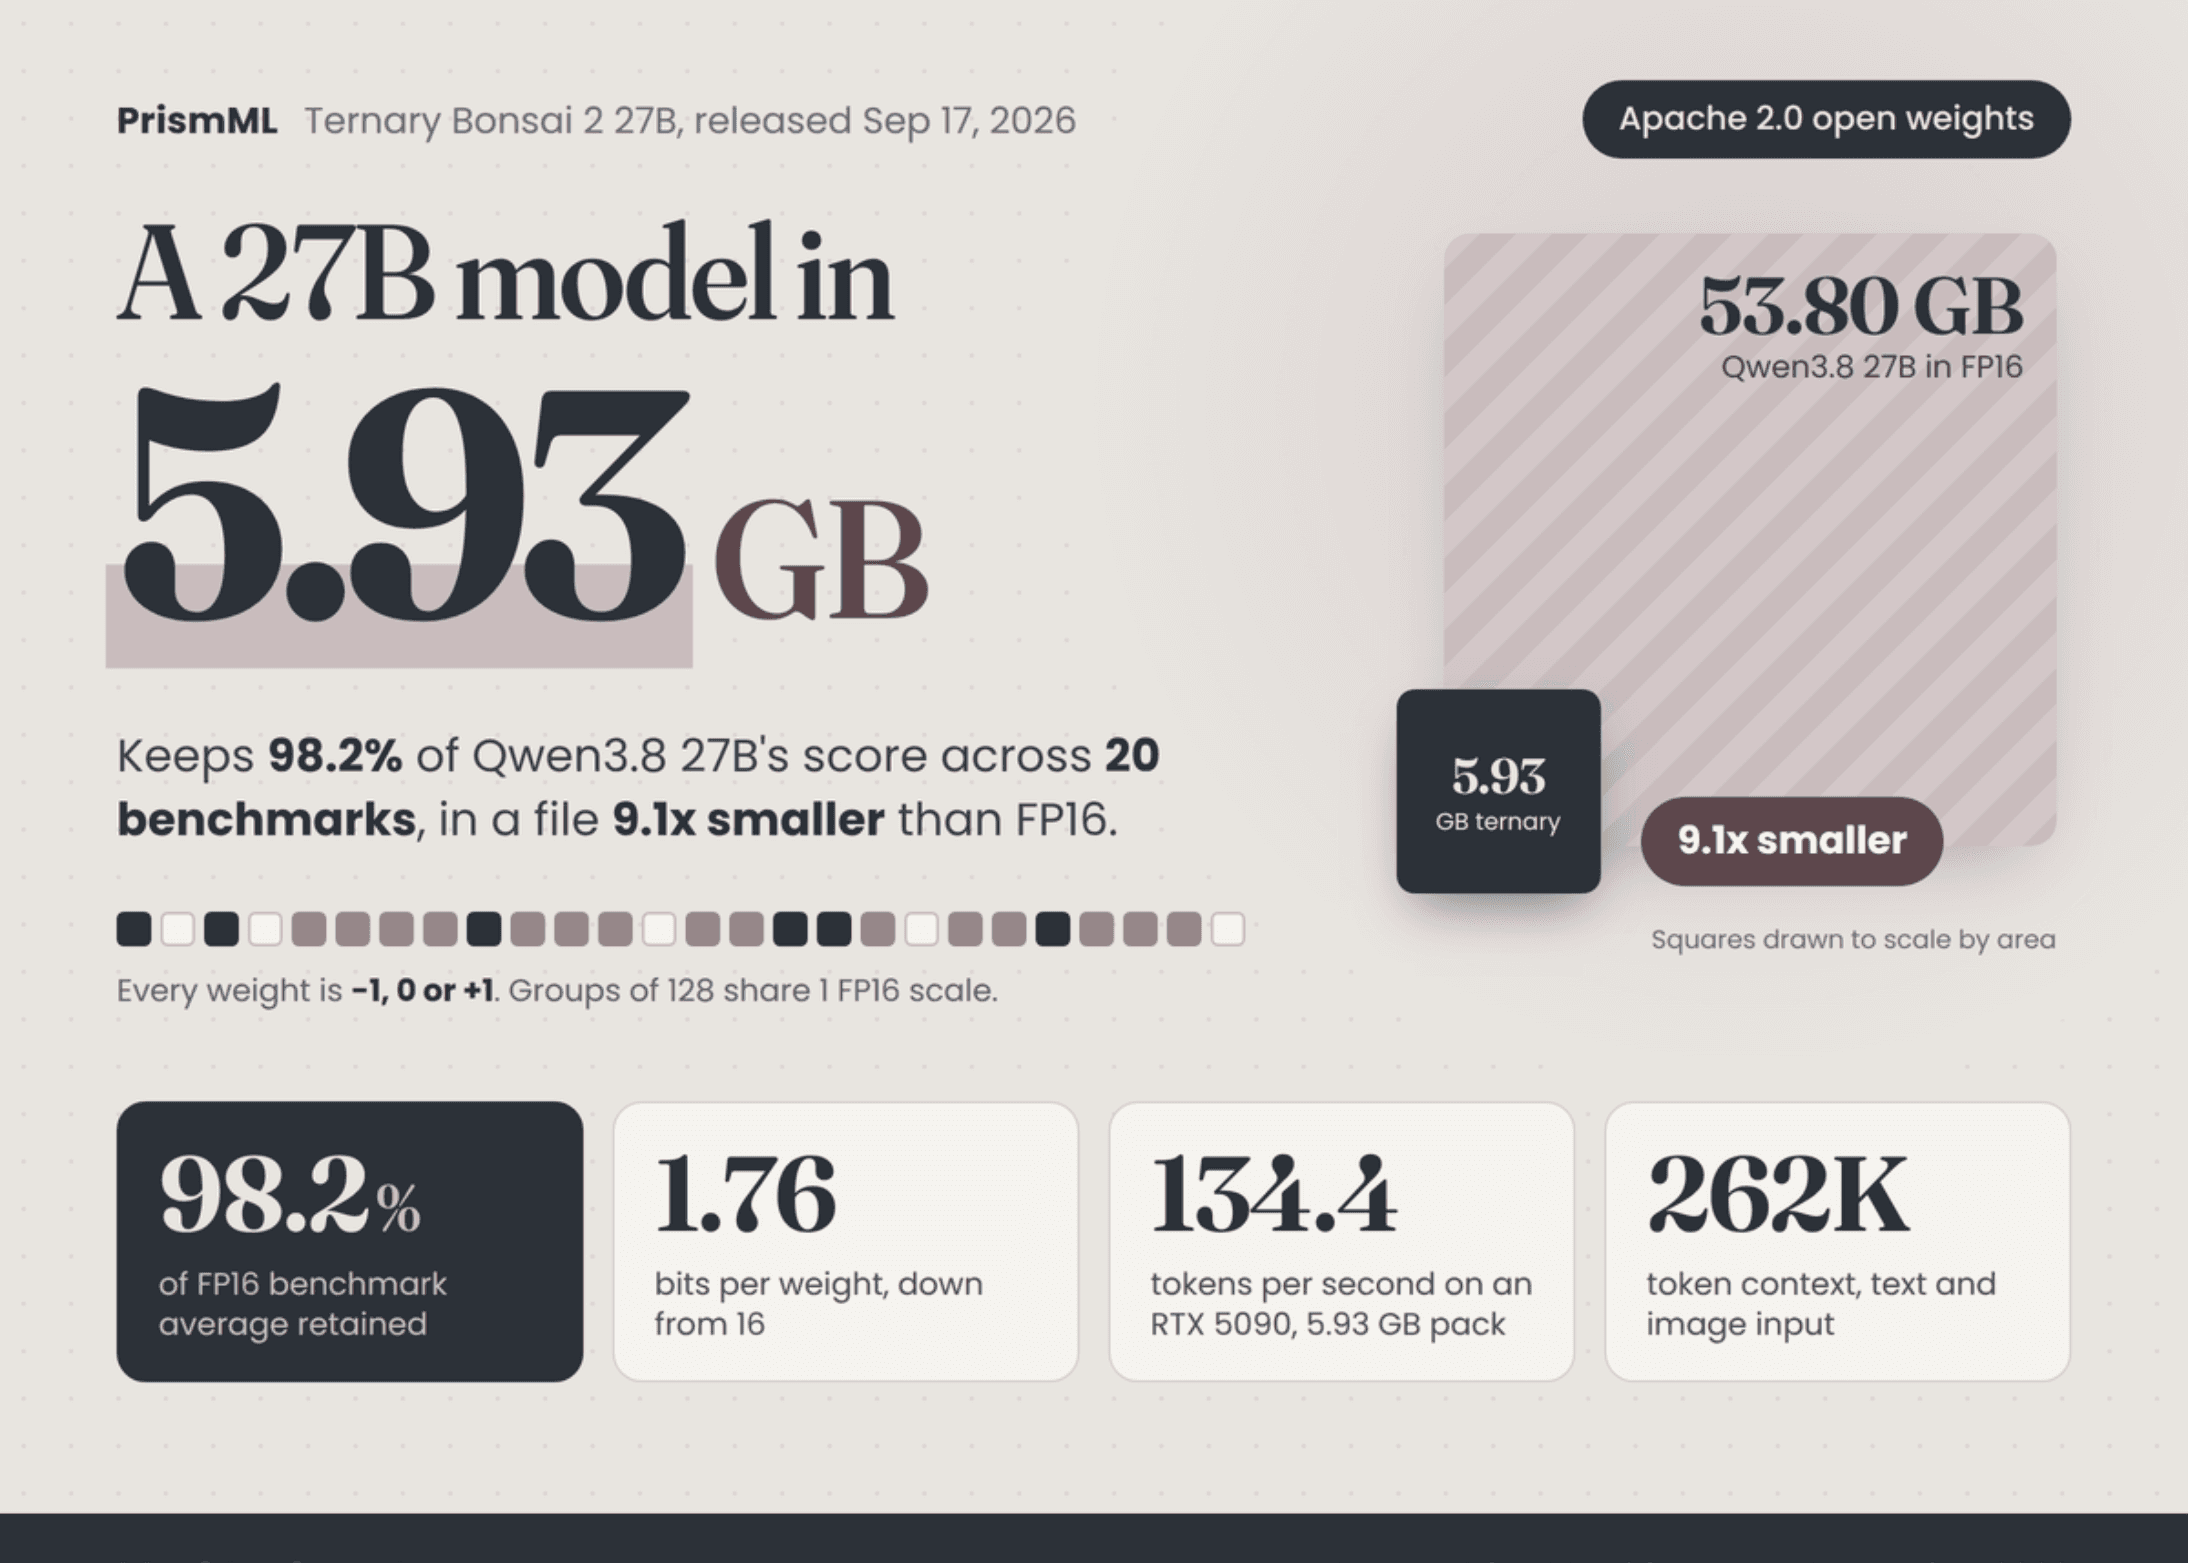
PrismML ได้เปิดตัว Ternary Bonsai 2 27B โมเดลภาษาเวอร์ชัน ternary-weight ที่พัฒนาต่อยอดมาจาก Qwen3.8 27B โดยมีจุดเด่นที่ขนาดไฟล์เพียง 5.93 GB ซึ่งเล็กลงอย่างมากเมื่อเทียบกับขนาด 53.80 GB ในรูปแบบ FP16
จากการทดสอบ 20 benchmarks ทาง PrismML รายงานว่าโมเดลนี้สามารถรักษาประสิทธิภาพเฉลี่ยไว้ได้ถึง 98.2% รองรับทั้งการประมวลผลข้อความและรูปภาพ พร้อม context window ขนาด 262K-token โดยมีการสาธิตการใช้งานร่วมกับ Cline coding agents และการสั่งงานคอมพิวเตอร์ผ่าน RTX 5090 โมเดลนี้เปิดตัวตามหลัง Bonsai 27B ตัวแรก เพียง 2 เดือน ซึ่งรุ่นก่อนหน้านั้นทำประสิทธิภาพได้ราว 95%
สำหรับการใช้งานจริง weights ภายใต้ลิขสิทธิ์ Apache 2.0 พร้อมให้ดาวน์โหลดไปรันบนแล็ปท็อปที่มีแรม 16 GB หรือ GPU ขนาด 24 GB ได้ทันที โดยจำเป็นต้องใช้งานผ่าน llama.cpp เวอร์ชัน fork ของ PrismML หรือ MLX runtime ของทางผู้พัฒนาเอง
Ternary Bonsai 2 27B คืออะไร?
โมเดลนี้ยังคงสถาปัตยกรรมเดิมของ Qwen3.8 27B ไว้ครบถ้วน โดยมีพารามิเตอร์รวม 27.36B แบ่งเป็นส่วนประมวลผลภาษา (backbone) 24.35B ส่วน embeddings และ LM head 2.54B และส่วนการมองเห็น (vision tower) 0.47B ตัว backbone ใช้เทคนิค hybrid attention ที่ผสมผสานระหว่าง linear-attention 75% และ full-attention 25%
โครงสร้าง Ternary weights ครอบคลุมเกือบทุกส่วน ยกเว้นเพียง 0.0976% ของพารามิเตอร์ที่ยังคงความละเอียดสูงไว้เพื่อรักษาเสถียรภาพ ได้แก่ recurrent state path และ normalization weights ทั้งนี้ในรูปแบบไฟล์ GGUF ส่วน vision tower จะถูกแยกเป็นไฟล์ขนาด 0.63 GB และจะโหลดเข้าหน่วยความจำเมื่อมีการประมวลผลรูปภาพเท่านั้น
รูปแบบ Ternary ทำงานอย่างไร?
กลไกหลักคือน้ำหนัก (weight) แต่ละตัวจะมีค่าเพียง 1 ใน 3 สถานะ คือ -1, 0 หรือ +1 โดยกลุ่มน้ำหนักทุกๆ 128 ตัวจะใช้ FP16 scale ร่วมกันหนึ่งค่า ทำให้ได้ความหนาแน่นของข้อมูลเฉลี่ยที่ 1.72 bits ต่อ weight
จากข้อมูลใน whitepaper การจัดเก็บข้อมูล (packing) แบบ GGUF มี 2 รูปแบบหลัก คือ PTQ1_0 ที่เน้นความกะทัดรัดด้วยขนาด 5.93 GB และ PQ2_0 ขนาด 7.25 GB ที่ออกแบบมาให้ประมวลผลการแตกไฟล์ (unpack) ได้รวดเร็วกว่า
นอกจากนี้ยังมีการใช้เทคนิค rotated basis หรือการหมุนเวกเตอร์ด้วย blockwise Hadamard rotation ขนาด 1,024 ก่อนกำหนดค่า ternary และใช้ matching transform กับ activations ในขณะประมวลผล ซึ่งเป็นแนวคิดที่อ้างอิงมาจาก SpinQuant อย่างไรก็ตาม PrismML ไม่ได้เปิดเผยรายละเอียดวิธีการกำหนดค่า ternary อย่างเจาะจง
ผลคะแนนเมื่อเทียบกับ Qwen3.8 27B เป็นอย่างไร?
PrismML ประเมินประสิทธิภาพผ่าน EvalScope และ vLLM ในโหมด thinking บนเครื่อง H100 GPU โดยมีผลลัพธ์ดังนี้:
| ความสามารถ | Qwen3.6 27B | Qwen3.8 27B | Ternary Bonsai 2 27B | การคงประสิทธิภาพ |
|---|---|---|---|---|
| ความรู้และการใช้เหตุผล | 84.71 | 86.66 | 83.95 | 96.9% |
| คณิตศาสตร์ | 94.64 | 97.06 | 96.57 | 99.5% |
| การเขียนโค้ด | 82.57 | 82.17 | 81.58 | 99.3% |
| การเป็นเอเจนต์และเรียกใช้เครื่องมือ | 80.05 | 79.74 | 77.57 | 97.3% |
| การทำตามคำสั่ง | 74.53 | 81.25 | 82.66 | 101.7% |
| การมองเห็น (Vision) | 79.82 | 81.64 | 78.59 | 96.3% |
| ภาพรวม (20 benchmarks) | 83.6 | 85.4 | 83.9 | 98.2% |
เมื่อเทียบกับเทคนิคการบีบอัดทั่วไปอย่าง IQ2_XXS (ขนาด 7.3 GB) ซึ่งได้คะแนนเฉลี่ย 75.2 พบว่า Bonsai 2 ทำได้ดีกว่ามาก โดยเฉพาะในด้านคณิตศาสตร์ (AIME26) และ LiveCodeBench v6 ที่ทำคะแนนทิ้งห่างอย่างเห็นได้ชัด
จุดที่คุณภาพยังลดลงอยู่คือส่วนไหน?
แม้ค่าเฉลี่ยจะสูงถึง 98.2% แต่ในงานบางประเภทความสามารถยังคงลดลงอย่างมีนัยสำคัญ โดยเฉพาะงานด้าน Vision และด้านความรู้ทั่วไปที่รักษาไว้ได้ประมาณ 96%
จุดอ่อนที่ชัดเจนที่สุดคืองานด้านเอเจนต์ที่มีความซับซ้อนและยาวต่อเนื่อง (Long-horizon) โดยใน Terminal-Bench 2.1 และ SWE-bench Verified โมเดลรักษาประสิทธิภาพไว้ได้เพียง 75% เท่านั้น ซึ่งการทดสอบส่วนนี้ไม่ได้ถูกนับรวมในค่าเฉลี่ย 20 benchmarks หลัก
นอกจากนี้ ระดับความพยายามในการใช้เหตุผล (Reasoning effort) ก็มีผลต่อความแม่นยำ โดยผลลัพธ์ทั้งหมดนี้เป็นข้อมูลภายในจาก PrismML และยังไม่ได้รับการตรวจสอบโดยบุคคลภายนอก
ความเร็วบนฮาร์ดแวร์จริงเป็นอย่างไร?
จากการทดสอบการถอดรหัส (decode) ที่ batch size 1 บนซอฟต์แวร์เฉพาะของ PrismML เมื่อวันที่ 16 กันยายน 2026 พบว่า RTX 5090 ทำความเร็วได้สูงถึง 142.5 tokens ต่อวินาที ขณะที่ RTX 4090 ทำได้ 96.7 tokens ต่อวินาที ส่วนฝั่ง Apple Silicon อย่าง M5 Max ทำได้ที่ 46.8 tokens ต่อวินาที
ในแง่ของรูปแบบการจัดเก็บ ไฟล์ PTQ1_0 จะทำงานได้เร็วกว่าบนการ์ดจอซีรีส์ Ada และ L4 ส่วนไฟล์ PQ2_0 จะให้ประสิทธิภาพดีกว่าบน Blackwell, Hopper, Ampere รวมถึง Apple Silicon นอกจากนี้ทีมวิจัยยังระบุว่าโมเดลนี้ประหยัดพลังงานมากกว่าโมเดลขนาด 8B แบบปกติถึง 40%
วิธีการรันโมเดล?
การใช้งาน ไฟล์ GGUF จำเป็นต้องใช้ llama.cpp fork ของ PrismML เท่านั้น โดยสามารถตั้งค่าผ่าน Bonsai-demo repo ด้วยคำสั่ง:
./setup.shตามด้วยการเริ่มเซิร์ฟเวอร์:
./scripts/start_llama_server.shสำหรับผู้ใช้ Mac สามารถเลือกใช้ MLX pack หรือทดลองใช้งานผ่านเบราว์เซอร์ได้ที่ เดโม WebGPU
สรุปประเด็นสำคัญ
- โมเดลขนาด 5.93 GB เล็กกว่าต้นฉบับประมาณ 9.1 เท่า
- ประสิทธิภาพเฉลี่ย 83.9 คะแนน สูสีกับ Qwen3.8 27B รุ่นเต็ม
- ความเร็วสูงถึง 142.5 tokens ต่อวินาทีบน RTX 5090
- ยังมีข้อจำกัดในงานประเภท Long-horizon agent ซึ่งประสิทธิภาพลดลงเหลือ 75%
- ต้องใช้ llama.cpp เวอร์ชันปรับแต่งพิเศษในการรันไฟล์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร