
เปิดตัว Project HydraFusion: ยกระดับ GitHub Copilot ด้วยระบบประสานงานหลายโมเดลที่มีความฉลาดระดับ Frontier
เป้าหมายสูงสุดของเราคือการมอบเครื่องมือที่ดีที่สุดให้แก่นักพัฒนา ซึ่งเมื่อต้นปีที่ผ่านมา เราได้เปิดตัว Auto model selection, เพื่อช่วยคัดเลือกโมเดลที่เหมาะสมกับงานโดยอัตโนมัติ
ล่าสุดเราขอแนะนำ Project HydraFusion ซึ่งเป็นงานวิจัยฉบับทดสอบ (Research Preview) ที่มอบความฉลาดระดับ Frontier ผ่านระบบ Runtime Orchestration โดยตัวระบบจะสร้างแผนงานและเลือกใช้โมเดลจากผู้ให้บริการหลายรายเพื่อทำหน้าที่ร่าง (Draft) วิจารณ์ (Critique) และแก้ไข (Revise) หรือส่งต่องาน (Cascade) ไปยังโมเดลที่ทรงพลังกว่าเพื่อให้งานเสร็จสมบูรณ์
HydraFusion ถือเป็นหัวใจสำคัญของกลยุทธ์การกำหนดเส้นทางเชิงความหมายอัตโนมัติ (Automated Semantic Routing) ระหว่างโมเดลแบบ Local, Cloud และ Compound โดยความซับซ้อนทั้งหมดจะถูกจัดการอยู่เบื้องหลัง นักพัฒนาเพียงแค่เลือกใช้งาน HydraFusion แล้วระบบจะจัดสรรเวิร์กโฟลว์ที่สมดุลทั้งในด้านประสิทธิภาพ ต้นทุน และความหน่วง (Latency) ให้เอง
พร้อมให้ใช้งานแล้วในรูปแบบ Research Preview
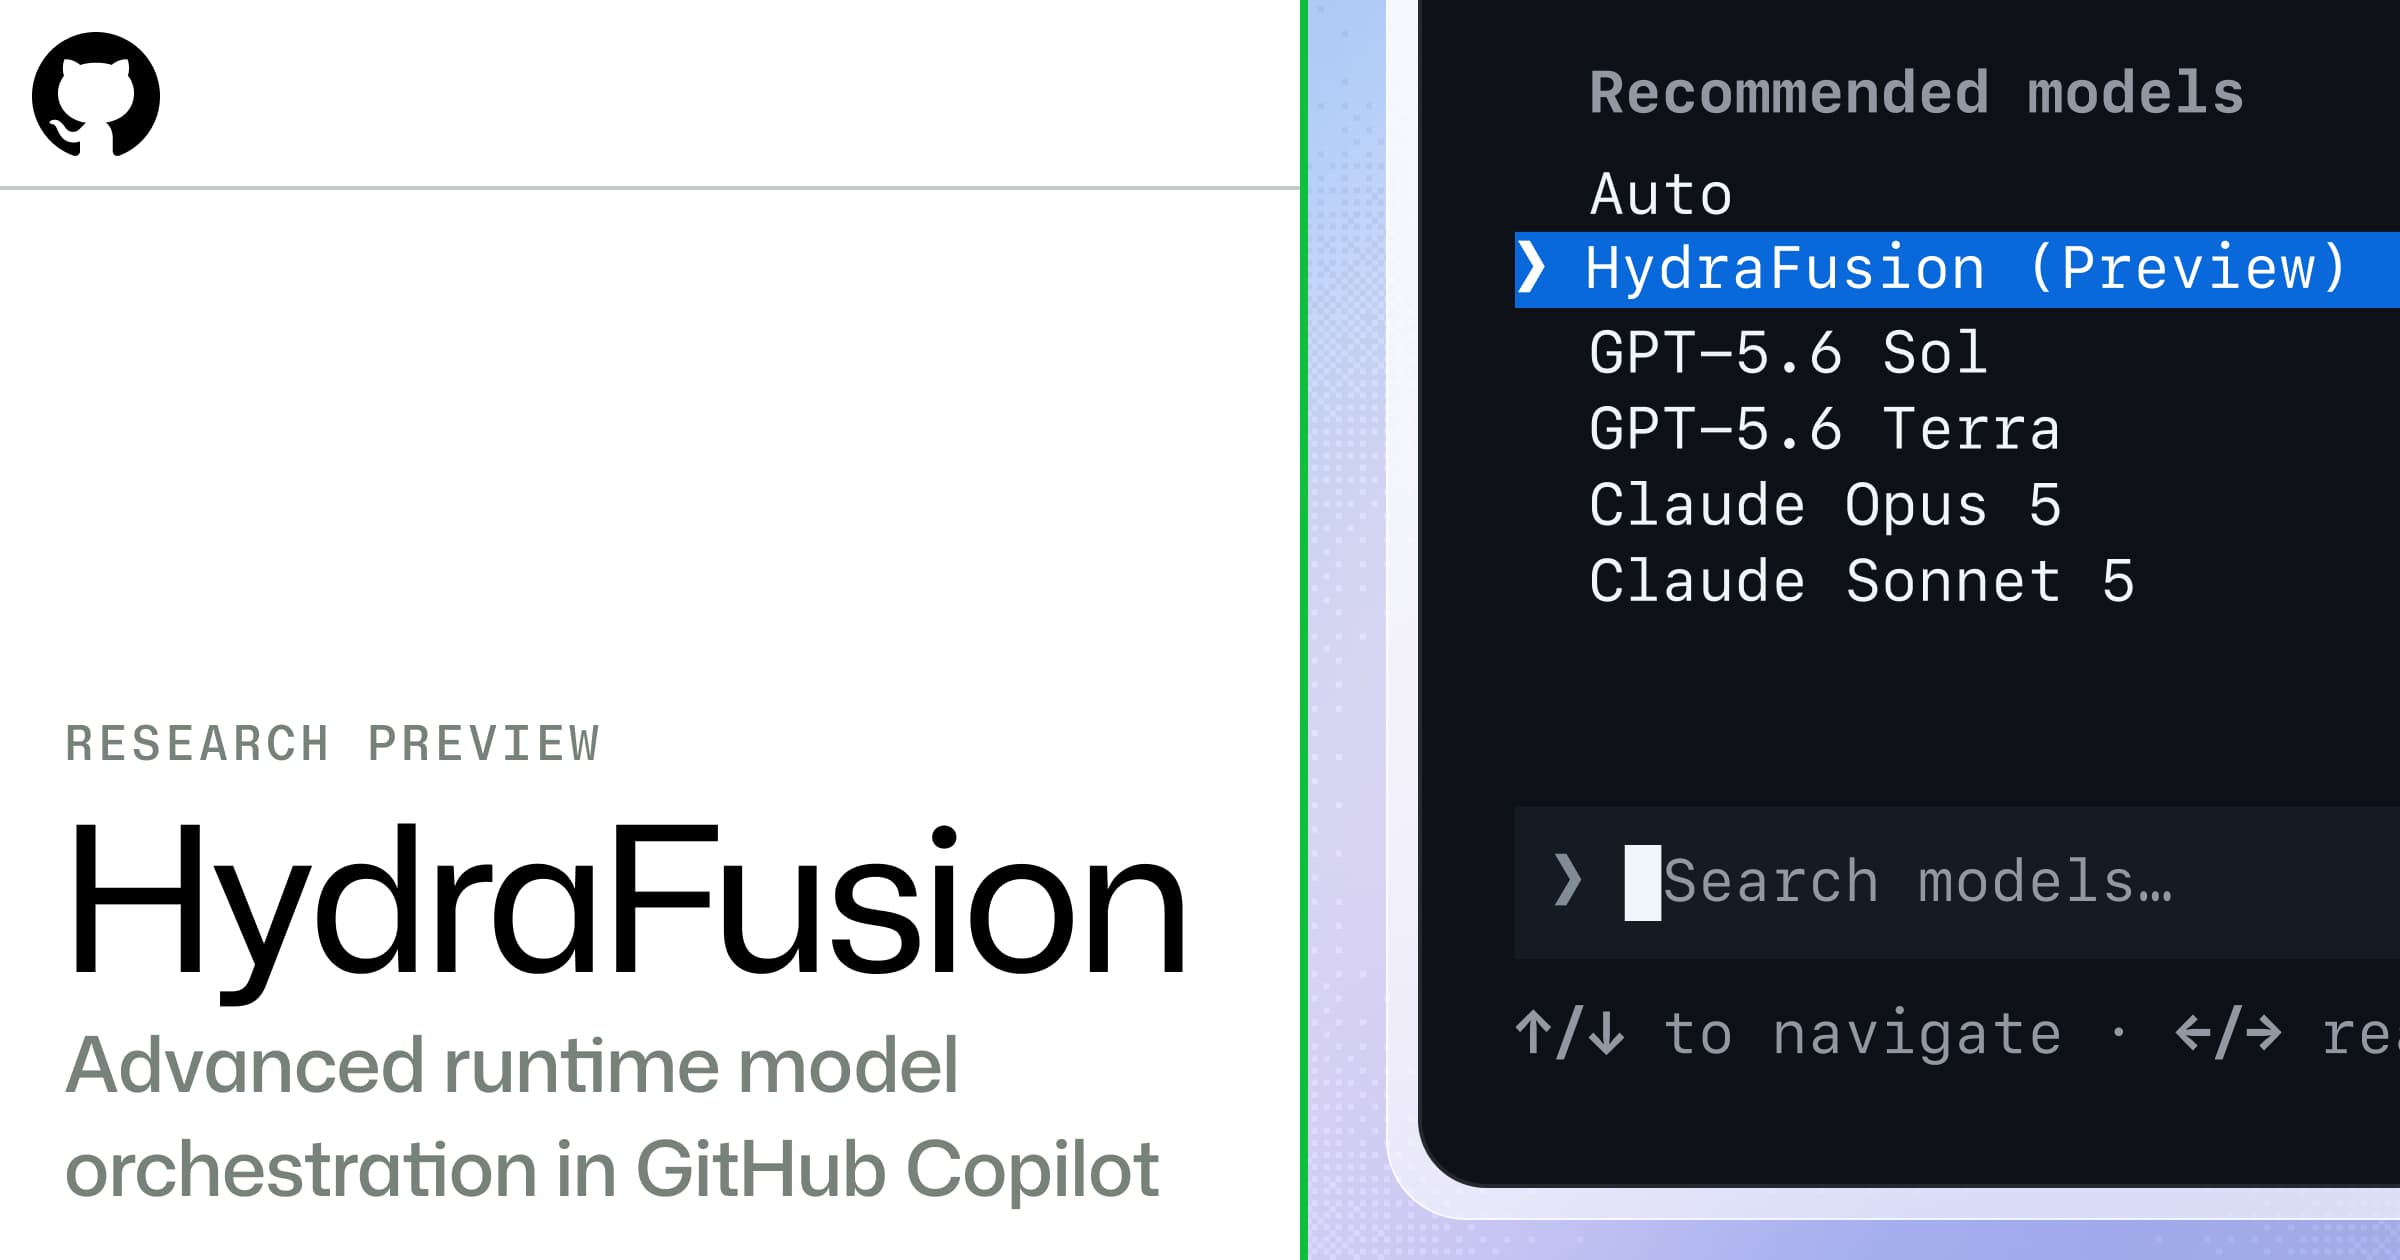
HydraFusion เปิดให้ใช้งานแล้วสำหรับผู้ใช้ GitHub Copilot ทุกแผนผ่านคำสั่ง /experimental ใน GitHub Copilot CLI โดยค่าใช้จ่ายจะคำนวณตามจำนวน Token ของโมเดลที่ถูกเลือกใช้งานจริงตาม standard rate ของแต่ละโมเดล
สำหรับผู้ที่ต้องการทดลองใช้งานใน Copilot CLI สามารถทำได้ดังนี้:
- รัน
/updateเพื่อติดตั้งเวอร์ชันล่าสุด - รัน
/experimental onเพื่อเปิดโหมดทดลอง - รัน
/modelแล้วเลือกHydraFusion (Research Preview)
ทั้งนี้ ท่านสามารถส่งข้อเสนอแนะเพิ่มเติมได้ที่ GitHub Community
ในการทำงาน HydraFusion จะมองว่าการเลือกเวิร์กโฟลว์คือโจทย์การหาค่าที่เหมาะสมที่สุด (Optimization Problem) โดยวิเคราะห์จากสัญญาณความสามารถ (Capability Signals) ทั้งด้านการใช้เหตุผล การเขียนโค้ด การแก้บั๊ก และการใช้เครื่องมือ เพื่อให้ได้ผลลัพธ์ตามมาตรฐานคุณภาพที่กำหนด
ปัจจุบัน HydraFusion จะเลือกรูปแบบการทำงานอย่างใดอย่างหนึ่งจาก 3 รูปแบบ ดังนี้:
- Single: ใช้โมเดลเดียวที่เหมาะสมที่สุดแก้ปัญหาโดยตรง
- Cascade: ให้โมเดลที่มีประสิทธิภาพร่างคำตอบก่อน หากไม่ผ่านด่านตรวจสอบคุณภาพ (Quality Gate) ระบบจะส่งต่องานไปยังโมเดลที่แข็งแกร่งกว่า
- Critique: โมเดลหนึ่งจะร่างผลลัพธ์ แล้วใช้อีกโมเดลจากตระกูลที่ต่างกันทำหน้าที่วิจารณ์แบบอ่านอย่างเดียว (คล้ายรูปแบบ Rubber Duck) เพื่อให้โมเดลแรกนำไปแก้ไขอีกครั้ง
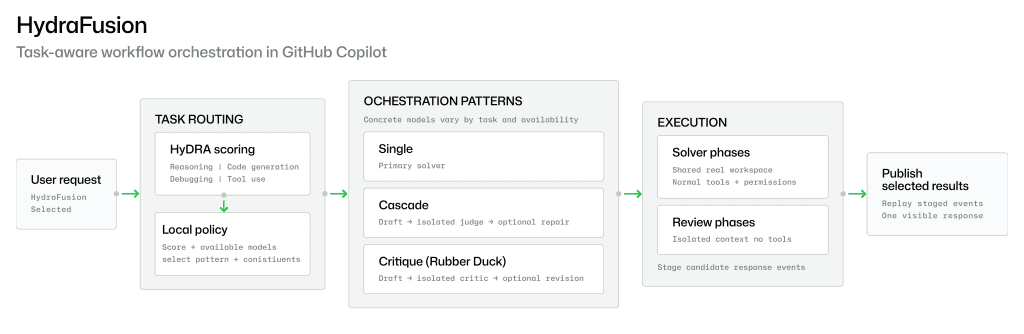
รูปที่ 1. สถาปัตยกรรม HydraFusion
แต่ละรูปแบบจะตอบโจทย์การแลกเปลี่ยนระหว่างคุณภาพและต้นทุน (Quality-to-cost trade-off) ที่ต่างกัน โดยโหมด Single เน้นความเร็ว Cascade ให้โอกาสโมเดลขนาดเล็กก่อนเข้าสู่กระบวนการที่ซับซ้อน และ Critique เพิ่มมุมมองที่เป็นอิสระเพื่อความแม่นยำสูงสุด
จากการทดสอบแบบออฟไลน์ผ่าน Benchmark การเขียนโค้ด 3 รายการ HydraFusion แสดงให้เห็นคุณภาพระดับ Frontier พร้อมการประหยัดต้นทุนที่น่าประทับใจ โดยใน TerminalBench 2.1 สามารถเพิ่มคุณภาพงานได้ 4.9 จุดเปอร์เซ็นต์ แต่ใช้ต้นทุนต่ำกว่า Claude Opus 5 ถึง 67%
การประสานงานหลายโมเดลแบบปรับตัวได้ (Adaptive multi-model orchestration)
ปกติแล้วนักพัฒนามักประสานงานระหว่างโมเดลด้วยตนเอง เช่น การใช้โมเดลหนึ่งตรวจงานของอีกโมเดล HydraFusion จึงนำกระบวนการนี้มาใส่ไว้ในระบบ Runtime เพื่อให้คุณจดจ่อกับงานได้เต็มที่ในขณะที่ระบบจัดการโมเดลอยู่เบื้องหลัง
HydraFusion จะประเมินความซับซ้อนของแต่ละคำขอและเลือกเวิร์กโฟลว์ที่ประหยัดที่สุดแต่ยังคงตอบโจทย์คุณภาพ โดยจะเรียกใช้โมเดลเพิ่มเติมเฉพาะเมื่อจำเป็นเท่านั้น นอกจากนี้ เมื่อมีโมเดลใหม่ๆ เข้าสู่ตลาด HydraFusion จะสามารถรวมโมเดลเหล่านั้นเข้าสู่ระบบเพื่อดึงจุดแข็งมาใช้ได้ทันที
การสร้าง HydraFusion เพื่อให้ระบบนี้มีความน่าเชื่อถือสำหรับการทำงานระดับมืออาชีพ HydraFusion จึงถูกสร้างขึ้นบนหลักการดำเนินงาน 5 ประการ:
- การทำบัญชีที่สมบูรณ์ (Complete accounting): รวมต้นทุนทุกขั้นตอนตั้งแต่การร่างจนถึงแผนสำรอง
- การประมวลผลที่มีขอบเขต (Bounded execution): กำหนดเวลา Timeout และการยกเลิกงานที่ชัดเจนเพื่อคุมงบประมาณ
- การตรวจสอบแบบแยกส่วน (Isolated review): แยกส่วนการวิจารณ์ออกจากพื้นที่ทำงานหลักเพื่อป้องกันการแก้ไข Repository โดยไม่ตั้งใจ
- การปรับใช้แบบปลอดภัย (Fail-safe application): จะไม่มีการเขียนทับไฟล์ (Patch) หากเวิร์กโฟลว์ล้มเหลวหรือไม่ผ่านการตรวจสอบ
- การกำหนดเส้นทางที่ผ่านการตรวจสอบ (Validated routing): ตรวจสอบความพร้อมของโมเดลและแผนงานก่อนเริ่มประมวลผล
ระบบ Runtime ของเราจะบันทึกข้อมูลทุกขั้นตอน ทั้งผลลัพธ์ ต้นทุน และความหน่วง เพื่อให้นักพัฒนามองเห็นภาพรวมหลังจบการทำงาน แต่ในระหว่างการประมวลผล นักพัฒนาจะได้รับเพียงคำตอบเดียวที่ผ่านการตรวจสอบความถูกต้องแล้วอย่างราบรื่น
การแสดงความก้าวหน้าโดยไม่แสดงงานที่ยังไม่เสร็จ
ปัจจุบัน HydraFusion จะแสดงสถานะขั้นตอนการทำงาน แต่จะยังไม่แสดงร่างโค้ดจนกว่าจะได้ผลลัพธ์ที่สมบูรณ์ เนื่องจากร่างเหล่านั้นอาจถูกแก้ไขหรือยกเลิกได้ ซึ่งการแสดงผลแบบเรียลไทม์อาจทำให้เกิดความเข้าใจผิด อย่างไรก็ตาม เราได้รับฟังข้อเสนอแนะเรื่องทัศนวิสัยระหว่างรอ และกำลังเร่งพัฒนาระบบการอัปเดตความคืบหน้าที่ดีขึ้นในอนาคต
ผลลัพธ์จากการ Benchmark
เราประเมินผล HydraFusion ผ่าน Benchmark 3 รายการ ได้แก่ TerminalBench 2.1, DeepSWE และ CheckpointBench (ชุดทดสอบภายในจากสถานการณ์จริง) โดยใช้ Claude Opus 5 และ GPT-5.6 Sol เป็นเกณฑ์เปรียบเทียบ
| Benchmarks | ต้นทุน เทียบกับ Opus 5 | คุณภาพ เทียบกับ Opus 5 |
|---|---|---|
| TerminalBench 2.1 | ต่ำกว่า 67% | +4.9 จุด |
| DeepSWE | ต่ำกว่า 36% | -1.5 จุด |
| CheckpointBench | ต่ำกว่า 65% | -0.1 จุด |
ตารางที่ 1. คุณภาพและต้นทุนของ HydraFusion ในสาม benchmark แบบ agentic เทียบกับ Opus 5
สำหรับ DeepSWE ซึ่งเป็นงานวิศวกรรมซอฟต์แวร์ระดับ Repository ที่ยากเป็นพิเศษ HydraFusion มีคะแนนตามหลัง Opus 5 เพียงเล็กน้อย แต่ลดต้นทุนได้ถึง 36% ส่วนใน CheckpointBench ที่สะท้อนการใช้งานจริง HydraFusion ทำคะแนนได้ใกล้เคียงกับ Opus 5 อย่างมากโดยใช้ต้นทุนต่ำกว่าถึง 65%
จนถึงตอนนี้ ความสามารถในการใช้เหตุผลและการแก้ปัญหาของ HydraFusion อยู่ในระดับเดียวกับหรือดีกว่า Opus
Principal Software Engineer ที่ Microsoft
การพัฒนาอย่างต่อเนื่องของ HydraFusion
เราปรับปรุงนโยบายการตัดสินใจของ HydraFusion ผ่านเทคนิค Beam Search เพื่อหาเส้นทางที่ดีที่สุดแทนการตั้งค่าด้วยตนเอง โดยใช้ข้อมูลจาก CheckpointBench ที่คัดสรรมาจากเซสชันการเขียนโค้ดจริงของ Copilot เพื่อให้มั่นใจว่าการพัฒนาจะสอดคล้องกับการใช้งานจริงของนักพัฒนามากที่สุด
บันทึกการพัฒนาแสดงให้เห็นความก้าวหน้าที่มั่นคง โดยเฉพาะในช่วงปลายเดือนสิงหาคมที่ HydraFusion บรรลุจุดดำเนินงานที่แข็งแกร่งที่สุด ซึ่งการเรียนรู้นี้จะถูกขยายผลจาก Research Preview ไปสู่เวิร์กโฟลว์ในชีวิตจริงต่อไป
ร่วมทดสอบและก้าวต่อไป
ในช่วง Preview นี้ งานเขียนโค้ดแบบคำสั่งเดียว (Single-prompt) ที่มีขอบเขตชัดเจนคือจุดเริ่มต้นที่ดีที่สุดในการทดสอบประสิทธิภาพ เราต้องการเรียนรู้ว่าเวิร์กโฟลว์แบบผสม (Compound workflows) ส่งผลต่อการใช้งานจริงอย่างไร
คุณสามารถแบ่งปันประสบการณ์ผ่าน /feedback ใน Copilot CLI หรือร่วมพูดคุยได้ที่ GitHub Community discussion โดยเราเชื่อว่าก้าวต่อไปของ Coding Agents คือการเปลี่ยนจากการเลือกโมเดลที่ดีที่สุด ไปสู่การสร้างวิธีแก้ปัญหาที่ดีที่สุดแบบไดนามิก
กิตติกรรมประกาศ
ขอขอบคุณทีมวิจัยและวิศวกรจาก GitHub และ Microsoft รวมถึงทีม GitHub Copilot CLI, API และ VS Code ที่ร่วมกันผลักดันจนงานวิจัยชิ้นนี้เข้าสู่มือลูกค้าได้สำเร็จ
พบกับทีมงาน
 Aashna Garg, Principal Applied Scientist, Code AI
 Shengyu Fu, Partner Applied Science Manager, Code AI
 Carlos Castro, Partner Architect, GitHub Copilot
 Siddharth Singha Roy, Research Scientist II, Code AI
 Andy Salerno, Principal Software Engineer, GitHub Copilot
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร