
Ricursive AI เปิดตัว Ripple-65B โมเดล Open-Weight ประสิทธิภาพสูง
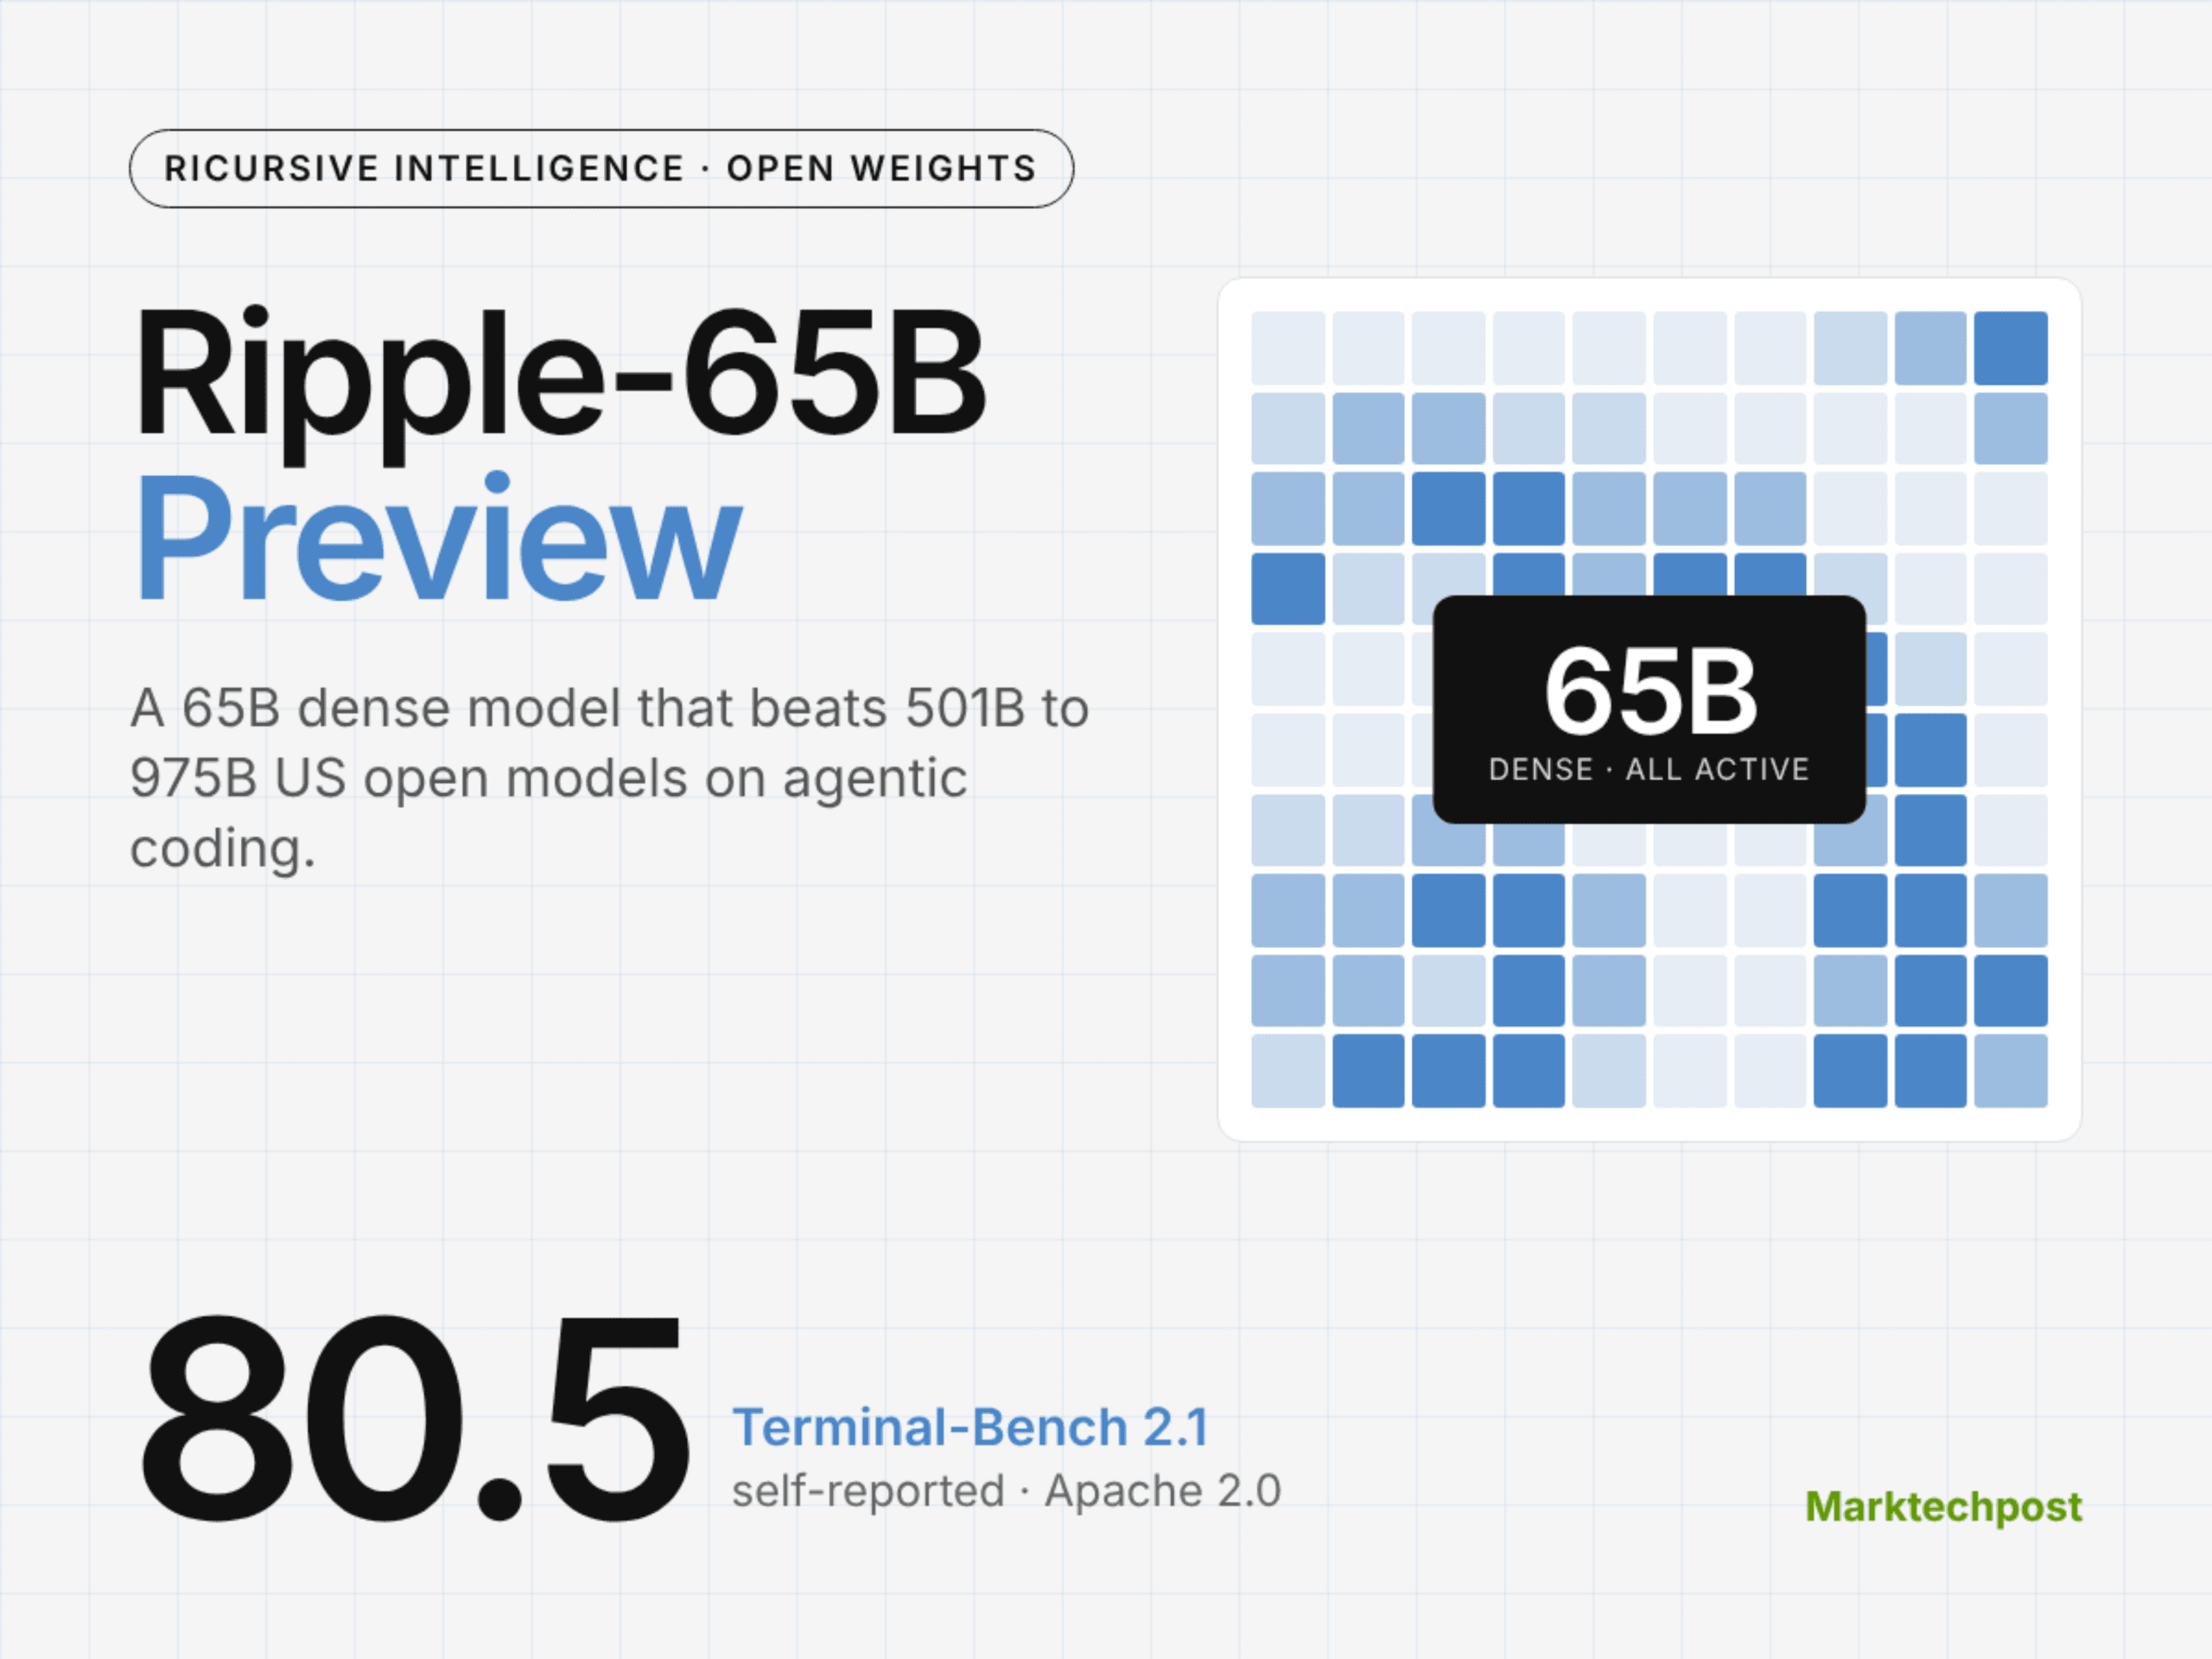
Ricursive Intelligence เพิ่งเปิดตัว Ripple-65B Preview ซึ่งเป็นโมเดลแบบ dense open-weight ขนาด 65B ที่ผ่านการ pretrain ใหม่ทั้งหมดเพื่อเน้นด้าน agentic coding โดยเฉพาะ โดยโมเดลนี้เป็นเวอร์ชันใช้งานทั่วไปของเทคโนโลยีเบื้องหลังแพลตฟอร์มออกแบบชิป AI ของบริษัท
จุดเด่นสำคัญคือการทำคะแนนได้ 80.52 บน Terminal-Bench 2.1 ซึ่งเป็นคะแนนที่รายงานด้วยตัวเอง (self-reported) สูงสุดในบรรดาโมเดล open-weight ของสหรัฐฯ โดยสามารถเอาชนะคู่แข่งที่เป็นโครงสร้างแบบ MoE ซึ่งมีพารามิเตอร์รวมตั้งแต่ 501B ถึง 975B ได้สำเร็จ
TL;DR
- ขนาด: 65B dense (65B active) ฝึกฝนบน 12T tokens รองรับ context สูงสุด 1M
- การใช้งาน: รันบน BF16 บน datacenter GPUs (ความเร็ว 250 tok/s บน 2x B200) ส่วนรุ่นทดลอง NVFP4 ออกแบบมาเพื่อ NVIDIA DGX Spark
- ประสิทธิภาพ: อยู่ในระดับ Frontier ในด้าน agentic coding เมื่อเทียบกับขนาดตัว แต่ยังตามหลังโมเดล MoE ขนาดใหญ่ในด้านความรู้ทั่วไปและ science coding
- คะแนนสูงสุด: Terminal-Bench 2.1 ได้ 80.5 (รายงานด้วยตัวเอง)
- คะแนนต่ำสุด: SciCode ได้ 39.4 ซึ่งต่ำที่สุดในบรรดา 5 โมเดลที่นำมาเปรียบเทียบ
Ripple-65B Preview คืออะไร?
การเปิดตัวครั้งนี้ประกอบด้วย 3 checkpoints ได้แก่ โมเดล BF16 ที่ผ่านการ instruction-tuned, เวอร์ชัน NVFP4 และโมเดลฐาน (base model) ทั้งหมดเผยแพร่ภายใต้สิทธิ์การใช้งาน Apache 2.0 โดยใช้คลังข้อมูลภาษาอังกฤษและโค้ดเป็นหลักในการฝึกฝน
ทีม Ricursive ระบุว่าต้นทุน R&D ทั้งหมดอยู่ที่ 32 ล้านดอลลาร์ ครอบคลุมทั้งการทดลองแบบ ladder, การผสมข้อมูล (data mixing), การประเมินผล และการสร้างข้อมูลสังเคราะห์ (synthetic data) ซึ่งประเมินว่าเป็นเพียง 1 ใน 10 ของต้นทุนเมื่อเทียบกับผู้นำด้าน agentic coding แบบ open-weight รายก่อนหน้า
สถาปัตยกรรมทำงานอย่างไร?
Ricursive เลือกใช้ Transformer แบบ dense แทน Mixture-of-Experts เพื่อลดความซับซ้อนของโครงสร้างพื้นฐาน โดยรักษาค่า MFU ไว้ที่ 40% ผ่านการทำ simple sharding โดยไม่มี custom kernels หรือการทำ quantization ในขั้นตอนการฝึก
ตัวโมเดลมีลักษณะ "บางและลึก" ด้วย d_model ขนาด 5120 ครอบคลุม 80 เลเยอร์ โดยเปลี่ยนจากเลย์เอาต์แบบ Llama ของ Olmo 3 มาเป็นดีไซน์แบบ Gemma 3N เพื่อความเสถียร นอกจากนี้ยังมีการจัดสรร attention heads มากเกินความจำเป็น (Overprovisioned) เพื่อเพิ่มประสิทธิภาพการใช้เหตุผล และใช้เทคนิค FFN activation clipping ร่วมด้วย
กระบวนการ Post-training
ขั้นตอน post-training ประกอบด้วย midtraining, long context, SFT และ mixed RL โดยในส่วนของ long-context มีการฝึกฝนที่ sequence length ระดับ 2M ทั้งนี้ Ricursive ไม่ได้ซื้อข้อมูลภายนอกเลย แต่ใช้การสร้าง pipeline ข้อมูลสังเคราะห์ของตัวเองทั้งหมด
ทีมงานยังได้รันการทดสอบ Terminal-Bench 2.1 ซ้ำด้วย harness ของ Terminus 2 อย่างเป็นทางการที่ 128K ซึ่งพบว่าคู่แข่งส่วนใหญ่คะแนนตกลง เช่น Beam ลดลงเหลือ 70.8 ขณะที่ Ripple ยังคงรักษามาตรฐานที่ 80.5 ไว้ได้
ตารางเปรียบเทียบ
| คุณสมบัติ | Ripple-65B Preview | Reflection Beam | Meta Muse Spark Open | Thinking Machines Inkling | NVIDIA Nemotron 3 Ultra |
|---|---|---|---|---|---|
| Architecture | Dense | MoE | MoE | MoE | Hybrid Mamba-2 LatentMoE |
| Total params | 65B | 501B | 816B | 975B | 550B |
| Active params | 65B | 23B | 42B | 41B | 55B |
| Pretraining tokens | 12T | 23.8T | ไม่เปิดเผย | 45T | ~20T |
| Context | สูงสุด 1M | 1M | 1M | 1M | สูงสุด 1M |
| License | Apache 2.0 | Apache 2.0 | Muse Model License | Apache 2.0 | OpenMDW-1.1 |
| Terminal-Bench 2.1 | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Verified | 76.5 | 80.9 | ไม่เปิดเผย | 77.6 | 70.7 |
| GPQA Diamond | 85.2 | ไม่เปิดเผย | 89.0 | 87.2 | 87.0 |
ช่องทางการใช้งาน
นักพัฒนาสามารถดาวน์โหลด Weights ได้ทาง Hugging Face โดยมีผู้ให้บริการอย่าง Together AI, GMI Cloud และ OpenRouter พร้อมรองรับในช่วงเปิดตัว ส่วน Fireworks จะตามมาในภายหลัง
สำหรับการรันบนอุปกรณ์ท้องถิ่น (Local) รุ่น NVFP4 ถูกวางตำแหน่งให้ใช้งานกับฮาร์ดแวร์ระดับ NVIDIA DGX Spark โดยมีการทำ quantization เฉพาะในเลเยอร์ MLP และคง attention ไว้ในรูปแบบ BF16 เพื่อประสิทธิภาพสูงสุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร