
เปลี่ยน Qwen3.8-27B เป็น Local AI Coding Agent ส่วนตัว ง่ายๆ ด้วยคำสั่งเพียง 3 บรรทัด
การรันโมเดลระดับ 27B ที่มีความสามารถสูงในฐานะ local AI coding agent เคยเป็นเรื่องยุ่งยากที่ต้องตั้งค่าทั้ง inference server, กำหนดค่า endpoint และเชื่อมต่อระบบทุกอย่างด้วยตัวเอง แต่ด้วยการมาถึงของ Qwen3.8-27B, Ollama และ OpenCode ทำให้กระบวนการนี้กลายเป็นเรื่องง่ายอย่างน่าทึ่ง
Qwen3.8-27B เป็นหนึ่งในโมเดลแบบ local ที่น่าจับตามองที่สุด ด้วยความสามารถที่แข็งแกร่งทั้งด้านการเขียนโค้ด (coding), การใช้เหตุผล (reasoning), การใช้งานเครื่องมือ (tool use) ไปจนถึงงานแบบ Agent ระยะยาว (long-horizon agentic tasks) ซึ่งตอบโจทย์การทำงานกับโปรเจกต์ที่ซับซ้อนและฐานข้อมูลโค้ดขนาดใหญ่ภายในเครื่อง
ในคู่มือนี้ เราจะเปลี่ยน Qwen3.8-27B ให้กลายเป็น local AI coding agent โดยใช้เพียง 3 คำสั่งในเทอร์มินัล เริ่มตั้งแต่การติดตั้ง Ollama, ดาวน์โหลดโมเดล ไปจนถึงการเปิดใช้งานผ่าน OpenCode พร้อมวิธีตรวจสอบการทำงานบน GPU ของคุณ
ก่อนที่คุณจะเริ่ม: ตรวจสอบฮาร์ดแวร์ของคุณ เนื่องจาก Qwen3.8-27B เป็นโมเดลขนาดใหญ่ คุณควรตรวจสอบให้แน่ใจก่อนว่าเครื่องของคุณมีทรัพยากรเพียงพอ สำหรับผู้ใช้งานบน Linux หรือ Windows ที่ติดตั้งไดรเวอร์ NVIDIA สามารถรันคำสั่งเพื่อตรวจสอบได้ดังนี้:
nvidia-smi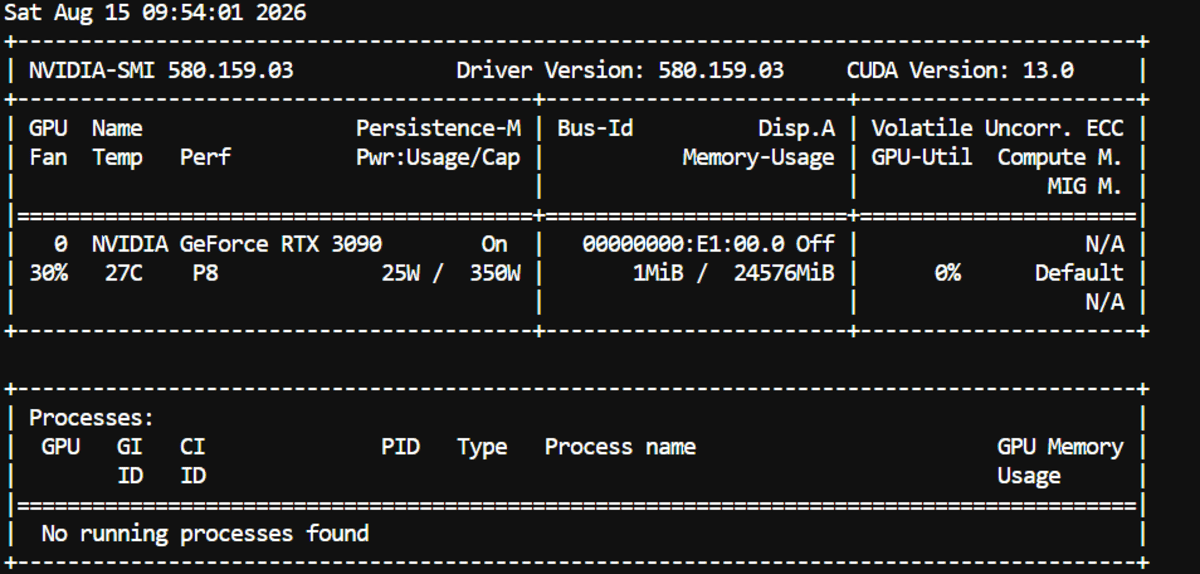
ในคู่มือนี้เราใช้การ์ดจอ RTX 3090 พร้อม VRAM 24 GB โดยตัวโมเดล Qwen3.8-27B บน Ollama มีขนาดประมาณ 18 GB จึงสามารถบรรจุลงใน GPU ได้ทั้งหมด และยังเหลือพื้นที่ VRAM บางส่วนสำหรับ context และ runtime overhead
ตามหลักการทั่วไป VRAM 24 GB คือสเปกเป้าหมายที่เหมาะสม หากคุณต้องการรันโมเดลบน GPU ทั้งหมด แต่หากหน่วยความจำไม่เพียงพอ Ollama จะใช้วิธีแบ่งการทำงานระหว่าง GPU VRAM และ RAM ของระบบ แทน ซึ่งจะช่วยให้ยังทำงานได้แต่อาจมีความเร็วที่ลดลง ทั้งนี้แนะนำว่าควรมี System RAM อย่างน้อย 32 GB เพื่อรองรับการถ่ายโอนข้อมูลในส่วนนี้
รัน Qwen3.8-27B ในเพียง 3 คำสั่ง
เมื่อเตรียมฮาร์ดแวร์พร้อมแล้ว เราจะเริ่มกระบวนการติดตั้งและเปิดใช้งานผ่านเทอร์มินัลด้วย 3 ขั้นตอนง่ายๆ ดังนี้
1. การติดตั้ง Ollama
ขั้นแรก ให้ทำการติดตั้งโปรแกรม Ollama ซึ่งจะทำหน้าที่เป็นหัวใจหลักในการดาวน์โหลดและรันโมเดลภายในเครื่อง
curl -fsSL https://ollama.com/install.sh | sh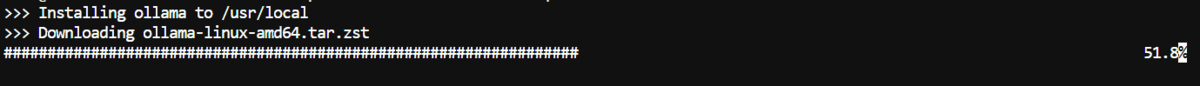
2. เริ่มการทำงาน Ollama และดาวน์โหลด Qwen3.8-27B
จากนั้น ให้สั่งเริ่มทำงาน Ollama server ในแบบเบื้องหลัง (background) พร้อมกับสั่งดาวน์โหลดโมเดล Qwen3.8-27B มาไว้ในเครื่อง
ollama serve & ollama pull qwen3.8:27b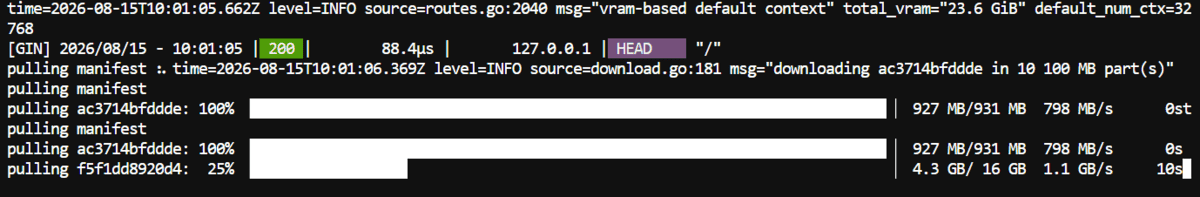
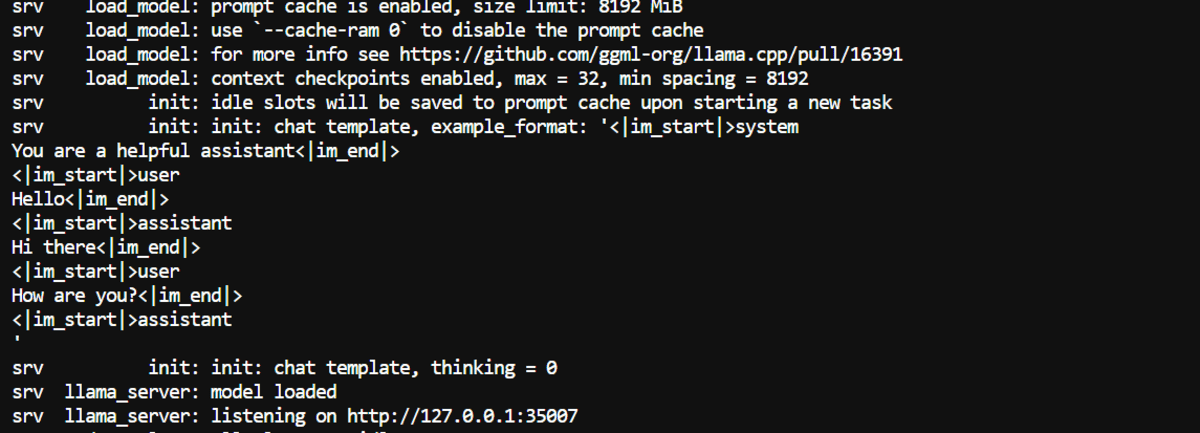
คำสั่งนี้จะทำการเปิด local server และดาวน์โหลดไฟล์โมเดลที่จำเป็น ให้เปิดหน้าต่างเทอร์มินัลนี้ทิ้งไว้เพื่อคอยดู server logs ในขณะที่โมเดลเริ่มทำงาน
3. เปิดใช้งาน Qwen3.8-27B ใน OpenCode
เปิด เทอร์มินัลหน้าต่างใหม่ แล้วใช้คำสั่งเพื่อรัน OpenCode โดยกำหนดให้ใช้โมเดล Qwen3.8-27B ที่เตรียมไว้
ollama launch opencode --model qwen3.8:27b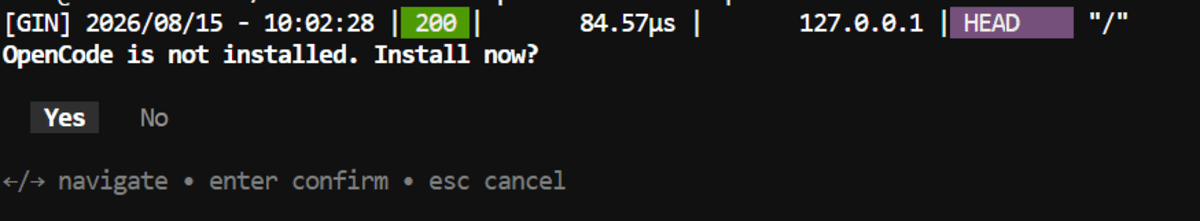
หากคุณยังไม่ได้ติดตั้ง OpenCode ระบบของ Ollama จะแจ้งเตือนและให้คุณทำการติดตั้งก่อน เมื่อเสร็จสิ้น OpenCode TUI จะปรากฏขึ้นพร้อมกับโมเดล Qwen3.8-27B ที่พร้อมรับคำสั่งเขียนโค้ดได้ทันที
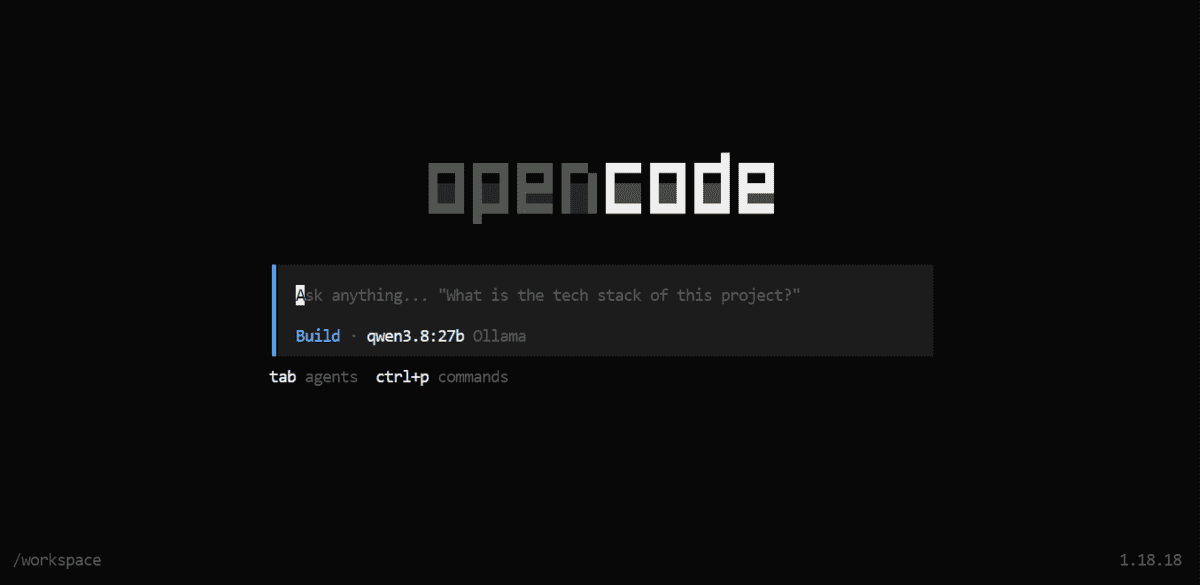
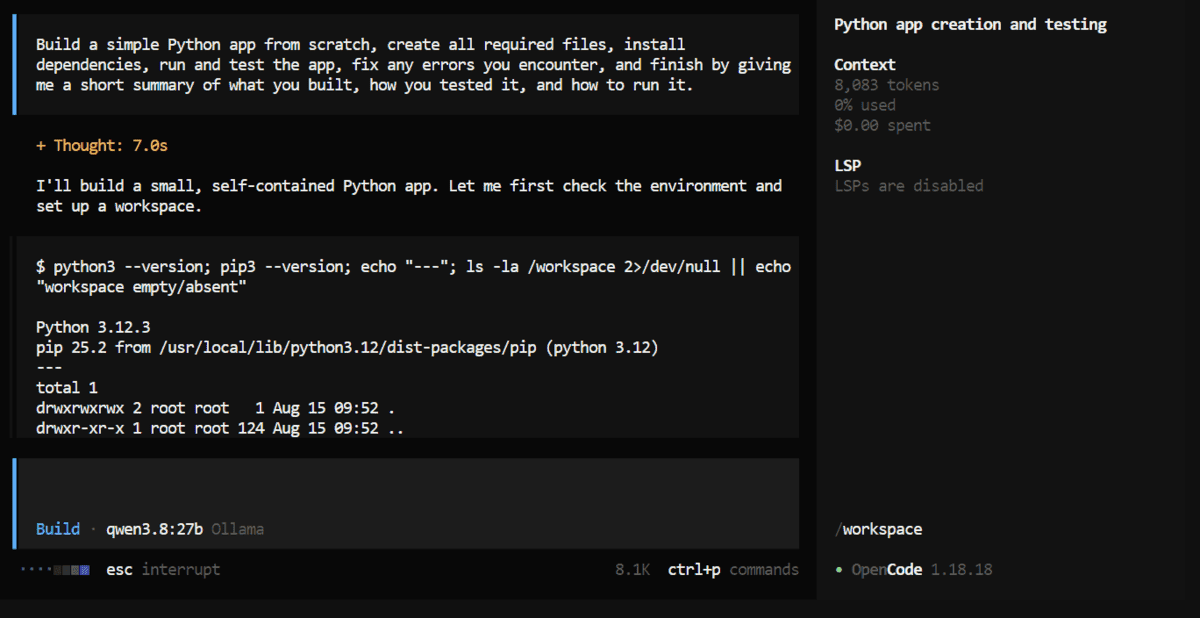
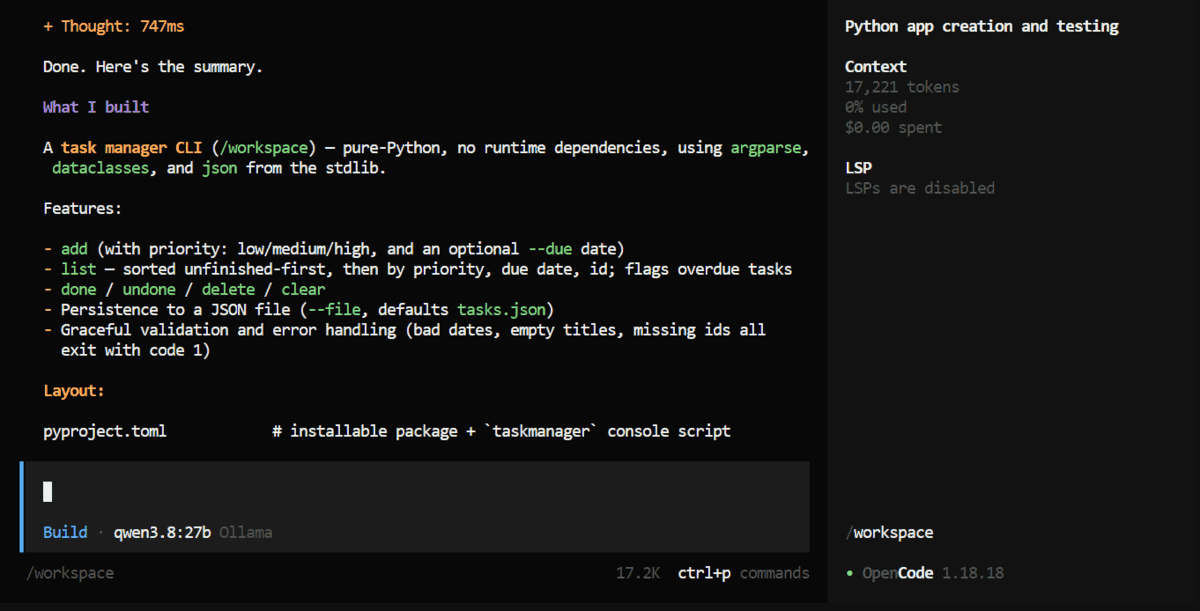
จากการทดสอบด้วยการสั่งให้สร้างแอปพลิเคชัน Python โมเดลอาจใช้เวลาโหลดเข้าหน่วยความจำในครั้งแรกนานเล็กน้อย ซึ่งสังเกตสถานะได้จากเทอร์มินัลแรกที่เปิดทิ้งไว้ แต่เมื่อโหลดเสร็จแล้ว ความเร็วในการสร้างโค้ดถือว่าทำได้น่าประทับใจมาก
ผลการทดสอบพบว่ามันสามารถสร้างแอปพลิเคชัน ทดสอบระบบ และส่งคืนสรุปโปรเจกต์อย่างละเอียดได้ภายในเวลา ไม่ถึง 2 นาที โดยมี Ollama คอยบริหารจัดการโมเดลและ OpenCode เป็นสภาพแวดล้อมการทำงานแบบ Agent ให้กับคุณ
บทสรุป
แม้ว่าผู้เชี่ยวชาญบางส่วนอาจจะนิยมใช้ llama.cpp เนื่องจากให้การควบคุมที่ละเอียดกว่า ทั้งเรื่องการจูนประสิทธิภาพและการทำ quantization แต่สำหรับ ผู้เริ่มต้นหรือผู้ใช้ทั่วไป ที่ต้องการความสะดวก วิธีนี้คือคำตอบที่ดีที่สุด
ด้วยคำสั่งเพียง 3 บรรทัด คุณก็สามารถมี Local AI Coding Agent ที่ทรงพลังพร้อมใช้งานได้ทันทีในเวลาไม่กี่นาที โดยไม่ต้องวุ่นวายกับการ build source code หรือจัดการคำสั่ง command-line ที่ซับซ้อนให้ปวดหัว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร