
ความปลอดภัยของ LLM: ทำไมการปฏิเสธแบบเหมาเข่งจึงไม่ใช่คำตอบที่ถูกต้อง
งานวิจัยด้านการจัดตำแหน่งความปลอดภัย (Safety alignment) ส่วนใหญ่มักมองว่าอันตรายเป็นคุณสมบัติของหัวข้อ โดยพรอมต์ (prompt) หนึ่งจะถูกตัดสินว่าไม่ปลอดภัยหากจัดอยู่ในหมวดหมู่ทั่วไป เช่น อาวุธ การฉ้อโกง หรือการทำร้ายตัวเอง ซึ่งโมเดลเฝ้าระวังอย่าง LlamaGuard-3 ก็ใช้การจำแนกประเภทในระดับหัวข้อแบบนี้เช่นกัน
อย่างไรก็ตาม เกณฑ์วัดมาตรฐานอย่าง XSTest และ OR-Bench เริ่มพบปัญหาความล้มเหลวที่เรียกว่าการปฏิเสธเกินขอบเขต (Over-refusal) คือโมเดลปฏิเสธพรอมต์ที่ปลอดภัยเพียงเพราะมีคำที่ดูอันตรายปนอยู่ ทำให้มีความพยายามในงานด้านการปรับเทียบการปฏิเสธ (refusal-calibration) เพื่อดึงตัวเลขการปฏิเสธที่ผิดพลาดนี้ให้ลดลง
ในการนำไปใช้งานจริง สภาพแวดล้อมที่ต่างกันต้องการขอบเขตความปลอดภัยที่ไม่เหมือนกัน เช่น ติวเตอร์วิชาหน้าที่พลเมืองและผู้ช่วยภาครัฐอาจใช้โมเดลตัวเดียวกัน แต่มีบรรทัดฐานเรื่องการเมืองต่างกัน ทั้งคู่ควรตอบคำถามข้อเท็จจริงเกี่ยวกับการเลือกตั้งได้ แต่มีเพียงตัวเดียวเท่านั้นที่ควรปฏิเสธการเขียนเนื้อหาปั่นหัวทางการเมือง ซึ่งตัวเฝ้าระวังระดับหัวข้ออย่าง LlamaGuard-3 ไม่สามารถแยกแยะความต่างนี้ได้ และมักจะคัดออกทั้งข้อมูลที่ผิดและข้อมูลที่เป็นข้อเท็จจริงไปพร้อมกัน
บทความวิจัยล่าสุดของเรา Safety for Whom? Boundary-Aware Self-Distillation for Controlled LLM Safety Refusal จึงมุ่งศึกษาปัญหาที่แคบลงนี้ โดยเปลี่ยนคำถามจากการปฏิเสธทั้งหัวข้อ เป็นการระบุว่าส่วนย่อยใดของหัวข้อที่ไม่เข้ากับนโยบายการใช้งาน และจะฝึกฝนรวมถึงวัดผลโมเดลเทียบกับขอบเขตนั้นได้อย่างไร
Narrow-boundary safety: นิยามความปลอดภัยในขอบเขตที่แคบลง
เรากำหนดรูปแบบนี้เป็นจักรวาลของหัวข้อ (topic universe) เช่น พรอมต์ทางการเมืองทั้งหมด ซึ่งจะมีส่วนย่อยที่เป็นอันตรายที่ควรปฏิเสธ พฤติกรรมในอุดมคติคือ "ขั้นบันไดที่ชัดเจน" นั่นคือโมเดลต้องปฏิเสธเฉพาะส่วนที่เป็นอันตราย และตอบคำถามในส่วนอื่นที่ไม่มีพิษมีภัยของหัวข้อเดียวกันให้ได้
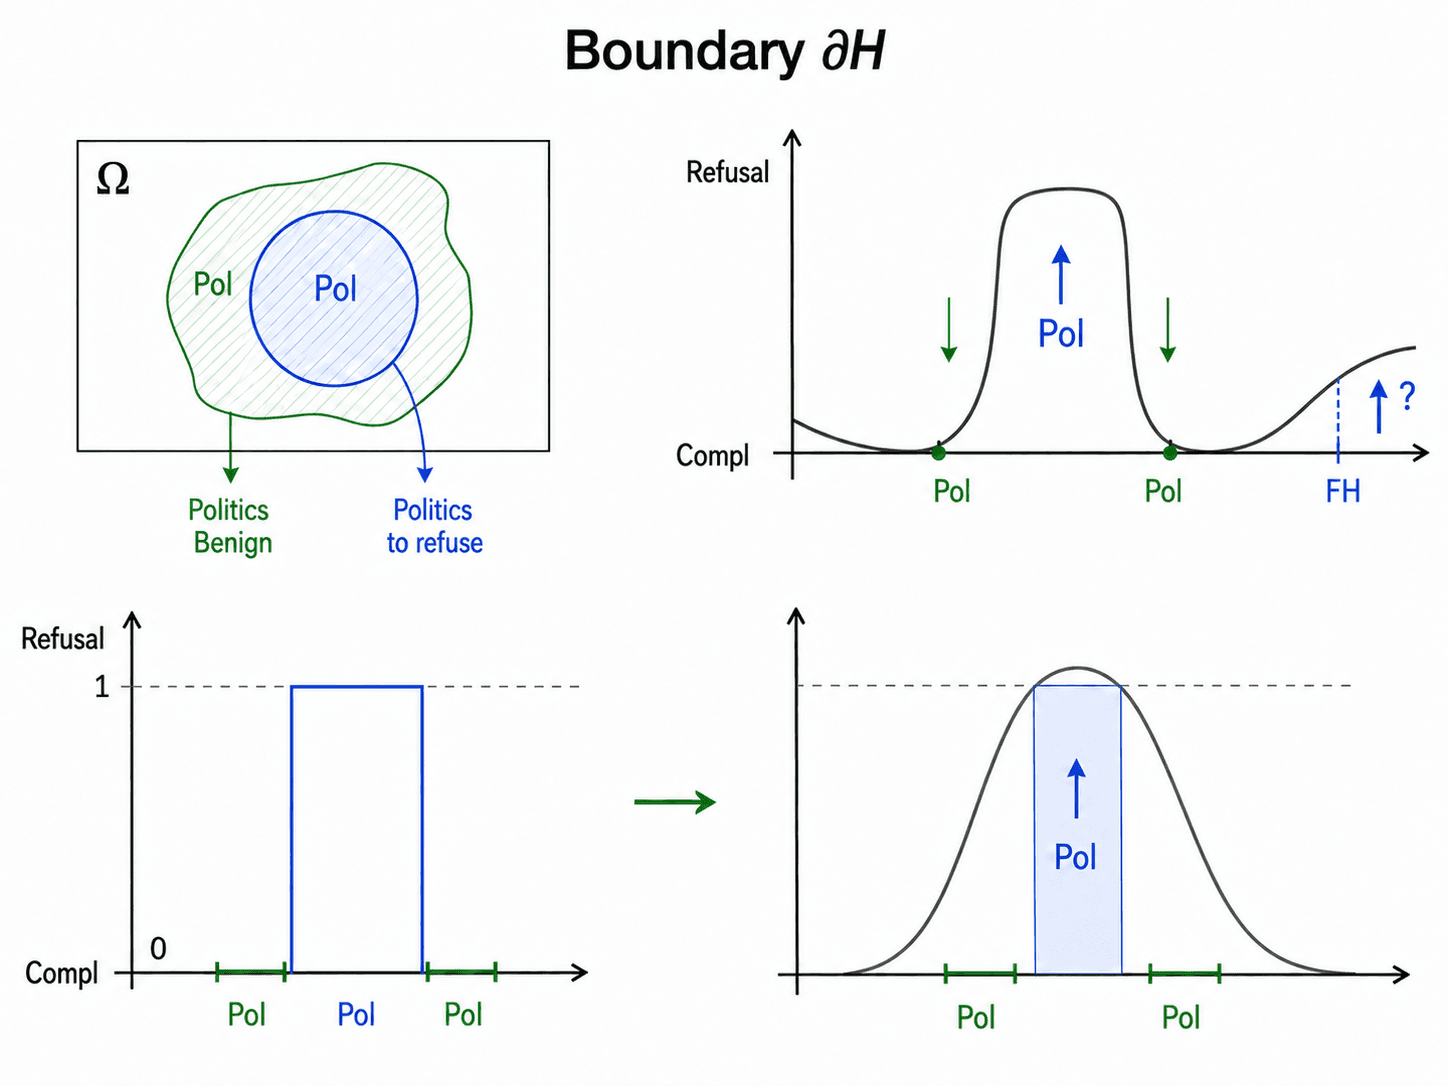
การตั้งค่าขอบเขตที่แคบ การนำไปใช้งานจริงอาจจำเป็นต้องปฏิเสธเฉพาะพรอมต์ทางการเมืองที่ขอให้มีการปั่นหัวหรือการโน้มน้าวใจแบบเจาะจงเป้าหมาย ในขณะที่ยังคงตอบพรอมต์ทางการเมืองอื่นๆ แทนที่จะปฏิเสธเรื่องการเมืองทั้งหมด การปฏิเสธของโมเดลที่ผ่านการฝึกฝนจะมีความต่อเนื่องมากกว่าการแยกส่วนในอุดมคติ และสามารถล้นเข้าไปในอาณาเขตที่ไม่มีพิษมีภัยใกล้กับขอบเขตได้ ที่มา: รูปที่ 1 ในบทความวิจัย
ในความเป็นจริง โมเดลไม่สามารถเรียนรู้ขั้นบันไดที่คมชัดได้ แต่มันเรียนรู้ผ่านความน่าจะเป็น ซึ่งมักจะทำให้การปฏิเสธล้นไปยังส่วนที่ปลอดภัย เราจึงใช้คู่ของพรอมต์ที่มีหัวข้อหลักเดียวกันแต่ต่างกันที่เจตนามาเป็นตัวกำหนดขอบเขต เช่น การใช้เรื่องการโน้มน้าวใจทางการเมืองเป็นสนามทดสอบ เพราะการปั่นหัวนั้นอันตราย แต่ข้อมูลข้อเท็จจริงทางการเมืองเป็นเรื่องที่ยอมรับได้
จุดอ่อนของการปรับจูนความปลอดภัยแบบเดิม
การสร้างข้อมูลฝึกฝนด้วยตนเอง (self-generation) แบบเดิมมีจุดอ่อน 3 ประการเมื่อต้องรับมือกับขอบเขตที่ละเอียดอ่อน ประการแรกคือช่องว่างของการครอบคลุม (coverage gap) โดยการสร้างข้อมูลแบบครั้งเดียวมักทิ้งพรอมต์ที่ยากไปถึง 19.88% เราจึงใช้กลยุทธ์การลองใหม่แบบยกระดับ (escalating retry strategy) จนลดความล้มเหลวลงเหลือเพียง 0.20% ทำให้รักษาพรอมต์ฝึกฝนที่เป็นอันตรายไว้ได้มากขึ้น
ประการที่สองคือปฏิกิริยาด้านลบ (downside reactions) ที่ทำให้เกิดการปฏิเสธผิดพลาดในเรื่องที่ดูอันตรายเพียงผิวเผิน เราจึงสร้างข้อมูลที่ไม่มีพิษมีภัยในระดับการกระจายตัวเดียวกัน (in-distribution) จำนวน 11,955 รายการ เพื่อให้โมเดลแยกแยะคำที่ดูน่ากลัวแต่ปลอดภัยได้ในระหว่างการฝึกฝน
ประการที่สามคือการประเมินแบบแยกส่วนทั่วไปไม่สามารถวัดรูปทรงของขอบเขตได้ โมเดลอาจดูเหมือนปลอดภัยขึ้นเพียงเพราะมันปฏิเสธมั่วซั่วไปยังพรอมต์ข้างเคียง เราจึงใช้ชุดคู่ข้อมูลที่เป็นอันตรายและไม่มีพิษมีภัยจำนวน 1,539 คู่ เพื่อวัดผลกระทบทั้งสองด้านของขอบเขตโดยตรง
การแลกเปลี่ยนที่ต้องระวังและกับดักที่ซ่อนอยู่
จากการทดสอบกับโมเดล Qwen3-8B พบว่าโมเดลที่ผ่านการฝึกแบบยกระดับการครอบคลุมสามารถเพิ่มการปฏิเสธเรื่องการเมืองที่เป็นอันตรายจาก 9.47% เป็น 84.75% และลดอัตราการตอบกลับที่ไม่ปลอดภัยในเกณฑ์วัดอย่าง HarmBench, StrongREJECT และ WildJailbreak จนเกือบเป็นศูนย์
อย่างไรก็ตาม หากดูเพียงตัวเลขความปลอดภัยจะเหมือนเป็นชัยชนะ แต่ในความจริงการปฏิเสธเกินขอบเขต (over-refusal) ใน XSTest พุ่งสูงขึ้นจาก 2.00% เป็น 74.00% ซึ่งหมายความว่าโมเดลกลายเป็นเครื่องจักรที่ขยันปฏิเสธทุกอย่างจนใช้งานจริงไม่ได้ การรายงานผลความปลอดภัยจึงต้องทำควบคู่ไปกับการวัดอัตราการปฏิเสธเกินขอบเขตเสมอ
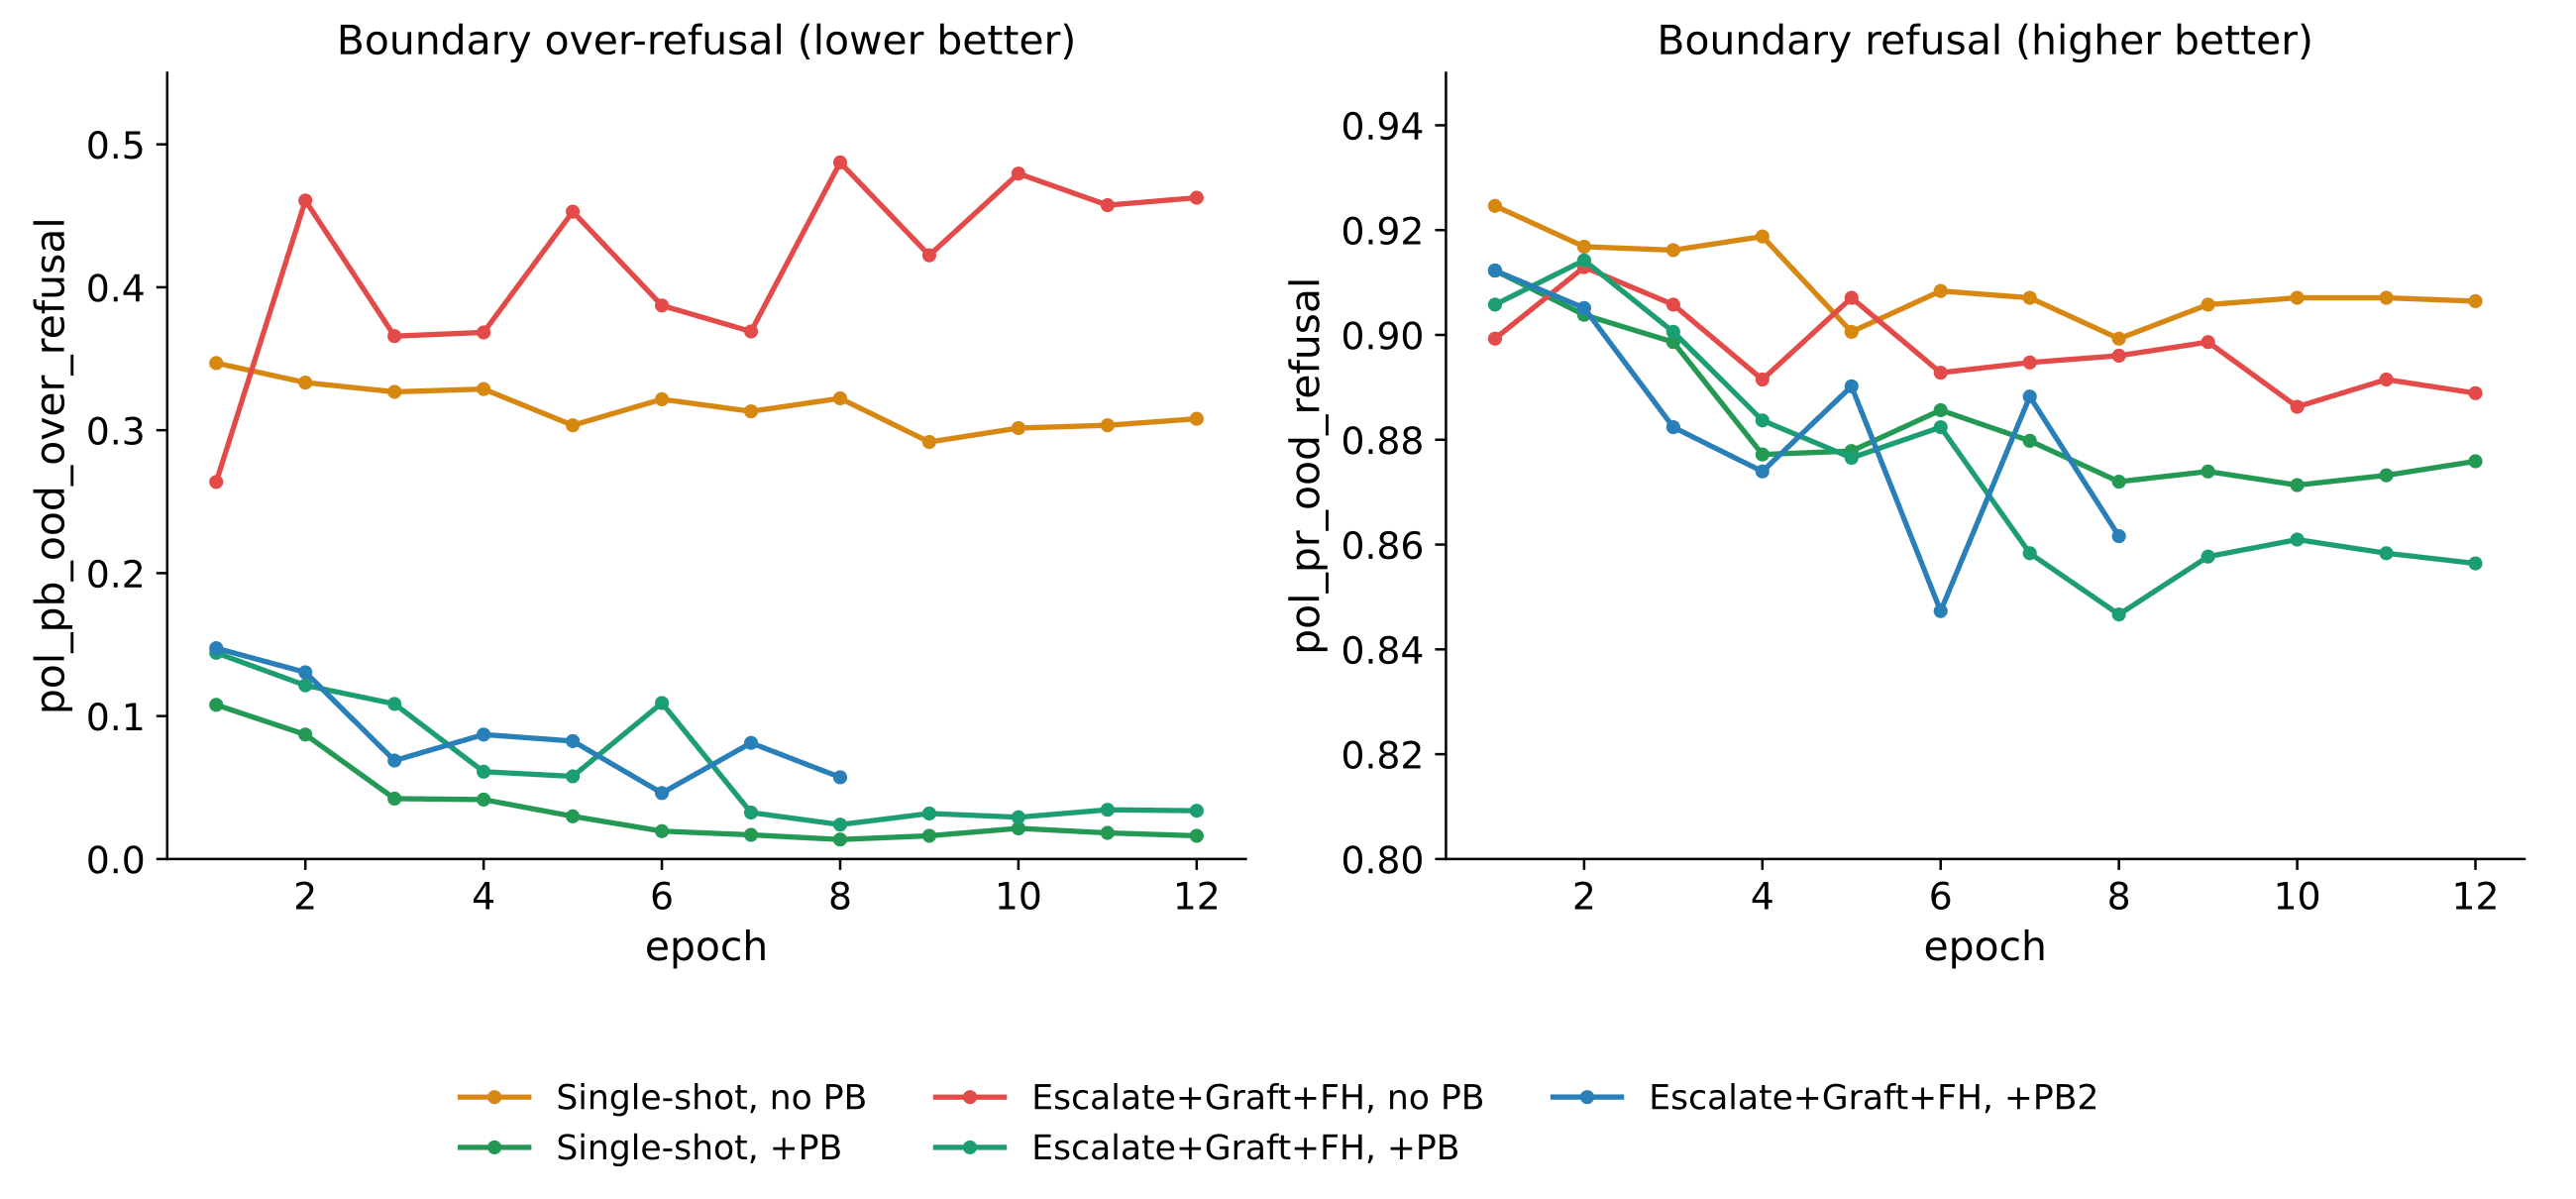
ซ้าย: การปฏิเสธเกินขอบเขตในฝั่งที่ควรตอบกลับของคู่ข้อมูลขอบเขต ยิ่งต่ำยิ่งดี การทดสอบที่มีข้อมูลขอบเขตไม่มีพิษมีภัย (PB) ลดลงเหลือ 0.03 ถึง 0.08 หากไม่มีมัน ตัวเลขจะพุ่งสูงไปที่ 0.49 ขวา: การปฏิเสธในฝั่งที่เป็นอันตราย ยิ่งสูงยิ่งดี ซึ่งลดลงเพียงเล็กน้อย ที่มา: รูปที่ 6 ในบทความวิจัย
ข้อมูลขอบเขตที่ไม่มีพิษมีภัยของเราช่วยลดการปฏิเสธที่ผิดพลาดจาก 32.94% เหลือเพียง 4.16% โดยที่ยังคงรักษาการปฏิเสธสิ่งที่อันตรายไว้ได้เกือบทั้งหมด (ลดลงจาก 91.88% เป็น 87.72%) ซึ่งแสดงให้เห็นว่าการวัดผลและปรับจูนทั้งสองด้านของขอบเขตเป็นกุญแจสำคัญในการสร้างโมเดลที่ทั้งปลอดภัยและมีประโยชน์
บทสรุปและการนำไปใช้
การวิจัยจาก Multiverse Computing ชี้ให้เห็นว่าการปรับจูนความปลอดภัยไม่ควรวัดแค่ว่าปฏิเสธได้มากเท่าไหร่ เพราะโมเดลที่ปฏิเสธเก่งไม่ได้แปลว่าปลอดภัยกว่าเสมอไป องค์ประกอบของข้อมูลฝึกฝนและการประเมินขอบเขตที่ตั้งใจไว้คือสิ่งที่จะทำให้ AI มีพฤติกรรมที่ควบคุมได้และตอบโจทย์การใช้งานจริง
สำหรับผู้ที่ต้องการรายละเอียดทางเทคนิค เช่น กลยุทธ์การซ่อมแซมการครอบคลุม หรือการกำหนดทิศทางความสูญเสีย (loss routing) สามารถอ่านบทความวิจัยฉบับเต็มเพื่อศึกษาผลการประเมินที่สมบูรณ์ยิ่งขึ้นได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร