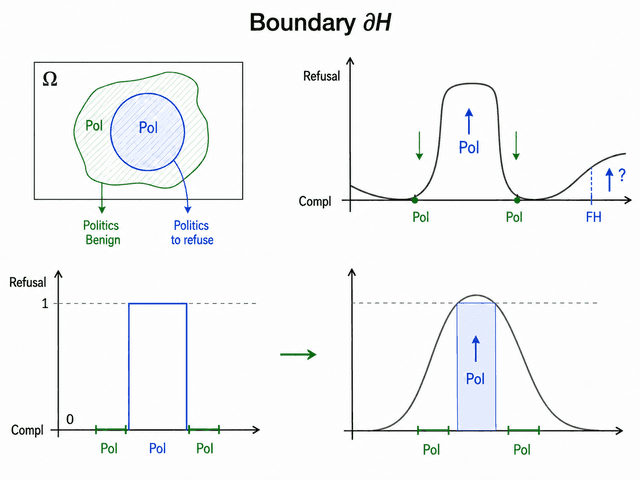
ความปลอดภัยของ LLM: ทำไมการปฏิเสธแบบเหมาเข่งจึงไม่ใช่คำตอบที่ถูกต้องtag: LlamaGuard-3, LLM, Multiverse Computing, Qwen3-8B, Safety AlignmentSep 8, 2026 · By: SirilukPงานวิจัยใหม่เสนอแนวทาง Narrow-boundary safety เพื่อแก้ปัญหาโมเดล AI ปฏิเสธการตอบคำถามที่ปลอดภัยเพียงเพราะมีคำที่ดูอันตรายปนอยู่ โดยเน้นการกำหนดขอบเขตความปลอดภัยให้แม่นยำตามเจตนาของผู้ใช้แทนการบล็อกทั้งหัวข้อ