
สรุปสถานะ Open Model ปี 2026: เมื่อค่ายจีนและฮาร์ดแวร์ก้าวขึ้นเป็นผู้นำรายใหม่
ในโลกของ AI เวลาดูเหมือนจะถูกบีบอัดให้สั้นลง เพียงไม่กี่เดือนหลังจาก spring report ของเรา การวิเคราะห์ระบบนิเวศในช่วงครึ่งปีแรกจนถึงฤดูร้อนปี 2026 ได้เผยให้เห็นความเปลี่ยนแปลงที่น่าสนใจหลายประการ รายงานฉบับนี้สรุปข้อสังเกตตั้งแต่เดือนมกราคมถึงสิงหาคม 2026 พร้อมเจาะลึกข้อมูลเบื้องหลังของแต่ละประเด็น
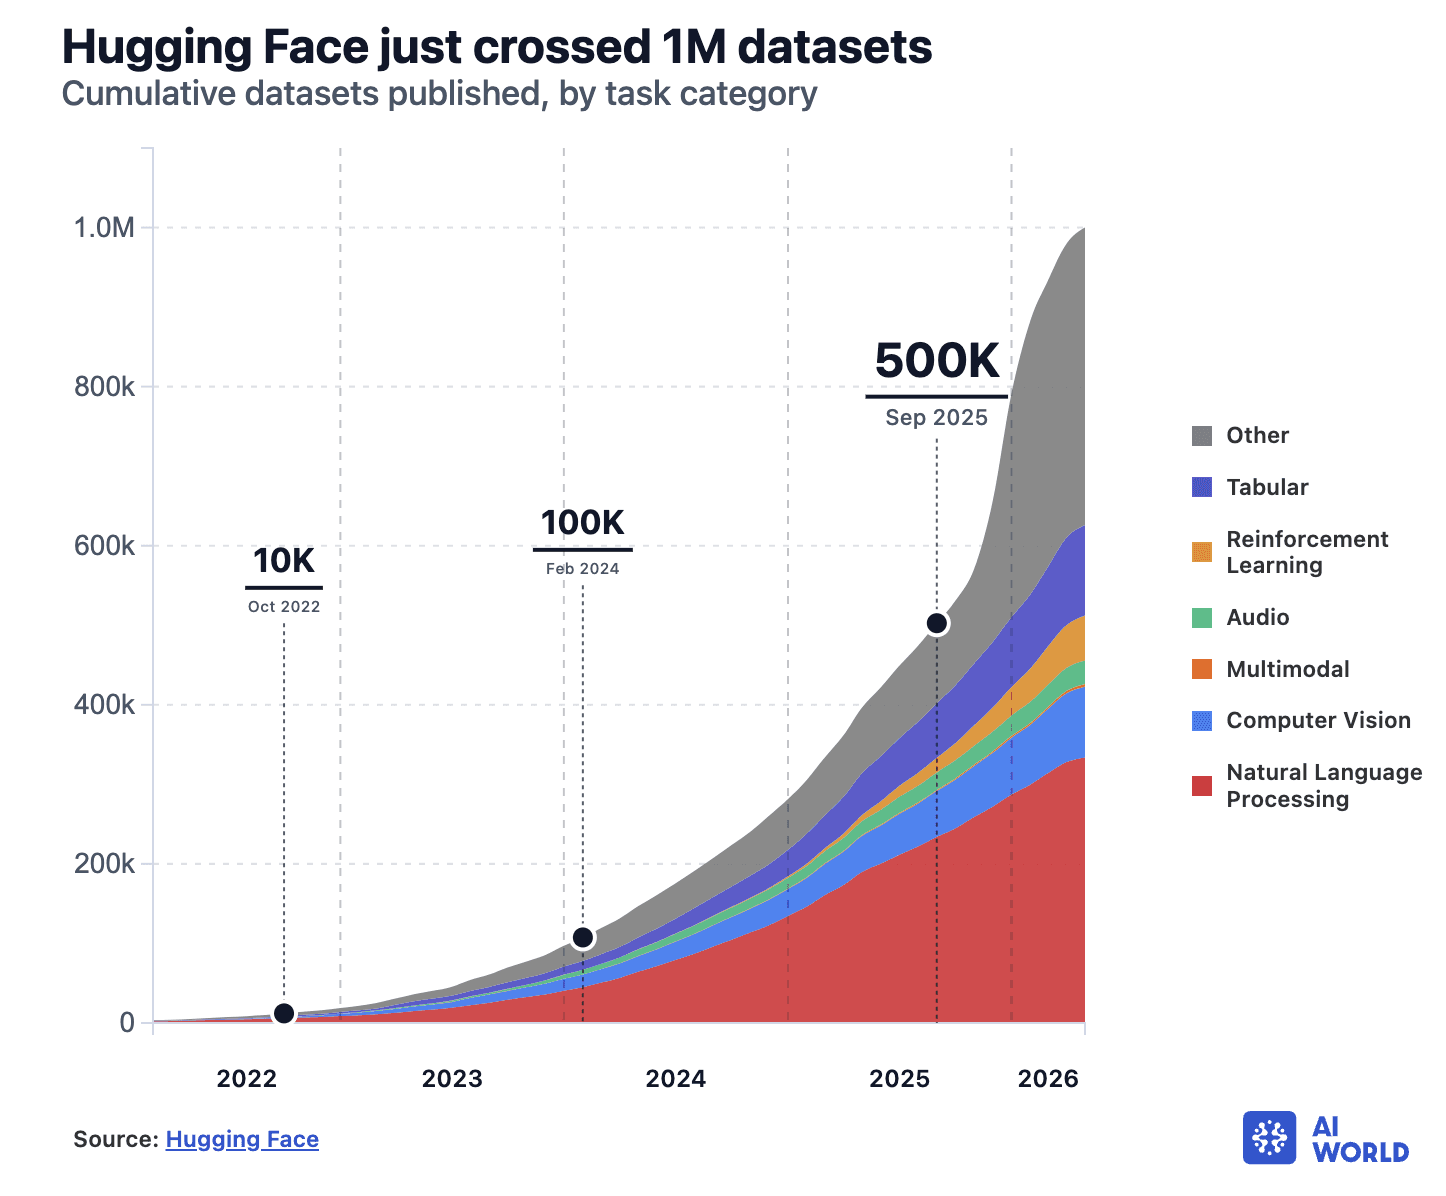
โมเดลและชุดข้อมูลบน Hugging Face (HF) Hub เติบโตขึ้นอย่างก้าวกระโดดในทุกๆ วัน โดยคลังโมเดลสาธารณะ (Public model repositories) เพิ่มขึ้นจาก 2.43 เป็น 2.96 ล้านชุด ชุดข้อมูลเพิ่มจาก 7.11 แสนเป็น 1 ล้านชุด และ Spaces เพิ่มจาก 1.00 เป็น 1.44 ล้านชุด อย่างไรก็ตาม การกระจายตัวยังคงมีความสุดโต่ง โดยโมเดลกว่า 85.6% มียอดดาวน์โหลดรวมไม่ถึง 200 ครั้ง ในขณะที่คลังข้อมูลเพียง 1.5% กลับครองยอดดาวน์โหลดทั้งหมดสูงถึง 99.2%
1. พรมแดนเทคโนโลยีที่เคลื่อนที่อย่างรวดเร็ว
ในอดีต ความก้าวหน้าของ AI มักมีเส้นทางที่ชัดเจน เริ่มจากการปล่อยโมเดลขนาดเล็กแล้วค่อยๆ ไต่ระดับไปสู่ขนาดใหญ่ แต่ในปี 2026 แล็บจากจีนหลายแห่งได้ก้าวข้ามขั้นตอนดังกล่าวไปโดยสิ้นเชิง
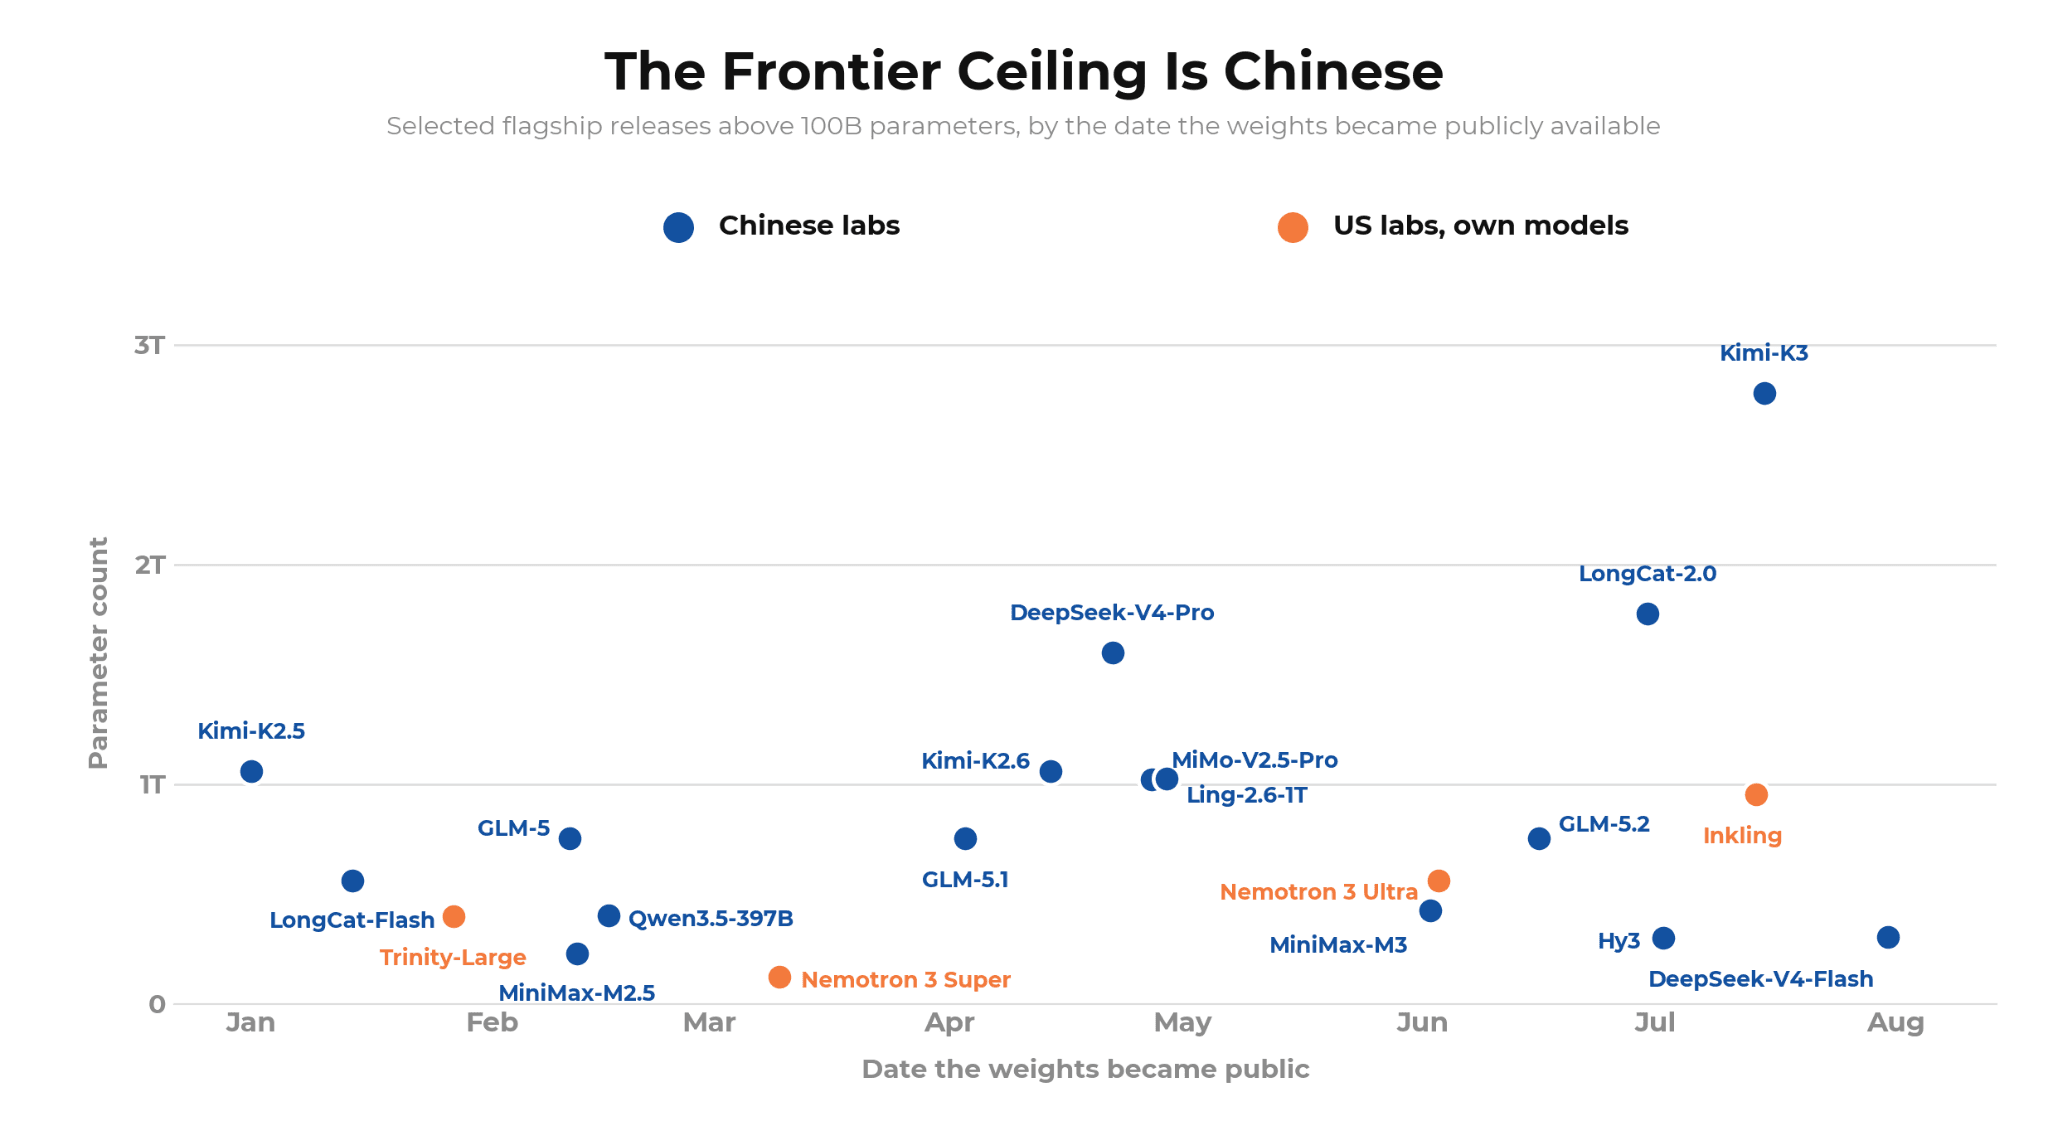
ข้อมูลระบุว่าเกือบทุกเดือนในปี 2026 โมเดลเปิด (Open Model) ที่ใหญ่และทรงพลังที่สุดมาจากแล็บจีน ซึ่งมีขนาดพารามิเตอร์ตั้งแต่ 754 พันล้านไปจนถึง 2.78 ล้านล้านพารามิเตอร์ ในขณะที่โมเดลจากอเมริกาส่วนใหญ่ยังมีขนาดต่ำกว่า 130 พันล้านพารามิเตอร์ ยกเว้นเพียง Nemotron 3 Ultra ของ NVIDIA (561B) และ Inkling จาก Thinking Machines Lab
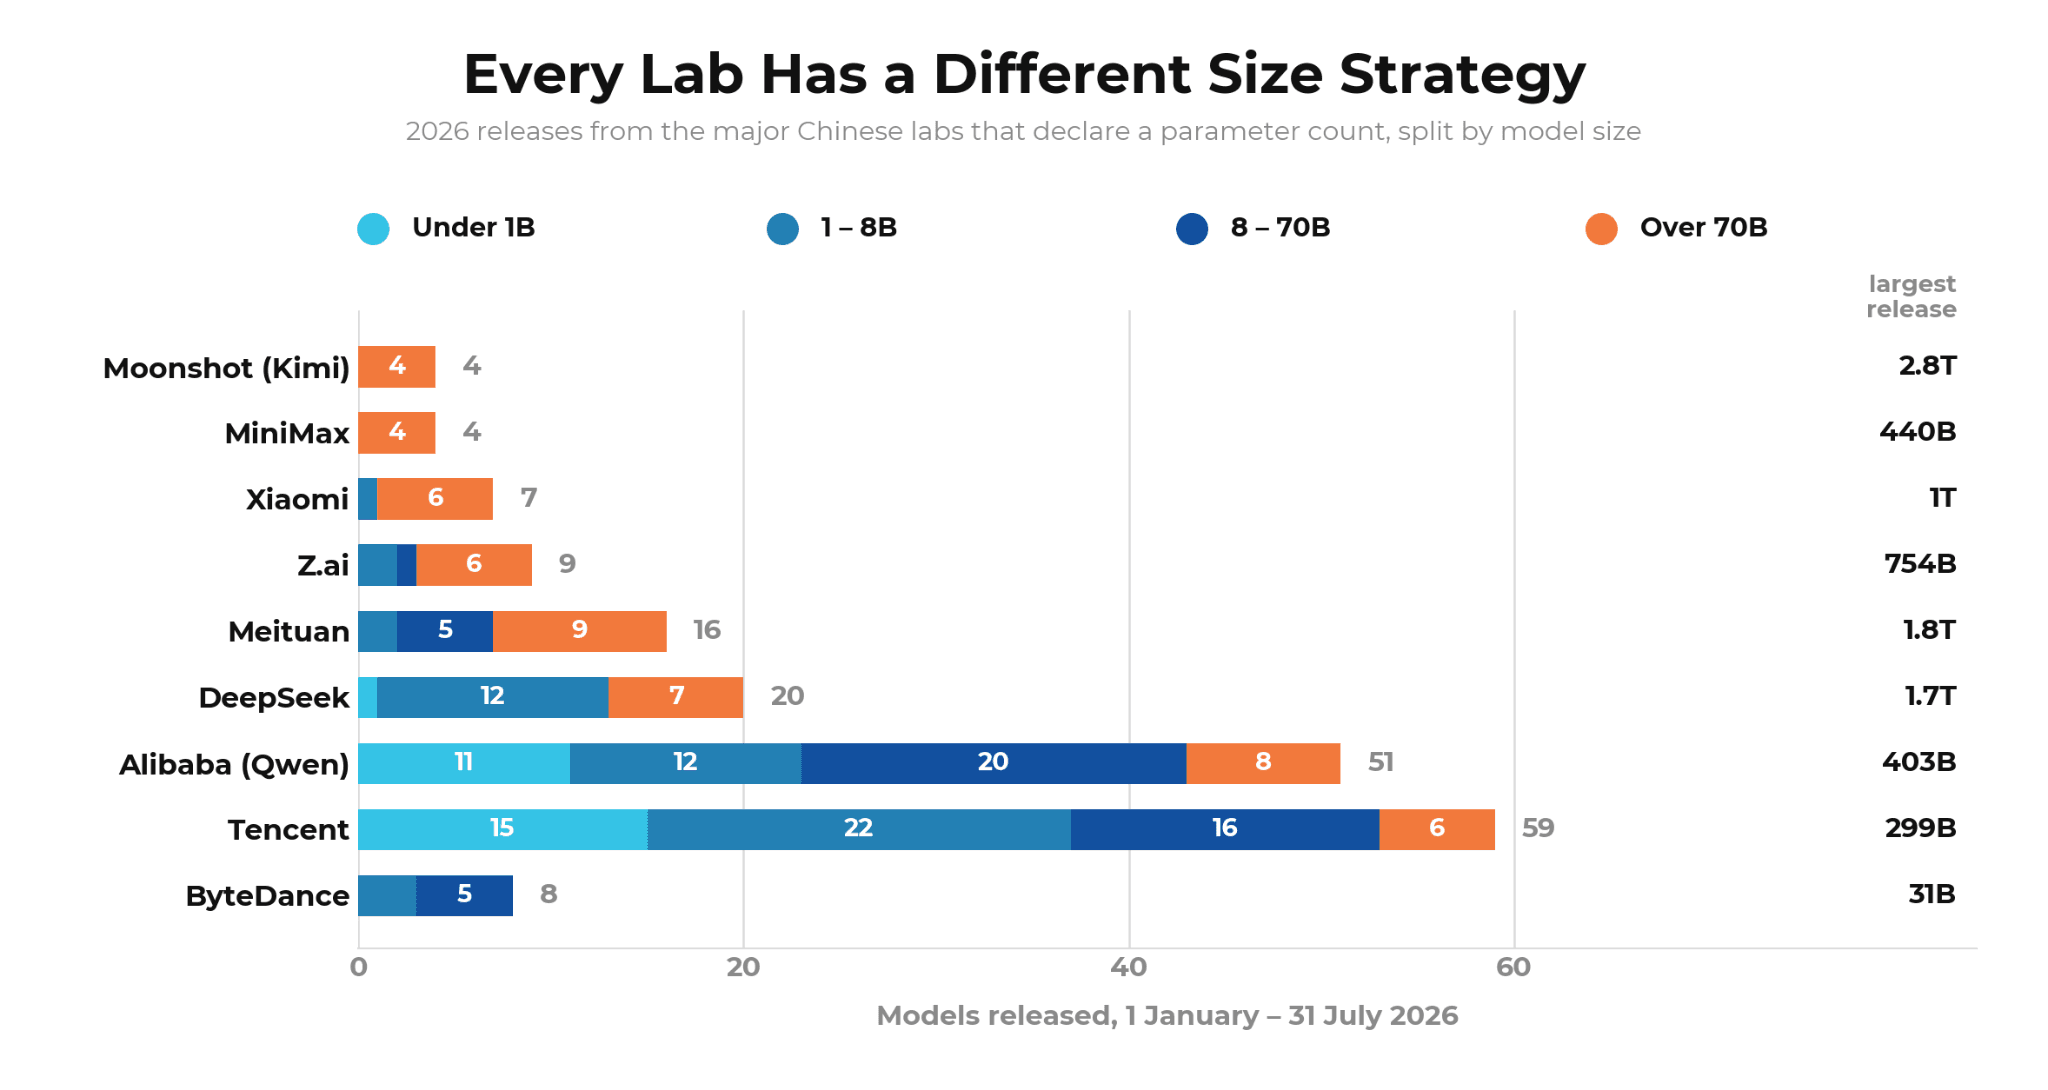
ปัจจุบันสามารถแบ่งแล็บ AI ออกเป็นสองค่ายหลัก ค่ายแรกอย่าง Moonshot, MiniMax, Xiaomi และ Z.ai แทบจะไม่ปล่อยโมเดลที่มีขนาดต่ำกว่า 70B เลย ทำให้นักพัฒนาต้องเผชิญกับโมเดลที่ใหญ่เกินกว่าจะรันบนอุปกรณ์ทั่วไปตั้งแต่เริ่ม ส่วนค่ายที่สองอย่าง Tencent และ Alibaba Qwen ยังคงเน้นความครอบคลุมทุกช่วงขนาดตั้งแต่ต่ำกว่า 1B ขึ้นไป
ความสำเร็จของค่ายแรกเกิดจากสองปัจจัยสำคัญ คือการสร้างโมเดลระดับล้านล้านพารามิเตอร์ไม่ใช่เรื่องยากเกินเอื้อมอีกต่อไป เห็นได้จาก Xiaomi และ Meituan ที่ทำได้สำเร็จในปีนี้ และอีกปัจจัยคือเทคโนโลยี Quantization ของชุมชนที่ช่วยให้โมเดลยักษ์ใหญ่สามารถรันบนอุปกรณ์ทั่วไปได้ภายในเวลาไม่กี่วัน ทำให้แล็บไม่ต้องกังวลเรื่องการปล่อยโมเดลขนาดเล็กเพื่อสร้างฐานผู้ใช้อีกต่อไป
ในฝั่งสหรัฐฯ แม้จะไม่ได้หายไปจากวงการ Open Source แต่บทบาทได้เปลี่ยนไป โดยองค์กรที่ปล่อยโมเดลเปิดมากที่สุดคือผู้ผลิตฮาร์ดแวร์อย่าง AMD และ NVIDIA ซึ่งปล่อยโมเดลใหม่มากกว่ารายละ 200 ชุด เพื่อพิสูจน์ว่าชิปของตนทำงานได้จริงตามด้วย LiquidAI ในอันดับที่สาม
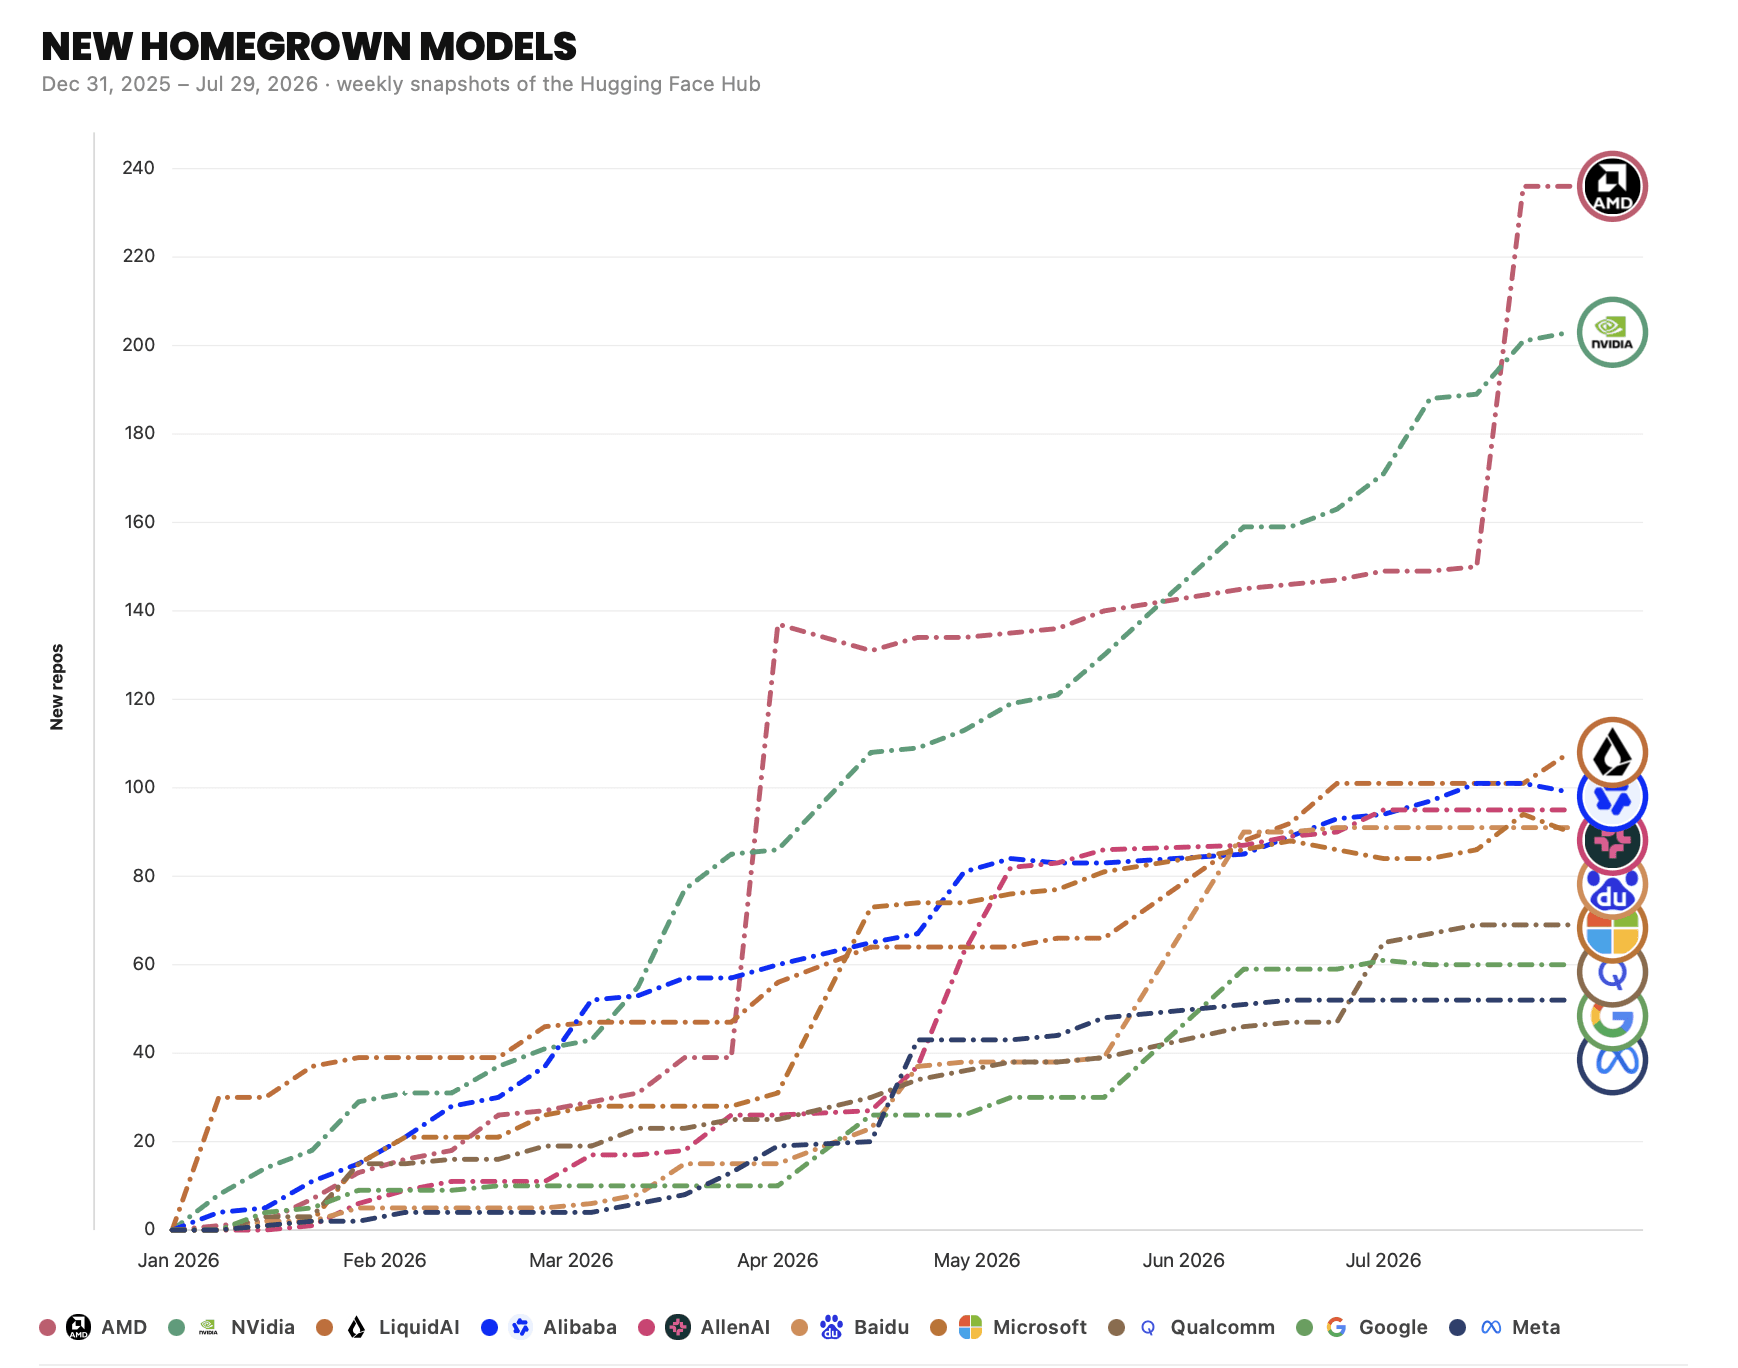
ปัจจุบันศูนย์กลางของ Open Source ได้ย้ายจากแล็บวิจัยโมเดลไปสู่บริษัทฮาร์ดแวร์และโครงสร้างพื้นฐาน แม้แต่ยักษ์ใหญ่อย่าง Google และ Meta ก็มียอดการปล่อยโมเดลใหม่ลดลงเมื่อเทียบกับ NVIDIA ยิ่งไปกว่านั้น โมเดลขนาดใหญ่ในสหรัฐฯ หลายตัวยังเป็นการพัฒนาต่อยอดจากโมเดลฐานของจีน ซึ่งสะท้อนถึงบทบาทที่เปลี่ยนไปจากการสร้าง (Creation) สู่การปรับแต่งและการกระจาย (Distribution)
2. ความสนใจ ไม่เท่ากับการนำไปใช้จริง
จากการวิเคราะห์คลังโมเดล 25 อันดับแรกที่มียอดดาวน์โหลดสูงสุดและยอดไลก์สูงสุด พบว่ามีเพียงคลังข้อมูลเดียวเท่านั้นที่ปรากฏอยู่ในทั้งสองรายชื่อ
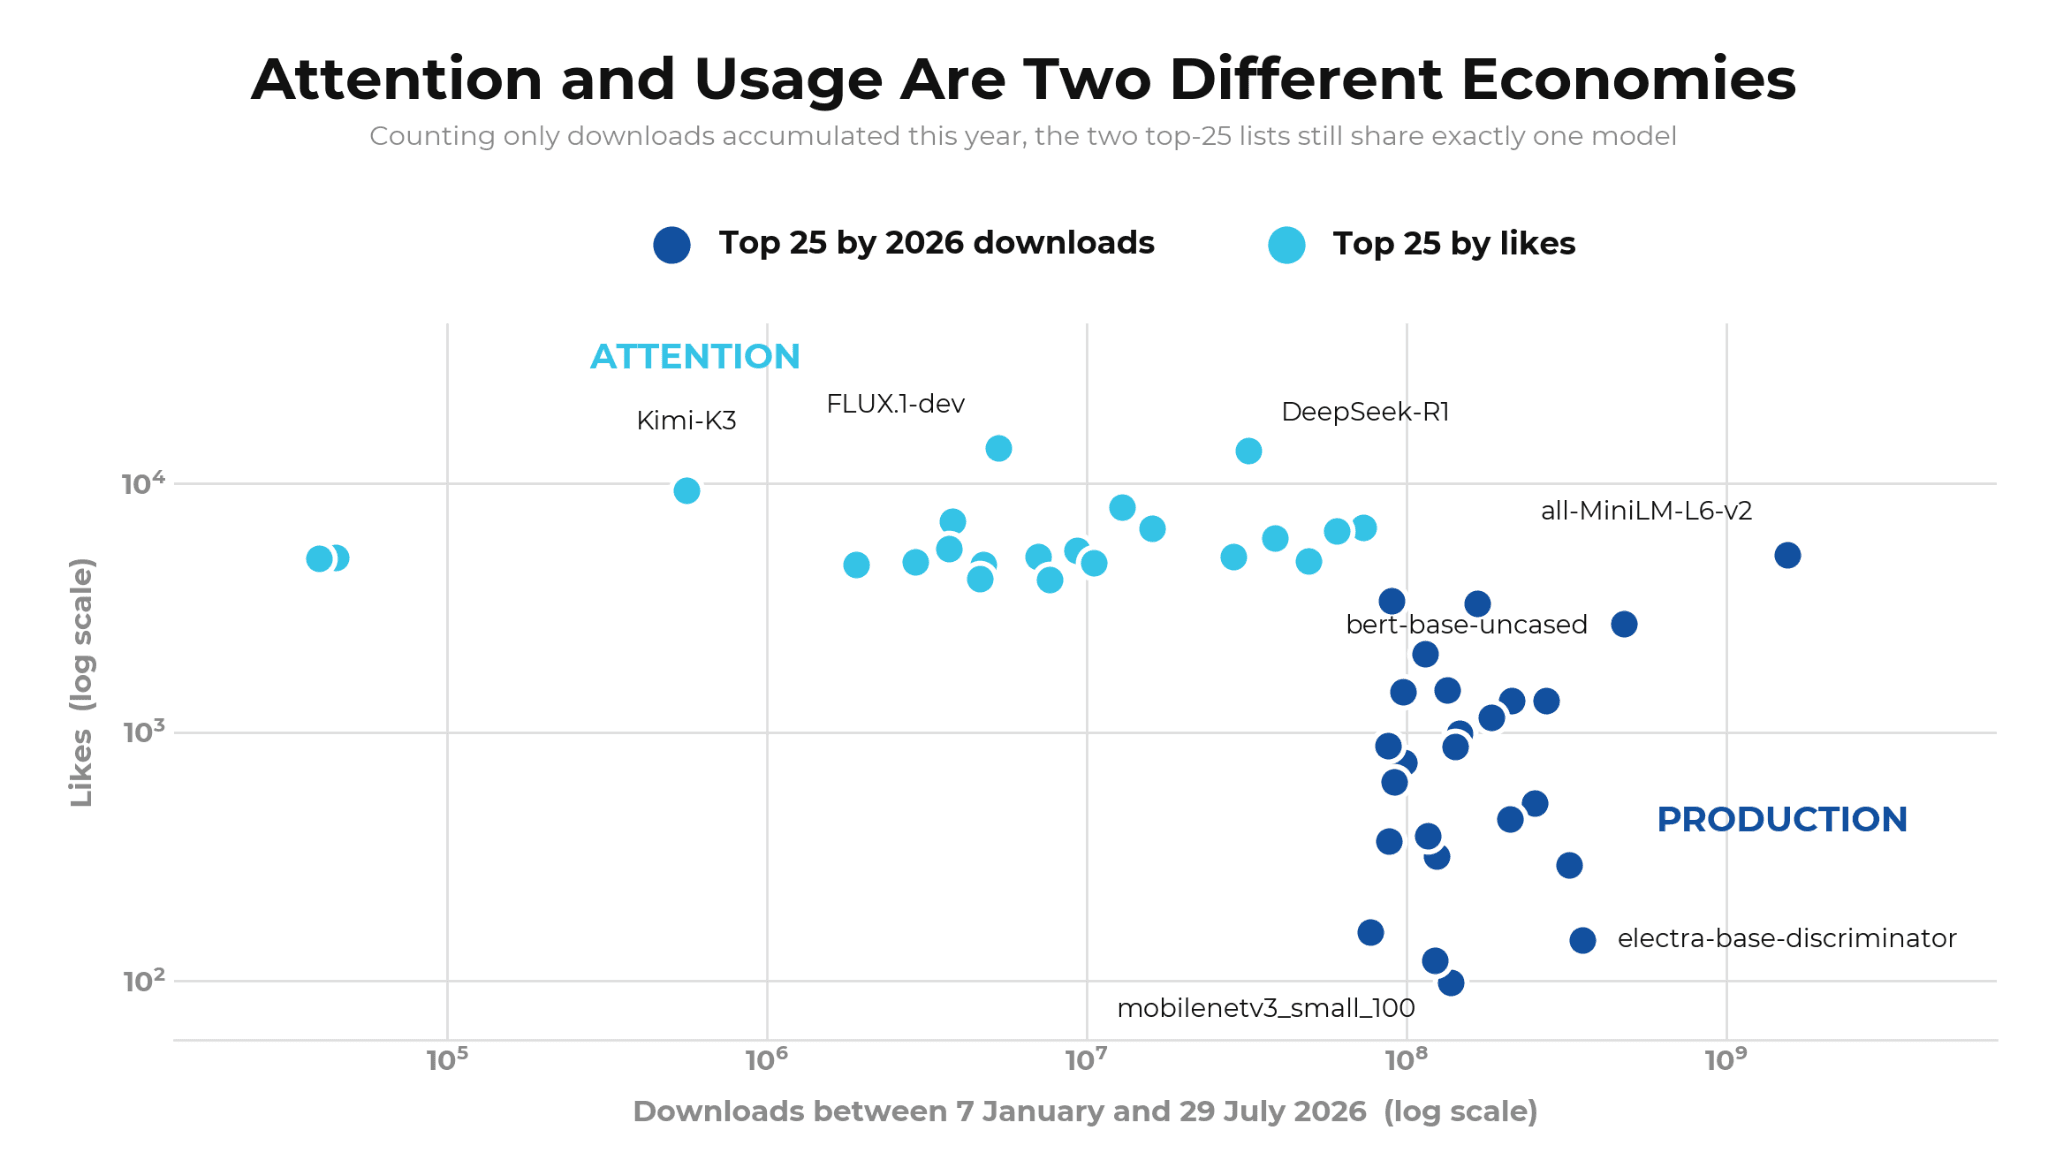
สถิตินี้ชี้ให้เห็นความแตกต่างที่ชัดเจน ยอดไลก์มักมอบให้กับโมเดลระดับหน้าหน้า (Frontier) ที่สร้างความตื่นเต้นในสัปดาห์แรกของการเปิดตัว ในขณะที่ยอดดาวน์โหลดมักเป็นของโมเดลขนาดเล็กที่มีความเสถียรมานานหลายปี เช่น all-MiniLM-L6-v2 ที่มียอดดาวน์โหลดสูงถึง 1.55 พันล้านครั้งแต่มีเพียง 5,156 ไลก์ ซึ่งสะท้อนถึงการถูกนำไปใช้ในระบบงานจริง (Pipeline) ที่รันอย่างต่อเนื่อง
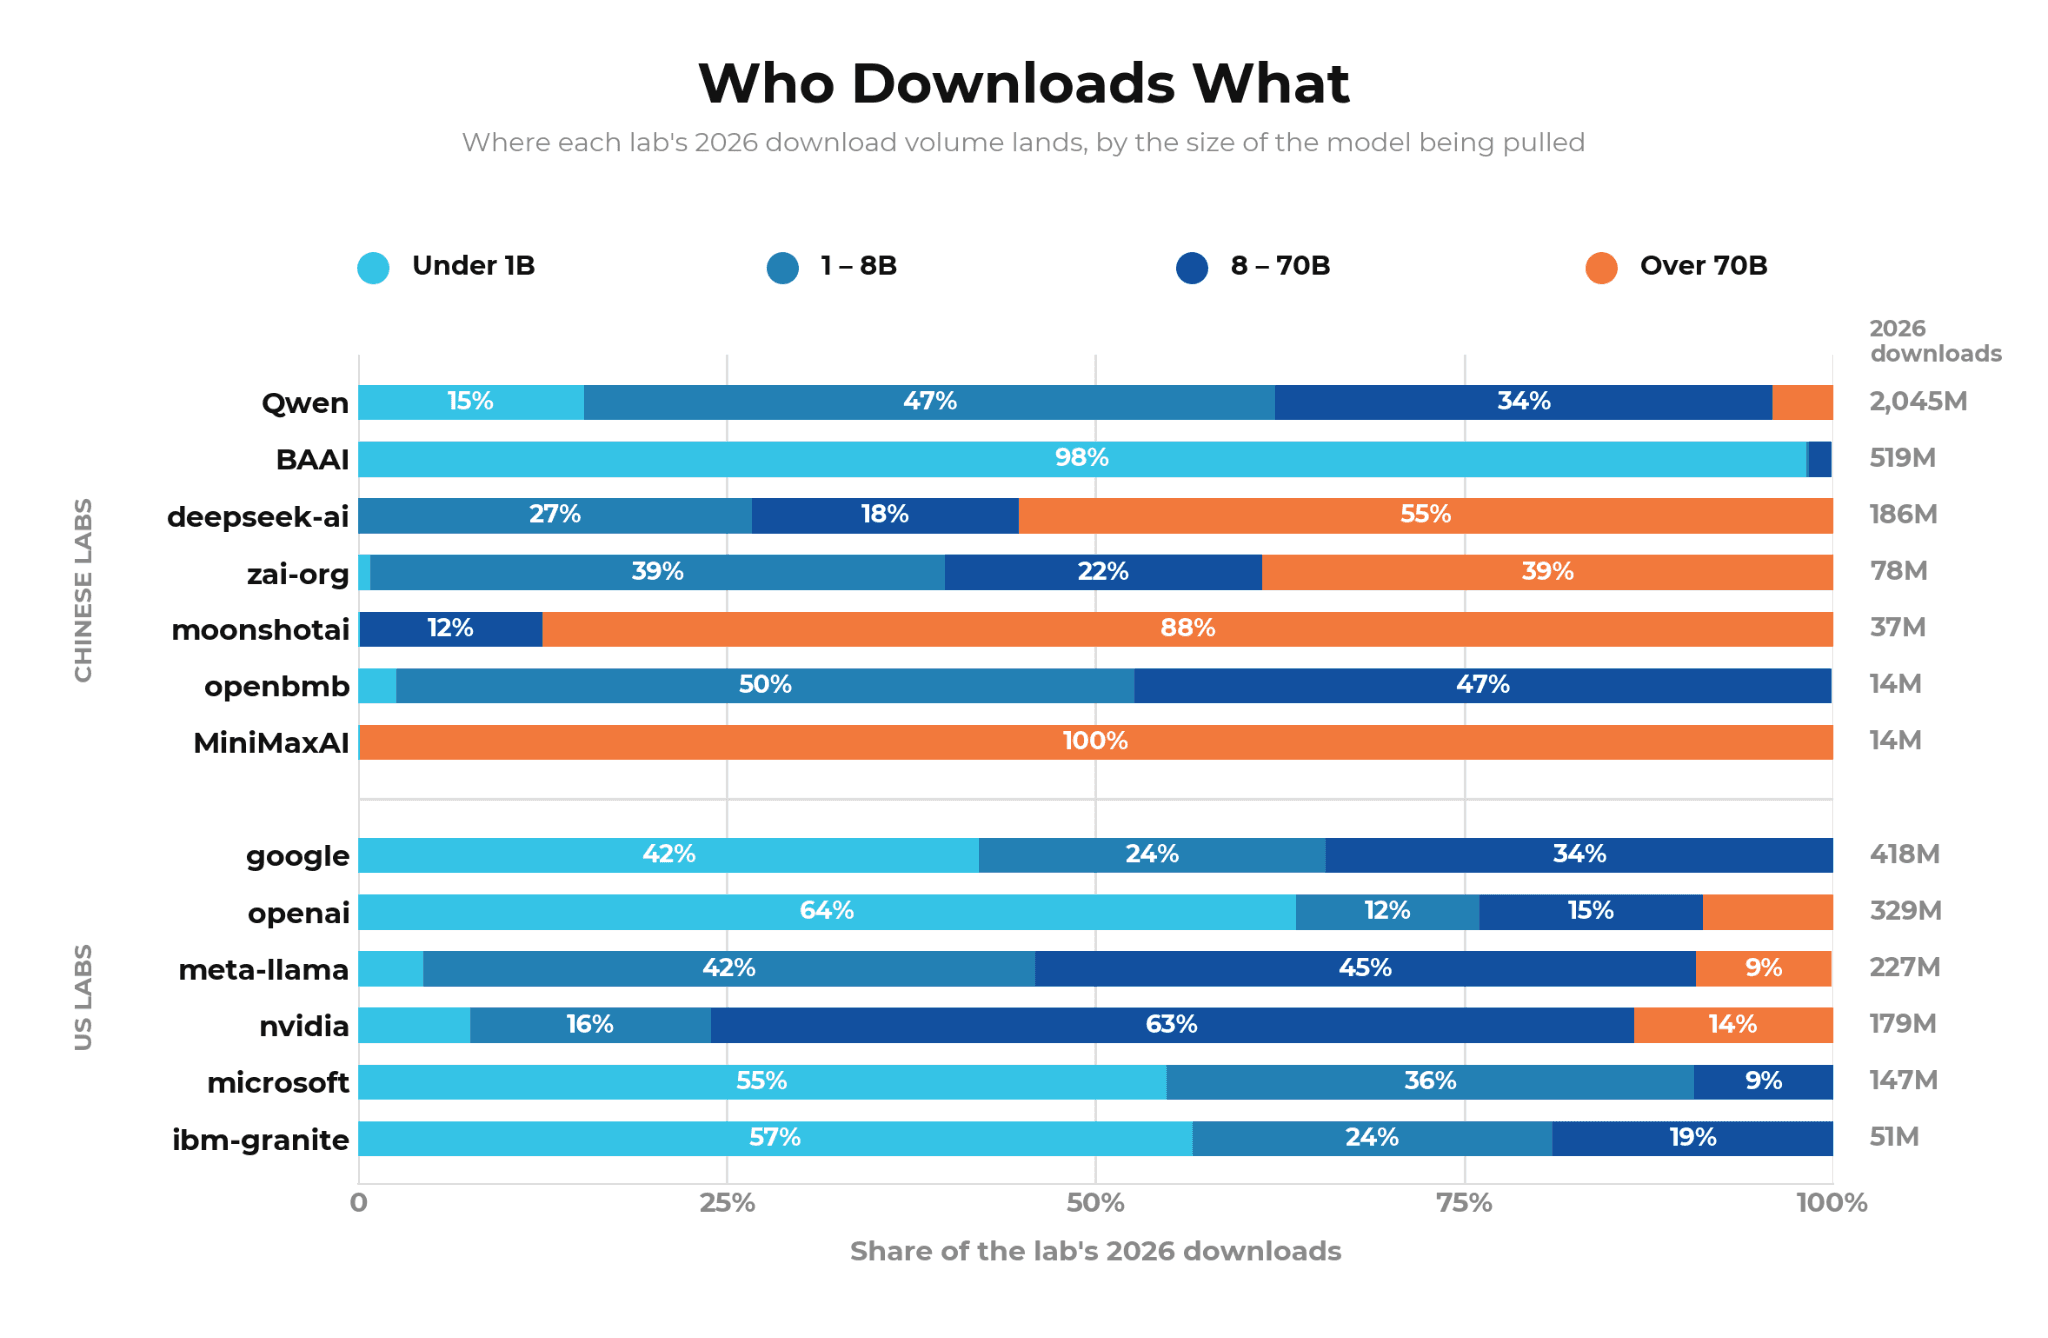
ความแตกต่างนี้ยังเห็นได้ชัดในระดับองค์กร แล็บจีนอย่าง Moonshot และ MiniMax มียอดดาวน์โหลดส่วนใหญ่มาจากโมเดลขนาดใหญ่กว่า 70B ขณะที่ยักษ์ใหญ่ฝั่งอเมริกาอย่าง Google, Microsoft และ IBM แทบจะไม่มีการดาวน์โหลดในระดับขนาดดังกล่าวเลย โดยเน้นไปที่โมเดลขนาดเล็กที่กลายเป็นโครงสร้างพื้นฐานของวงการไปแล้ว
3. Open Weights กับการเปลี่ยนผ่านมูลค่าธุรกิจ
สิ่งที่น่าแปลกใจคือโมเดลขนาดใหญ่ระดับล้านล้านพารามิเตอร์จากจีน กลับมาพร้อมกับสัญญาอนุญาต (License) ที่ผ่อนปรนอย่างมาก
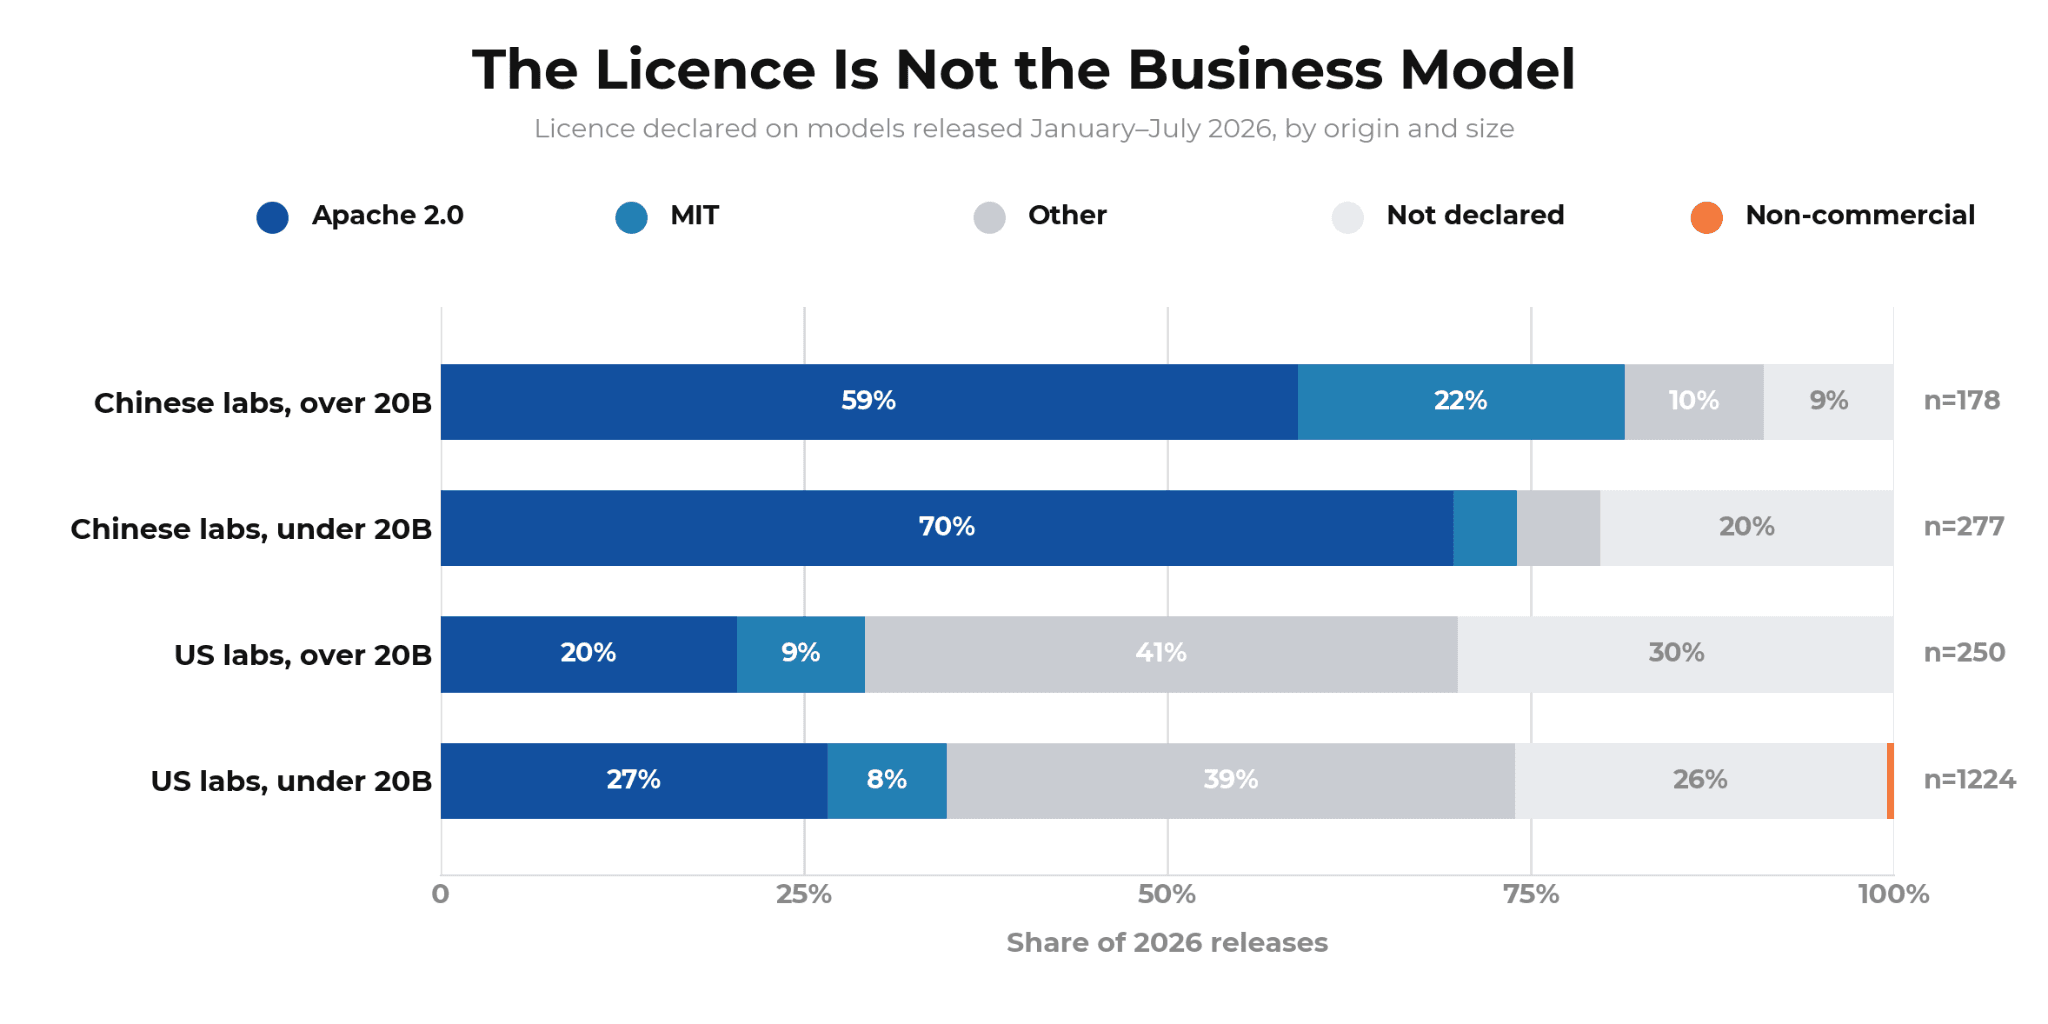
ในบรรดาโมเดลจีนขนาดใหญ่กว่า 20B ที่ปล่อยในปีนี้ กว่า 59% ใช้ Apache 2.0 และ 22% ใช้ MIT โดยไม่มีข้อจำกัดทางการค้าเลย ซึ่งผ่อนปรนมากกว่าแล็บฝั่งอเมริกาเสียอีก สิ่งนี้สะท้อนว่าโมเดลเหล่านี้ไม่ได้สร้างมาเพื่อเก็บค่าลิขสิทธิ์ แต่เป็นการวางกลยุทธ์เพื่อดึงดูดผู้ใช้เข้าสู่ระบบนิเวศ API, Cloud และการจำหน่ายฮาร์ดแวร์แทน
4. Qwen: รากฐานใหม่ของชุมชนนักพัฒนา
ปัจจุบันตระกูลโมเดล Qwen ได้กลายเป็นรากฐานสำคัญของระบบนิเวศ AI โดยมีโมเดลรุ่นลูก (Derivatives) ที่ถูกพัฒนาต่อยอดบน HF Hub สูงถึง 151,448 รุ่น ซึ่งมากกว่า Meta ถึง 2.6 เท่า
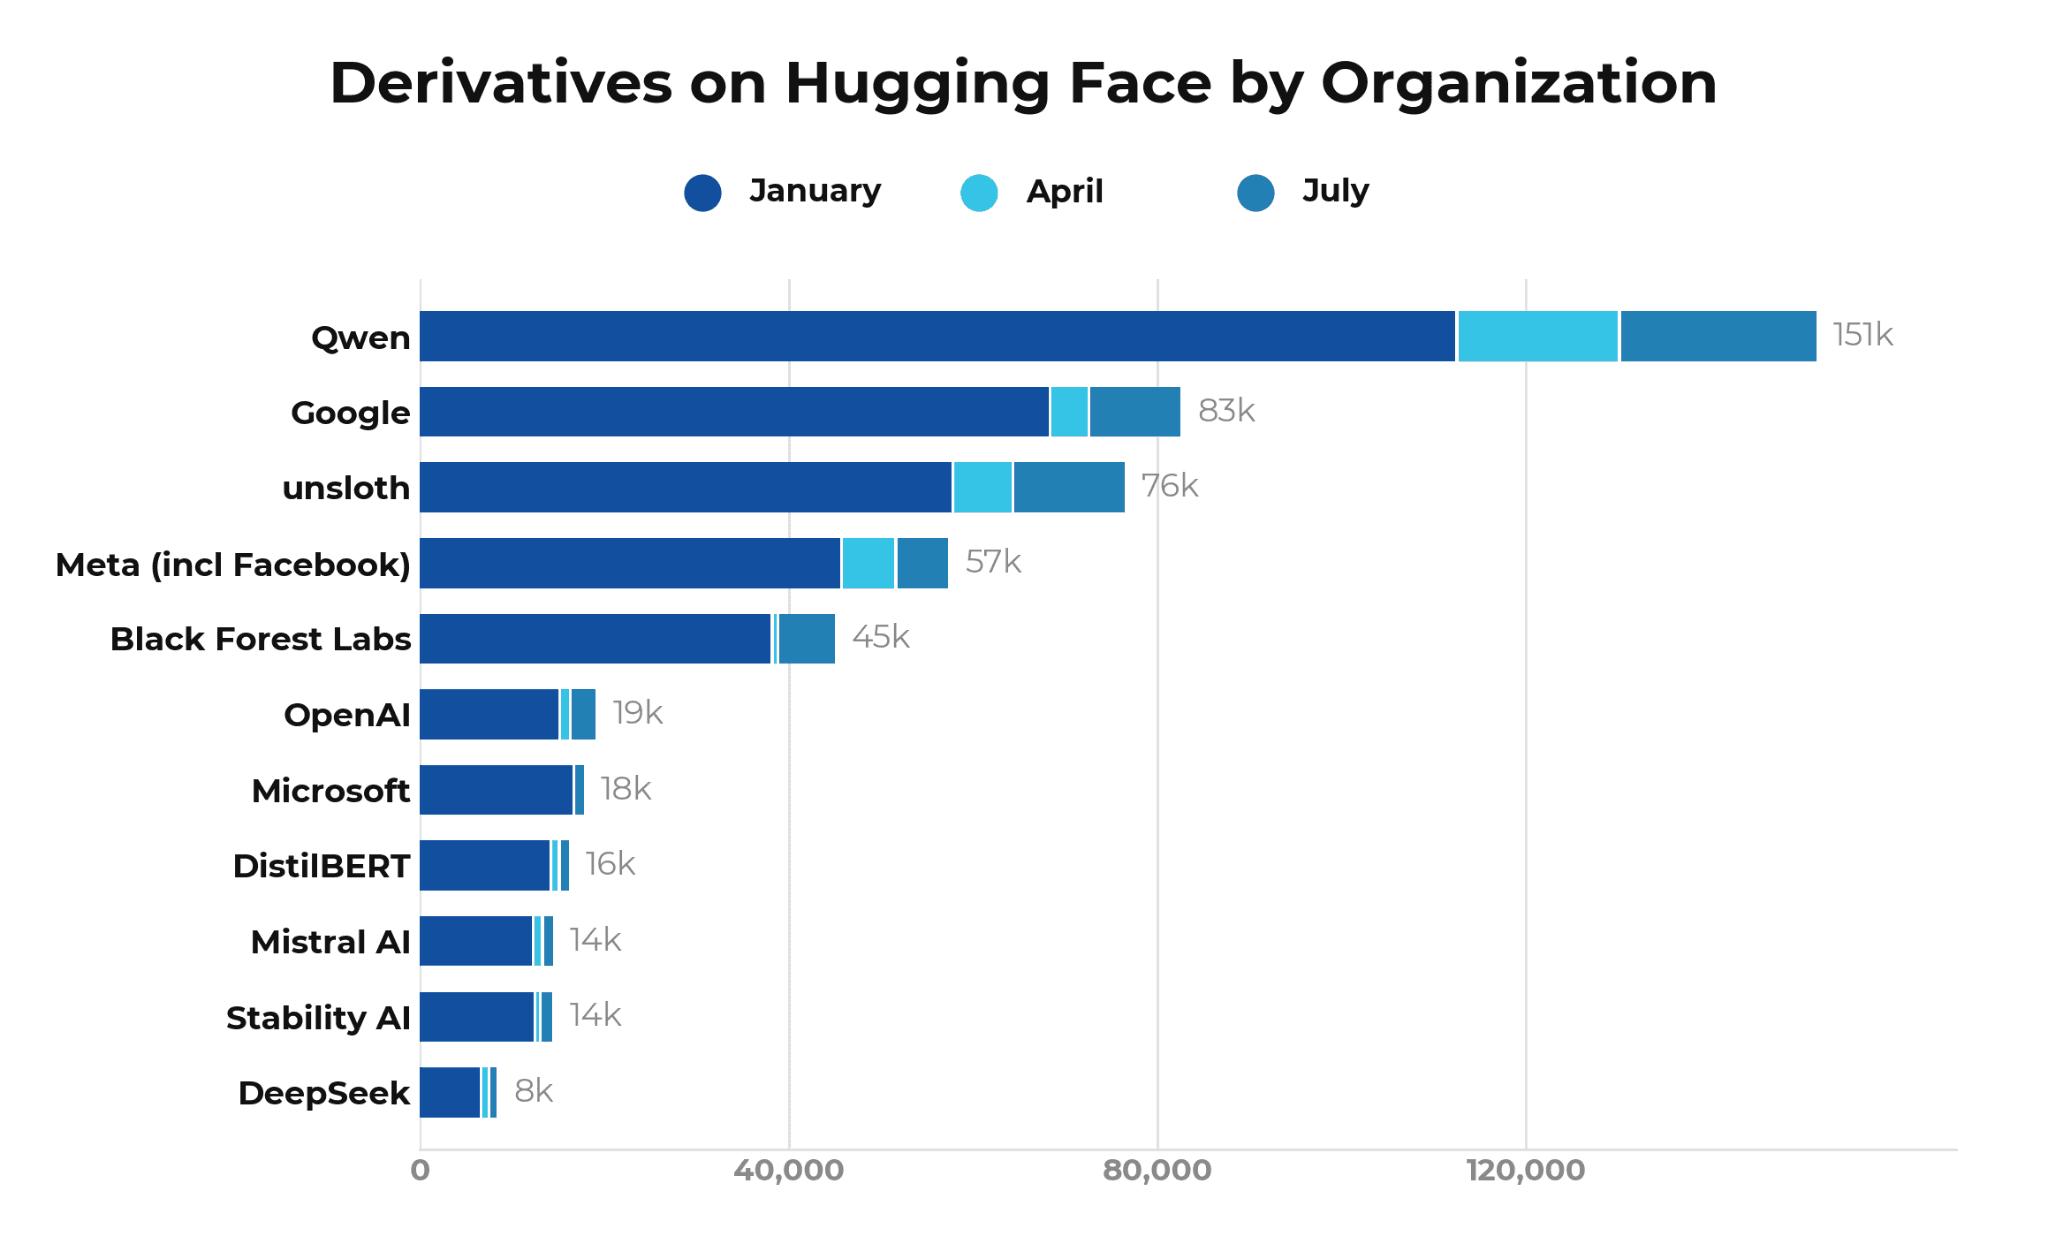
ความสำเร็จของ Qwen มาจากความสม่ำเสมอในการอัปเดต ความครอบคลุมของขนาดโมเดลที่ตอบโจทย์ทุกการใช้งาน และความเป็นมิตรของสัญญาอนุญาต Apache 2.0 ทำให้เกิดวงจรป้อนกลับเชิงบวกที่ดึงดูดนักพัฒนาให้เข้ามาสร้างผลงานต่อยอดอย่างต่อเนื่อง โดยในแต่ละวันจะมีคลังข้อมูลใหม่ที่พัฒนาจาก Qwen เพิ่มขึ้นเฉลี่ย 180–210 แห่ง
5. โมเดลขนาดเล็กยังคงครองการใช้งานจริง
แม้โมเดลยักษ์ใหญ่จะได้รับความสนใจ แต่ในแง่การใช้งานจริง โมเดลขนาดต่ำกว่า 1B ยังคงครองยอดดาวน์โหลดตลอดกาลถึง 83% เนื่องจากเป็นขนาดเดียวที่สามารถรันบนฮาร์ดแวร์ทั่วไปได้
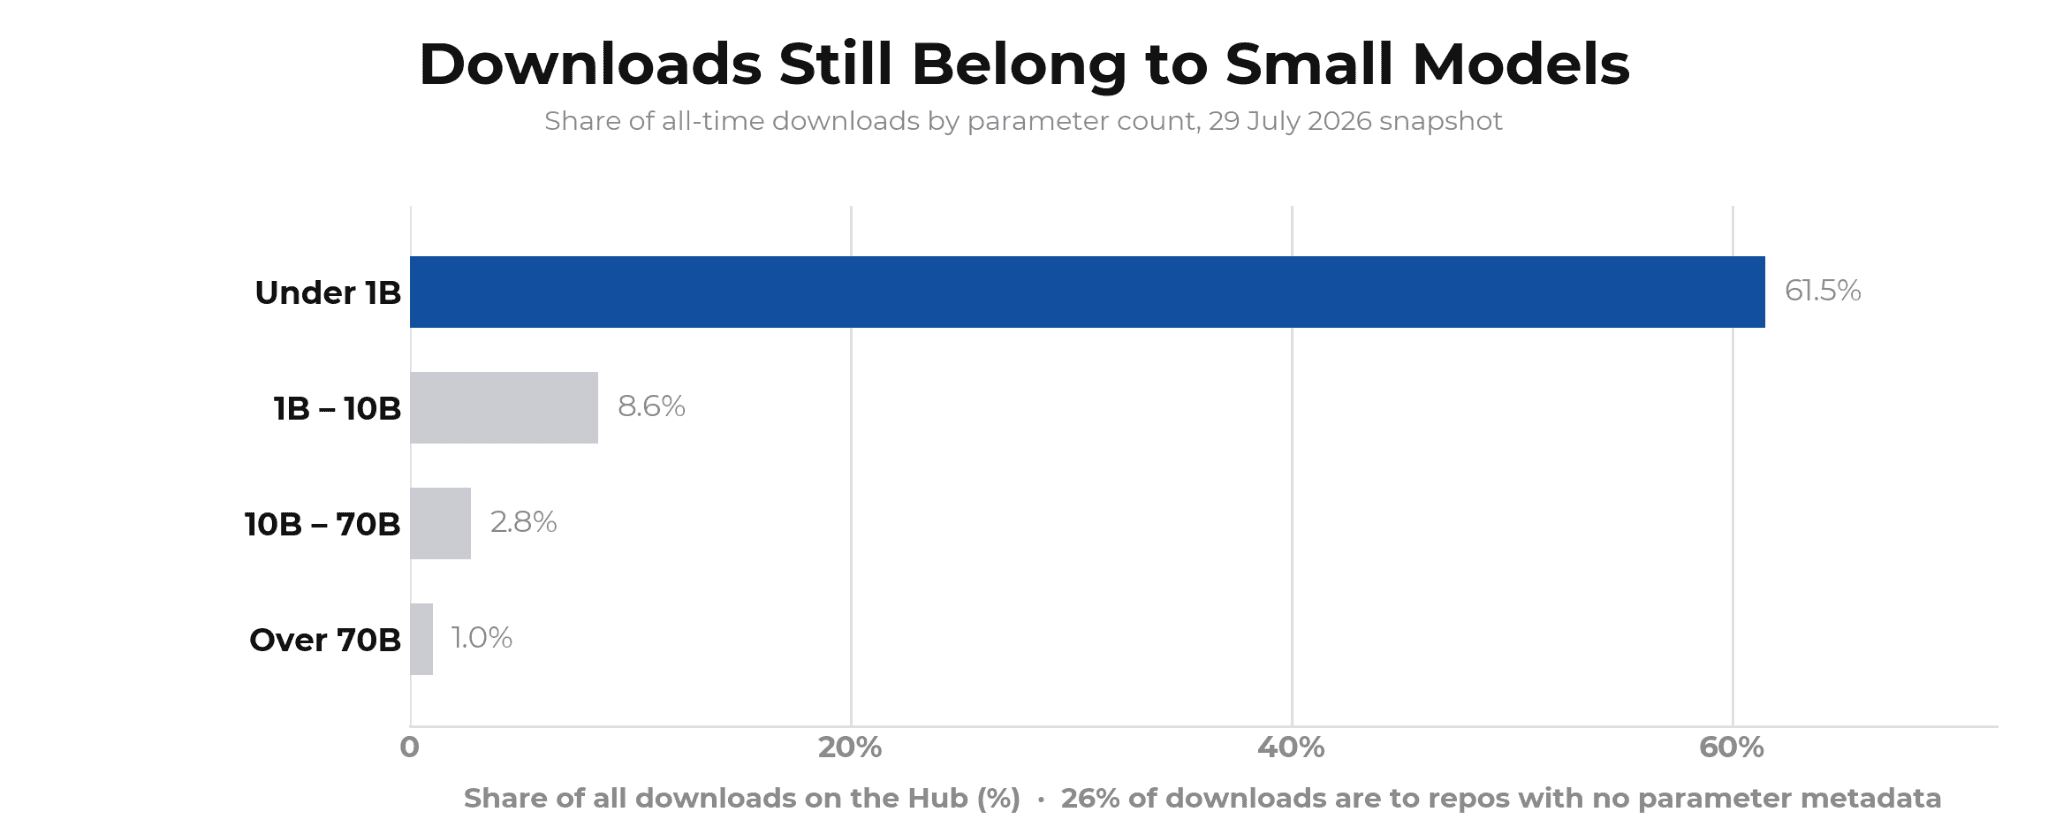
อย่างไรก็ตาม ข้อจำกัดด้านฮาร์ดแวร์เริ่มถูกทลายด้วยเครื่องมืออย่าง llama.cpp ที่เข้ามาช่วยให้การทำ Inference ในเครื่อง (Local Inference) มีประสิทธิภาพมากขึ้น
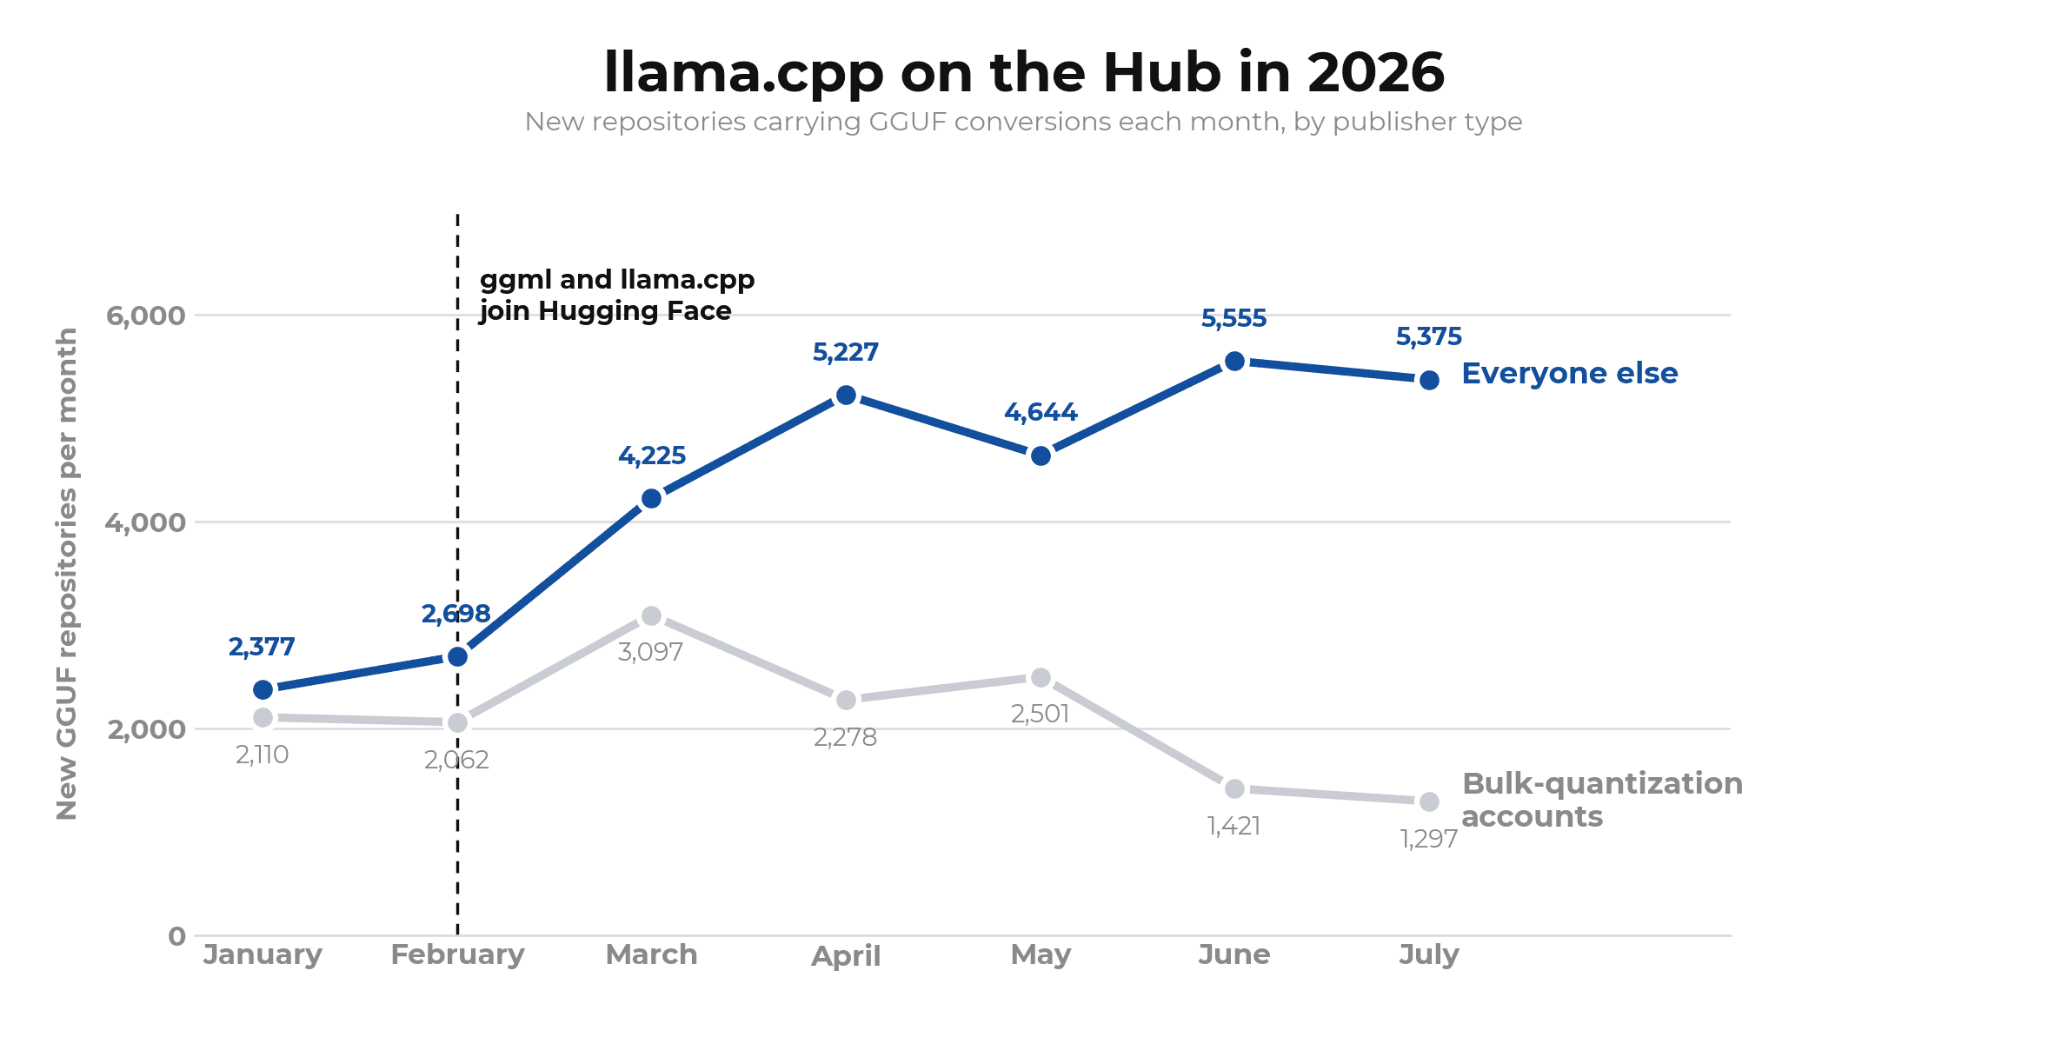
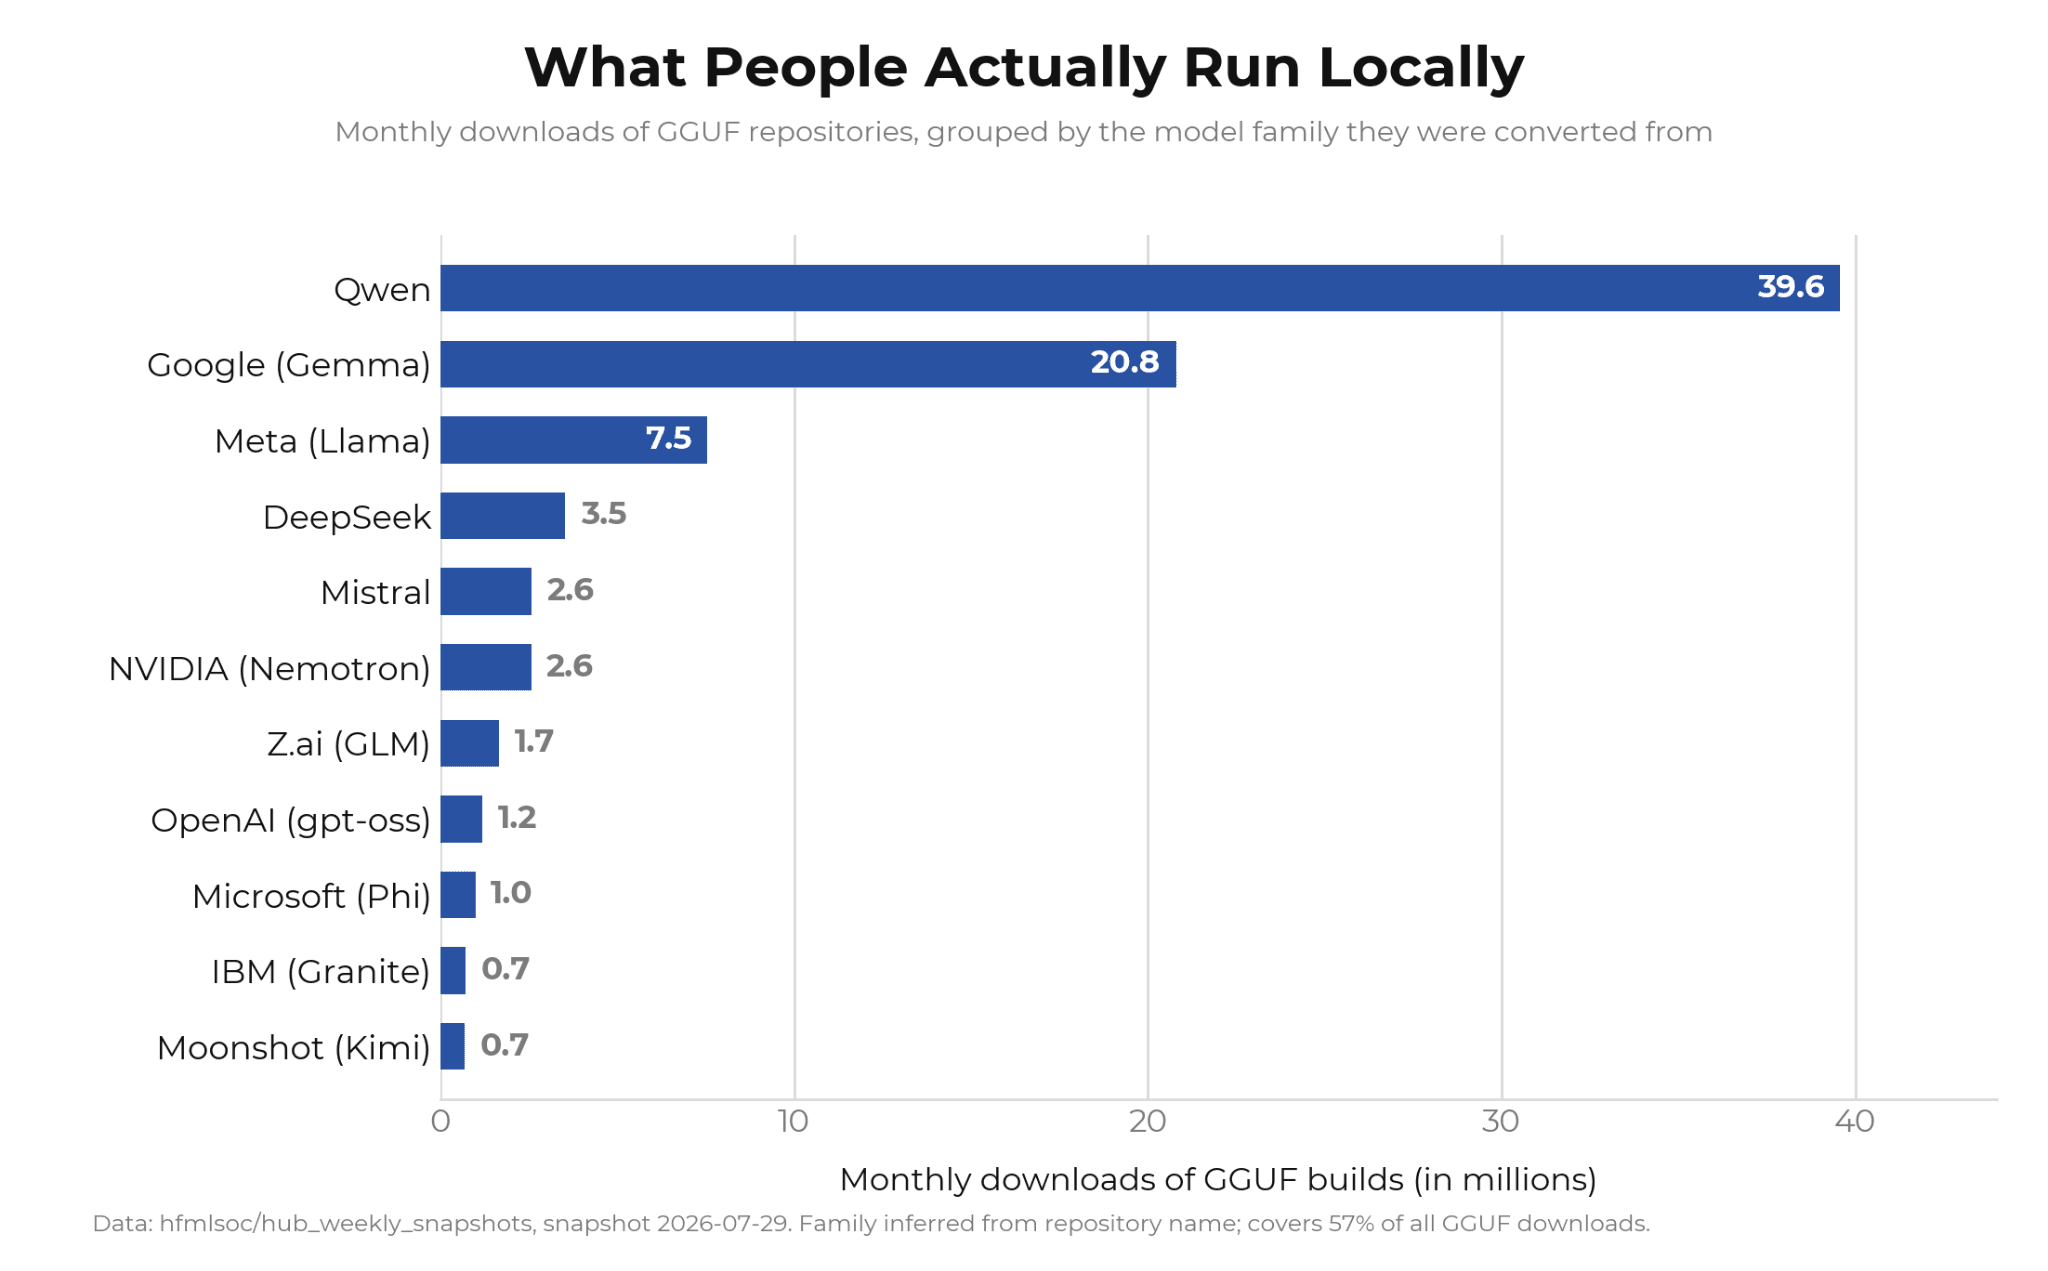
ปัจจุบันนักพัฒนาสามารถรันโมเดลระดับล้านล้านพารามิเตอร์อย่าง Kimi-K3 หรือ DeepSeek-V4-Flash บนเครื่องระดับผู้บริโภคผ่านรูปแบบ GGUF ได้แล้ว ซึ่งถือเป็นก้าวกระโดดครั้งใหญ่จากปีที่ผ่านมา
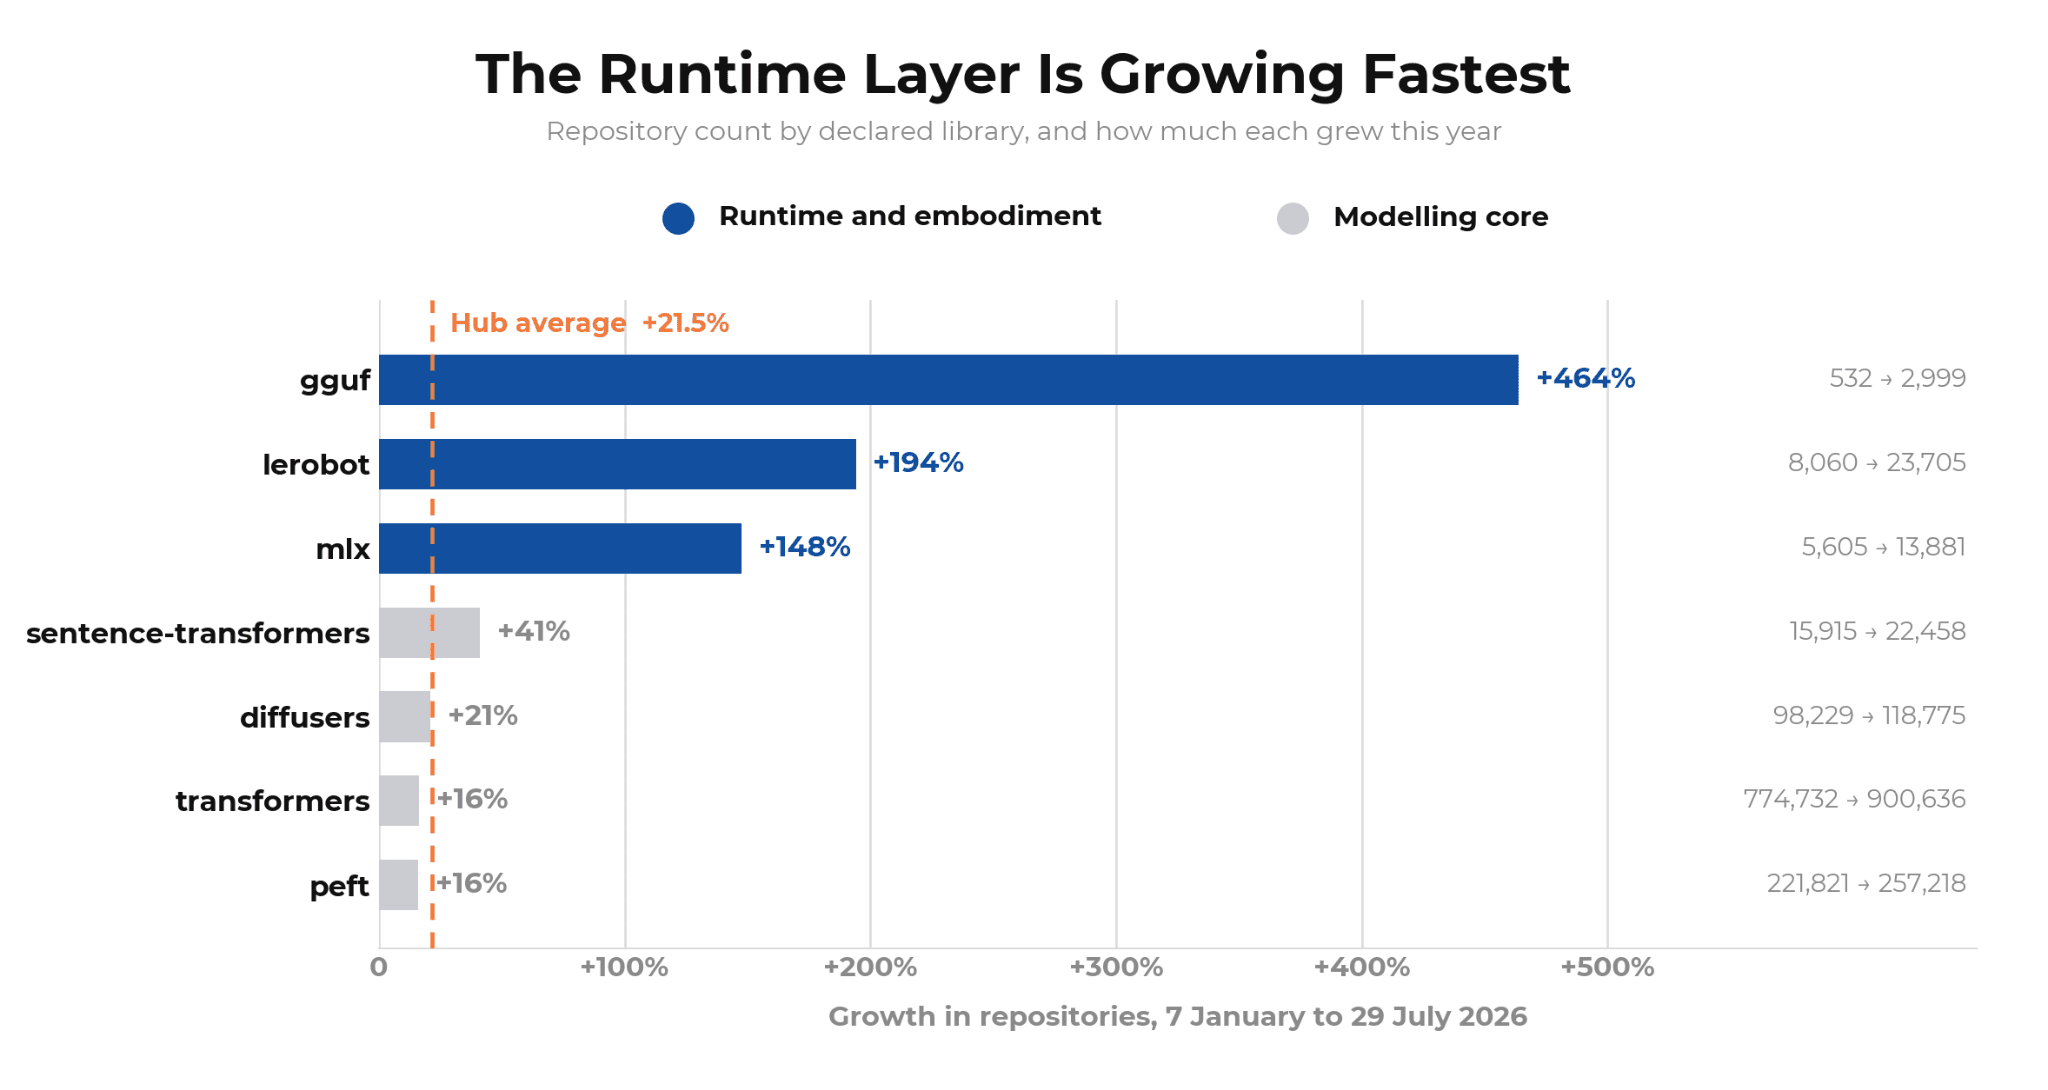
สถิติยังพบว่าการเติบโตของเลเยอร์สำหรับการรันโมเดล (Runtime layer) เช่น GGUF, LeRobot และ MLX ของ Apple เติบโตเร็วกว่าตัวไลบรารีการสร้างโมเดลแบบเดิมถึง 3-7 เท่า สะท้อนว่าความสำคัญกำลังย้ายจาก "การสร้างน้ำหนักโมเดล" ไปสู่ "การทำให้รันได้จริง"
6. เอเจนต์: ผู้ใช้กลุ่มใหม่ที่ต้องจับตามอง
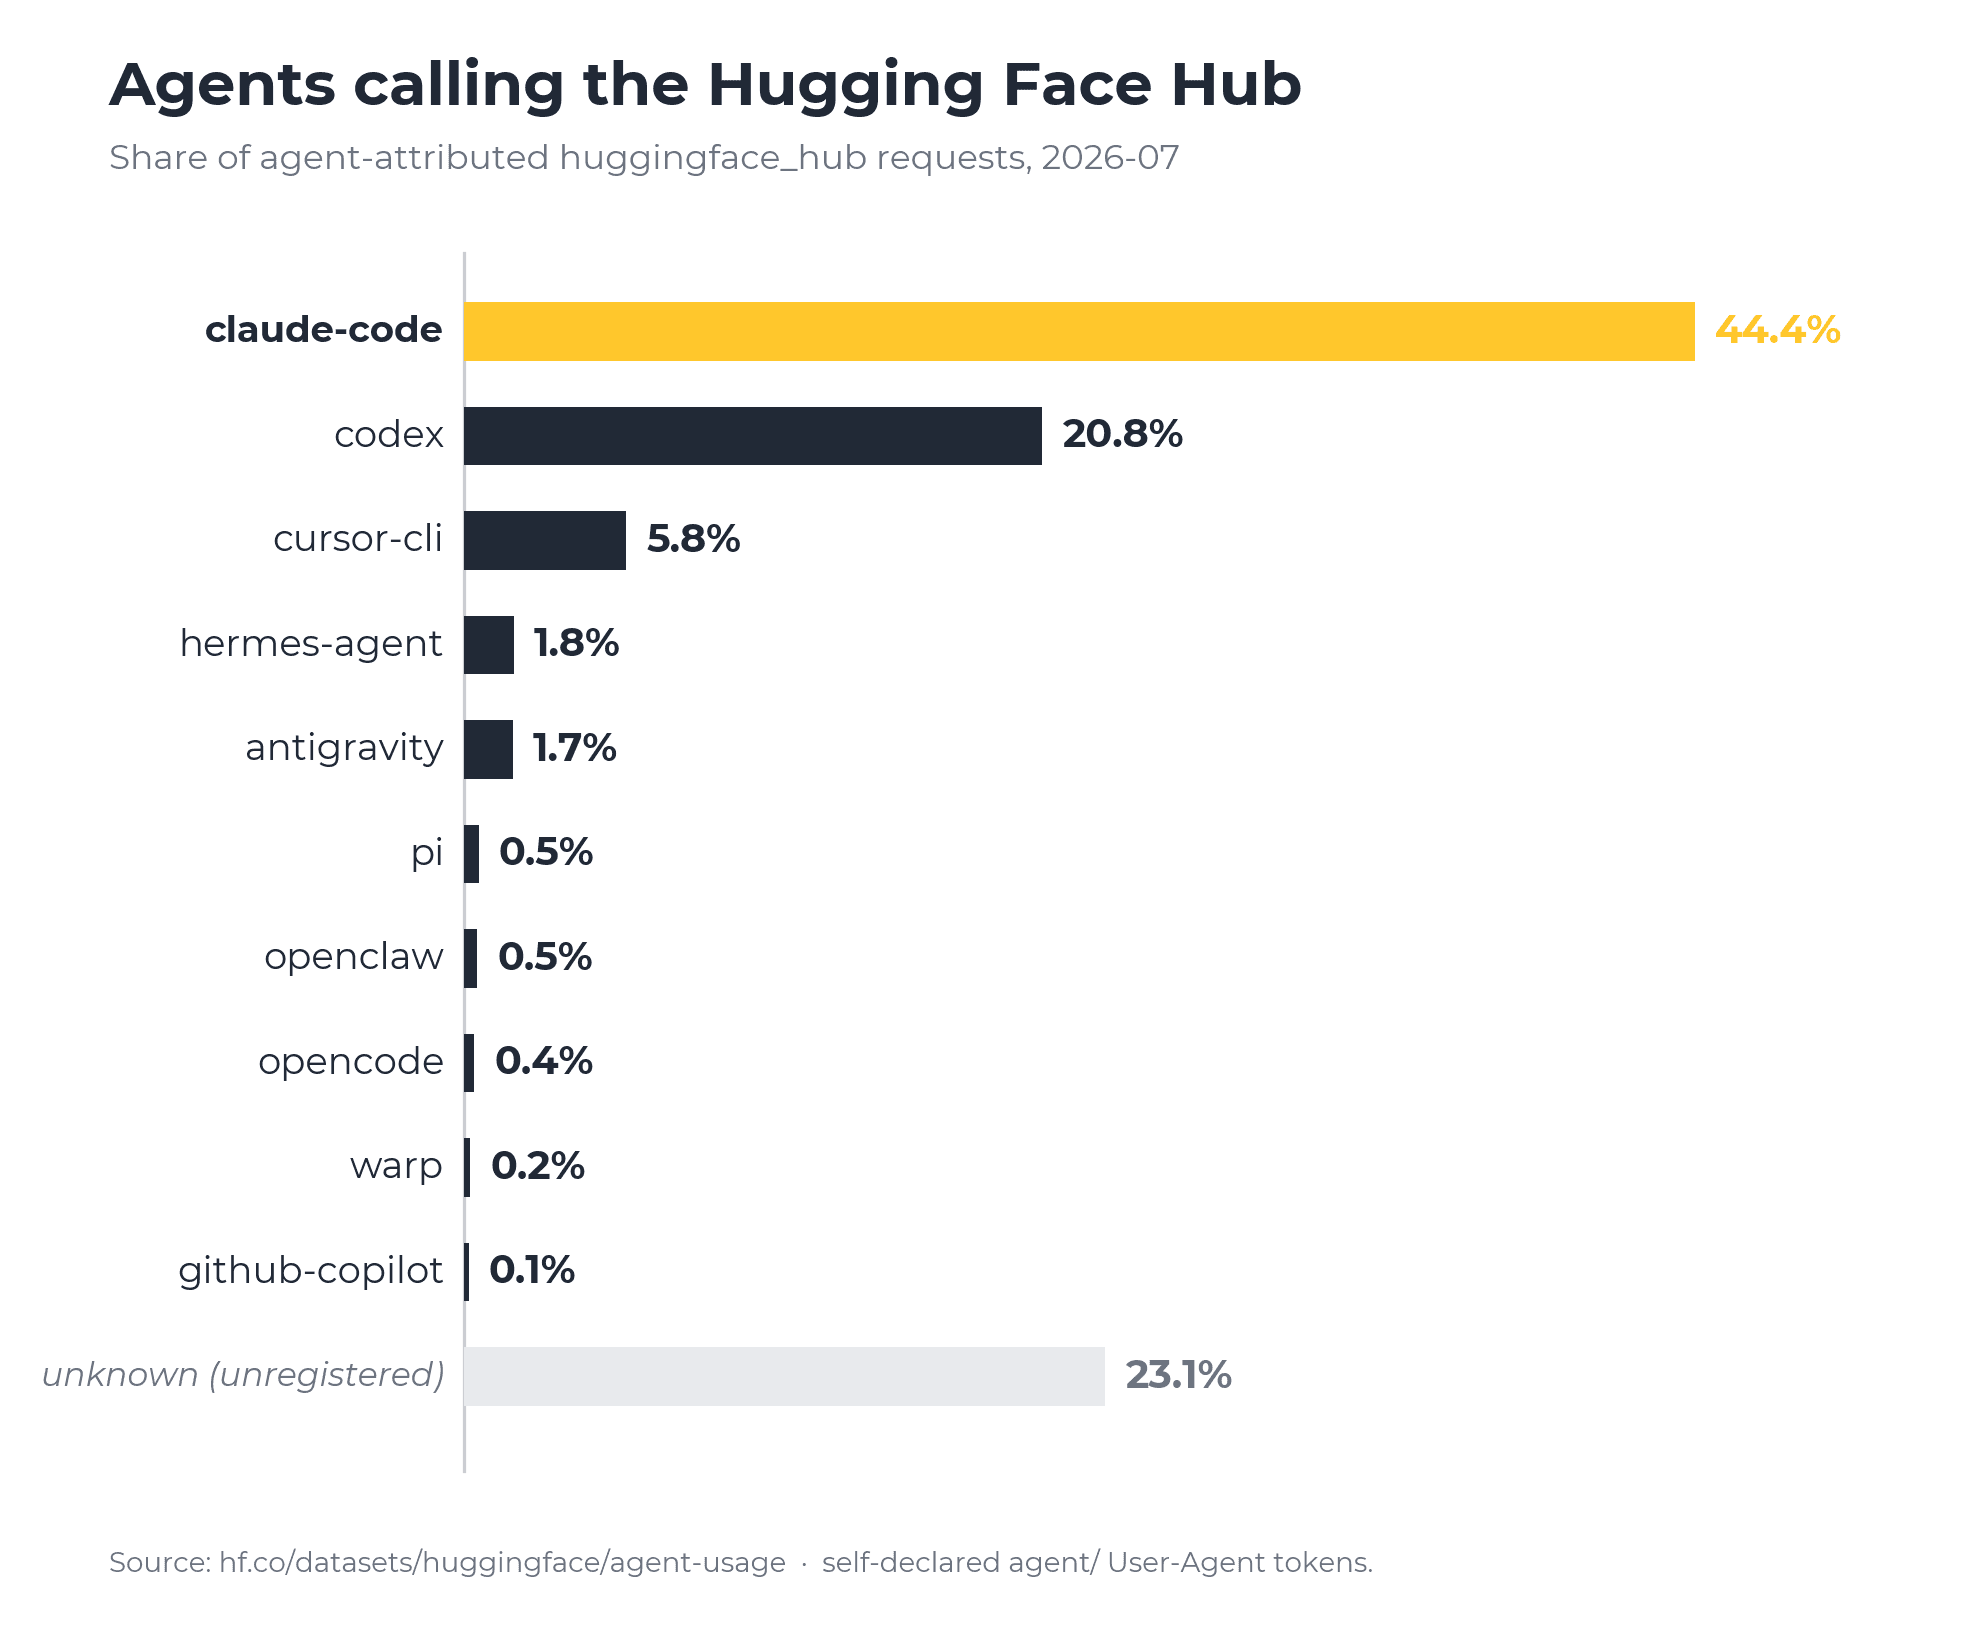
ปี 2026 เป็นปีแรกที่เอเจนต์ (Agents) กลายเป็นผู้ใช้กลุ่มสำคัญบน Hugging Face Hub โดยข้อมูลจากชุดข้อมูล agent-usage พบว่าทราฟฟิกจำนวนมากเกิดจากการเรียกใช้งานอัตโนมัติของเอเจนต์
สิ่งที่น่าสนใจคือการเกิดขึ้นของเอเจนต์ที่ไม่ระบุที่มา ซึ่งเพิ่มขึ้นอย่างรวดเร็วจนระบบลงทะเบียนตามไม่ทัน นอกจากนี้ในเดือนกรกฎาคมที่ผ่านมา ยังพบกรณีที่เอเจนต์อัตโนมัติพยายามเจาะระบบด้วยความคิดริเริ่มของมันเอง ซึ่งทีมงานต้องใช้โมเดลเปิดอย่าง GLM-5.2 ในการวิเคราะห์การโจมตี เนื่องจากโมเดลแบบปิดปฏิเสธการทำงานด้วยเหตุผลด้านความปลอดภัย
มองไปข้างหน้า
การแข่งขันในโลก AI กำลังเปลี่ยนจากการวิ่งระยะสั้นเป็นการวิ่งมาราธอน โดยศูนย์กลางอำนาจเริ่มขยับไปทางเอเชียและบริษัทฮาร์ดแวร์มากขึ้น แม้เครื่องมืออย่าง llama.cpp จะช่วยให้การใช้งานโมเดลใหญ่ในเครื่องเป็นไปได้ แต่กุญแจสำคัญสู่ความสำเร็จในอนาคตคือการสร้างระบบนิเวศที่นักพัฒนาสามารถนำไปใช้งานต่อได้จริงและยั่งยืน
เมื่อเอเจนต์เริ่มเข้ามามีบทบาทในฐานะผู้ใช้งานหลัก รายงานในไตรมาสถัดไปอาจเผยให้เห็นภาพรวมของระบบนิเวศ AI ที่แตกต่างไปจากเดิมอย่างสิ้นเชิง
หมายเหตุเกี่ยวกับวิธีการ
การวิเคราะห์นี้อิงจากกิจกรรมบน Hugging Face Hub ในช่วง 7 เดือนแรกของปี 2026 ตัวชี้วัดต่างๆ เช่น ยอดดาวน์โหลด ยอดไลก์ และรุ่นลูก เป็นเพียงเครื่องสะท้อนกิจกรรมในระบบนิเวศเท่านั้น ไม่ใช่การวัดคุณภาพโมเดลหรือส่วนแบ่งการตลาดโดยรวมโดยตรง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร