
วิธีแก้ Notebook ในงาน Data Science 'ตาย': 6 นิสัยสร้างโค้ดที่รันได้ยาวนาน
Notebook จะ "ตาย" ทันทีที่ปุ่ม "Restart Kernel and Run All" ใช้งานไม่ได้
บ่อยครั้งที่ไม่มีใครสังเกตเห็นเรื่องนี้เป็นสัปดาห์ หลังจากวิเคราะห์เสร็จ แผนภูมิถูกใส่ในสไลด์ และไฟล์ถูกส่งขึ้นระบบเรียบร้อย แต่เมื่อมีคนถามถึงที่มาของตัวเลข แล้วคุณเปิด Notebook ขึ้นมารันใหม่ cell ที่ 12 อาจฟ้อง KeyError ในคอลัมน์ที่คุณเคยเปลี่ยนชื่อไปใน cell ที่ 31 และลบทิ้งไปใน cell ที่ 44 แต่ผลลัพธ์เดิมยังค้างอยู่ ทำให้ Notebook ดูเหมือนปกติทั้งที่รันไม่ได้แล้ว
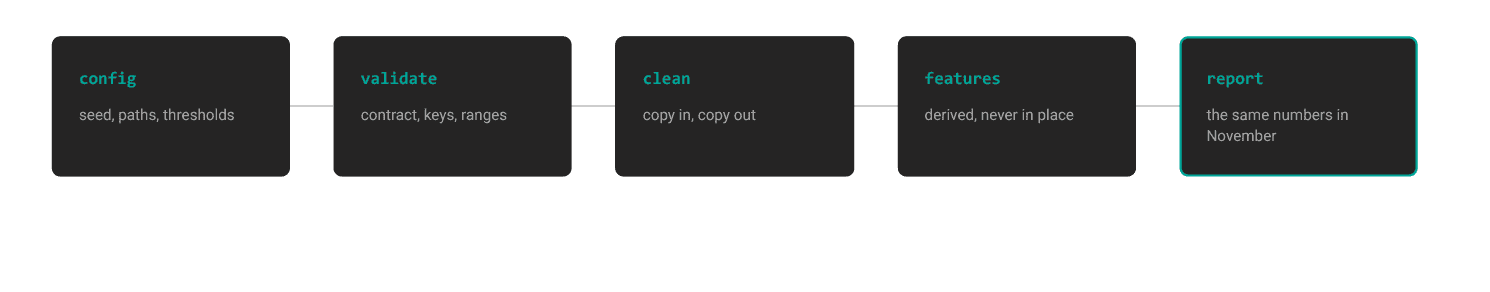
การสร้างนิสัยเพื่อป้องกันปัญหานี้มีต้นทุนที่ต่ำมาก โดยเราจะนำเทคนิคทั้งหมดมาใช้กับชุดข้อมูลจริง และควบคุมให้โค้ดทั้งหมดอยู่ภายใต้ 100 บรรทัดของ Pandas
ข้อมูล (The Data)
ในบทความนี้ เราจะใช้ตาราง olympics_athletes_events จาก คำถามสัมภาษณ์ นี้
ข้อมูลประกอบด้วยนักกีฬา 336 คน จากการแข่งขัน 15 ครั้ง รวม 352 แถว ซึ่งมีรายละเอียดสำคัญคือคอลัมน์เหรียญรางวัล (medal) ที่มีข้อมูลอยู่ 120 แถว ส่วนช่องว่างหมายถึงนักกีฬาไม่ได้รับเหรียญในรายการนั้นๆ
ตัวอย่างข้อมูล:
| id | name | sex | age | height | team | noc | year | sport | medal |
|---|---|---|---|---|---|---|---|---|---|
| 3520 | Guillermo J. Amparan | M | Mexico | MEX | 1924 | Athletics | |||
| 35394 | Henry John Finchett | M | Great Britain | GBR | 1924 | Gymnastics | |||
| 21918 | Georg Frederik Ahrensborg Clausen | M | 28.0 | Denmark | DEN | 1924 | Cycling | ||
| 110345 | Marinus Cornelis Dick Sigmond | M | 26.0 | Netherlands | NED | 1924 | Football | ||
| … | … | … | … | … | … | … | … | … | … |
| 999998 | John Testman | M | 30.0 | 180.0 | Canada | CAN | 2004 | Athletics | Bronze |
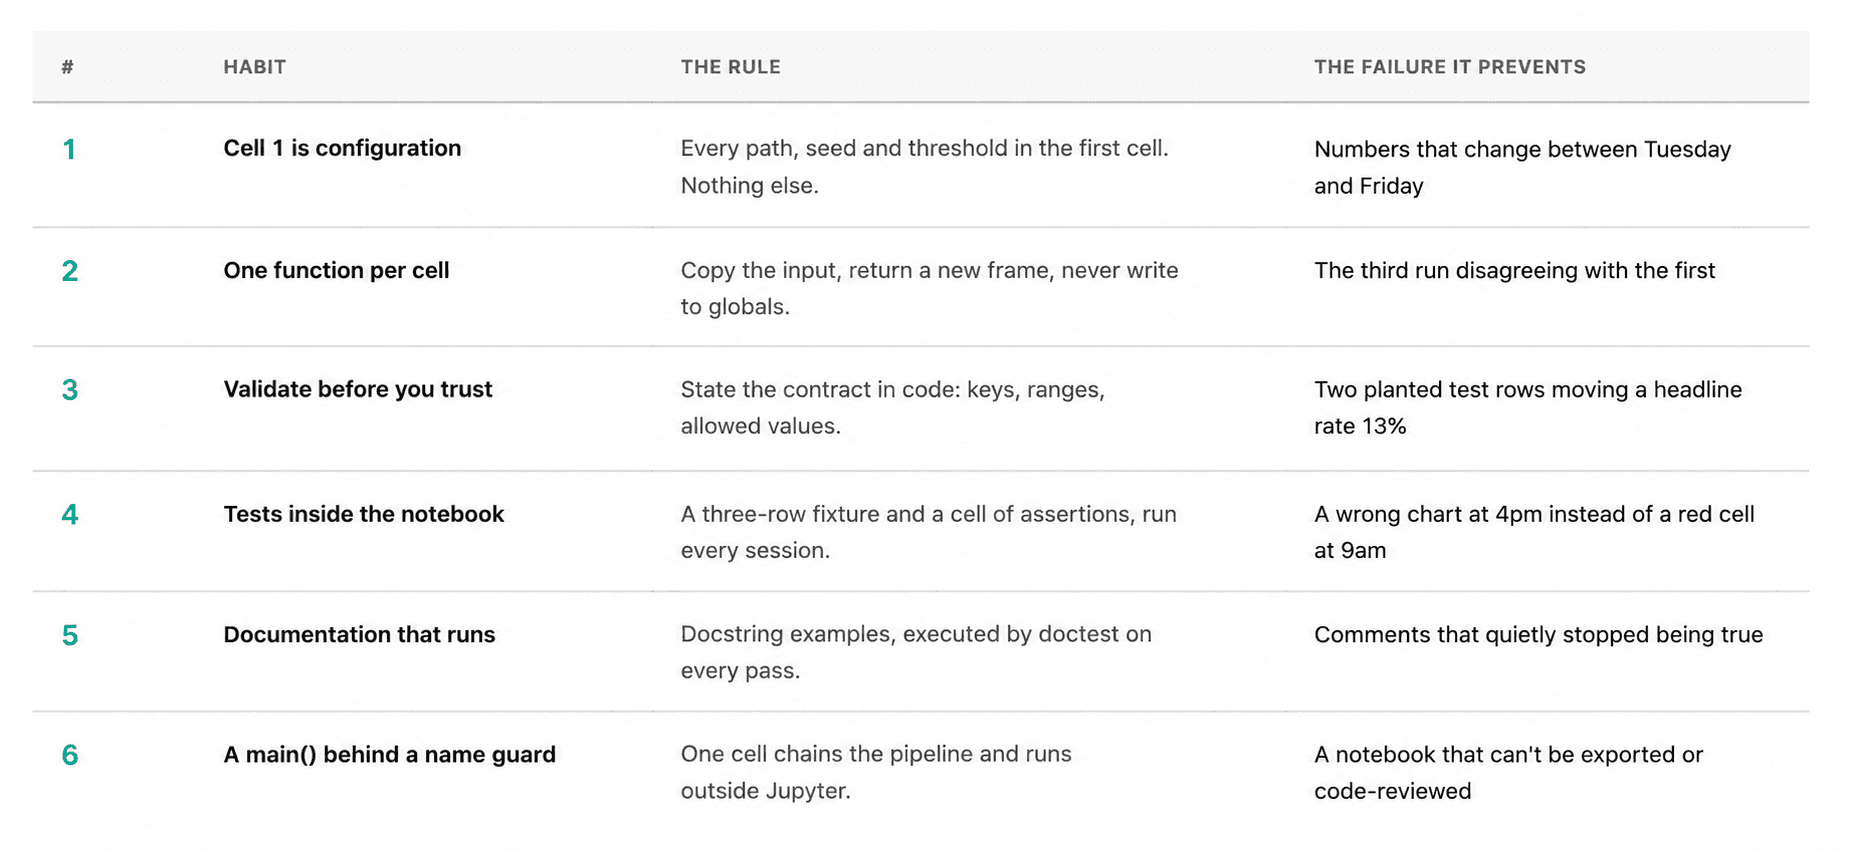
นิสัยที่ 1: รวมการตั้งค่าทั้งหมดไว้ใน Cell แรก
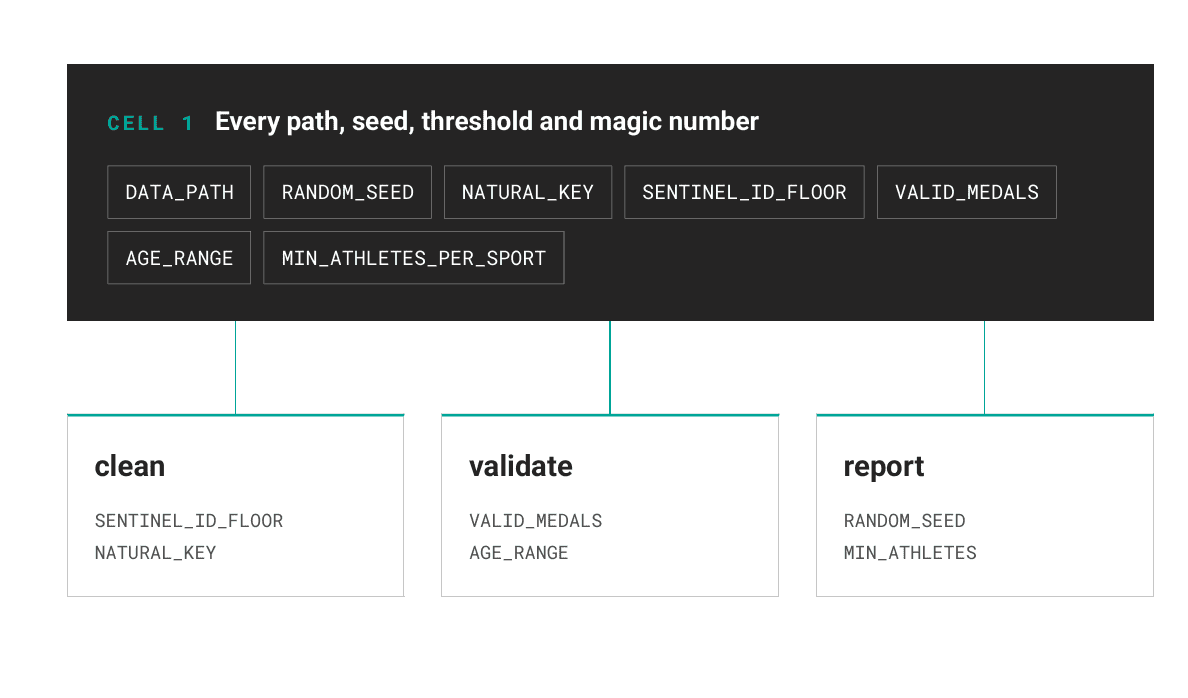
ทุกค่าคงที่ ไม่ว่าจะเป็น path, seed, threshold หรือ magic number ควรอยู่ใน cell แรกเพียงที่เดียวและไม่มีโค้ดส่วนอื่นปน
from pathlib import Path
import pandas as pd

DATA_PATH = Path("olympics_athletes_events.csv")
RANDOM_SEED = 42

NATURAL_KEY = ["id", "games", "event"]
SENTINEL_ID_FLOOR = 900_000   # real athlete ids in this extract stop at 134205
VALID_SEXES = {"M", "F"}
VALID_MEDALS = {"Gold", "Silver", "Bronze"}
AGE_RANGE = (10, 75)
HEIGHT_RANGE_CM = (120, 230)
WEIGHT_RANGE_KG = (25, 220)
MIN_ATHLETES_PER_SPORT = 5
วิธีนี้ช่วยให้ผู้ที่มาอ่าน Notebook ในภายหลังเห็นข้อสันนิษฐานทั้งหมดได้ทันทีโดยไม่ต้องเลื่อนหน้าจอ และเมื่อต้องแก้ไขค่าต่างๆ ก็มีจุดให้จัดการเพียงจุดเดียวเท่านั้น
นอกจากนี้ ค่า seed มีความสำคัญอย่างยิ่งต่อความน่าเชื่อถือ ไม่ว่าจะเป็นการใช้ df.sample(), train/test split หรือ k-means เพราะ Notebook ที่ให้ผลลัพธ์ต่างกันทุกครั้งที่รันจะขาดความน่าเชื่อถือทันที
นิสัยที่ 2: เขียนหนึ่งฟังก์ชันต่อหนึ่ง Cell
กฎสำคัญคือ หนึ่ง cell ต้องทำหน้าที่เพียงอย่างเดียว คือนิยามฟังก์ชันหรือเรียกใช้ฟังก์ชัน ห้ามทำทั้งสองอย่าง และห้ามแก้ไขตัวแปรที่สร้างจาก cell อื่นโดยตรง
def load_raw(path: Path) -> pd.DataFrame:
    """Read the Olympics CSV with no cleaning applied."""
    return pd.read_csv(path)

def clean(df: pd.DataFrame) -> pd.DataFrame:
    """Drop test rows and duplicate entries, then encode 'no medal' explicitly."""
    out = df[df["id"] < SENTINEL_ID_FLOOR].copy()
    out = out.drop_duplicates(subset=NATURAL_KEY, keep="first")
    out["medal"] = out["medal"].fillna("None")
    out["sex"] = out["sex"].astype("category")
    out["season"] = out["season"].astype("category")
    return out.reset_index(drop=True)

def add_features(df: pd.DataFrame) -> pd.DataFrame:
    """Add decade, is_medalist and bmi. Never mutates the input frame."""
    out = df.copy()
    out["decade"] = (out["year"] // 10) * 10
    out["is_medalist"] = out["medal"].ne("None")
    out["bmi"] = bmi(out["weight"], out["height"])
    return out
การใช้ .copy() ในบรรทัดแรกของฟังก์ชันเป็นเทคนิคสำคัญที่ป้องกันไม่ให้เกิดการเขียนทับข้อมูลเดิม ทำให้ลำดับการรัน cell ไม่ส่งผลเสียต่อผลลัพธ์ และช่วยแก้ปัญหาคลาสสิกที่การรันครั้งที่สองให้ผลต่างจากครั้งแรก
นิสัยที่ 3: ตรวจสอบความถูกต้องของข้อมูล (Validation)
อย่าเชื่อใจข้อมูลจนกว่าจะได้รับการตรวจสอบ ให้เขียนเงื่อนไขที่คุณคาดหวังลงไปเพื่อให้ Notebook ช่วยยืนยันความถูกต้อง
def validate_raw(df: pd.DataFrame) -> list[str]:
    """Return a list of contract violations. An empty list means the data is usable."""
    problems = []

expected = {"id", "sex", "age", "height", "weight", "year", "sport", "event",
                "medal", "games", "team"}
    missing = expected - set(df.columns)
    if missing:
        problems.append(f"missing columns: {sorted(missing)}")
        return problems

dupes = df.duplicated(subset=NATURAL_KEY).sum()
    if dupes:
        problems.append(f"{dupes} duplicate rows on {NATURAL_KEY}")

sentinels = df.loc[df["id"] >= SENTINEL_ID_FLOOR, "id"]
    if len(sentinels):
        found = sorted(int(i) for i in sentinels.unique())
        problems.append(f"{len(sentinels)} sentinel ids: {found}")

bad_sex = set(df["sex"].dropna().unique()) - VALID_SEXES
    if bad_sex:
        problems.append(f"unexpected sex values: {bad_sex}")

bad_medal = set(df["medal"].dropna().unique()) - VALID_MEDALS
    if bad_medal:
        problems.append(f"unexpected medal values: {bad_medal}")

for col, (lo, hi) in [("age", AGE_RANGE),
                          ("height", HEIGHT_RANGE_CM),
                          ("weight", WEIGHT_RANGE_KG)]:
        out = df[col].dropna()
        n = ((out < lo) | (out > hi)).sum()
        if n:
            problems.append(f"{n} {col} values outside {lo}-{hi}")

return problems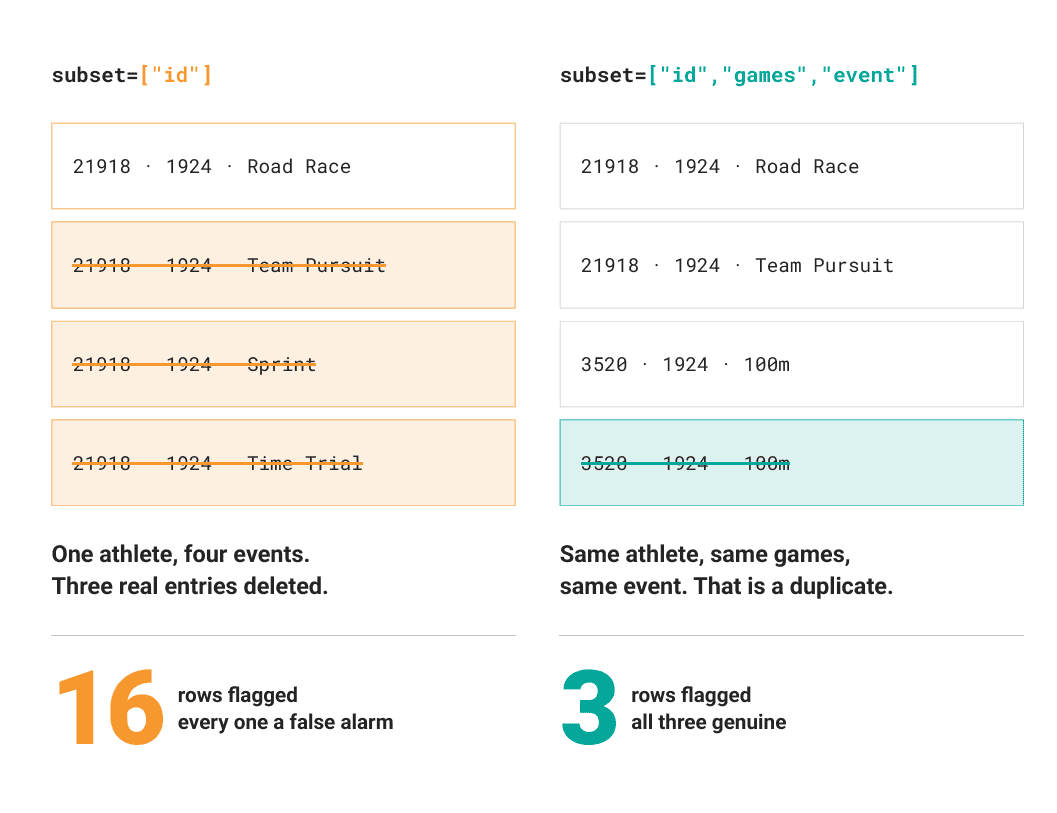
ตัวอย่างเช่น การตรวจสอบข้อมูลซ้ำโดยใช้ Natural Key (id, games, event) จะช่วยป้องกันการลบข้อมูลที่ถูกต้องออกไป ในขณะที่การเช็ค Sentinel IDs ช่วยดักจับข้อมูลทดสอบ (เช่น "John Testman") ที่อาจปนมาและทำให้ค่าสถิติผิดเพี้ยนไปถึง 13%
นิสัยที่ 4: เขียนการทดสอบ (Tests) ไว้ใน Notebook
คุณสามารถใช้การทำ Assertion ง่ายๆ เพื่อตรวจสอบฟังก์ชันได้โดยไม่ต้องพึ่งพาเครื่องมือภายนอกอย่าง pytest
def _fixture() -> pd.DataFrame:
    return pd.DataFrame({
        "id": [1, 1, 2],
        "games": ["1924 Summer"] * 3,
        "event": ["Rings", "Rings", "Rings"],
        "sex": ["M", "M", "F"],
        "age": [24.0, 24.0, None],
        "height": [180.0, 180.0, 165.0],
        "weight": [81.0, 81.0, 55.0],
        "year": [1924, 1924, 1924],
        "season": ["Summer"] * 3,
        "sport": ["Gymnastics"] * 3,
        "medal": ["Gold", "Gold", None],
        "team": ["Denmark"] * 3,
    })

def run_tests() -> None:
    fx = _fixture()

assert len(clean(fx)) == 2, "clean() must drop the duplicate entry"
    assert clean(fx)["medal"].tolist() == ["Gold", "None"], "missing medal becomes 'None'"

before = fx.copy()
    add_features(fx)
    pd.testing.assert_frame_equal(fx, before)   # add_features must not mutate

feat = add_features(clean(fx))
    assert feat["is_medalist"].tolist() == [True, False]
    assert round(feat.loc[0, "bmi"], 1) == 25.0
    assert feat["decade"].unique().tolist() == [1920]

assert validate_raw(fx) == [f"1 duplicate rows on {NATURAL_KEY}"]
    assert "missing columns" in validate_raw(pd.DataFrame({"id": [1]}))[0]

planted = pd.concat([fx, fx.iloc[[2]].assign(id=999999)], ignore_index=True)
    assert any("sentinel" in p for p in validate_raw(planted))
    assert 999999 not in clean(planted)["id"].values

print("all 10 checks passed")
การรัน assertions เหล่านี้ช่วยให้คุณรู้ตัวทันทีหากโค้ดที่แก้ไขใหม่ไปทำลายตรรกะเดิม ซึ่งดีกว่าการไปพบข้อผิดพลาดในภายหลังตอนที่ต้องส่งงาน
นิสัยที่ 5: เขียนเอกสารที่ตรวจสอบได้จริง
ใช้ doctest เพื่อให้ตัวอย่างในเอกสารกำกับโค้ด (Docstring) ถูกรันและตรวจสอบความถูกต้องอยู่เสมอ
def bmi(weight_kg: float, height_cm: float) -> float:
    """Body mass index in kg/m2.

>>> round(bmi(81.0, 180.0), 1)
    25.0
    >>> round(bmi(55.0, 165.0), 1)
    20.2
    """
    return weight_kg / (height_cm / 100) ** 2

import doctest
doctest.run_docstring_examples(bmi, globals(), name="bmi", verbose=True)
นิสัยที่ 6: ทำให้ Notebook รันเป็น Script ได้
การใช้บล็อก if __name__ == "__main__" ใน cell สุดท้าย จะช่วยให้ Notebook สามารถถูกแปลงเป็น script และถูก import ไปใช้งานในที่อื่นได้โดยไม่เกิดผลกระทบข้างเคียง
def main() -> pd.DataFrame:
    raw = load_raw(DATA_PATH)
    problems = validate_raw(raw)
    df = add_features(clean(raw))

print("\nspot check:")
    print(df.sample(3, random_state=RANDOM_SEED)[["name", "year", "sport", "medal", "bmi"]])

report = medal_rate_by_sport(df)
    return report

if __name__ == "__main__":
    run_tests()
    doctest.run_docstring_examples(bmi, globals(), name="bmi", verbose=True)
    main()
บทสรุป
การสละเวลาเพิ่มเพียงเล็กน้อยเพื่อสร้างนิสัยเหล่านี้ จะช่วยให้ Notebook ของคุณยังคงให้ผลลัพธ์ที่ถูกต้องแม้เวลาจะผ่านไปนานเพียงใด
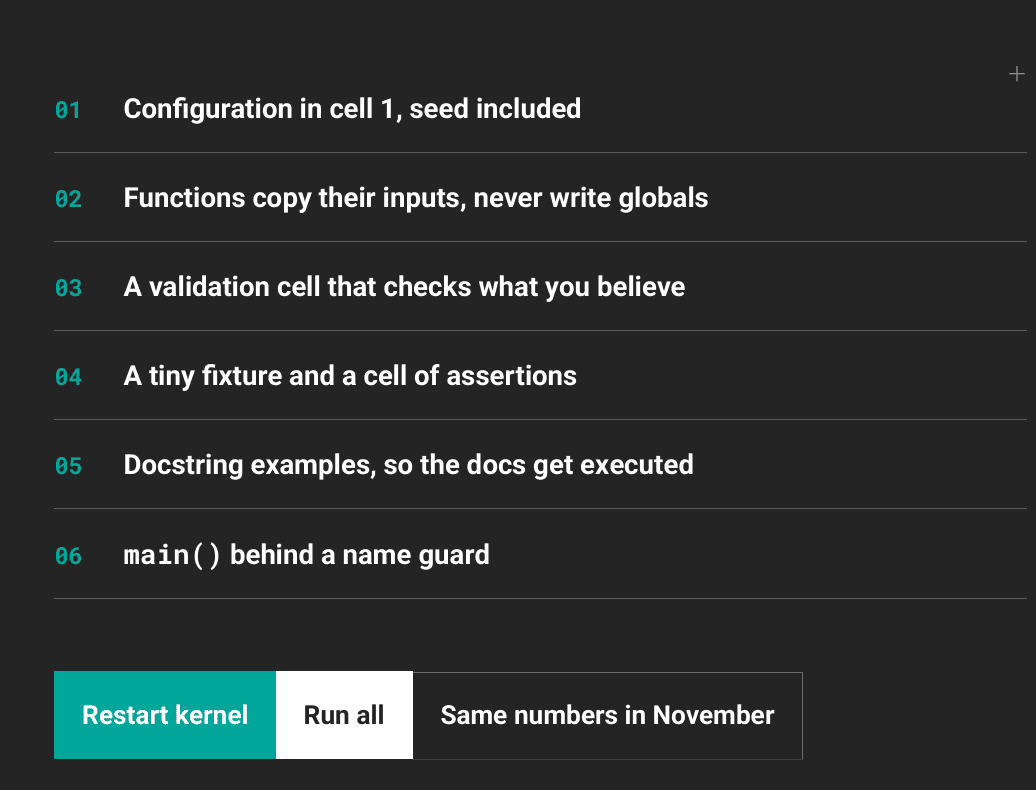
จำไว้ว่าหากคุณกด Restart kernel และ Run all แล้วมันยังทำงานได้ถูกต้อง นั่นหมายความว่า Notebook ของคุณยังมีชีวิตอยู่และพร้อมใช้งานเสมอ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร