
ทำไมงาน Fine-Tuning ใช้เวลานานกว่าที่ค่า FLOPs บอกไว้
การพยากรณ์เวลา fine-tuning แบบ end-to-end บนคลัสเตอร์ GPU ที่ใช้งานร่วมกัน จากการรันในสภาพแวดล้อมจริง 272 ครั้ง
พรีวิวของเปเปอร์ที่กำลังจะมาถึงของเรา Predicting End-to-End Fine-Tuning Time for Generative Language Models เวอร์ชันเต็มจะลงบน arXiv เร็วๆ นี้
GPU เป็นทรัพยากรที่มีราคาสูงและหายากที่สุดในวงการ AI ปัจจุบัน ผู้ดูแลคลัสเตอร์ต้องตัดสินใจทุกวันว่าจะรันงานไหนบน GPU ตัวใดและลำดับอย่างไร แผนงานจะมีประสิทธิภาพได้ก็ต่อเมื่อมีการประมาณการเวลาที่แม่นยำ หากงานเสร็จก่อนเวลา GPU จะถูกปล่อยว่างทิ้งไว้ แต่หากงานรันเกินเวลา คิวงานที่รออยู่ก็จะล่าช้าและส่งผลกระทบต่อกำหนดการส่งมอบงานทั้งหมด
การประมาณการที่ดีจะเปลี่ยนการคาดเดาให้เป็นการวางแผนที่แม่นยำ ช่วยลดกำลังการผลิตที่ว่างเปล่าลง อย่างไรก็ตาม ทีมส่วนใหญ่มักใช้วิธีคำนวณค่า FLOP แบบคร่าวๆ (back-of-the-envelope) ซึ่งมักผิดพลาด เช่น พยากรณ์ว่าใช้เวลา 9 ชั่วโมง แต่ความจริงกลับลากยาวไปถึงบ่ายวันถัดไป
เราจึงนำงาน supervised fine-tuning (SFT) จริงจำนวน 272 งานจากคลังผลิต NVIDIA H200 GPU ของเรา (รวมประมาณ 7,382 GPU-hours) มาเปรียบเทียบระหว่างการประมาณการเชิงวิเคราะห์กับตัวพยากรณ์ที่ผ่านการเรียนรู้มาแล้ว (learned predictors)
สรุปคือการประมาณการตาม FLOP ปกติแทบอธิบายสิ่งที่เกิดขึ้นจริงไม่ได้เลย (R² = 0.31, MAE 12.41 ชม.) แต่โมเดล CatBoost regressor ที่วิเคราะห์ข้อมูลก่อนส่งเข้าคิวสามารถทำได้ถึง R² = 0.98 โดยมีความผิดพลาดเฉลี่ยเพียง 1.71 ชม. ช่องว่างนี้เกิดจากตัว regressor สามารถมองเห็นสัญญาณเฉพาะของการเทรนได้มากกว่า เช่น จังหวะการทำ evaluation, นโยบาย checkpoint และโหลดต่อ GPU รวมถึงเรียนรู้ปฏิสัมพันธ์แบบไม่เป็นเส้นตรง (nonlinear interactions) จากข้อมูลในอดีต
การประมาณการที่ทุกคนใช้คือการคิดเฉพาะค่า compute เท่านั้น
สำหรับ Transformer แบบ dense ค่าใช้จ่ายในการเทรนจะอยู่ที่ประมาณ 6·P·D floating-point operations (P คือจำนวน parameter และ D คือจำนวน training tokens) เมื่อหารด้วยประสิทธิภาพของ GPU จะได้เวลา training-loop:
T_theoretical = (6 · P · D) / (N_GPU · FLOPS_peak · MFU)ในสูตรนี้ N_GPU คือจำนวน GPU, FLOPS_peak คือค่า throughput สูงสุดตามสเปก และ MFU (Model FLOPs Utilization) คือสัดส่วนที่ทำได้จริง ซึ่งมักอยู่ที่ 30% ถึง 60% เนื่องจากติดปัญหาเรื่องทราฟฟิกหน่วยความจำและการสื่อสาร
อย่างไรก็ตาม งานหนึ่งงานมีรายละเอียดมากกว่าแค่ loop ของมัน ตั้งแต่การตั้งค่าสภาพแวดล้อม การโหลดโมเดล การทำ tokenization ไปจนถึงการ evaluation และการอัปโหลด checkpoint ซึ่งต้องแย่งชิง I/O ของเครือข่ายและพื้นที่จัดเก็บข้อมูลกับงานอื่นๆ บนคลัสเตอร์
ค่าโสหุ้ย (overheads) เหล่านี้ขึ้นอยู่กับการกำหนดค่าและไม่ได้ขยายตัวตามปริมาณงานอย่างเป็นระเบียบ ทำให้งานสองงานที่มีค่า compute เท่ากันอาจเสร็จห่างกันหลายชั่วโมง เพื่อความยุติธรรม เราจึงรวมทั้ง evaluation tokens และทดสอบค่า MFU ในช่วงที่กว้างในการเปรียบเทียบครั้งนี้
สิ่งที่เราสร้างขึ้น
เรามองระยะเวลาแบบ end-to-end เป็นปัญหา supervised regression โดยใช้ feature vector จากการกำหนดค่างานและ metadata เพื่อพยากรณ์เวลาจริง (wall-clock time) ตั้งแต่งานได้รับ GPU จนเสร็จสิ้น (ไม่รวมเวลารอในคิว)
ทางเลือกสำคัญสองประการในการออกแบบคือ:
- ต้องรู้ทุกอย่างก่อนการส่งงาน (dispatch): ข้อมูลนำเข้ามาจาก hyperparameters, ขนาด dataset และการจัดสรร GPU โดยไม่มีการใช้ log ขณะรัน เพื่อให้ใช้งานจริงได้ในการจัดตารางงาน (scheduling)
- Features ที่เผยให้เห็นค่าโสหุ้ย: เราดึงค่าอย่าง
num_eval_data,num_saves,num_params_savedและปริมาณ token ต่อ GPU มาใช้ รวมถึงใส่ค่าประมาณการ FLOP เดิมเป็นหนึ่งใน feature (baseline_time) เพื่อให้โมเดลเรียนรู้การปรับปรุงค่าจากฐานเดิม
เราเปรียบเทียบ Linear Regression, Ridge, XGBoost และ CatBoost โดยใช้เทคนิคกรองความสัมพันธ์และ grid search จนได้โมเดล CatBoost ขั้นสุดท้ายที่ใช้ 24 features
ข้อมูล
- SFT 272 รอบ จาก log จริงในระดับองค์กร ครอบคลุมโมเดลสูงสุด 1.5 หมื่นล้านพารามิเตอร์ ทั้งแบบ LoRA และ full fine-tuning
- โครงสร้างพื้นฐานที่ใช้งานร่วมกัน: รันบน GPU H200 จำนวน 1, 2 หรือ 4 ตัว ร่วมกับงานเทรนและ inference อื่นๆ เพื่อวัดผลจากการแย่งชิงทรัพยากรจริง
- ระยะเวลา: ตั้งแต่ 1.6 ถึง 172.4 ชั่วโมง (เฉลี่ย 23.43 ชม.)
- Stack: ใช้ Hugging Face Transformers และ Unsloth โดยกำหนดให้เป็น categorical feature
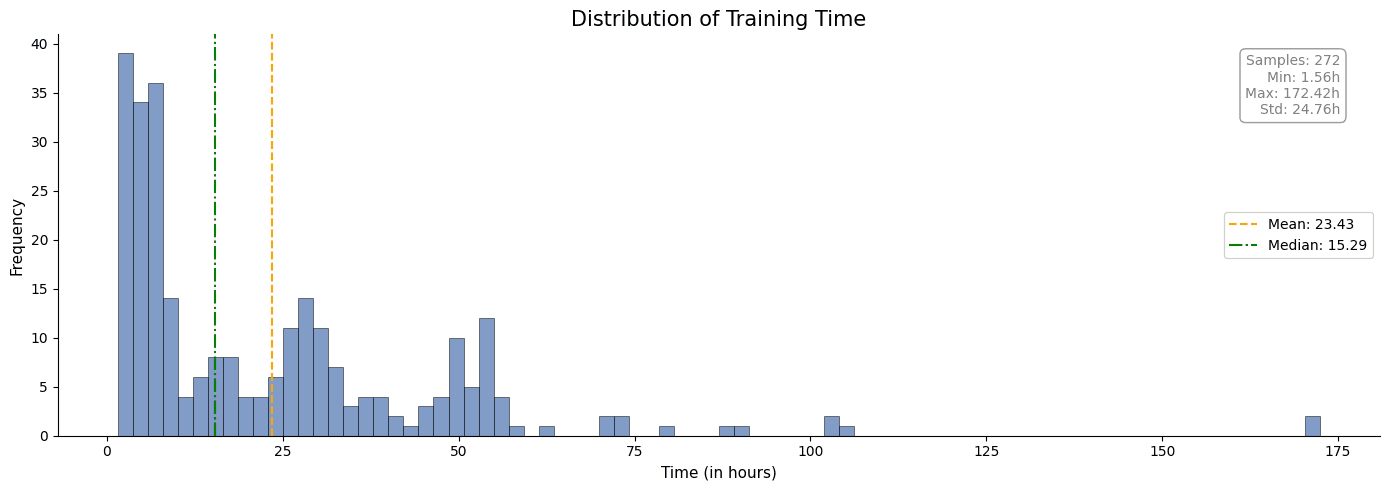
การกระจายของระยะเวลา end-to-end ในการรัน 272 ครั้ง เฉลี่ย 23.43 ชม. มัธยฐาน 15.29 ชม.
ผลลัพธ์
ข้อมูลจากการทำ stratified 5-fold cross-validation แสดงให้เห็นว่าโมเดลเชิงวิเคราะห์แบบเดิมมีความคลาดเคลื่อนสูง
| Model | R² | RMSE (h) | MAE (h) |
|---|---|---|---|
| FLOP baseline (MFU 30%) | 0.31 | 20.45 | 12.41 |
| FLOP baseline (MFU 45%) | 0.18 | 22.38 | 13.01 |
| FLOP baseline (MFU 60%) | 0.01 | 24.56 | 14.62 |
| Calculon | −0.51 | 30.40 | 20.36 |
| Linear Regression | 0.69 ± 0.14 | 13.52 ± 4.23 | 7.52 ± 0.49 |
| Ridge | 0.73 ± 0.09 | 12.72 ± 3.70 | 7.23 ± 0.68 |
| XGBoost | 0.97 ± 0.01 | 4.18 ± 1.17 | 1.95 ± 0.32 |
| CatBoost | 0.98 ± 0.01 | 3.52 ± 0.78 | 1.71 ± 0.33 |
ประเด็นที่น่าสนใจคือไม่มีค่า MFU ใดที่แก้ไขค่า FLOP baseline ได้อย่างสมบูรณ์ แม้แต่โมเดลเชิงวิเคราะห์ที่ละเอียดอย่าง Calculon ก็ยังพยากรณ์งานระดับการผลิตได้แม่นยำเพียง 11% ของเวลาจริง เพราะมีปัจจัยนอกเหนือจากขั้นตอน optimization มากเกินไป
โมเดลเชิงเส้นช่วยลดความคลาดเคลื่อนได้ในระดับหนึ่ง แต่โมเดลกลุ่ม Gradient boosting อย่าง CatBoost และ XGBoost ให้ผลลัพธ์ที่โดดเด่นที่สุด โดยเราเลือก CatBoost เพราะมีค่าความผิดพลาดเฉลี่ยต่ำที่สุด
สิ่งที่ตัวพยากรณ์ให้ความสำคัญ
ความสำคัญของ feature ใน CatBoost กระจุกตัวอยู่ที่ตัวแปรของ model, workload และที่สำคัญคือการ evaluation และ checkpoint โดย num_eval_data (จำนวนตัวอย่างที่ประมวลผลตอน evaluation) อยู่อันดับหนึ่ง ตามด้วยจำนวนพารามิเตอร์ที่เทรนได้ และ I/O ของ checkpoint
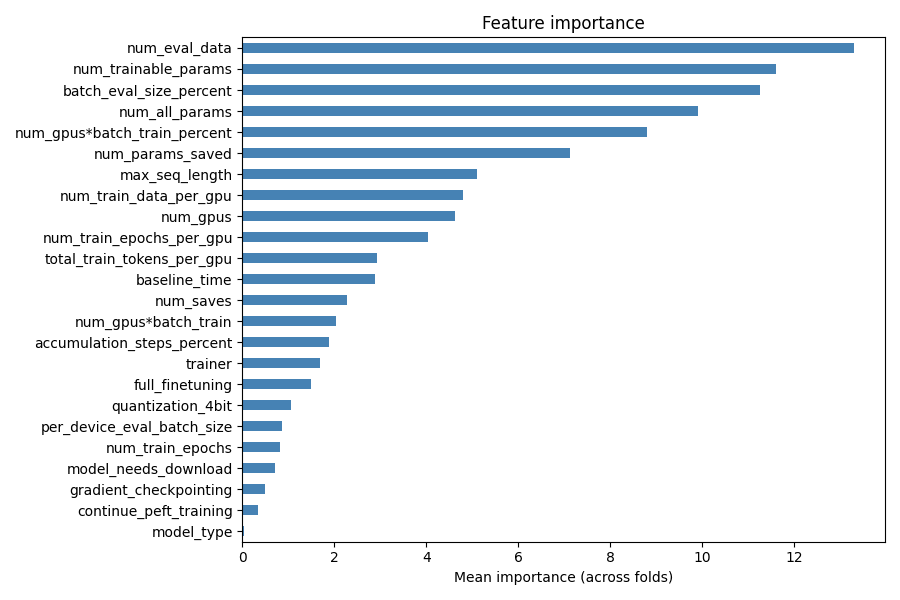
ค่าความสำคัญของ feature เฉลี่ยของโมเดล CatBoost ในแต่ละ fold (PredictionValuesChange)
ข้อมูลเหล่านี้ชี้ว่า ความถี่และขนาดของการ evaluation รวมถึงจำนวนจุด checkpoint เป็นตัวกำหนดเวลาจริงร่วมกับขนาดของโมเดลและชุดข้อมูล ซึ่งมักเป็นสิ่งที่ผู้ใช้กำหนดตามความเคยชินในไฟล์ config
ความผิดพลาดมากน้อยเพียงใดและที่ไหน
จากการพยากรณ์ 272 รายการ พบว่า 80% มีความคลาดเคลื่อนอยู่ในระยะ 2.20 ชม. และ 90% อยู่ในระยะ 4.31 ชม. โดยงานที่รันไม่เกิน 60 ชั่วโมง โมเดลสามารถพยากรณ์ได้แม่นยำมาก แต่จะเริ่มมีปัญหาในงานที่ยาวกว่านั้นเนื่องจากมีข้อมูลตัวอย่างน้อยเกินไป
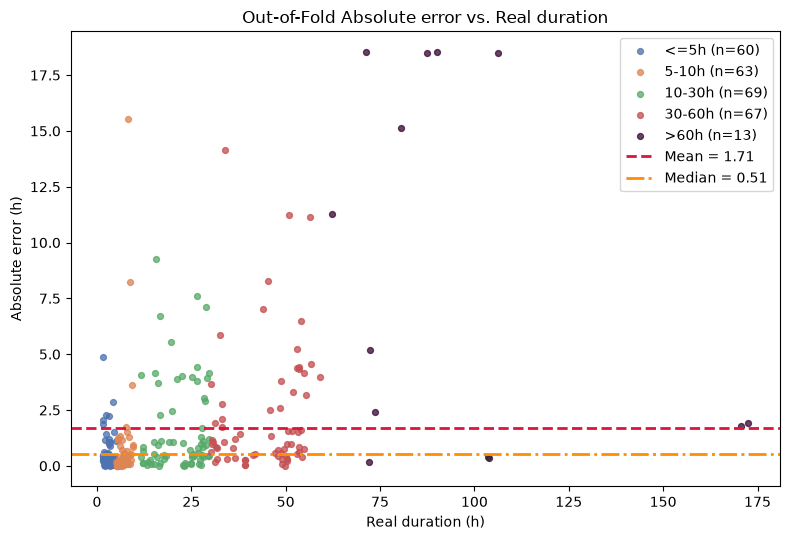
ค่าความผิดพลาดสัมบูรณ์เทียบกับระยะเวลาจริง ความผิดพลาดยังคงต่ำจนถึง 60 ชม. และกว้างขึ้นในส่วนท้ายของข้อมูลที่เบาบาง
สิ่งนี้มีประโยชน์อย่างไร
ในทางปฏิบัติ ตัวพยากรณ์นี้ช่วยให้ผู้จัดตารางงาน (scheduler) สามารถวางแผนล่วงหน้าได้ว่า งานใดควรรันพร้อมกัน GPU จะว่างเมื่อไหร่ และงานจะเสร็จทันกำหนดการหรือไม่
ข้อจำกัด
- เฉพาะ SFT เท่านั้น: ยังไม่รวม RLHF, DPO หรือ RLVR
- GPU ประเภทเดียว: ทดสอบเฉพาะ H200 หากใช้ GPU รุ่นอื่นต้องเทรนโมเดลใหม่ด้วยข้อมูลฮาร์ดแวร์ที่เกี่ยวข้อง
- งานระยะยาวมีน้อย: ความแม่นยำลดลงเมื่องานเกิน 60 ชั่วโมง
เป้าหมายถัดไปคือการเพิ่มข้อมูลบรรยายฮาร์ดแวร์เพื่อรองรับ GPU หลายประเภท และขยายขอบเขตไปยังวัตถุประสงค์การเทรนแบบอื่นๆ
ขั้นตอนต่อไป
เปเปอร์ฉบับเต็มจะเผยแพร่บน arXiv เร็วๆ นี้ คุณสามารถติดตาม Dharma-AI บน Hugging Face เพื่อรับการแจ้งเตือน และร่วมแลกเปลี่ยนวิธีการประมาณเวลางานบนคลัสเตอร์ของคุณได้ในส่วนความคิดเห็น
อ่านเพิ่มเติม
- GPU Management: Why Idle GPUs Are the New Grounded Aircraft
- Same Cluster, 33 Points More Utilization: What Changed Was the Order
- How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
- Specialization Beats Scale: A Strategic Variable Most AI Procurement Decisions Overlook
- Why Specialization Is Inevitable
- Newer Models, Same Advantage
- Direct Preference Optimization Beyond Chatbots
- Text Degeneration: A Production Failure Mode That Most Benchmarks Do Not Track
Dharma-AI R&D · We Make AI Your Model
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร