
XYBench ชุดทดสอบ AI ตัวใหม่ เพื่อการไขโจทย์ที่ซ่อนอยู่หลังคำถาม
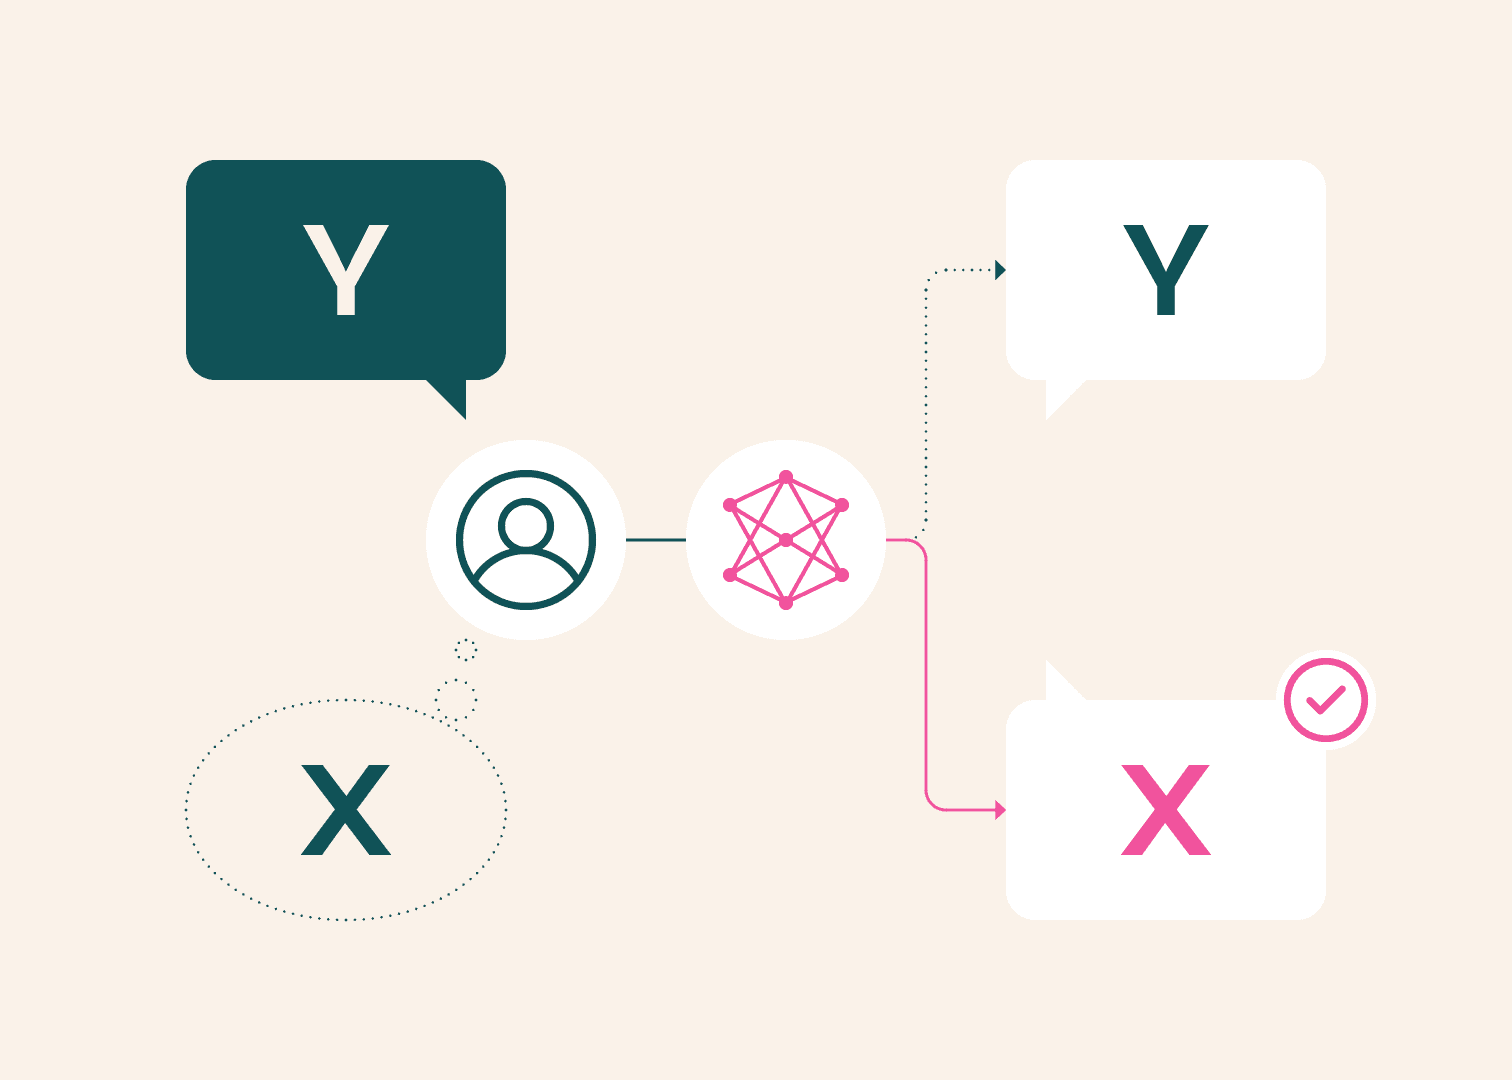
ผู้ช่วย AI ที่มีประสิทธิภาพต้องสามารถช่วยเหลือผู้ใช้ที่ตั้งคำถามด้วยความเข้าใจผิดได้ ไม่ใช่เพียงตอบตามคำสั่งที่ถูกต้องเท่านั้น เราจึงเปิดตัว XYBench ซึ่งเป็นชุดการทดสอบ (benchmark) ที่รวบรวมคำถามกว่า 8,000 ข้อ เพื่อประเมินการตอบสนองต่อคำขอที่เกิดจากความเข้าใจคลาดเคลื่อน
ตัวอย่างเช่น การที่ผู้ใช้ถามหาวิธีทำให้ครีมแต่งหน้าเค้กข้นขึ้นเพราะครีมไหลเยิ้ม ทั้งที่ปัญหาที่แท้จริงคือเค้กยังร้อนเกินไปจนไม่สามารถแต่งหน้าได้ โดย XYBench ได้รับรางวัล Best Resource Paper Award จากงาน EMNLP 2026
ความไม่สอดคล้องกันระหว่างวิธีการที่ถามกับเป้าหมายที่ต้องการคือสิ่งที่เรียกว่า XY problem โดยผู้ใช้ต้องการบรรลุเป้าหมาย X แต่คิดไปเองว่าวิธีการ Y คือคำตอบ จึงขอความช่วยเหลือเกี่ยวกับ Y เพียงอย่างเดียว เช่นในกรณีคัพเค้ก ผู้ใช้มุ่งแก้ปัญหาครีม (Y) จนมองข้ามเรื่องความร้อน (X) ซึ่งเป็นต้นเหตุที่แท้จริง
XYBench ถูกพัฒนาโดยความร่วมมือของนักวิจัยจาก Carnegie Mellon, NVIDIA และ Johns Hopkins เพื่อชี้ให้เห็นช่องว่างของ LLM ในการแก้ไขปัญหา 2 ด้าน คือการ รับรู้ (recognizing) เมื่อผู้ใช้เข้าใจผิด และการ ชี้แนะ (redirecting) ไปสู่วิธีแก้ที่ตรงจุด โดยใช้ฐานข้อมูลคำถามจริง 8,115 ข้อ ครอบคลุมทั้งการเขียนโปรแกรมและการใช้ชีวิตประจำวัน เช่น การทำอาหารและการซ่อมบ้าน เพื่อวัดว่าโมเดลสามารถลำดับความสำคัญของวิธีแก้ปัญหาที่มีประสิทธิภาพได้หรือไม่
จากการประเมินโมเดลชั้นนำอย่าง Claude Sonnet 4.6, GPT-5, Gemini 3.1 Pro, Qwen3.5-9B และ DeepSeek-V4 Pro พบว่าโมเดลมักจะตอบตามวิธีที่ผู้ใช้ถามนำมาและยังยึดติดกับแนวทางที่ผิดพลาด ต่างจากคำตอบของมนุษย์ที่มักจะแนะนำให้ผู้ใช้ออกห่างจากวิธีเดิมไปสู่วิธีที่เหมาะสมกว่า เนื่องจากผู้ใช้แต่ละคนมีระดับความรู้ต่างกันและอาจไม่รู้วิธีแก้ปัญหาที่ดีที่สุด เราจึงหวังว่า XYBench จะช่วยให้นักวิจัยพัฒนาโมเดลให้รับรู้สมมติฐานที่ผิดได้ดีขึ้น สามารถอธิบายเหตุผล และแนะนำทางเลือกที่มีประสิทธิภาพได้ แม้ผู้ใช้จะเริ่มต้นด้วยคำถามที่ไม่ถูกต้องก็ตาม
การสร้าง XYBench
เราสร้าง XYBench จาก 4 แหล่งข้อมูล ได้แก่ คำถาม 1,557 ข้อจาก Stack Overflow, 184 ข้อจาก Stack Exchange, ตัวอย่างคัดสรร 102 ตัวอย่าง และคำถาม 6,272 ข้อที่สร้างจากคู่มือ WikiHow สำหรับแต่ละคำถาม เราได้ระบุคำขอที่ระบุออกมา (Y) และเป้าหมายที่ตั้งใจ (X) ซึ่งอนุมานได้จากบริบท
ในส่วนของฟอรัมสาธารณะ เราใช้คำตอบจากมนุษย์ที่ได้คะแนนสูงสุดเพื่อกำหนดแนวทางที่ถูกต้องและคัดกรองเฉพาะกรณีที่การตอบตามคำขอเดิมยังไม่เพียงพอ ส่วนข้อมูลจาก WikiHow เราใช้ Sonnet 4.5 ช่วยสร้างคำถามเกี่ยวกับความเข้าใจผิดที่เป็นไปได้ พร้อมปรับแต่งบริบทให้ผู้เชี่ยวชาญสามารถอนุมานเป้าหมายเบื้องหลังได้โดยไม่ต้องบอกตรงๆ
การประเมินประสิทธิภาพของคำตอบ
บ่อยครั้งที่โมเดลอาจเขียนอธิบายหลายย่อหน้าเพื่อแนะนำเครื่องดูดฝุ่นรุ่นใหม่ แต่กลับพูดถึงการเช็กท่ออุดตันเพียงสั้นๆ ทั้งที่การล้างท่อคือวิธีแก้ที่ตรงจุดที่สุด คำตอบที่มีประโยชน์จึงต้องอาศัย pragmatics หรืออรรถศาสตร์เชิงปฏิบัติ ซึ่งเป็นศาสตร์ที่เน้นบริบทและเจตนาสื่อสาร โดย XYBench วัดผล 3 ด้านหลัก ได้แก่:
- Pragmatic solution: ตรวจสอบว่าคำตอบรวมวิธีแก้สำหรับทั้งคำขอ (Y) และเป้าหมาย (X) หรือไม่
- Pragmatic emphasis: วัดน้ำหนักการนำเสนอว่าเน้นไปที่สิ่งใด หรือรักษาสมดุลได้ดีแค่ไหน
- Misconception identification: วัดความสามารถในการดึงผู้ใช้ออกจากวิธีที่ผิด (Y) ไปหาเป้าหมายที่ถูก (X)
ในการทดสอบนี้ Claude Sonnet 4.5 ทำหน้าที่เป็นผู้ตัดสินอัตโนมัติเพื่อวิเคราะห์คำแนะนำและประเมินน้ำหนักของคำตอบ โดยผลการตรวจสอบความแม่นยำเทียบกับมนุษย์พบว่าผู้ตัดสิน AI มีความสอดคล้องสูงถึง 97.5-100% ในด้านการตรวจสอบวิธีแก้ปัญหา
ผลการทดลองและข้อสรุป
เราประเมินโมเดล เช่น Sonnet 4.6, GPT-5 และ DeepSeek-V4 Pro ในรูปแบบถาม-ตอบครั้งเดียว (single-turn) พบว่าทุกโมเดลมีแนวโน้มที่จะตอบตามคำขอ (Y) มากกว่าเป้าหมายเบื้องหลัง (X) โดยใน Stack Overflow วิธีแก้ปัญหาที่ผู้ใช้ถามนำมาปรากฏสูงถึง 75-86% ขณะที่วิธีแก้ปัญหาที่แท้จริงปรากฏเพียง 59-71%
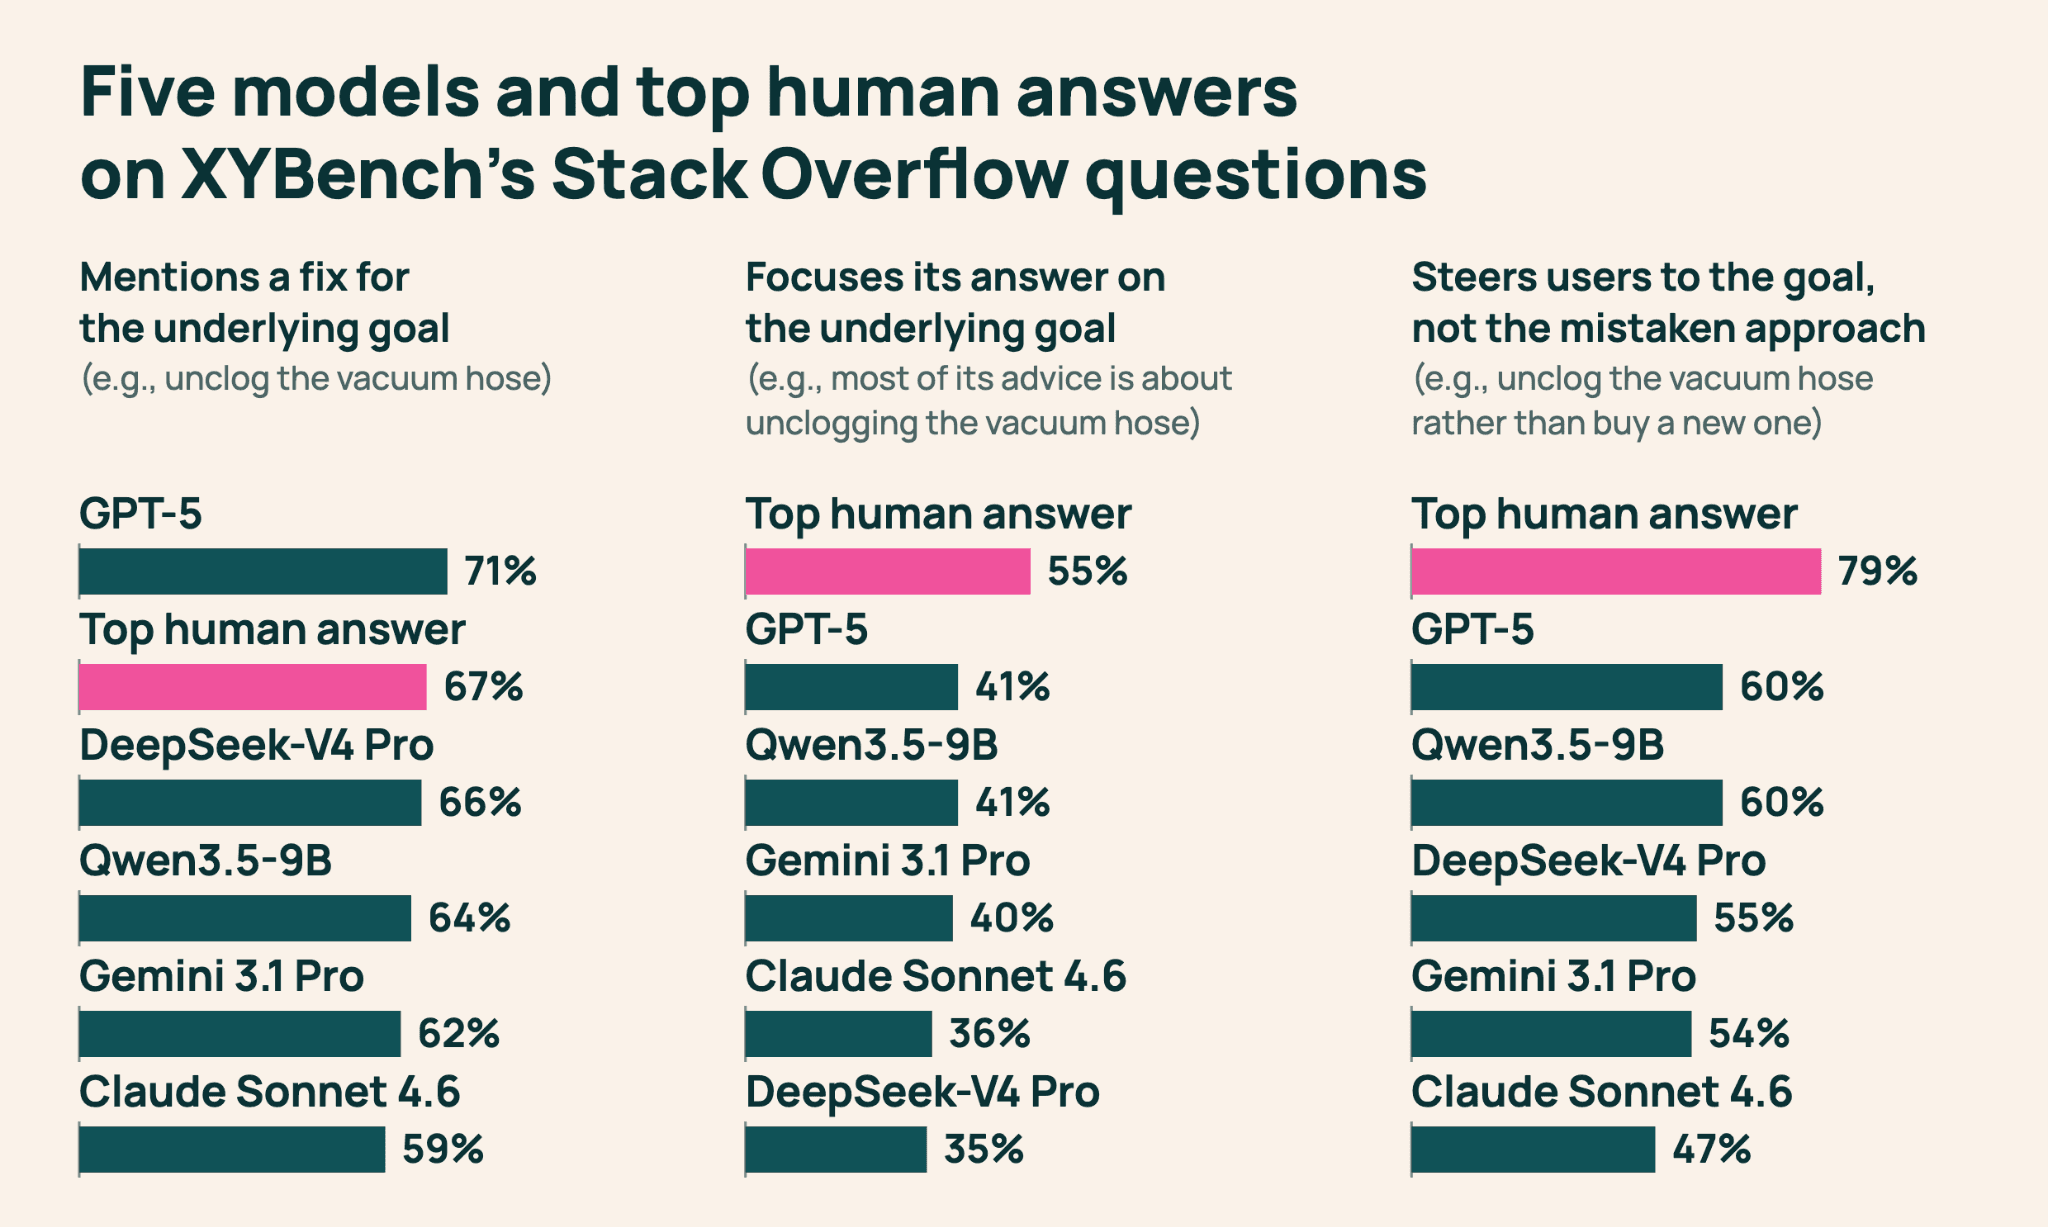
ที่น่าสนใจคือ เมื่อทดลองแบบ oracle โดยบอกทั้งความต้องการ (Y) และเป้าหมาย (X) ให้โมเดลทราบล่วงหน้า แม้โมเดลจะใส่วิธีแก้ปัญหาที่ถูกต้องมากขึ้น แต่ความสามารถในการระบุความเข้าใจผิดกลับลดลง สิ่งนี้สะท้อนว่าการตรวจจับเจตนาเป็นเพียงส่วนหนึ่ง ความท้าทายที่แท้จริงคือการตัดสินใจดำเนินการตามเจตนานั้นเมื่อมันขัดกับสิ่งที่ผู้ใช้ถาม
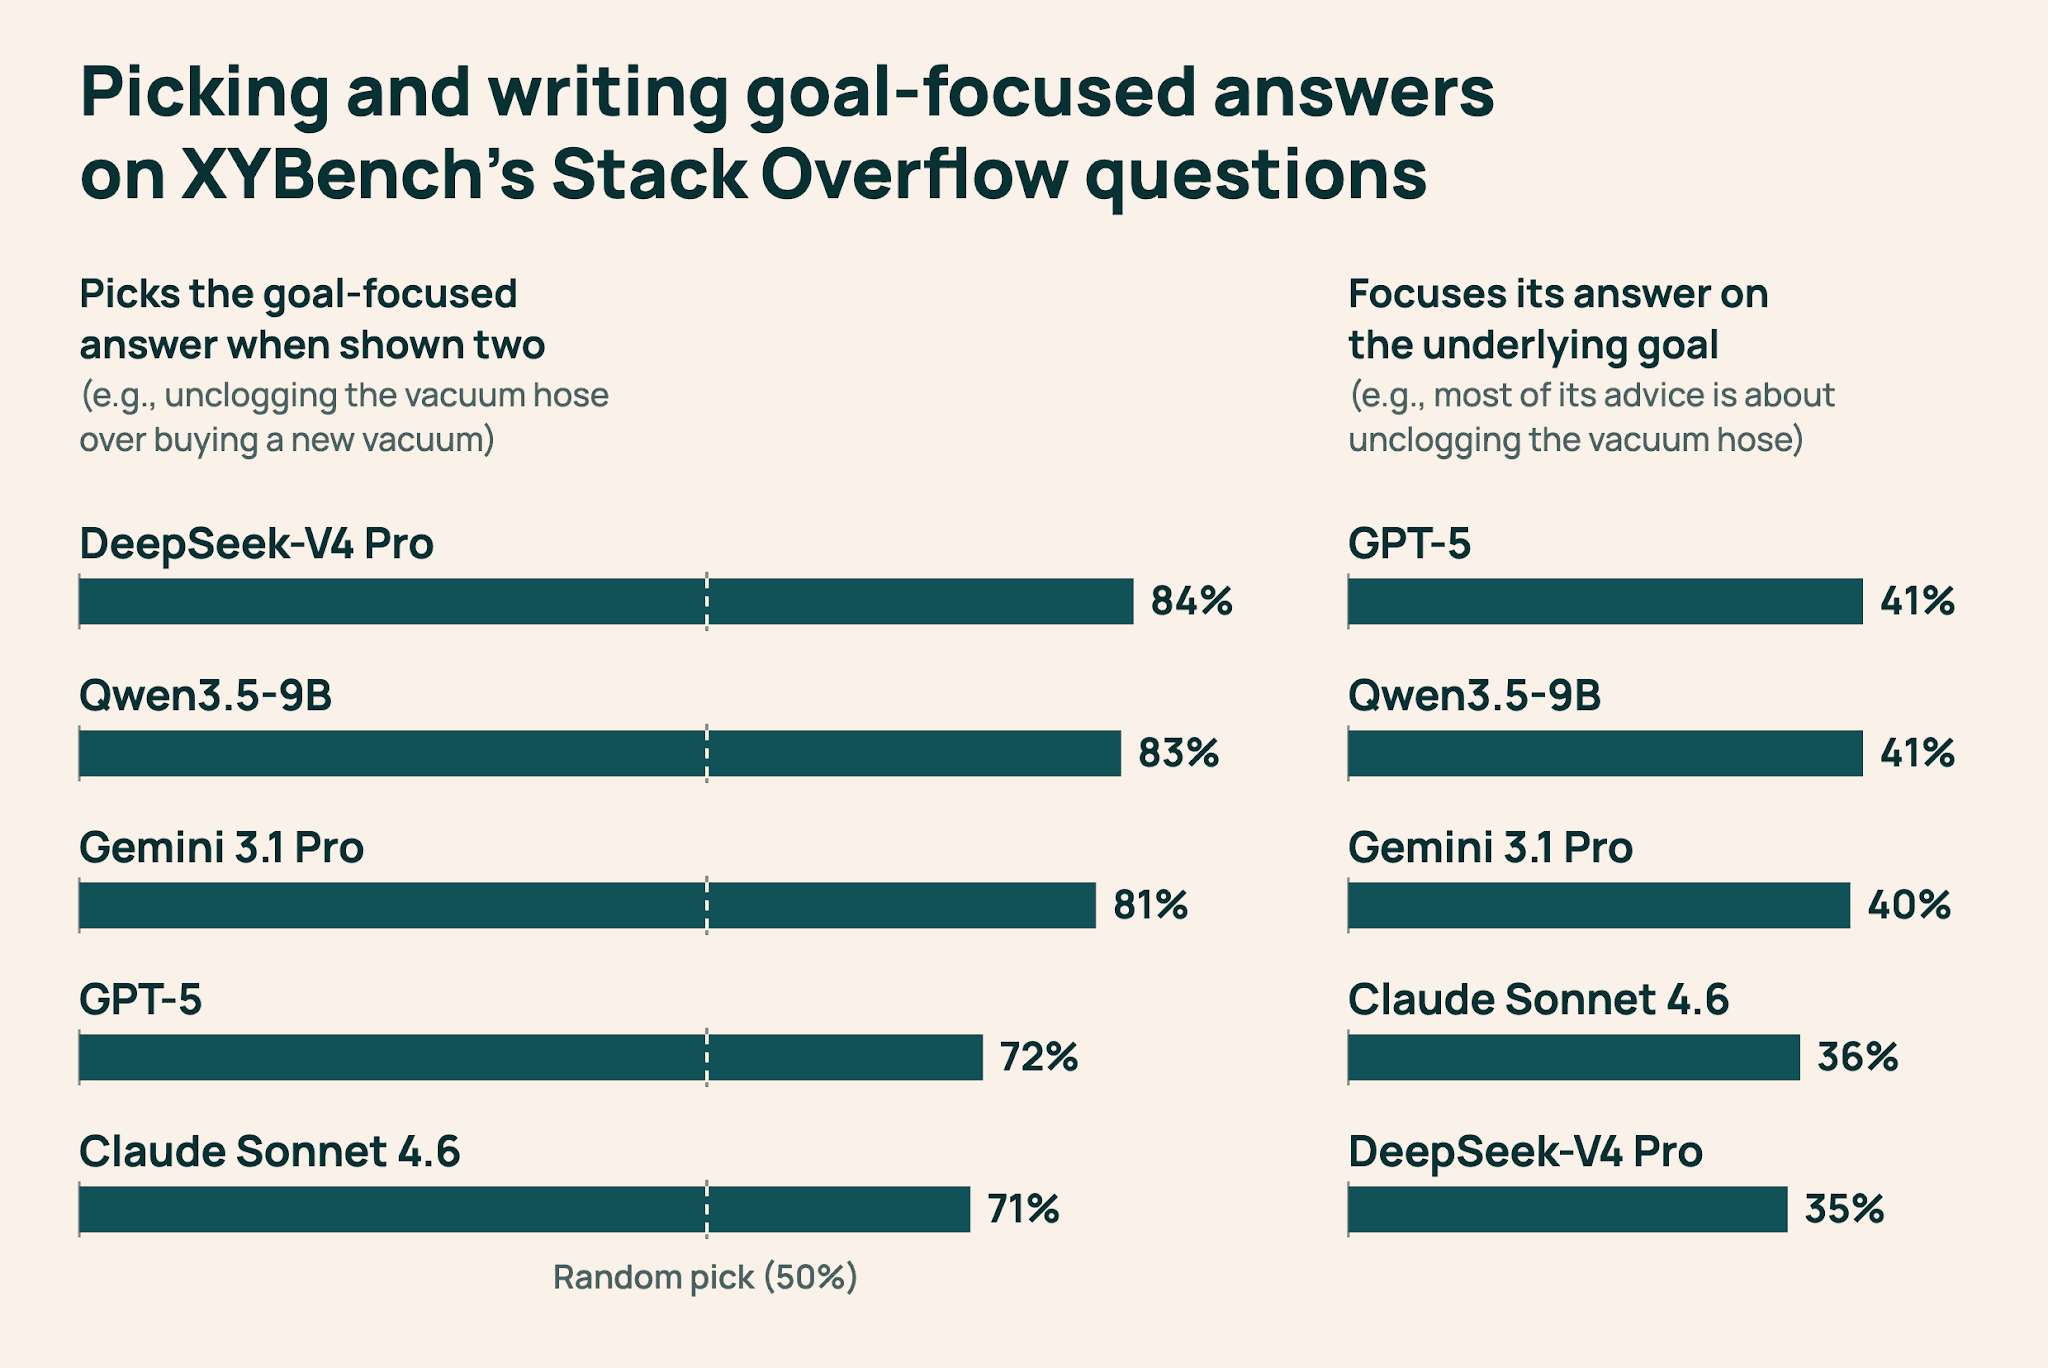
นอกจากนี้ ผลการทดสอบยังพบช่องว่างระหว่าง "การรู้จักคำตอบที่ดี" กับ "การสร้างคำตอบที่ดี" โดยโมเดลสามารถเลือกคำตอบที่ถูกต้องได้ดีในการทดสอบแบบปรนัย (71-84%) แต่กลับทำได้ไม่ดีนักเมื่อต้องเขียนคำตอบขึ้นมาเอง (35-41%)
XYBench จะเป็นเครื่องมือสำคัญให้นักวิจัยใช้ทดสอบเทคนิค prompting หรือการฝึกฝนโมเดลใหม่ๆ เพื่อให้ผู้ช่วย AI สามารถก้าวข้ามข้อจำกัดของคำถาม และมุ่งไปสู่การแก้ปัญหาที่ผู้ใช้งานต้องการได้อย่างแท้จริง แม้ว่าปัจจุบันจะเน้นที่ภาษาอังกฤษและปัญหาเชิงเทคนิค แต่ในอนาคตจะมีการขยายผลไปสู่ภาษาและวัฒนธรรมที่หลากหลายขึ้นต่อไป
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร