
HOPE วิธีลดขนาดโมเดล MoE แบบใหม่ที่รักษาประสิทธิภาพได้สูงสุด
Higher-Order Pruning of Experts in Mixture-of-Experts Language Models
Introduction
โมเดลแบบ Mixture-of-Experts (MoE) ช่วยให้ LLMs ระดับชั้นนำสามารถขยายขนาดได้ถึงหลายแสนล้านพารามิเตอร์ แต่ก็มาพร้อมกับข้อควรระวังพื้นฐานที่มีค่าใช้จ่ายสูงคือ ทุก expert MLP จะต้องกินพื้นที่หน่วยความจำในขณะรัน inference แม้ว่าส่วนใหญ่จะไม่ได้ใช้งานสำหรับ token ใดๆ ก็ตาม
ตัวอย่างเช่น Qwen3.5-122B มี 256 experts ในแต่ละชั้น MoE ทั้ง 48 ชั้น โดย 95% ของการใช้หน่วยความจำพารามิเตอร์ประมาณ 250 GB นั้นถูกใช้งานโดย expert MLPs เหล่านี้เพียงอย่างเดียว ทั้งที่จริงแล้วสำหรับ token ใดๆ จะมีเพียง 8 experts ในแต่ละชั้นเท่านั้นที่ถูกเรียกใช้งาน
Expert pruning เป็นหนึ่งในการแก้ไขปัญหาคอขวดของหน่วยความจำที่ตรงจุดที่สุด ด้วยการลบ experts ที่มีประโยชน์น้อยที่สุดออกไปอย่างถาวร วิธีนี้ช่วยหลีกเลี่ยงปัญหาความหน่วง (latency) จากการโหลดข้อมูลแบบไดนามิก อีกทั้งยังไม่ต้องการการ training เพิ่มเติม และ it composes with quantization อย่างไรก็ตาม ความท้าทายสำคัญคือการตัดสินใจว่า expert ไหน ที่ปลอดภัยที่สุดในการลบออก
วิธีการ pruning ที่มีอยู่ในปัจจุบันมักให้คะแนนแต่ละ expert แยกกันในรูปแบบสเกลาร์และตัดตัวที่สำคัญน้อยที่สุดออก วิธีการเหล่านี้เรียกว่า first-order เพราะสมมติว่าแต่ละ expert ทำงานเป็นอิสระต่อกัน แต่ในความเป็นจริง experts มักรวมกลุ่มทำงานร่วมกัน (co-activated) การละเลยปฏิสัมพันธ์เหล่านี้จะนำไปสู่การ pruning ที่ไม่เหมาะสม โดยเฉพาะเมื่อต้องการลดขนาดในอัตราที่สูง
Our newest paper ได้นำเสนอ HOPE (Higher-Order Pruning of Experts) ซึ่งเป็นวิธีแบบ second-order ที่พิจารณาปฏิสัมพันธ์ระหว่างคู่ของ experts โดยที่ระดับการ pruning 50% HOPE ได้รับอันดับเฉลี่ยดีที่สุด และมีประสิทธิภาพเพิ่มขึ้นสูงสุดถึง +6.1% ในงาน agentic coding เหนือกว่าวิธีการ pruning แบบเดิมอย่างชัดเจน
ในโพสต์นี้ เราจะอธิบายการทำงานของ HOPE และวิธีนำไปใช้กับโมเดลของคุณ สำหรับผู้ที่ยังไม่คุ้นเคยกับโครงสร้าง MoE สามารถศึกษาเพิ่มเติมได้ที่ Mixture of Experts (MoEs) in Transformers
Experts don't work alone
ใน MoE มาตรฐาน แต่ละชั้นจะมี EEE experts และแต่ละ input token xxx จะถูกส่ง (routed) ไปยัง KKK experts (โดยทั่วไป K=8 K = 8 K=8) ผ่าน layer ที่สร้าง softmax-normalized gate weights gk(x)g_{k}(x)gk(x) เพื่อเลือก active set ของ experts, T(x)⊂{1,..,E}T(x) \subset{1,..,E}T(x)⊂{1,..,E} ผลลัพธ์ของชั้นจะคำนวณจาก ∑k∈T(x)gk(x)fk(x)\sum\limits_{k\in T(x)}g_{k}(x)f_{k}(x)k∈T(x)∑gk(x)fk(x) โดย fk(x)f_{k}(x)fk(x) คือผลลัพธ์ของแต่ละ expert
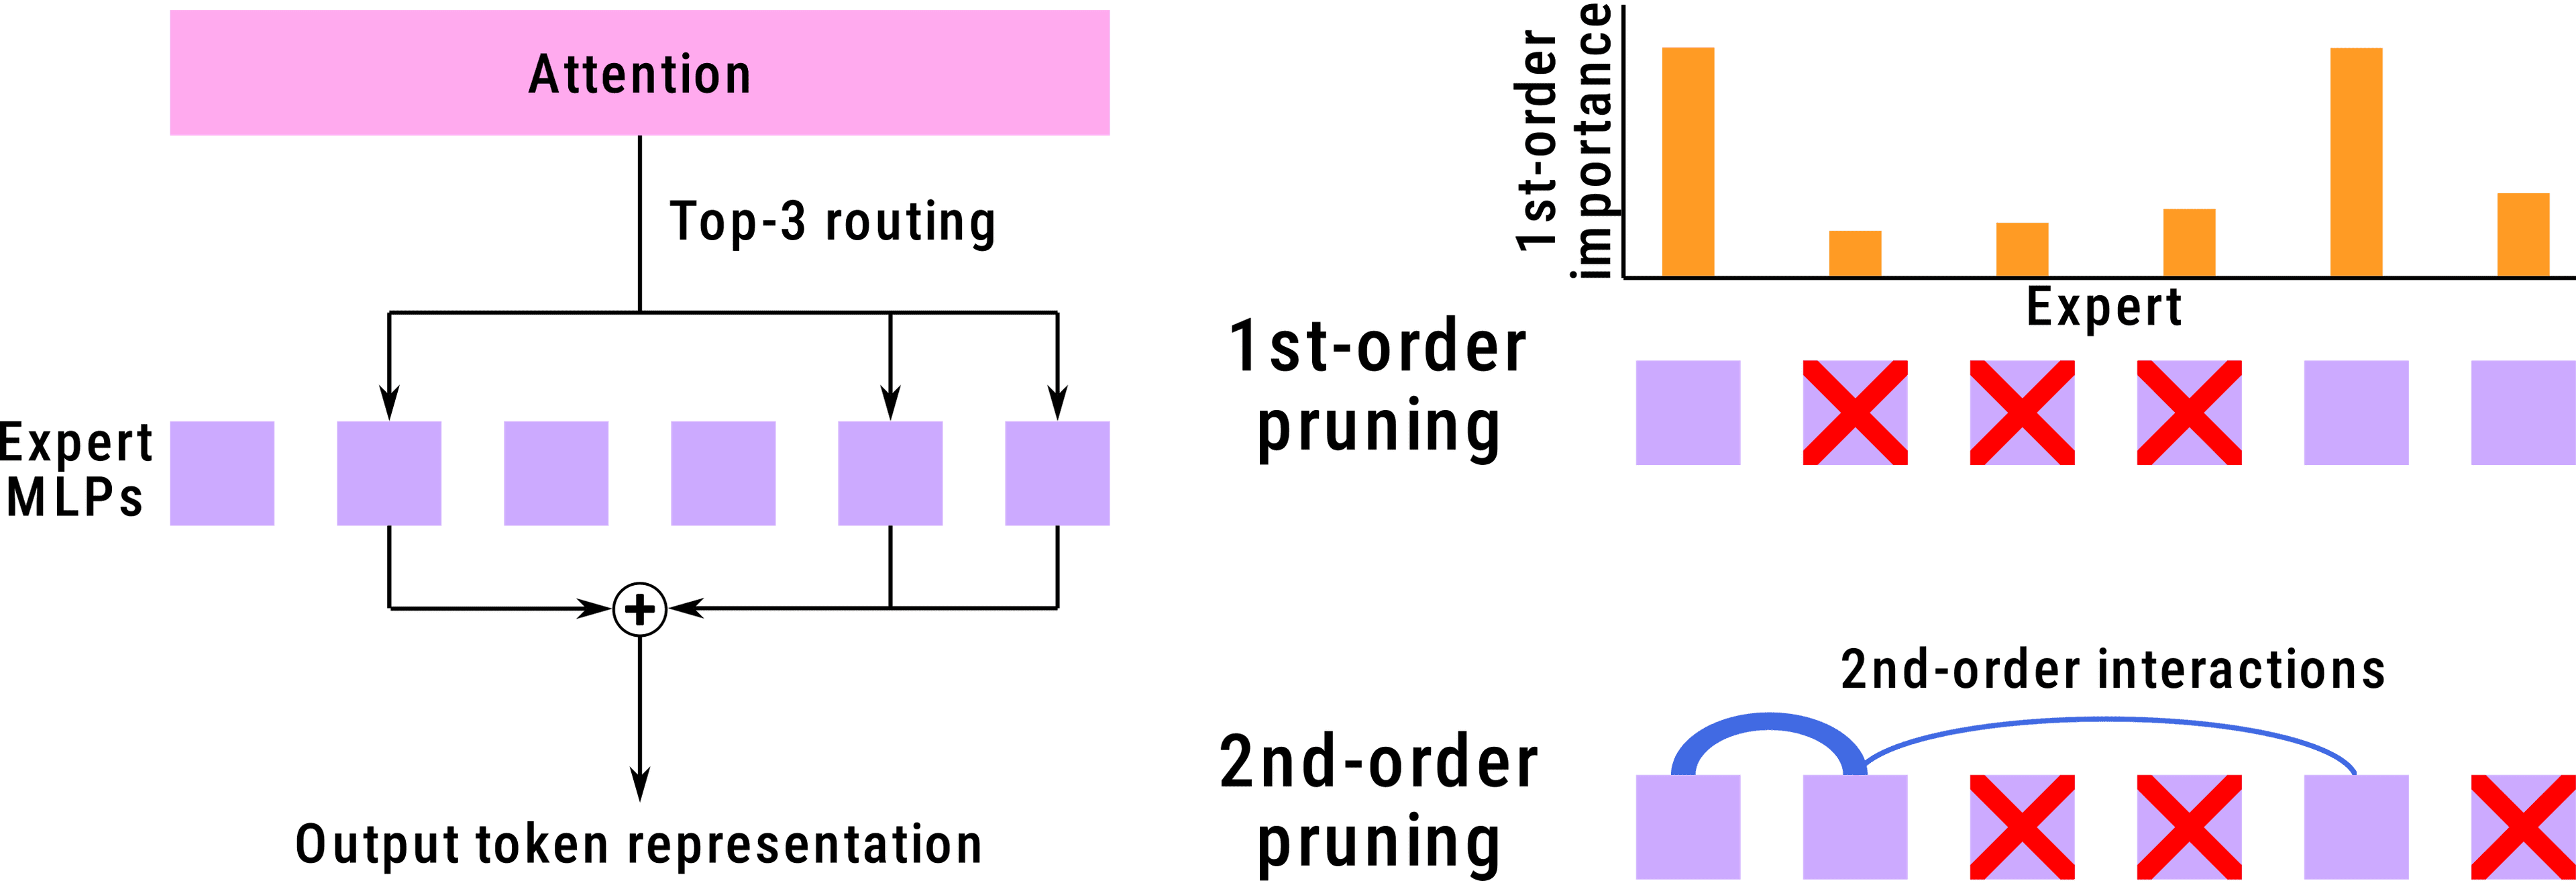
ซ้าย: ชั้น MoE ทั่วไปที่แต่ละ token ถูกส่งไปยัง top-K experts ขวา: วิธีแบบ first-order จัดอันดับและลบ experts รายตัว แต่การ pruning ที่ดีที่สุดควรพิจารณาความแข็งแกร่งของปฏิสัมพันธ์ระหว่างคู่ experts ด้วย
ผู้เชี่ยวชาญสังเกตเห็น before in the literature ว่า experts ในชุดที่ถูกเลือกมักทำงานร่วมกันเป็นกลุ่มที่มั่นคงมาตั้งแต่ช่วงเริ่มต้นการฝึกฝน ซึ่งหมายความว่าการลบ expert A อาจดูเหมือนไม่ส่งผลเสียเมื่อพิจารณาแยกเดี่ยว แต่หาก expert B ที่สำคัญสูงต้องพึ่งพา A การลบ A จะทำลายประสิทธิภาพของกลุ่มทันที
ปัญหานี้จะทวีความรุนแรงขึ้นเมื่อเราลดขนาดโมเดลลงถึง 50% เพราะเสี่ยงที่จะทำลายความสัมพันธ์แบบร่วมมือจำนวนมาก นี่คือจุดที่ second-order pruning ของ HOPE เข้ามาสร้างความแตกต่าง
How HOPE identifies a prune-set
เป้าหมายของ HOPE คือการหาชุดการ prune PPP ที่ทำให้ pruning error เหลือน้อยที่สุด (ดูรายละเอียดในภาคผนวก A ของ our corresponding paper) โดยกำหนดตัวแทน (surrogate) ZZZ ซึ่งเป็นขอบเขตบนของ error ดังนี้:
Z=[∑j∈P∩T(x)gj(x)∥fj(x)∥2]2≥true errorZ = \bigl[\sum\limits_{j \in P\cap T(x)} g_{j}(x)\Vert f_j(x)\Vert_{2}\bigr]^{2} \geq \text{true error}Z=[j∈P∩T(x)∑gj(x)∥fj(x)∥2]2≥true error เนื่องจาก ZZZ คือผลรวมยกกำลังสอง การกระจายสูตรจึงสร้าง cross-terms gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2g_{i}(x)g_{j}(x)\Vert f_{i}(x)\Vert_{2}\Vert f_{j}(x)\Vert_{2}gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2 ระหว่างคู่ของ experts โดยธรรมชาติ ซึ่งเป็น interaction terms ที่วิธีแบบ first-order มองข้ามไป
HOPE จะหาค่าต่ำสุดของ E[Z]\mathbb{E}[Z]E[Z] บนชุดข้อมูล calibration ผ่านโจทย์ quadratic program (QP):
P∗=arg minp p⊤Fps.t.p∈{0,1}E,∑k=1Epk=∣P∣P^{*} = \argmin_{p}; p^{\top}Fp \quad \text{s.t.} \quad p \in {0,1}^{E}, \sum\limits_{k=1}^{E}p_{k} = \vert P\vertP∗=pargminp⊤Fps.t.p∈{0,1}E,k=1∑Epk=∣P∣ โดยใช้เมทริกซ์ F∈RE×EF\in\mathbb{R}^{E\times E}F∈RE×E ที่นิยามว่า:
Fi,j=1∣Xi,j∣∑x∈Xi,jgi(x)gj(x)∥fi(x)∥2∥fj(x)∥2whereXi,j={x:i,j∈T(x)}F_{i,j} = \frac{1}{\vert \mathcal{X}{i,j}\vert} \sum\limits_{x\in\mathcal{X}{i,j}} g_{i}(x)g_{j}(x)\Vert f_{i}(x)\Vert_{2}\Vert f_{j}(x)\Vert_{2}\quad\text{where}\quad \mathcal{X}{i,j} = {x: i,j \in T(x)}Fi,j=∣Xi,j∣1x∈Xi,j∑gi(x)gj(x)∥fi(x)∥2∥fj(x)∥2whereXi,j={x:i,j∈T(x)}
เมทริกซ์ F จะเก็บทั้งความสำคัญของ expert รายตัว (แนวทแยง) และค่าการมีส่วนร่วมแบบร่วมมือ (นอกแนวทแยง) ซึ่งเผยให้เห็นโครงสร้างแบบบล็อกที่แสดงถึงกลุ่ม experts ที่ทำงานร่วมกันอย่างใกล้ชิดในแต่ละชั้นของโมเดล
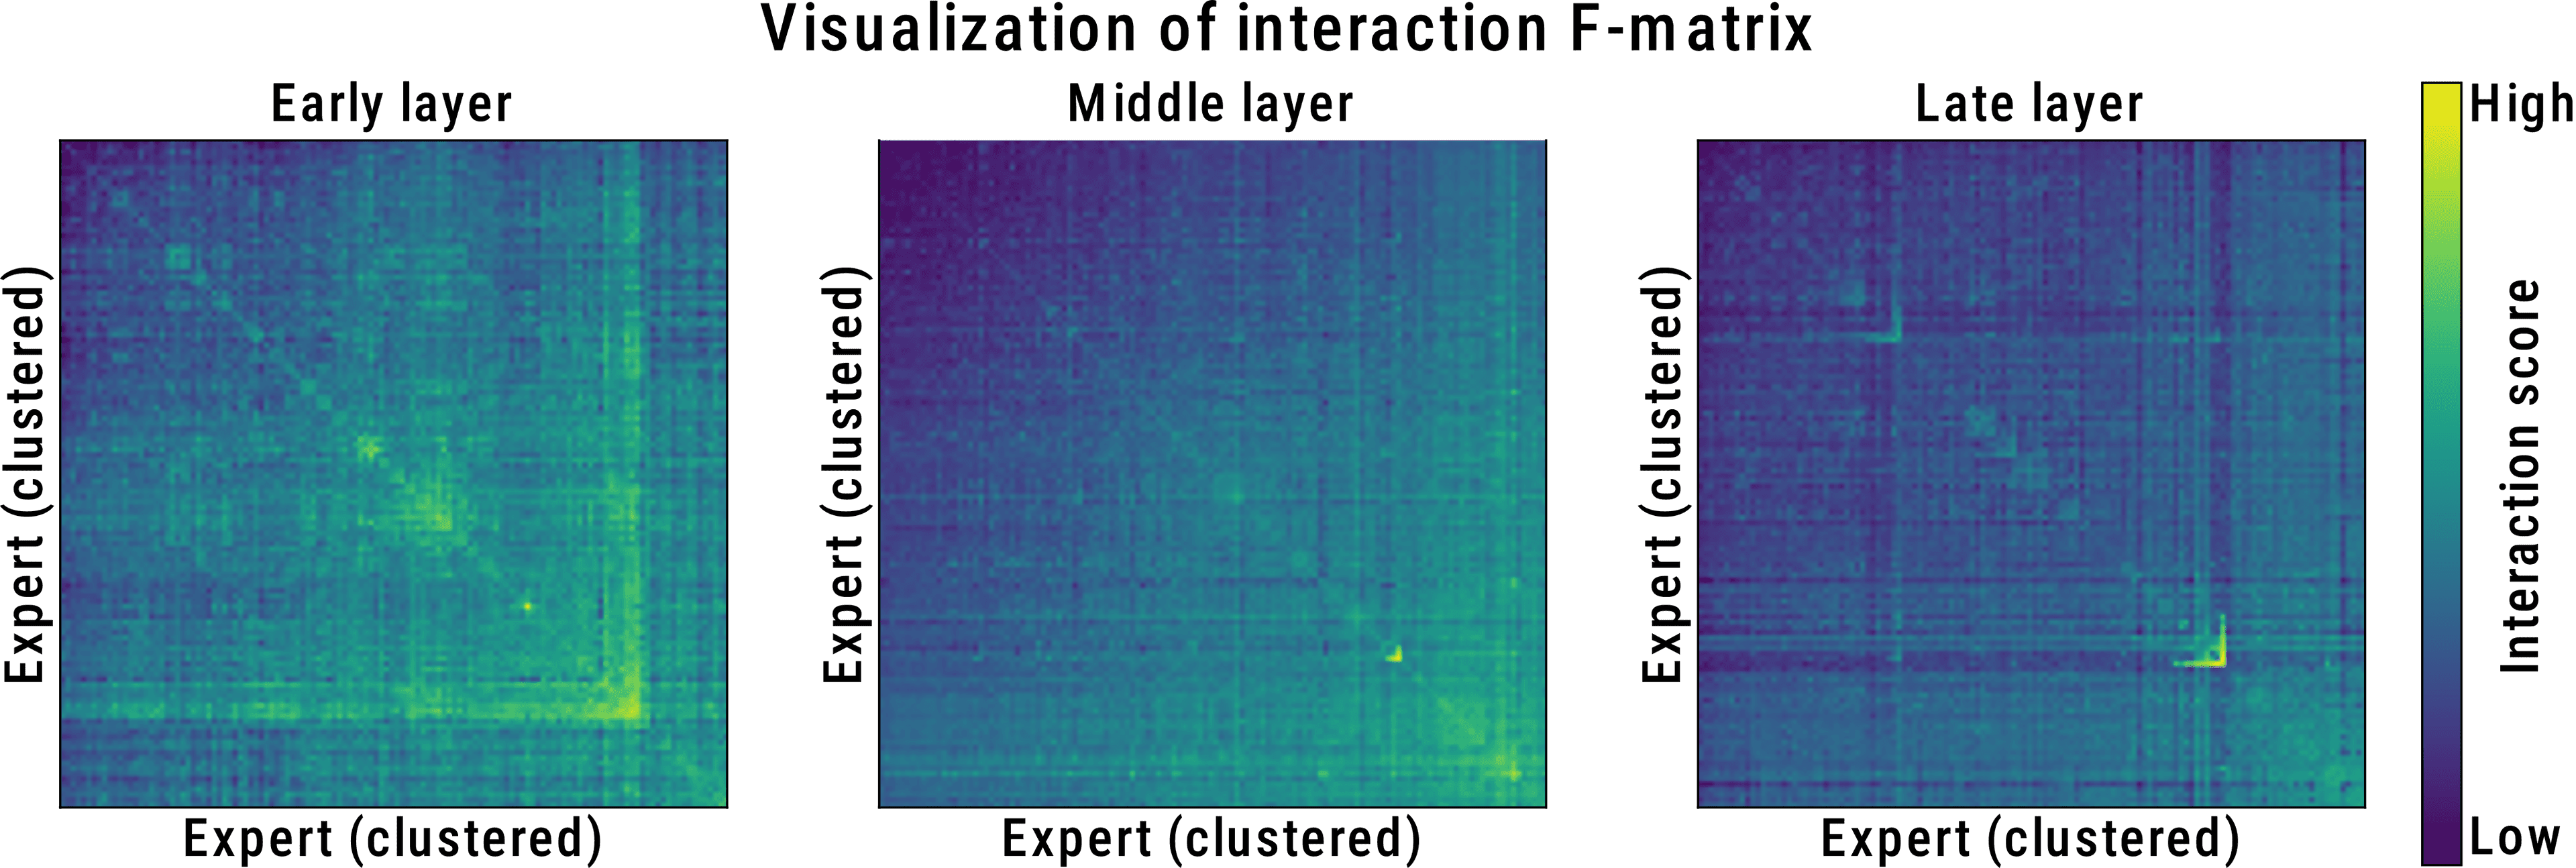
ภาพจำลอง interaction matrix F สำหรับ GLM-4.5-Air บล็อกสว่างตามแนวทแยงแสดงถึงกลุ่ม experts ที่มีปฏิสัมพันธ์กันสูง
ในแง่การใช้งาน HOPE ต้องการเพียงการรัน forward pass บนข้อมูล calibration หนึ่งครั้งและการแก้โจทย์ QP ซึ่งใช้เวลาเพิ่มเพียง 1-2 วินาทีต่อชั้น ถือว่าน้อยมากเมื่อเทียบกับเวลาที่ใช้ในขั้นตอนการ calibration ทั้งหมด
Connection to REAP
HOPE มีความเกี่ยวข้องกับ Router-weighted Expert Activation Pruning (REAP) ซึ่งเป็นวิธีแบบ first-order โดยเมทริกซ์ F ของ HOPE สามารถกู้คืนคะแนนที่ REAP ใช้ได้เกือบสมบูรณ์ (Spearman ρ=0.988\rho = 0.988ρ=0.988) ดังนั้นประสิทธิภาพที่เพิ่มขึ้นของ HOPE จึงมาจากข้อมูล interaction terms แบบ second-order เป็นหลัก
Results
จากการประเมินด้วยโมเดล Qwen3.5-122B, Qwen3.5-35B และ GLM-4.5-Air บนชุดทดสอบ Tulu3 และ SWE-Bench Pro พบว่า HOPE ทำผลงานได้ดีเยี่ยม
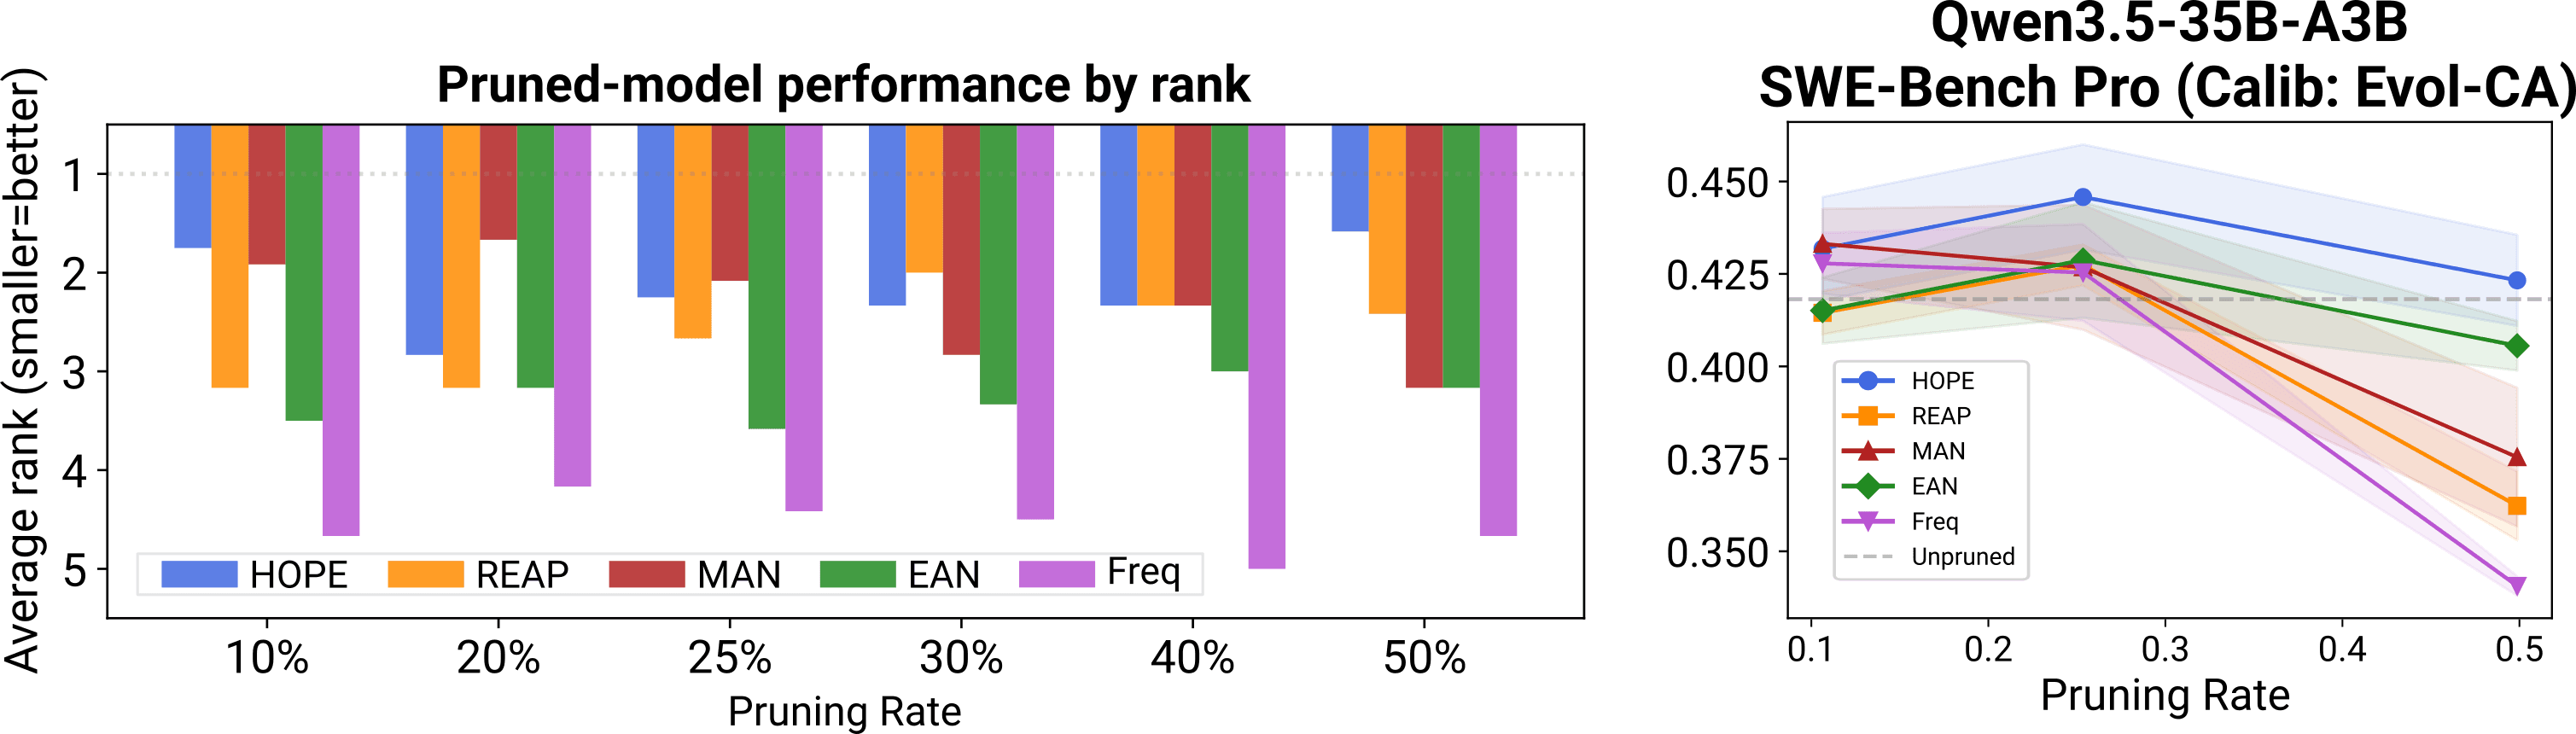
HOPE ได้อันดับเฉลี่ยดีที่สุด โดยเฉพาะในอัตราการ pruning สูง ซ้าย: อันดับเฉลี่ยจากทุกเกณฑ์มาตรฐาน ขวา: ประสิทธิภาพบน SWE-Bench Pro ของ Qwen3.5-35B
ที่อัตราการ pruning 50% HOPE ได้อันดับเฉลี่ย 1.58 เหนือกว่า REAP ที่ได้ 2.42 โดยเฉพาะในงาน SWE-Bench Pro (agentic coding) ซึ่งต้องใช้การทำงานร่วมกันของหลาย experts โมเดล Qwen3.5-35B-A3B ที่ถูก prune 50% โดย HOPE ยังทำคะแนนได้ถึง 42.3 เทียบเท่ากับโมเดลเดิมที่ไม่ได้ prune (41.8) ในขณะที่วิธี REAP คะแนนตกลงไปเหลือ 36.2
การทดลองยังแสดงให้เห็นว่า การยอมเสียสละ experts บางตัวที่มีคะแนนรายตัวสูงเพื่อรักษา "กลุ่มความร่วมมือ" ไว้ตามแนวทางของ HOPE ส่งผลดีต่อประสิทธิภาพโดยรวมของโมเดลอย่างชัดเจน
HOPE retains more cooperating experts
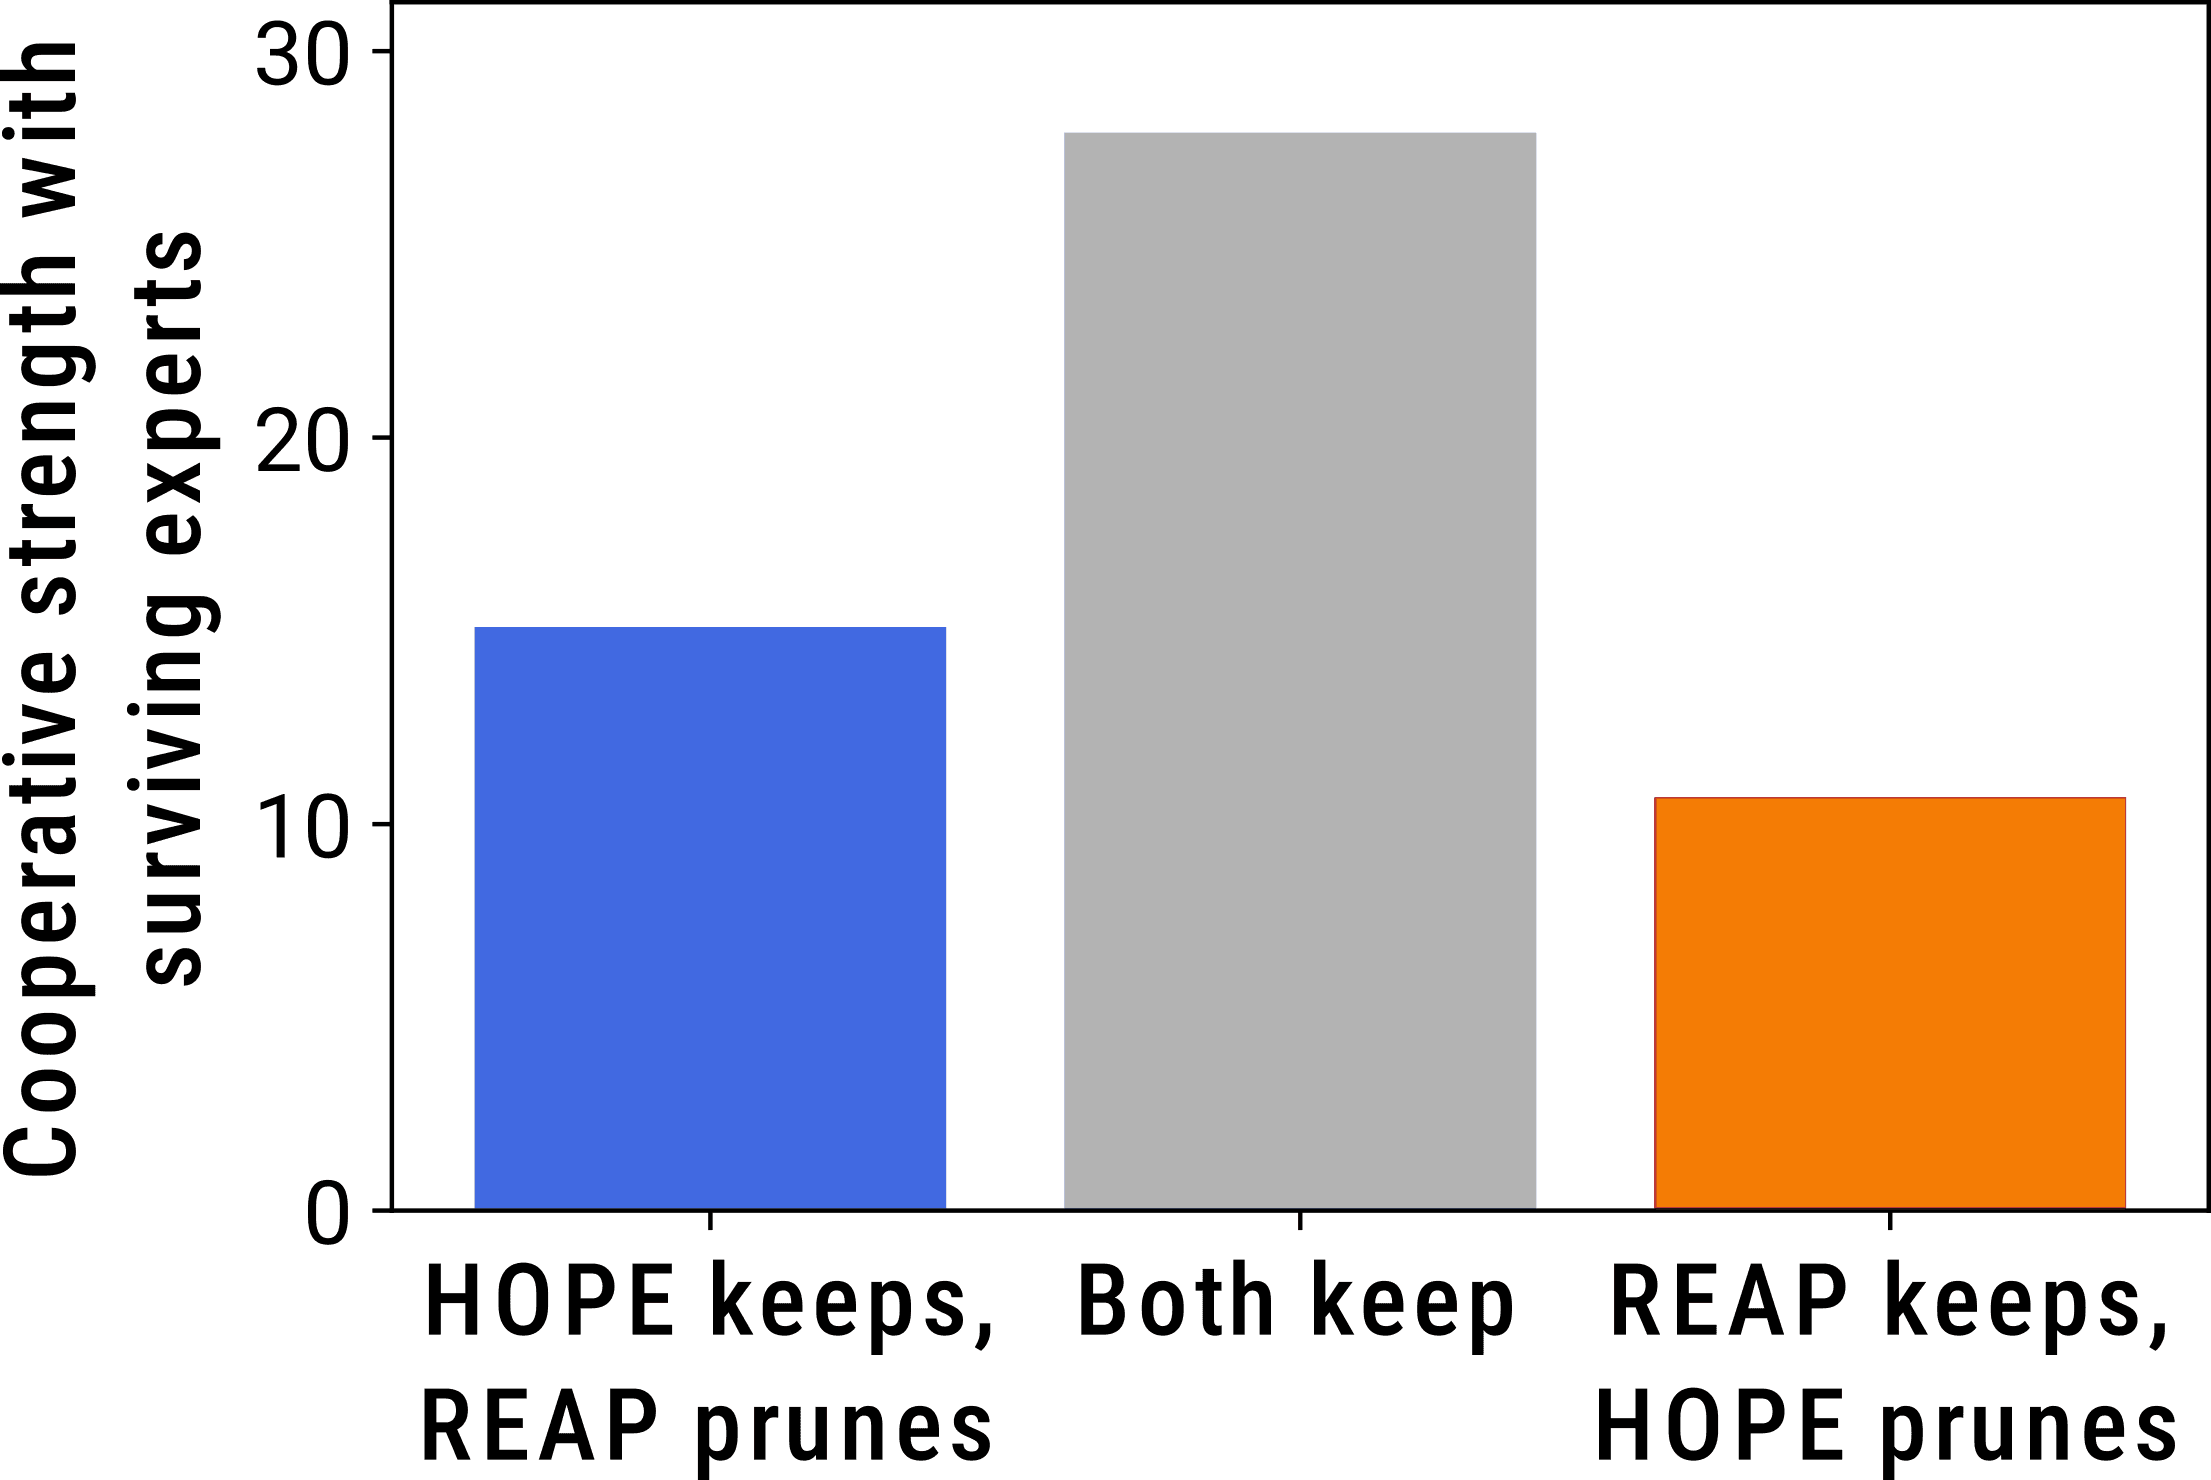
เปรียบเทียบความแข็งแกร่งของความร่วมมือระหว่าง experts ที่ HOPE และ REAP เลือกเก็บไว้
How to run HOPE
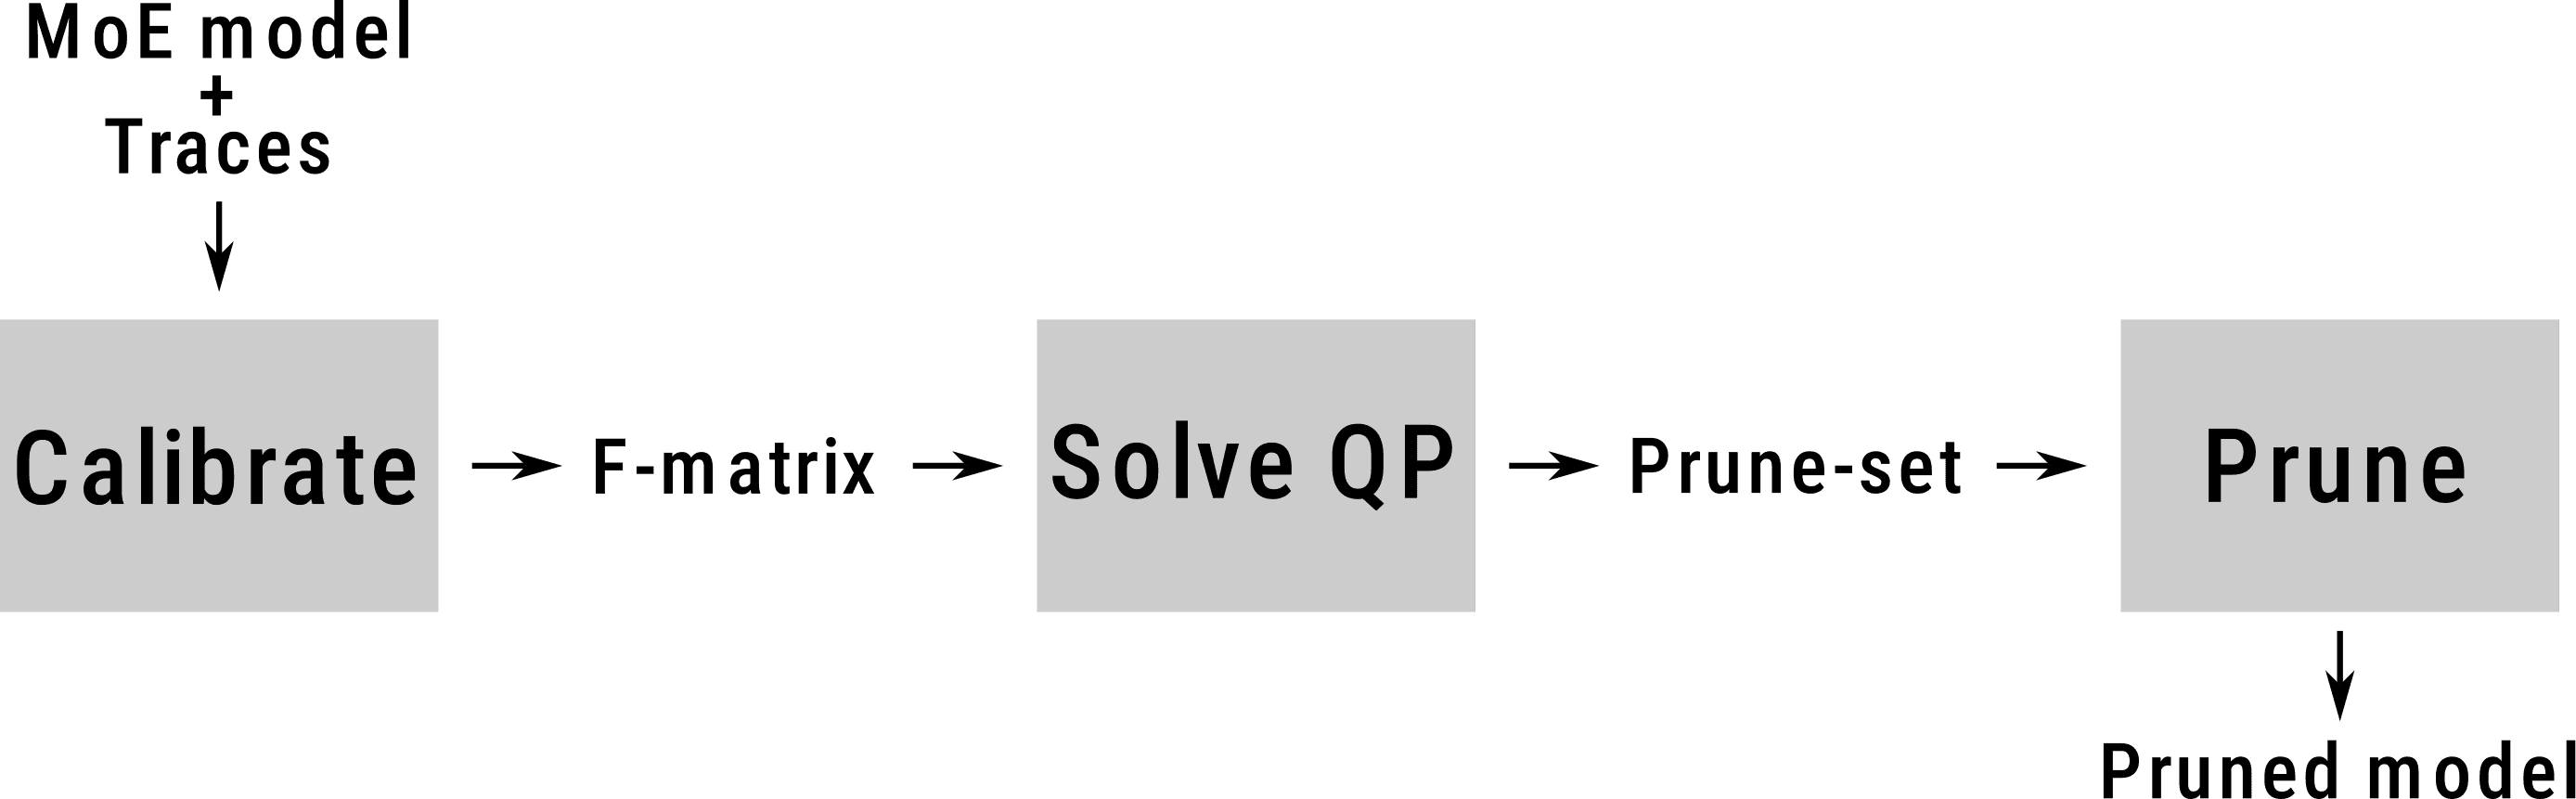
เราได้ปล่อย package ที่ใช้งานได้ง่ายผ่าน 3 ขั้นตอน ดังนี้:
Step 1: Calibrate
hope calibrate \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --prompts calibration_prompts.txt \
    --out-path observations.h5
Step 2: Solve QP
hope solve \
    --obs-path observations.h5 \
    --prune-frac 0.50 \
    --out-path pruneset.json
Step 3: Prune
hope prune \
    --model-path Qwen/Qwen3.5-35B-A3B \
    --pruneset-path pruneset.json \
    --out-path ./Qwen3.5-35B-A3B-pruned-50
นอกจากนี้ยังสามารถใช้งานผ่าน Python API ได้โดยตรง:
from hope.calibrate import calibrate
from hope.solve import solve
from hope.prune import prune_model

calibrate("Qwen/Qwen3.5-35B-A3B", calibration_prompts, "observations.h5")
solve("observations.h5", prune_frac=0.50, out_path="pruneset.json")
prune_model("Qwen/Qwen3.5-35B-A3B", "pruneset.json", "./Qwen3.5-35B-A3B-pruned-50")
Limitations of HOPE
ข้อได้เปรียบของ HOPE จะชัดเจนที่สุดที่อัตราการ pruning สูง (40-50%) ในขณะที่อัตราต่ำ วิธีแบบ first-order ยังคงมีความสามารถใกล้เคียงกัน นอกจากนี้ HOPE ยังทำการ prune แยกแต่ละชั้นโดยไม่ได้พิจารณาปฏิสัมพันธ์ข้ามชั้น (cross-layer) ซึ่งเป็นหัวข้อที่เรากำลังวิจัยต่อในอนาคต
More information
Paper: https://arxiv.org/abs/2609.18916
Code: https://github.com/awslabs/HOPE
สำหรับสถาปัตยกรรมไฮบริด โปรดดูที่ corresponding repository
Citation:
@article{tseng2026hope,
    title={Higher-Order Pruning of Experts in Mixture-of-Experts Language Models},
    author={Tseng, Alex M. and Kaul, Prannay and Zancato, Luca and Xia, Wei and Soatto, Stefano},
    journal={arXiv preprint arXiv:2609.18916},
    year={2026},
}ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร