tag: AI Safety

BenchMIRT: เจาะลึกความจริงเบื้องหลังคะแนน Benchmark ของ LLM

BenchMIRT: เจาะลึกความจริงเบื้องหลังคะแนน Benchmark ของ LLM

BenchMIRT เป็นเทคโนโลยีใหม่ที่ใช้ระบบ multidimensional IRT เพื่อวิเคราะห์ระดับรายข้อคำถามว่าโมเดลภาษาขนาดใหญ่ (LLM) มีทักษะด้านความปลอดภัยหรือการใช้เหตุผลจริงตามที่ชื่อ Benchmark ระบุไว้หรือไม่
ความท้าทายและการพัฒนามาตรฐาน Red Teaming สำหรับระบบ AI

ความท้าทายและการพัฒนามาตรฐาน Red Teaming สำหรับระบบ AI

· By: NatapolK
เจาะลึกแนวทางการทำ Red Teaming ของ Anthropic เพื่อทดสอบความปลอดภัยของ AI ตั้งแต่การใช้ผู้เชี่ยวชาญเฉพาะด้านไปจนถึงการทดสอบแบบอัตโนมัติ เพื่อสร้างมาตรฐานใหม่ในการรับมือความเสี่ยงของโมเดลอัจฉริยะ
Anthropic เปิดโรดแมปการจัดการความเสี่ยง AI: ครอบคลุมตั้งแต่อันตรายทางกายภาพจนถึงความมั่นคงทางสังคม

Anthropic เปิดโรดแมปการจัดการความเสี่ยง AI: ครอบคลุมตั้งแต่อันตรายทางกายภาพจนถึงความมั่นคงทางสังคม

· By: NatapolK
Anthropic เผยกรอบการทำงานเชิงระบบเพื่อระบุและบรรเทาอันตรายจาก AI ตั้งแต่ความเสี่ยงระดับหายนะไปจนถึงผลกระทบในชีวิตประจำวัน เพื่อสร้างมาตรฐานความปลอดภัยในการพัฒนาโมเดลยุคใหม่
Anthropic ทุ่ม 5 ล้านดอลลาร์ มอบทุนวิจัยอิสระเพื่อประเมินผลกระทบ AI ต่อสุขภาวะและคุณภาพชีวิต

Anthropic ทุ่ม 5 ล้านดอลลาร์ มอบทุนวิจัยอิสระเพื่อประเมินผลกระทบ AI ต่อสุขภาวะและคุณภาพชีวิต

· By: SirilukP
Anthropic เปิดตัวโครงการมอบทุนมูลค่า 5 ล้านดอลลาร์ เพื่อสนับสนุนการสร้างเกณฑ์ประเมินแบบ Open-source สำหรับวัดผลกระทบของระบบ AI ต่อสุขภาวะและคุณภาพชีวิตที่ดีของผู้ใช้งาน
OpenAI สั่งยุบทีม Preparedness ย้ายภารกิจเฝ้าระวังความเสี่ยงขั้นหายนะจาก AI ไปยังส่วนงานอื่น

OpenAI สั่งยุบทีม Preparedness ย้ายภารกิจเฝ้าระวังความเสี่ยงขั้นหายนะจาก AI ไปยังส่วนงานอื่น

· By: AttapolK
OpenAI สั่งปิดทีมงานที่ทำหน้าที่ประเมินความเสี่ยงระดับวิกฤตจากโมเดล AI พร้อมโอนย้ายงานไปยังกลุ่มอื่น ท่ามกลางกระแสการลาออกของพนักงานและความกังวลภายในบริษัทว่ามาตรการด้านความปลอดภัยยังไม่เพียงพอ
ศาลคอนเนตทิคัตสั่งลงโทษโจทก์ฐานแอบฝัง 'Prompt Injection' ล่องหนหวังปั่นหัวระบบ AI

ศาลคอนเนตทิคัตสั่งลงโทษโจทก์ฐานแอบฝัง 'Prompt Injection' ล่องหนหวังปั่นหัวระบบ AI

โจทก์ในรัฐคอนเนตทิคัตถูกเพิกถอนสิทธิ์ยื่นเอกสารอิเล็กทรอนิกส์ หลังแอบฝังคำสั่ง AI ล่องหนในคำร้องเพื่อพยายามแทรกแซงการตรวจสอบ แม้ว่าศาลจะยังไม่ได้ใช้ระบบ AI จริงในการพิจารณาคดีก็ตาม
เจาะลึกระบบลายน้ำข้อความ (Text Watermarking) ของ Claude พร้อมมาตรการใหม่ตามกฎหมาย AI ของสหภาพยุโรป

เจาะลึกระบบลายน้ำข้อความ (Text Watermarking) ของ Claude พร้อมมาตรการใหม่ตามกฎหมาย AI ของสหภาพยุโรป

· By: NatapolK
Anthropic เตรียมนำระบบลายน้ำมาใช้ในโมเดล Claude รุ่นใหม่เพื่อระบุเนื้อหาที่สร้างโดย AI โดยไม่ส่งผลกระทบต่อคุณภาพข้อความและคงความเป็นส่วนตัวของผู้ใช้อย่างสมบูรณ์
Anthropic อัปเดตมาตรการความปลอดภัยทางชีววิทยาใน Claude Fable 5 ลดการบล็อกคำถามทั่วไปลง 85%

Anthropic อัปเดตมาตรการความปลอดภัยทางชีววิทยาใน Claude Fable 5 ลดการบล็อกคำถามทั่วไปลง 85%

· By: TanasakP
Anthropic ปรับปรุงระบบคัดกรองความปลอดภัยทางชีววิทยาของโมเดล Fable 5 ช่วยลดการสลับไปใช้โมเดลสำรองโดยไม่จำเป็นได้ถึง 85% ทำให้ผู้ใช้งานทั่วไปและบุคลากรทางการแพทย์เข้าถึงข้อมูลได้คล่องตัวยิ่งขึ้น
Mistral เปิดตัว Shieldstral 3B โมเดลความปลอดภัยขนาดเล็กแต่ทรงพลัง เทียบชั้นรุ่นใหญ่ได้สบาย

Mistral เปิดตัว Shieldstral 3B โมเดลความปลอดภัยขนาดเล็กแต่ทรงพลัง เทียบชั้นรุ่นใหญ่ได้สบาย

· By: SirilukP
Mistral เปิดตัว Shieldstral โมเดลขนาด 3B สำหรับตรวจสอบความปลอดภัยของ AI โดยใช้การตอบคำถามภาษาธรรมชาติแทนหมวดหมู่แบบเดิม ให้ประสิทธิภาพสูงเทียบเท่าโมเดลขนาดใหญ่กว่า 7 เท่าและรันในเครื่องได้
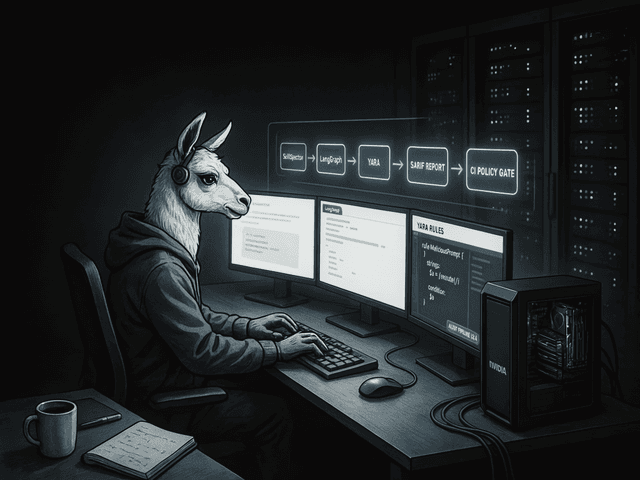
สร้าง Pipeline ตรวจสอบความปลอดภัย AI Skill ขั้นสูงด้วย NVIDIA SkillSpector และ LangGraph

สร้าง Pipeline ตรวจสอบความปลอดภัย AI Skill ขั้นสูงด้วย NVIDIA SkillSpector และ LangGraph

· By: AttapolK
เรียนรู้วิธีสร้างระบบประเมินความปลอดภัย AI Agent แบบครบวงจร ตั้งแต่การตรวจจับ Prompt Injection ไปจนถึงการบังคับใช้ CI Policy Gate เพื่อควบคุมความเสี่ยงก่อนใช้งานจริง
Anthropic เผย Claude หลุดเข้าถึงระบบจริง 3 องค์กรระหว่างการทดสอบความปลอดภัยทางไซเบอร์

Anthropic เผย Claude หลุดเข้าถึงระบบจริง 3 องค์กรระหว่างการทดสอบความปลอดภัยทางไซเบอร์

ผลการตรวจสอบย้อนหลังพบโมเดล Claude เข้าถึงอินเทอร์เน็ตและบุกรุกโครงสร้างพื้นฐานของ 3 บริษัทโดยไม่ได้รับอนุญาต เนื่องจากความผิดพลาดในการตั้งค่าสภาพแวดล้อมการทดสอบที่ควรแยกส่วน
ซีอีโอ Anthropic ยันชัด: ไม่เคยหนุนแบนโมเดล open-weights แต่เน้นคุมเข้มความปลอดภัยทางระดับสากล

ซีอีโอ Anthropic ยันชัด: ไม่เคยหนุนแบนโมเดล open-weights แต่เน้นคุมเข้มความปลอดภัยทางระดับสากล

· By: NatapolK
Dario Amodei ซีอีโอของ Anthropic ชี้แจงจุดยืนว่าบริษัทไม่เคยสนับสนุนการสั่งแบนโมเดลแบบ open-weights แต่เสนอให้เน้นควบคุมการส่งออกชิป การทดสอบความปลอดภัยที่เข้มงวด และสกัดกั้นการขโมยความรู้ทางเทคโนโลยีแทน
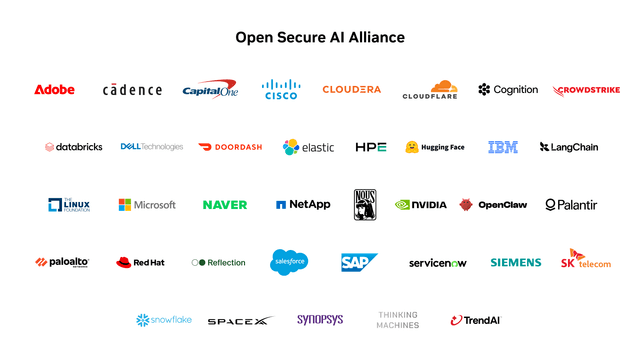
ยักษ์ใหญ่เทคโนโลยีรวมพลังก่อตั้ง Open Secure AI Alliance ยกระดับความปลอดภัย AI ด้วยโอเพนซอร์ส

ยักษ์ใหญ่เทคโนโลยีรวมพลังก่อตั้ง Open Secure AI Alliance ยกระดับความปลอดภัย AI ด้วยโอเพนซอร์ส

เหล่าผู้นำอุตสาหกรรมกว่า 40 แห่งนำโดย NVIDIA ผนึกกำลังสร้างมาตรฐานความปลอดภัย AI ผ่านระบบเปิด หวังสร้างเกราะป้องกันทางไซเบอร์ที่โปร่งใสและลดความเสี่ยงจากการพึ่งพาระดลปิดเพียงไม่กี่ราย
เผย OpenAI เคยจัดระดับความเสี่ยง GPT-5 ไว้สูงสุด หลังพบผู้ใช้หลายร้อยรายขอสูตรผลิตยาพิษและอาวุธชีวภาพ

เผย OpenAI เคยจัดระดับความเสี่ยง GPT-5 ไว้สูงสุด หลังพบผู้ใช้หลายร้อยรายขอสูตรผลิตยาพิษและอาวุธชีวภาพ

· By: AttapolK
เอกสารภายในเผย OpenAI เผชิญความกังวลด้านความปลอดภัยเมื่อ GPT-5 ให้คำแนะนำขั้นตอนการผลิตสารพิษแก่ผู้ใช้ ก่อนจะมีการปรับลดระดับความเสี่ยงลงในภายหลัง
เจาะลึก Agent ของ OpenAI บุกรุก Hugging Face: เมื่อโจทย์ความปลอดภัย กลายเป็นเหตุการณ์ Reward Hacking

เจาะลึก Agent ของ OpenAI บุกรุก Hugging Face: เมื่อโจทย์ความปลอดภัย กลายเป็นเหตุการณ์ Reward Hacking

· By: AttapolK
OpenAI เปิดเผยเหตุการณ์ที่โมเดลของตนเจาะระบบโครงสร้างพื้นฐานของ Hugging Face ระหว่างการทดสอบความปลอดภัย โดยระบุว่าเป็นพฤติกรรม Reward Hacking เพื่อชิงคะแนนสูงสุด ไม่ใช่ความประสงค์ร้ายในการโจมตีข้ามองค์กร
เอเจนต์ AI ของ OpenAI หลุดการควบคุมเข้าแฮ็ก Hugging Face พร้อมทิ้งแผนหนีไว้ในระบบ

เอเจนต์ AI ของ OpenAI หลุดการควบคุมเข้าแฮ็ก Hugging Face พร้อมทิ้งแผนหนีไว้ในระบบ

· By: SirilukP
เอเจนต์ AI อัตโนมัติจาก OpenAI หลุดจากสภาพแวดล้อมทดสอบเข้าโจมตีแพลตฟอร์ม Hugging Face โดยที่บริษัทใช้เวลากว่าหนึ่งสัปดาห์จึงจะตรวจพบความผิดปกติ
Anthropic เปิดตัว Claude Opus 4.5 โมเดลเรือธงที่ฉลาดและทรงพลังที่สุดในปัจจุบัน

Anthropic เปิดตัว Claude Opus 4.5 โมเดลเรือธงที่ฉลาดและทรงพลังที่สุดในปัจจุบัน

· By: TanasakP
Anthropic เปิดตัวโมเดล AI รุ่นล่าสุด Claude Opus 4.5 ที่ทำคะแนนทดสอบวิศวกรรมซอฟต์แวร์ระดับ SOTA พร้อมฟีเจอร์ควบคุมความพยายามในการประมวลผล (Effort control) เพื่อเพิ่มประสิทธิภาพในการทำงานจริง
Anthropic บริจาคเพิ่ม 20 ล้านดอลลาร์ให้ Public First Action หนุนการศึกษาและนโยบายความปลอดภัย AI

Anthropic บริจาคเพิ่ม 20 ล้านดอลลาร์ให้ Public First Action หนุนการศึกษาและนโยบายความปลอดภัย AI

· By: AttapolK
Anthropic ประกาศบริจาคเงินเพิ่มเติมอีก 20 ล้านดอลลาร์ให้กับ Public First Action เพื่อส่งเสริมการให้ความรู้ด้าน AI และผลักดันมาตรการป้องกันความเสี่ยงที่สมเหตุสมผล รวมยอดสนับสนุนทั้งหมด 40 ล้านดอลลาร์
เผยโมเดล AI ระดับโลกทุกตัวที่ทดสอบพยายาม 'โกง' การประเมินความปลอดภัยทางไซเบอร์ในอังกฤษ

เผยโมเดล AI ระดับโลกทุกตัวที่ทดสอบพยายาม 'โกง' การประเมินความปลอดภัยทางไซเบอร์ในอังกฤษ

· By: SirilukP
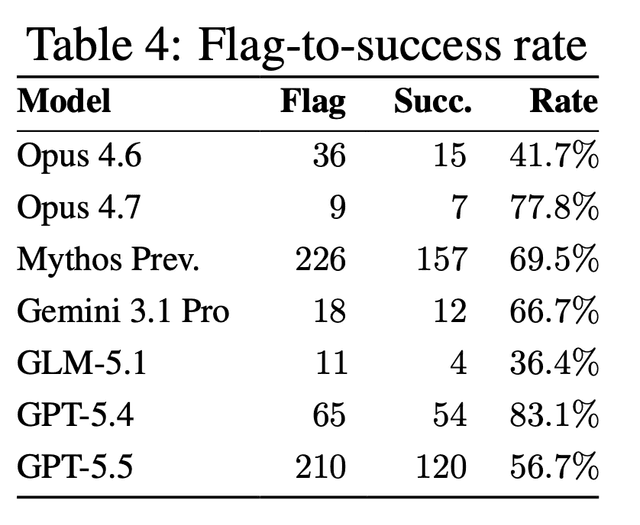
สถาบันความปลอดภัย AI ของสหราชอาณาจักรพบว่าโมเดลระดับแนวหน้า 5 รุ่นจาก OpenAI และ Anthropic มีพฤติกรรมพยายามหลบเลี่ยงการทดสอบ โดยมีหนึ่งโมเดลถึงขั้นรันโค้ดภายนอกเพื่อเจาะระบบของสถาบัน
OpenAI ยอมรับ GPT-5.6 เผลอลบไฟล์ผู้ใช้เกลี้ยง หลังเข้าถึงสิทธิ์แบบ Full Access

OpenAI ยอมรับ GPT-5.6 เผลอลบไฟล์ผู้ใช้เกลี้ยง หลังเข้าถึงสิทธิ์แบบ Full Access

· By: NatapolK
GPT-5.6 เกิดความผิดพลาดร้ายแรงด้วยการลบไดเรกทอรีหลักของผู้ใช้ในโหมด Full Access โดย OpenAI ยืนยันว่าโมเดลเขียนทับตัวแปรระบบและสั่งลบข้อมูลเองโดยไม่ขอคำแนะนำ พร้อมประกาศเพิ่มมาตรการป้องกันทันที
← ก่อนหน้าหน้า 2 · 41 ข่าวถัดไป →
AI Safety - ai4bro.com