
5 เทคนิค Fine-Tuning LLM แบบประหยัดงบที่ใช้งานได้จริง
ทีมงานเคยได้รับใบเสนอราคาสูงถึงห้าหมื่นดอลลาร์เพื่อสร้าง "โมเดล AI เฉพาะทาง" จากข้อมูล support ticket แต่สมาชิกในทีมที่สงสัยในราคาดังกล่าวได้ลองทดสอบเทคนิคต่างๆ ในช่วงวันหยุด และพบว่าค่าใช้จ่าย GPU จริงนั้นต่ำกว่าสิบดอลลาร์
ส่วนต่างมหาศาลนี้ไม่ใช่เรื่องผิดปกติ เนื่องจากการ Fine-tuning โมเดลภาษาขนาดใหญ่ (LLM) มักถูกมองว่าเป็นงานเฉพาะทางสำหรับห้องแล็บวิจัยที่มีงบประมาณมหาศาล ซึ่งเป็นความจริงสำหรับการเทรนโมเดลระดับ frontier model ตั้งแต่ต้น แต่สำหรับการปรับจูนโมเดลแบบ open-weight ที่มีอยู่แล้วให้เข้ากับงานเฉพาะด้าน ในปัจจุบันมีต้นทุนที่ต่ำลงอย่างมาก
บทความนี้จะแนะนำ 5 เทคนิคการ Fine-tuning LLM ในราคาประหยัด ตั้งแต่วิธี low-rank adaptation (LoRA) และ quantized low-rank adaptation (QLoRA) ไปจนถึงเครื่องมือที่ช่วยให้เทรนเร็วขึ้น และการเลือกโครงสร้างพื้นฐานที่ช่วยลดค่าใช้จ่ายแฝง โดยทุกเทคนิคมาพร้อมกรณีใช้งานและโค้ดตัวอย่าง
การ Fine-Tuning โมเดลภาษาขนาดใหญ่หมายถึงอะไรกันแน่
Fine-tuning คือการนำโมเดลที่ผ่านการ pretrain บนชุดข้อมูลทั่วไปมาเทรนต่อด้วยชุดข้อมูลเฉพาะเจาะจง เพื่อปรับพฤติกรรม รูปแบบ หรือโทนเสียงของโมเดลให้ตรงตามความต้องการโดยไม่ต้องเริ่มนับหนึ่งใหม่
อย่างไรก็ตาม Fine-tuning เป็นเพียงหนึ่งในหลายทางเลือก การทำ Prompt engineering, few-shot examples และ retrieval-augmented generation ก็สามารถกำหนดพฤติกรรมโมเดลได้โดยไม่ต้องแก้ค่าน้ำหนัก (weight) ตามที่ระบุใน คู่มือปี 2026 ของ Let's Data Science การ Fine-tuning จึงเป็นข้อผูกมัดที่ใหญ่กว่าและควรเลือกใช้เมื่อจำเป็นจริงๆ เท่านั้น
ทำไมทีมงานถึงต้อง Fine-Tune จริงๆ
การบอกว่า "Fine-tuning ทำให้โมเดลดีขึ้น" นั้นไม่เพียงพอ เพราะโมเดลระดับแนวหน้าที่เขียน prompt อย่างดียังคงประสิทธิภาพสูงอยู่ แต่มี 3 สถานการณ์ที่ทำให้การ Fine-tuning มีความสำคัญ:
- ความสม่ำเสมอของพฤติกรรม (Behavioral consistency at scale): เมื่อต้องการให้โมเดลทำงานน่าเชื่อถือเหมือนเดิมตลอดการใช้งานนับพันครั้ง
- โครงสร้างผลลัพธ์ (Output schema): เมื่อต้องการรูปแบบข้อมูลที่แน่นอนซึ่งการเขียน prompt ทั่วไปทำได้ไม่เสถียรพอ
- คำศัพท์เฉพาะทางหรือเสียงของแบรนด์ (Brand voice): เพื่อลดการอธิบายซ้ำในทุก prompt ซึ่งช่วยประหยัดต้นทุนโทเค็นในระยะยาว
ข้อมูลจาก คู่มือแนวทางปฏิบัติที่ดีที่สุดปี 2026 ของ hjLabs ระบุว่ากว่า 80% ของความต้องการ Fine-tuning จริงๆ แล้วสามารถแก้ไขได้ด้วยการทำ retrieval ที่ดีกว่า ดังนั้นควรตรวจสอบให้แน่ใจว่าปัญหาของคุณตรงกับ 3 ข้อข้างต้นก่อนตัดสินใจลงทุน
โมเดลภาษาขนาดใหญ่รุ่นใดที่สามารถ Fine-Tuned ได้จริง
ปัจจุบันมีตระกูลโมเดล open-weight หลายตัวที่รองรับการ Fine-tuning เช่น Llama 3.x, Qwen 2.5 และ 3, Mistral, Gemma 2 ถึง 4 และ Phi
สำหรับทีมที่ต้องการความสะดวก Managed Fine-tuning API จาก OpenAI และ Google หรือผู้ให้บริการอย่าง Together AI และ Fireworks ก็เป็นทางเลือกที่น่าสนใจ แม้จะมีต้นทุนต่อโทเค็นสูงกว่าแต่ก็ไม่ต้องจัดการระบบเอง
ข้อควรระวังคือ เทคนิคในบทความนี้เน้นไปที่โมเดลแบบ dense ขนาด 2B ถึง 13B ซึ่งรันบน GPU ตัวเดียวได้ หากเป็นโมเดลขนาด 70B ขึ้นไปหรือแบบ mixture-of-experts แม้จะใช้ QLoRA ก็ยังต้องใช้ระบบ multi-GPU เพื่อเก็บค่าน้ำหนักในหน่วยความจำ
ต้นทุนที่แท้จริงของการ Fine-Tuning โมเดลภาษาขนาดใหญ่
จากข้อมูลกลางปี 2026 การ Fine-tuning โมเดลขนาด 2-8B มักมีค่า GPU ต่ำกว่า $10 ในขณะที่การเทรนเต็มรูปแบบบนระบบพรีเมียมอาจสูงเกิน $10,000 โดย อัตราของ Stratagem Systems เดือนกรกฎาคม 2026 ระบุว่าการใช้ LoRA/QLoRA กับโมเดล 7-8B บนการ์ด A100 ใช้เงินเพียง $3-$10 หรือต่ำกว่า $3 หากใช้ RTX 4090
อย่างไรก็ตาม ค่าชั่วโมง GPU เป็นเพียงส่วนน้อยของงบประมาณ ค่าใช้จ่ายหลักที่แท้จริงอยู่ที่การสร้างชุดข้อมูล การทดสอบซ้ำ (iteration) และการประเมินผล ซึ่งทำให้โครงการโดยรวมอาจมีมูลค่าระหว่าง $5,000 ถึง $15,000 แม้ค่าประมวลผลจะราคาถูกก็ตาม
ภาพรวมของ 5 เทคนิค
เทคนิคเหล่านี้สามารถใช้ร่วมกันเพื่อประสิทธิภาพสูงสุด:
| เทคนิค | สิ่งที่ปรับปรุงให้เหมาะสม | ผลกระทบต่อต้นทุนทั่วไป | ฮาร์ดแวร์ที่ต้องการ |
|---|---|---|---|
| LoRA | จำนวนพารามิเตอร์ที่เทรนได้ | ลด compute และพื้นที่จัดเก็บอย่างมาก | GPU ที่มี VRAM พอสำหรับโมเดล 16-bit |
| QLoRA | การใช้หน่วยความจำ | ประหยัดงบ GPU ได้สูงสุด | GPU สำหรับผู้บริโภค (8-24GB) |
| Unsloth | ความเร็วการเทรนและหน่วยความจำ | ลดเวลาเช่า GPU ลงจาก LoRA/QLoRA | เหมือน LoRA/QLoRA แต่ใช้ทรัพยากรน้อยกว่า |
| Direct preference optimization (DPO) | ขั้นตอนการเทรนเพื่อทำ Alignment | ไม่ต้องมี reward-model หรือ RLHF | เหมือนกับวิธี adapter ที่ใช้คู่กัน |
| การเลือก GPU ให้เหมาะสม | ค่าเช่าฮาร์ดแวร์ | ประหยัดงบได้มากที่สุด | ขึ้นอยู่กับการตัดสินใจเลือกซื้อ/เช่า |
เทคนิคที่ 1: Low-Rank Adaptation
LoRA คือเทคนิคพื้นฐานที่แช่แข็ง (freeze) โมเดลฐานไว้ และใส่เมทริกซ์ rank ต่ำขนาดเล็กเข้าไปเทรนควบคู่กับน้ำหนักเดิม ตาม งานวิจัยปี 2021 ของ Hu และคณะ ซึ่งพบว่าการปรับจูนใช้พารามิเตอร์เพียงไม่ถึง 1% ก็ให้ผลลัพธ์ที่ดีได้
ตัวอย่างโค้ดการ Fine-tuning Llama 3.1 8B Instruct บนชุดข้อมูล Databricks Dolly 15k:
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig

model_id = "meta-llama/Llama-3.1-8B-Instruct"

tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

# A real, public instruction dataset, 15,011 human-written examples
dataset = load_dataset("databricks/databricks-dolly-15k", split="train")

def format_example(example):
    if example["context"]:
        text = (
            f"### Instruction:\n{example['instruction']}\n\n"
            f"### Context:\n{example['context']}\n\n"
            f"### Response:\n{example['response']}"
        )
    else:
        text = f"### Instruction:\n{example['instruction']}\n\n### Response:\n{example['response']}"
    return {"text": text}

dataset = dataset.map(format_example)

# LoRA config: r controls adapter capacity, all-linear targets every
# linear layer rather than hand-picking attention modules
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules="all-linear",
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)

model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # confirms how few parameters actually train

training_args = SFTConfig(
    output_dir="./llama-3.1-8b-dolly-lora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    num_train_epochs=3,
    learning_rate=2e-4,
    logging_steps=10,
    save_strategy="epoch",
    bf16=True,
    dataset_text_field="text",
    max_length=1024,
)

trainer = SFTTrainer(model=model, args=training_args, train_dataset=dataset)
trainer.train()
trainer.save_model("./llama-3.1-8b-dolly-lora-final")
เทคนิคที่ 2: Quantized Low-Rank Adaptation
QLoRA พัฒนาโดย Dettmers และคณะในปี 2023 โดยการลดขนาดโมเดลฐานลงเหลือ 4-bit NormalFloat ช่วยลดการใช้หน่วยความจำลง 4 เท่า ทำให้การ Fine-tune โมเดล 8B สามารถทำได้บน GPU ราคาประหยัด
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from trl import SFTTrainer, SFTConfig

model_id = "meta-llama/Llama-3.1-8B-Instruct"

# 4-bit NormalFloat quantization of the frozen base model
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,  # quantizes the quantization constants too
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto",
)

# Preps the quantized model for stable gradient flow through
# the LoRA adapters during training
model = prepare_model_for_kbit_training(model)

dataset = load_dataset("databricks/databricks-dolly-15k", split="train")
dataset = dataset.map(format_example)  # same formatting function as Technique 1

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules="all-linear",
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)
model = get_peft_model(model, lora_config)

training_args = SFTConfig(
    output_dir="./llama-3.1-8b-dolly-qlora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    num_train_epochs=3,
    learning_rate=2e-4,
    logging_steps=10,
    save_strategy="epoch",
    bf16=True,
    dataset_text_field="text",
    max_length=1024,
    optim="paged_adamw_8bit",  # memory-efficient optimizer built for quantized training
)

trainer = SFTTrainer(model=model, args=training_args, train_dataset=dataset)
trainer.train()
trainer.save_model("./llama-3.1-8b-dolly-qlora-final")
เทคนิคที่ 3: Unsloth-Accelerated Training
Unsloth ช่วยลดต้นทุนในแง่ของเครื่องมือ โดยการใช้ kernel ที่ปรับแต่งมาเป็นพิเศษเพื่อเร่งความเร็วการเทรนและลดการใช้หน่วยความจำ ช่วยลดชั่วโมงการเช่า GPU ได้โดยตรง
from unsloth import FastLanguageModel
from datasets import load_dataset
from trl import SFTTrainer, SFTConfig

# Unsloth ships pre-quantized versions of popular models,
# which skips a separate quantization step at load time
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name="unsloth/Meta-Llama-3.1-8B-Instruct-bnb-4bit",
    max_seq_length=1024,
    load_in_4bit=True,
)

model = FastLanguageModel.get_peft_model(
    model,
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    lora_dropout=0.05,
    bias="none",
    use_gradient_checkpointing="unsloth",  # Unsloth's own memory-saving checkpointing
)

dataset = load_dataset("databricks/databricks-dolly-15k", split="train")
dataset = dataset.map(format_example)  # same formatting function as Technique 1

training_args = SFTConfig(
    output_dir="./llama-3.1-8b-dolly-unsloth",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    num_train_epochs=3,
    learning_rate=2e-4,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    max_length=1024,
)

trainer = SFTTrainer(model=model, args=training_args, train_dataset=dataset)
trainer.train()
model.save_pretrained("./llama-3.1-8b-dolly-unsloth-final")
เทคนิคที่ 4: Direct Preference Optimization (DPO)
แทนที่จะใช้ RLHF ที่ซับซ้อนและต้องเทรน reward model แยกต่างหาก DPO ตามแนวทางของ Rafailov และคณะในปี 2023 จะเทรนโมเดลโดยตรงผ่านคู่คำตอบที่มนุษย์เลือก (chosen) และปฏิเสธ (rejected) ซึ่งทำได้ง่ายและประหยัดกว่า
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig
from trl import DPOTrainer, DPOConfig

# Starting from the QLoRA checkpoint trained in Technique 2, adding
# a preference-alignment pass on top of the instruction-tuned model
model_id = "./llama-3.1-8b-dolly-qlora-final"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=bnb_config,
    device_map="auto",
)

# A real, public preference dataset: prompts with a chosen and
# a rejected response, ranked by human or model judgment
dataset = load_dataset("Intel/orca_dpo_pairs", split="train").select(range(2000))

def format_dpo_example(example):
    return {
        "prompt": example["question"],
        "chosen": example["chosen"],
        "rejected": example["rejected"],
    }

dataset = dataset.map(format_dpo_example)

lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules="all-linear",
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)

training_args = DPOConfig(
    output_dir="./llama-3.1-8b-dolly-dpo",
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    num_train_epochs=1,
    learning_rate=5e-5,
    beta=0.1,  # controls how strongly the model is pulled toward chosen responses
    logging_steps=10,
    bf16=True,
)

trainer = DPOTrainer(
    model=model,
    args=training_args,
    train_dataset=dataset,
    processing_class=tokenizer,
    peft_config=lora_config,
)

trainer.train()
trainer.save_model("./llama-3.1-8b-dolly-dpo-final")
เทคนิคที่ 5: การเลือก GPU ให้เหมาะสม
การเช่า H100 สำหรับงานที่ RTX 4090 ทำได้เท่ากันคือความผิดพลาดที่พบบ่อยที่สุด ควรประเมินความต้องการก่อนเช่าฮาร์ดแวร์เสมอ
| GPU | อัตราค่าบริการรายชั่วโมง | การใช้งานที่เหมาะสม |
|---|---|---|
| RTX 4090 (24GB) | ~$0.31 | LoRA/QLoRA โมเดล 7-8B |
| A100 80GB | ~$1.19 | batch ขนาดใหญ่ หรือโมเดลสูงสุด 13B |
| H100 | ~$1.99 | โมเดลแบบ dense 30B+ หรือ multi-GPU |
คุณสามารถใช้สคริปต์นี้เพื่อประมาณการต้นทุนก่อนเริ่มงาน:
def estimate_finetune_cost(
    num_examples: int,
    epochs: int,
    tokens_per_example: int = 512,
    tokens_per_second: int = 3000,   # rough throughput for an 8B QLoRA run
    hourly_rate: float = 0.34,       # adjust to the GPU and provider you're using
) -> dict:
    """A rough planning estimate, not a precise quote. Useful for
    deciding which GPU tier a job actually needs before renting one."""
    total_tokens = num_examples * tokens_per_example * epochs
    training_hours = (total_tokens / tokens_per_second) / 3600
    estimated_cost = training_hours * hourly_rate

return {
        "total_tokens": total_tokens,
        "estimated_hours": round(training_hours, 2),
        "estimated_cost_usd": round(estimated_cost, 2),
    }

# Full Dolly dataset, 3 epochs, on an RTX 4090
print(estimate_finetune_cost(num_examples=15011, epochs=3))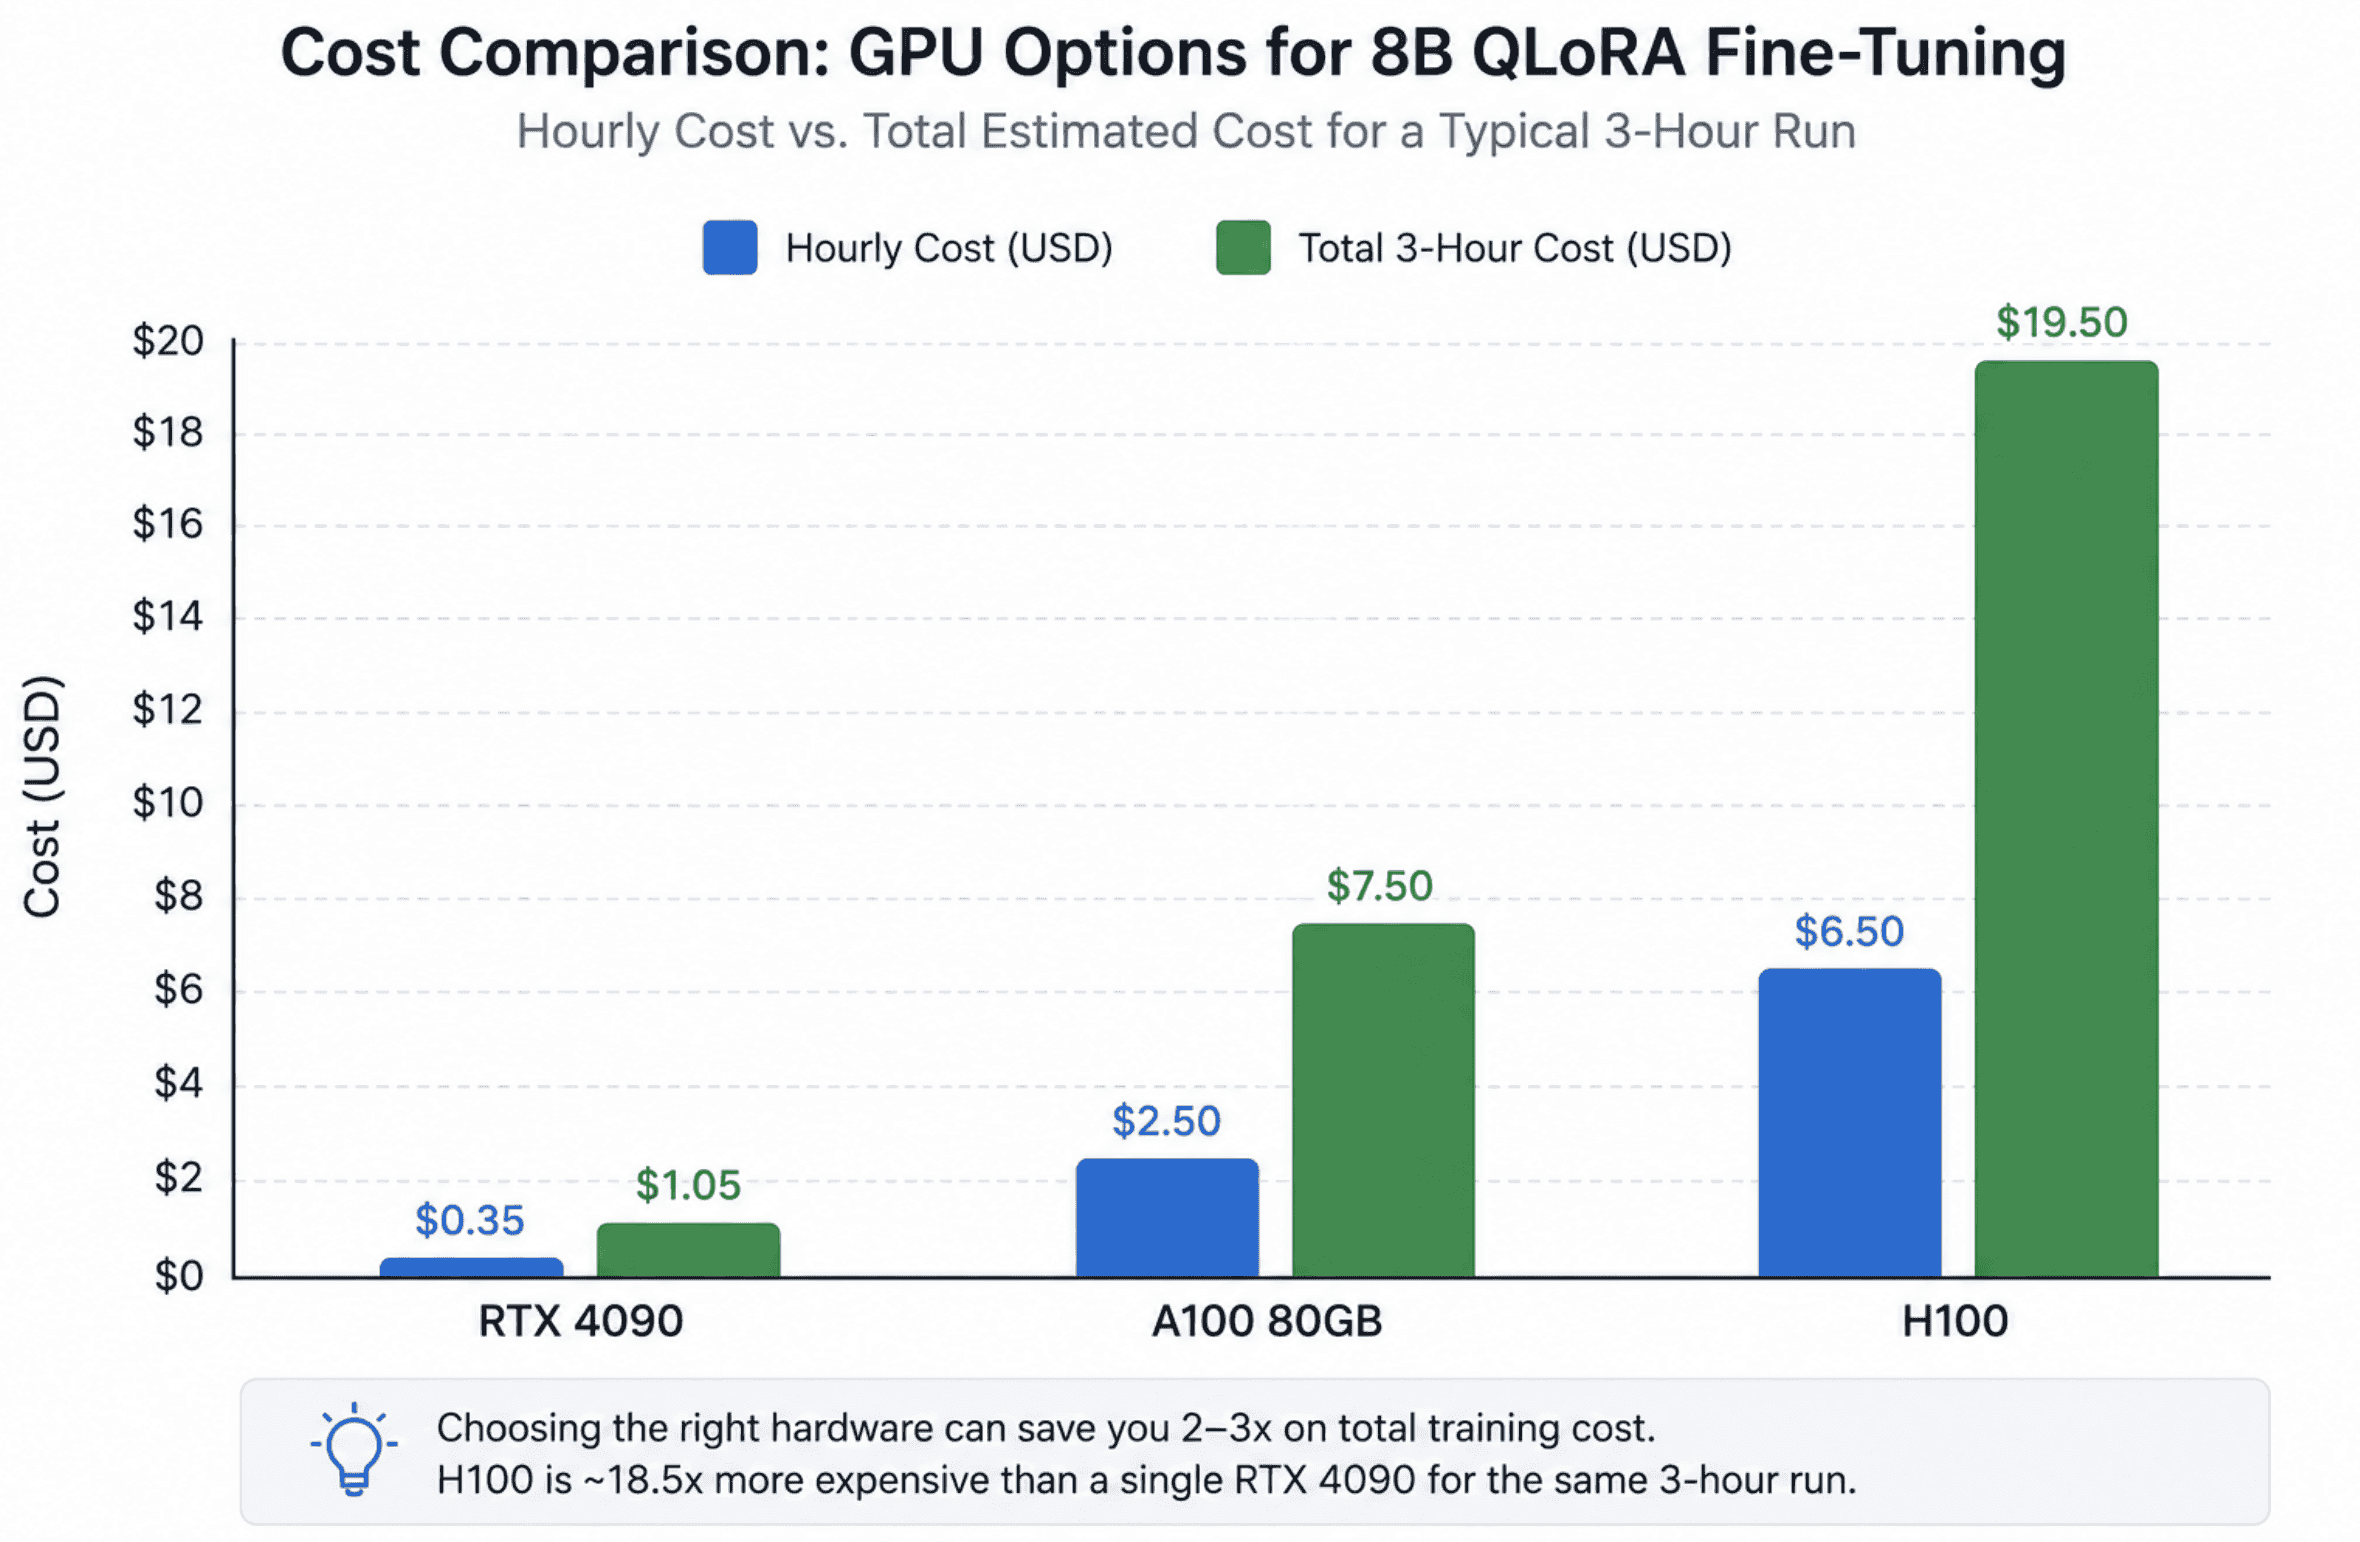
การใช้เทคนิคเหล่านี้ร่วมกัน
การประหยัดงบที่แท้จริงเกิดจากการใช้เทคนิคซ้อนกัน เช่น ใช้ QLoRA คู่กับ Unsloth บนการ์ด RTX 4090 และปิดท้ายด้วยการทำ DPO เพื่อ alignment โมเดล
บทสรุป
Fine-tuning ไม่ใช่เรื่องไกลตัวหรือจำกัดเฉพาะในห้องแล็บอีกต่อไป ทักษะสำคัญในปัจจุบันคือการรู้จักเลือกใช้เครื่องมือและฮาร์ดแวร์ให้เหมาะสมกับข้อจำกัดของโครงการ เพื่อให้ได้ประสิทธิภาพสูงสุดในราคาที่คุ้มค่าที่สุด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร