
Anthropic เปิดตัว Claude Fable 5.2 และ Mythos 5.2 ก่อนเข้า IPO
ประเด็นสำคัญ
Anthropic เปิดตัว Claude Fable 5.2 และ Mythos 5.2 สองโมเดลเรือธงใหม่ที่ออกแบบมาเพื่อจัดการงานทางเทคนิคที่มีความซับซ้อนสูงโดยเฉพาะ โดยบริษัทระบุว่าได้จงใจจำกัดความสามารถบางอย่างในระหว่างการฝึกฝน เพื่อป้องกันไม่ให้โมเดลเร่งการพัฒนา AI ของตัวมันเองได้โดยตรง
ในด้านประสิทธิภาพ Fable 5.2 สามารถคว้าอันดับหนึ่งด้วยคะแนน 65 คะแนนจาก Artificial Analysis Intelligence Index v5 นำหน้า Gemini 4 Carbon อยู่ 5 คะแนน และทิ้งห่างรุ่นก่อนหน้าอย่าง Fable 5.1 ถึง 15 คะแนน อย่างไรก็ตาม คุณภาพระดับสูงสุดนี้มีค่าใช้จ่ายเฉลี่ยต่องานอยู่ที่ 26.50 ดอลลาร์ ซึ่งสูงกว่ารุ่น Opus 5.5 ประมาณ 2.6 เท่า
แม้ในระดับการประมวลผล (compute tiers) ที่ต่ำกว่า Fable 5.2 ก็ยังคงรักษาความเป็นผู้นำเหนือโมเดลอื่นทุกระดับด้วยคะแนน 62 คะแนน โดยใช้จำนวน token ในการประมวลผลน้อยกว่าคู่แข่งอย่างมีนัยสำคัญ
Claude Fable 5.2 และ Mythos 5.2 ช่วยให้ Anthropic ทวงคืนตำแหน่งผู้นำ AI ก่อนเตรียมการ IPO ในเร็วๆ นี้ โดย Fable จะเน้นความปลอดภัยสำหรับการใช้งานทั่วไป ส่วน Mythos ถูกปรับแต่งมาเพื่องานเฉพาะทางที่ต้องการความยืดหยุ่นสูงกว่า
โมเดลทั้งสองใช้โครงสร้างพื้นฐานเดียวกันแต่ต่างกันที่การควบคุมการเข้าถึง Fable จะมีมาตรการความปลอดภัยเข้มงวดเพื่อบล็อกงานที่มีความเสี่ยงด้านความมั่นคงปลอดภัยไซเบอร์และชีววิทยา เพื่อให้บุคคลทั่วไปใช้งานได้อย่างปลอดภัย ส่วน Mythos จะถอดข้อจำกัดบางอย่างออกเพื่อเปิดให้องค์กรที่ผ่าน Verification Programs นำไปใช้ในงานด้านไซเบอร์หรือชีววิทยาศาสตร์โดยเฉพาะ
ด้านราคาค่าบริการกำหนดไว้ที่ 8 ดอลลาร์ต่อหนึ่งล้าน input tokens และ 40 ดอลลาร์ต่อหนึ่งล้าน output tokens ซึ่งถือว่าถูกลงกว่ารุ่นก่อนหน้า โดย Anthropic วางตำแหน่งโมเดลชุดนี้ไว้สำหรับงานเทคนิคขั้นสูง และยังคงแนะนำให้ใช้ Claude Opus 5.5 สำหรับการใช้งานทั่วไปในชีวิตประจำวัน
นอกจากนี้ โมเดลใหม่ยังประมวลผลผลลัพธ์ได้เร็วขึ้นสูงสุด 30% เมื่อเทียบกับรุ่น 5.1 และยังมีโหมดเร็ว (fast mode) เป็นทางเลือกสำหรับองค์กร ซึ่งสามารถเพิ่มความเร็วการส่งออก token ได้สูงสุดถึง 2.5 เท่า โดยมีค่าใช้จ่ายเพิ่มขึ้นเป็นสองเท่าและพร้อมให้บริการบนแพลตฟอร์มหลักอย่าง Claude Platform, Google Cloud และ Microsoft Foundry
Fable 5.2 ก้าวกระโดดขึ้นเป็นผู้นำชัดเจนบน Benchmark
Artificial Analysis’s benchmarks ระบุว่า Fable 5.2 อยู่ในอันดับเหนือกว่าคู่แข่งอย่างชัดเจนใน Index v5 ปัจจุบัน โดยเอาชนะทั้ง Gemini 4 Carbon ของ Google ที่ยังไม่ได้เปิดตัว และรุ่นพี่อย่าง Claude Opus 5.5 ไปได้ทั้งหมด
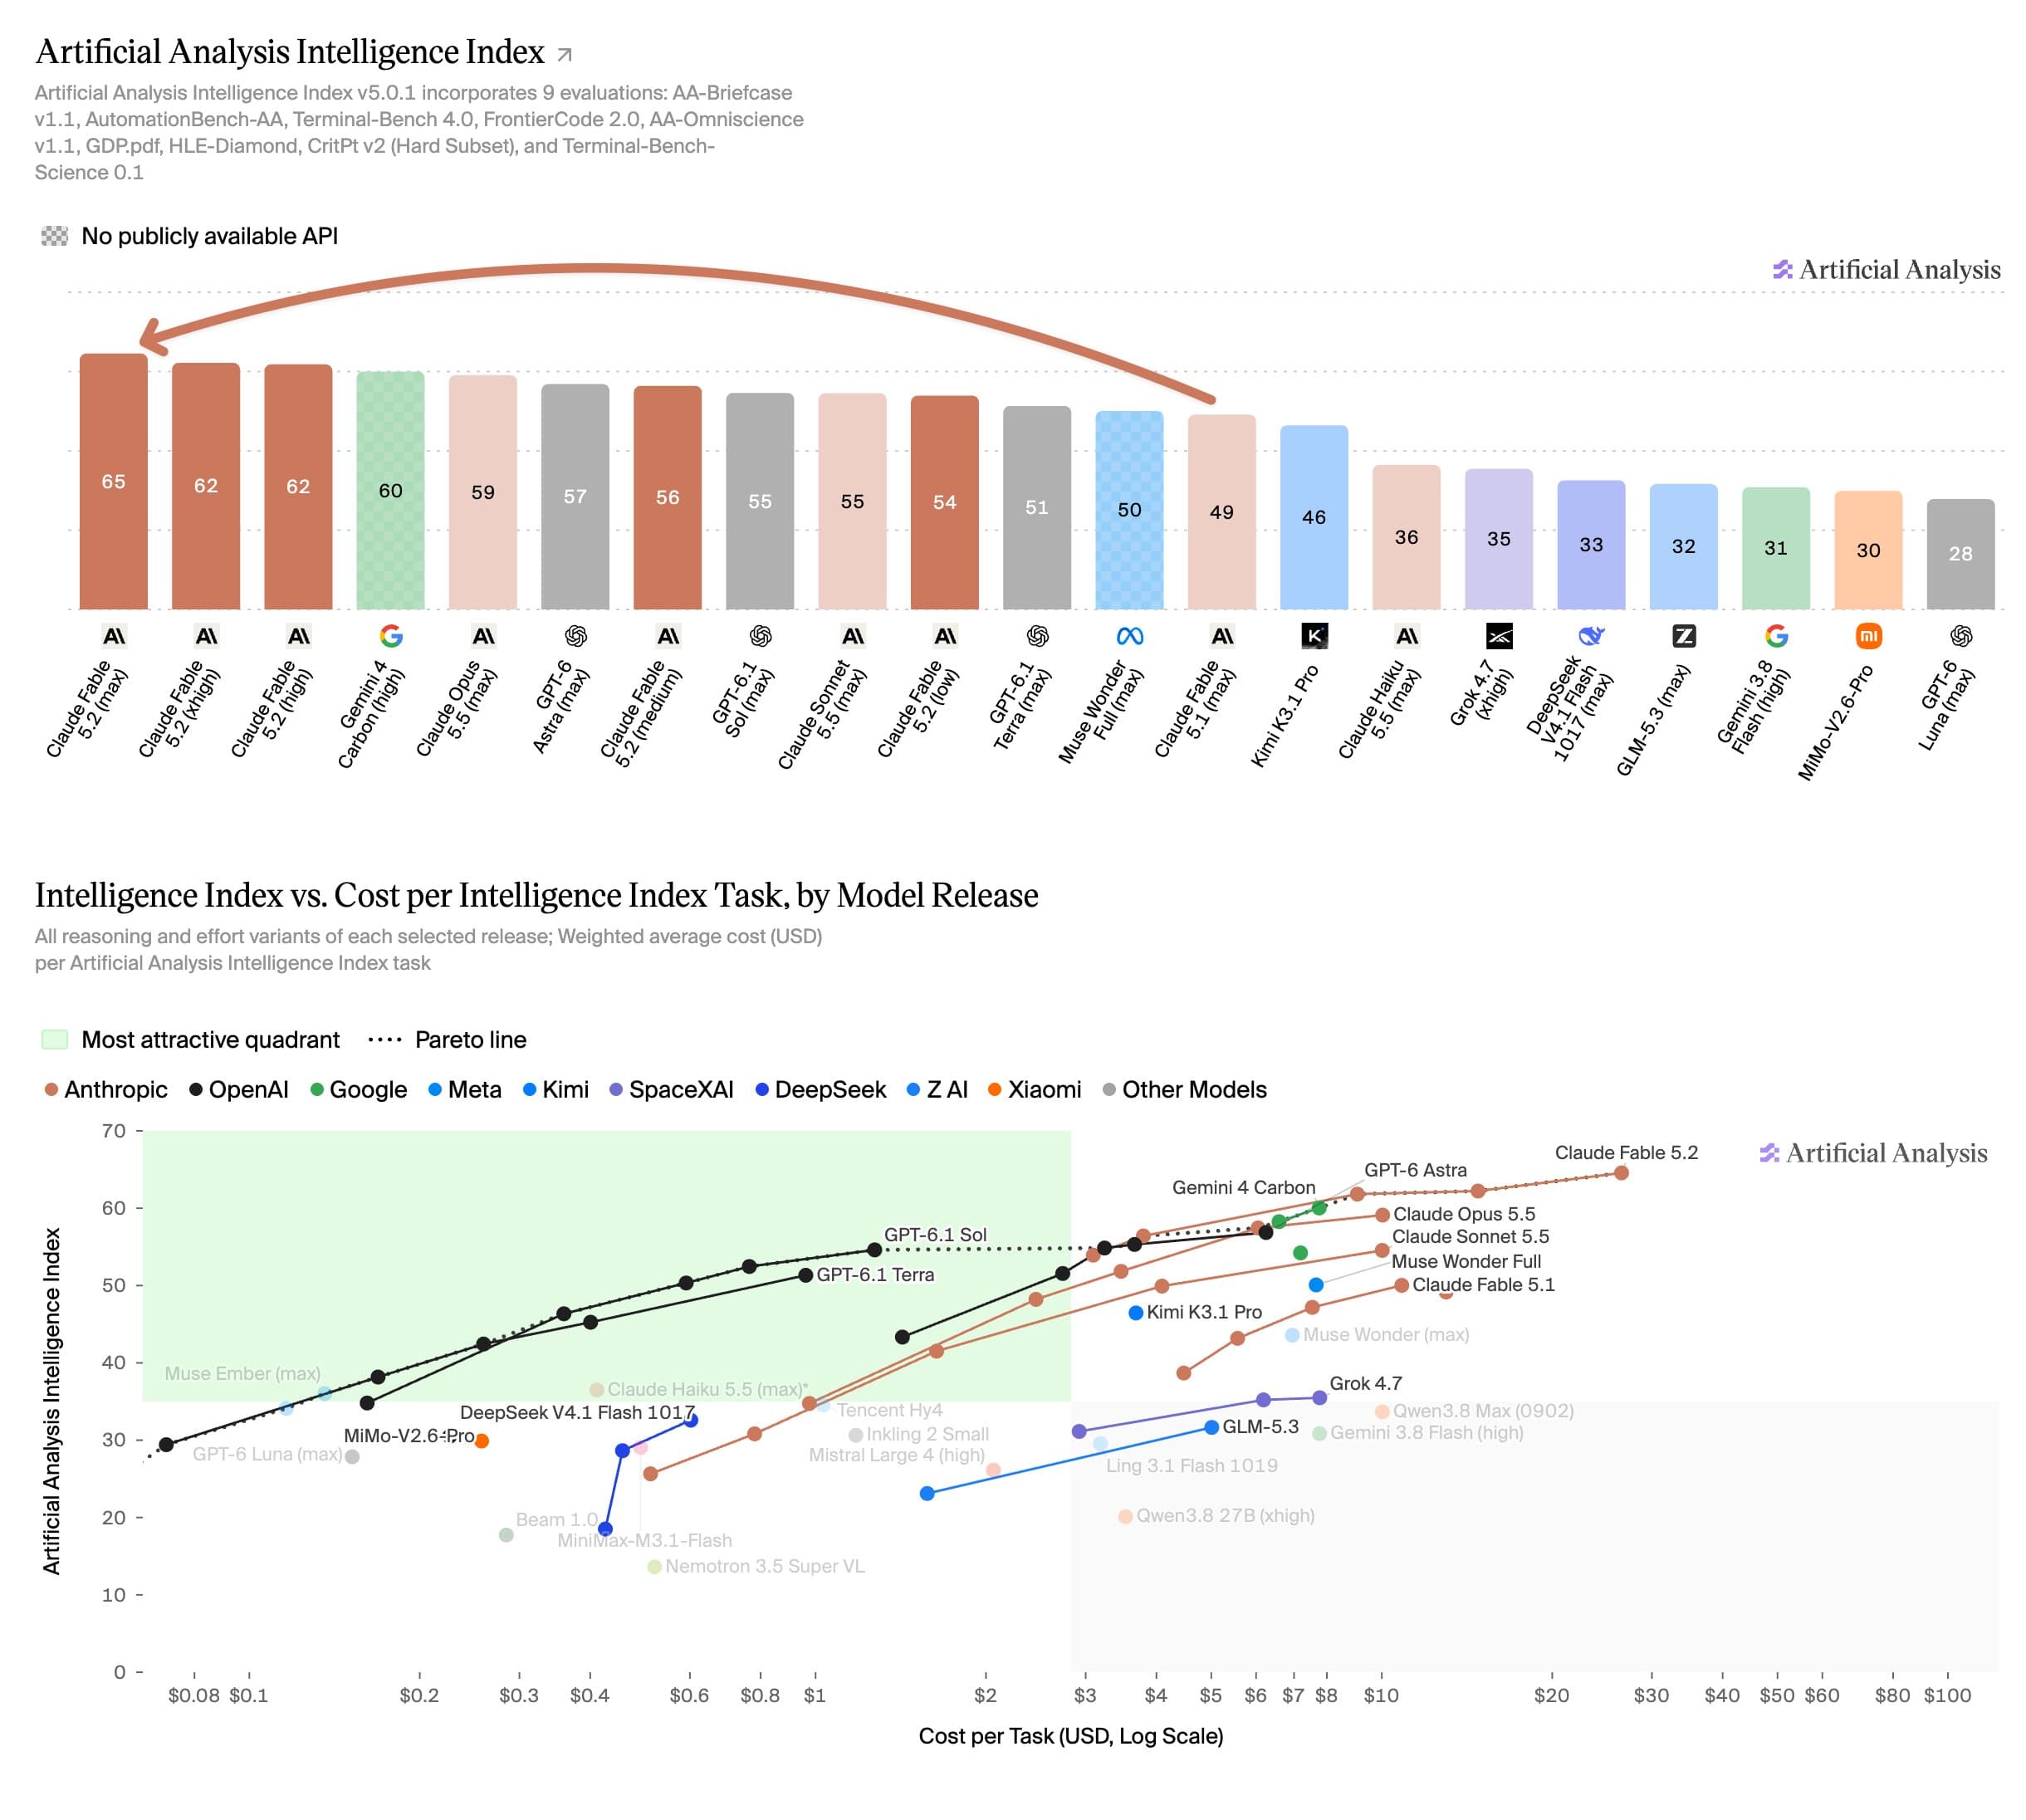
Fable 5.2 ทำคะแนนสูงสุดในการทดสอบรายบุคคล 5 จาก 9 รายการ โดยโดดเด่นมากใน HLE-Diamond ซึ่งทดสอบคำถามทางวิชาการระดับเชี่ยวชาญ และ Terminal-Bench-Science ที่ทดสอบการรันกระบวนการทางวิทยาศาสตร์ในเทอร์มินัลได้อย่างอิสระ รวมถึง FrontierCode 2.0 สำหรับการแก้ไขโค้ดในโครงการโอเพนซอร์สจริง
จุดที่ยังเป็นรองคือด้านงานความรู้แบบเอเจนต์ (agentic knowledge work) และการเขียนโค้ดผ่านเทอร์มินัลบางส่วน โดยทำคะแนนใน AA-Briefcase ตามหลัง Claude Sonnet 5.5 เล็กน้อย และใน Terminal-Bench 4.0 ยังคงมีคะแนนเท่ากับ Opus 5.5 ซึ่งตามหลังคู่แข่งอย่าง Kimi K3.1 Pro และ Gemini 4 Carbon ในส่วนนี้
อย่างไรก็ตาม ประสิทธิภาพในการประมวลผลต่อจำนวน token ยังคงน่าประทับใจ โดย Fable 5.2 ใช้ output tokens เพียง 98,000 ต่อหนึ่งงาน เมื่อเทียบกับ 173,000 ของ Opus 5.5 ที่ระดับสูงสุด ส่งผลให้การทำงานจริงมีความคล่องตัวและประหยัดทรัพยากรมากขึ้นในภาพรวม
| Anthropic Benchmark Results | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| Agentic coding FrontierCode 2.0 | 49.1% Xhigh effort | 32.4% Xhigh effort | 45.5% | 42.8% | 41.1% Medium effort |
| Agentic coding FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| Business Workflows AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Agentic scientific research Terminal-Bench Science 0.1 | 74.6% 75.3% (Myth 5.2) | 52.6% | 58.7% | 68.1% | 64.8% |
| Cybersecurity CyScenarioBench† | 76.3% Myth 5.2 | 61.7% Myth 5.1 | 67.6% without safeguards | 61% GPT-6 Cyber | - |
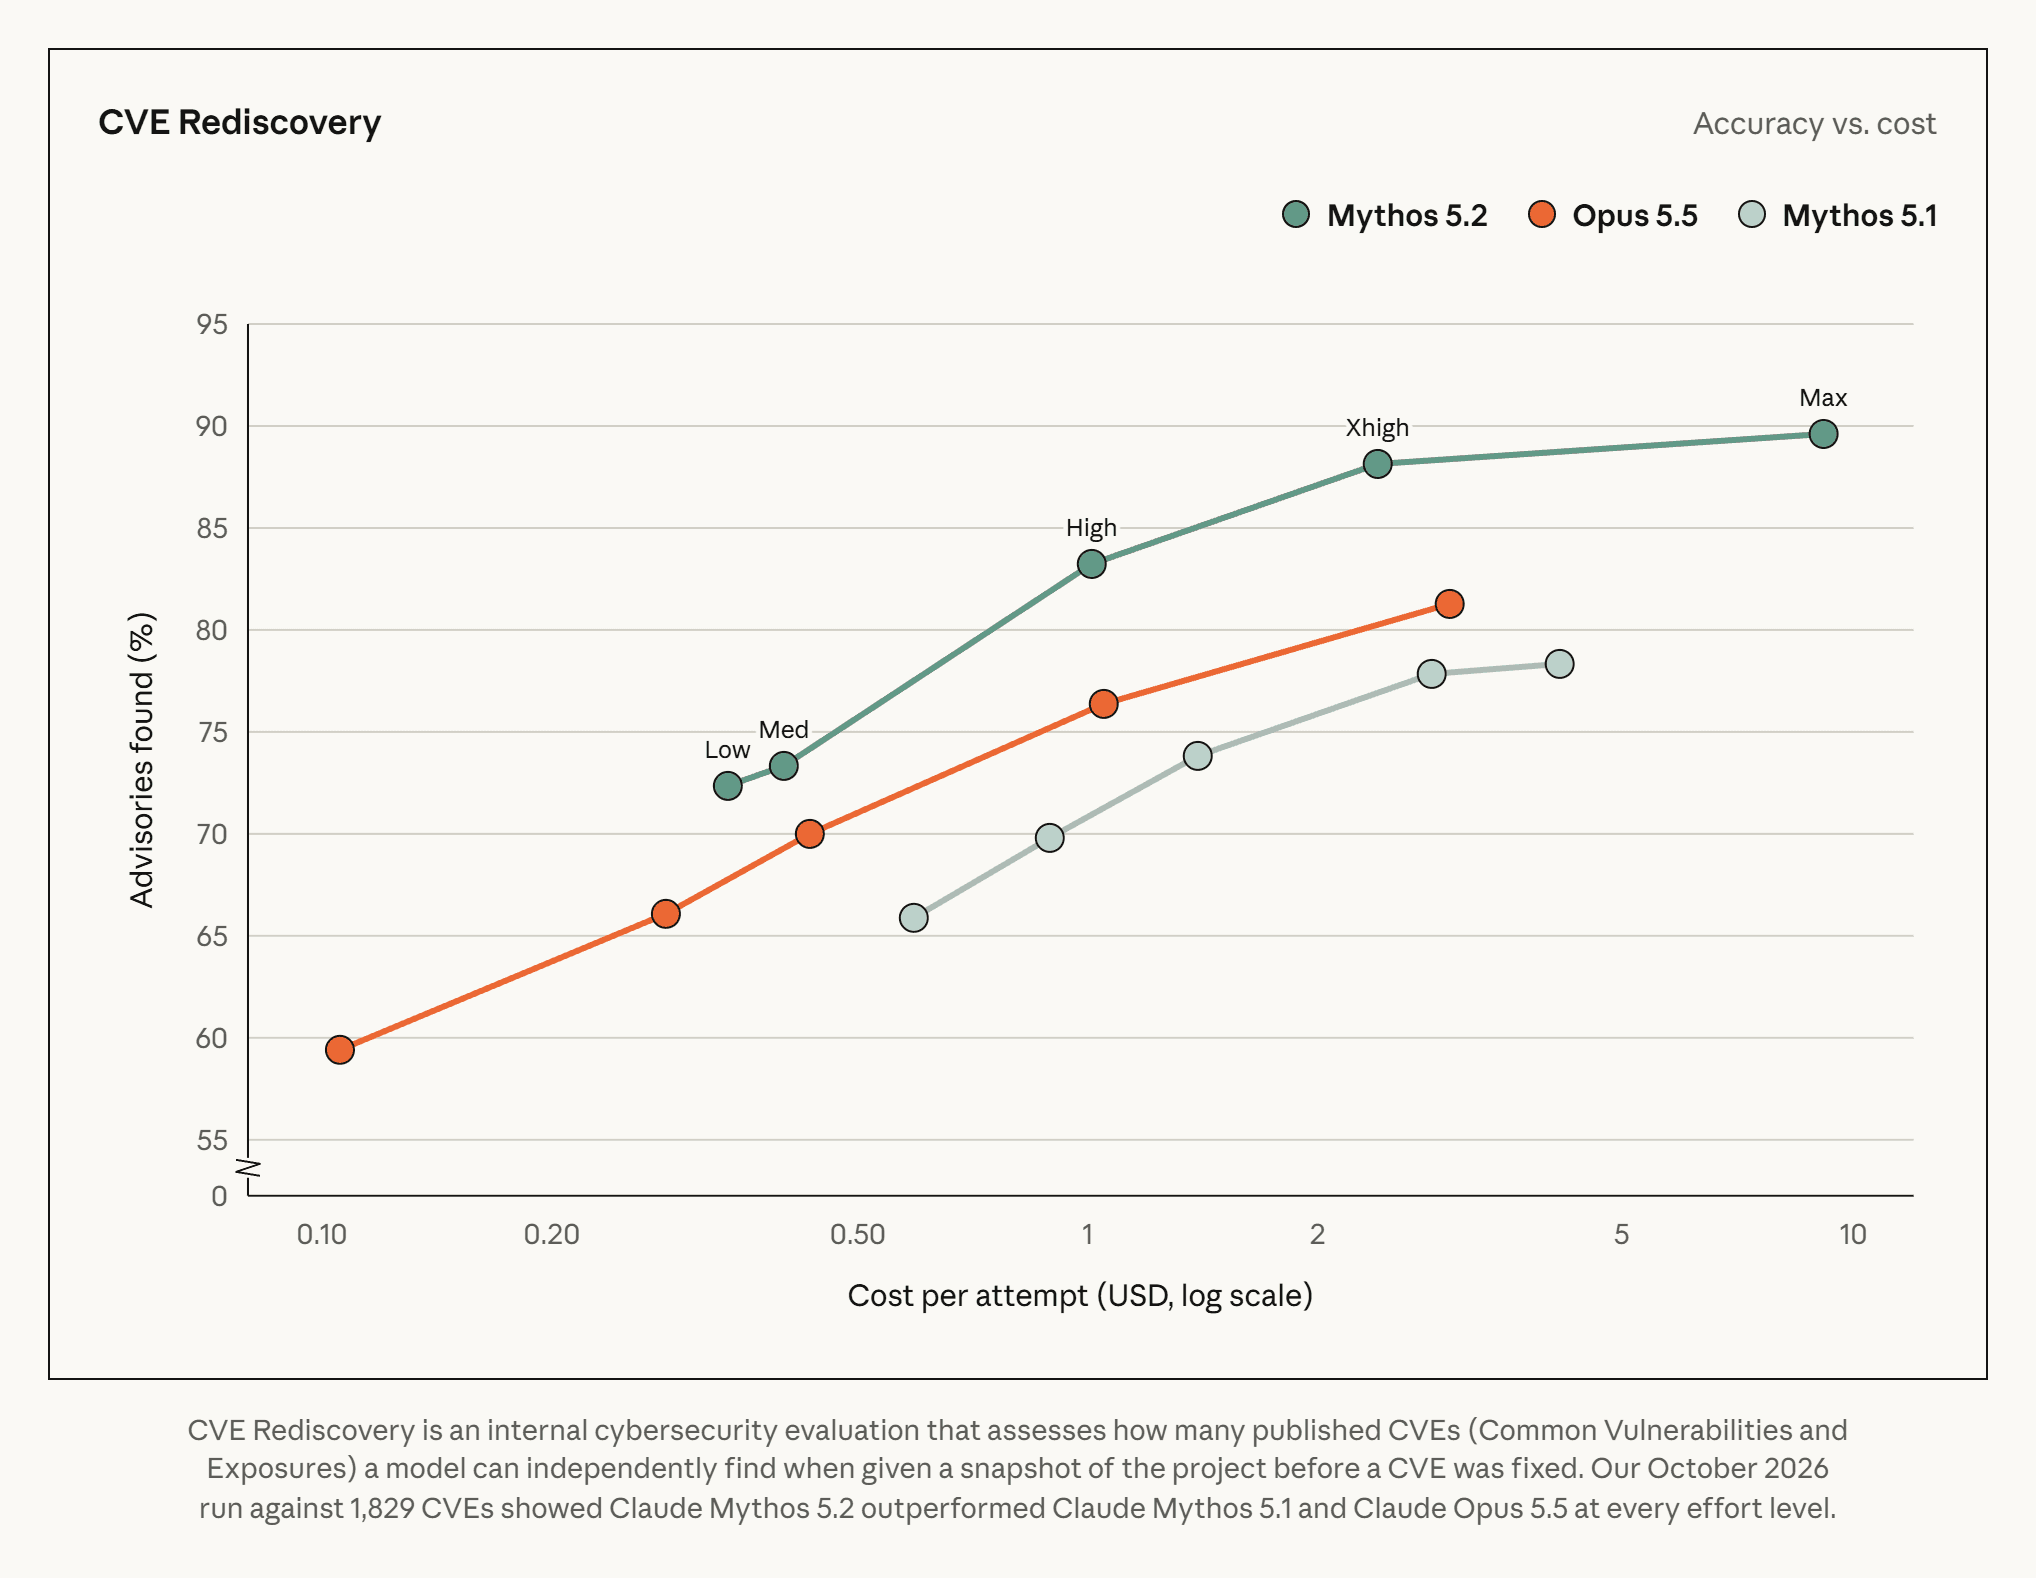
| Cybersecurity CVE Rediscovery | 89.6% Myth 5.2 | 78.3% Myth 5.1 | 81.3% without safeguards | - | - |
| Protein design De novo binder design (24 hr) | 85.1% Myth 5.2 | 79.1% Myth 5.1 | 82.6% without safeguards | - | - |
| Agentic search WANDR (relaxed score) | 82.1% | 68.7% | 72.3% | - | - |
| Computer use OSWorld 2.1 (offline set, partial) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| Robotics RoboDojoSim‡ | 64.9% | 27.6% | 39.4% | 29.8% | - |
| Knowledge work AA-Briefcase v1.1 | 66.1% rubric · 1785 Elo | 61.5% rubric · 1669 Elo | 61.2% rubric · 1800 Elo | 52.0% rubric · 1569 Elo | 61.8% rubric · 1611 Elo |
| Knowledge work Remote Labor Index (RLI) | 41.3% High effort | 17.9% | 21.3% | 20.8% | - |
| Multidisciplinary reasoning Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | - |
| Visual chart recognition Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Mythos 5.2 ตรวจพบช่องโหว่ความปลอดภัยได้เหนือกว่าทุกรุ่น
โมเดลใหม่สร้างสถิติใหม่ในด้าน Social Engineering และความมั่นคงปลอดภัยไซเบอร์ Anthropic เผยว่า Mythos 5.2 สามารถตรวจพบช่องโหว่ได้มากกว่ารุ่นก่อนๆ และเก่งขึ้นในการจำลองสถานการณ์เพื่อแก้ไขช่องโหว่ ด้วยเหตุนี้ Fable ที่เปิดให้สาธารณะใช้จึงต้องบล็อกงานด้านความปลอดภัยส่วนใหญ่ เช่น การทดสอบเจาะระบบและสร้าง exploit code โดยจะส่งต่องานเหล่านั้นไปให้รุ่น Opus จัดการภายใต้การควบคุมแทน
จากการทดสอบภายในที่เรียกว่า CVE Rediscovery ซึ่งเป็นการตรวจสอบความสามารถในการค้นหาช่องโหว่ที่ระบุในฐานข้อมูลสากล พบว่า Mythos 5.2 มีประสิทธิภาพสูงกว่า Opus 5.5 ถึง 10.2% และนำหน้า Mythos 5.1 ถึง 14.4% ในการทดสอบเมื่อเดือนตุลาคม 2026
นอกจากนี้ ข้อมูลจากบริษัทด้านความปลอดภัยอิสระยังระบุว่า 1 ใน 6 ของบั๊กที่ Mythos 5.2 ค้นหาพบและได้รับการยืนยันแล้วนั้น เป็นบั๊กที่โมเดลระดับแนวหน้า (frontier models) รายอื่นๆ ไม่สามารถตรวจพบได้เลยในการทดสอบครั้งเดียวกัน
การควบคุมความสามารถเพื่อความปลอดภัยของ AI
Anthropic ยืนยันว่าได้จงใจควบคุมไม่ให้โมเดลพัฒนาทักษะที่อาจเร่งการเติบโตของ AI จนเกินควบคุม (RSI) โดย Fable 5.2 และ Mythos 5.2 จะถูกจำกัดประสิทธิภาพในด้านการออกแบบชิปประมวลผลและการปรับปรุงโครงสร้างโมเดลภาษาให้มีความสามารถเทียบเท่าเพียงระดับ Opus 5.5 เท่านั้น เพื่อลดความเสี่ยงที่ AI จะเร่งพัฒนาตนเอง
อย่างไรก็ตาม ความสามารถในการสนับสนุนงานวิจัยทั่วไปไม่ได้รับผลกระทบ ปัจจุบัน Claude ได้เขียนโค้ดสำหรับการเปลี่ยนแปลงในระบบของ Anthropic ไปแล้วกว่า 90% ภายใต้การดูแลของมนุษย์ และโมเดลรุ่นนี้ยังสามารถพิสูจน์ความสามารถด้วยการเขียนระบบปฏิบัติการใหม่ทั้งหมดขึ้นมาได้ในการทดสอบภายใน
Fable 5.2 พิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาสำเร็จใน 30 ชั่วโมง
ความสำเร็จที่น่าทึ่งที่สุดคือการพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มา (Fermat's Last Theorem) ให้อยู่ในรูปแบบทางคณิตศาสตร์ที่คอมพิวเตอร์ตรวจสอบได้ (formalization) โดยใช้เอเจนต์ Fable 5.2 จำนวน 1,000 ราย ซึ่งใช้เวลาเพียง 30 ชั่วโมงในการแปลการพิสูจน์ที่ซับซ้อนนี้เข้าสู่ภาษา Lean
การพิสูจน์นี้มีความสำคัญทางประวัติศาสตร์อย่างมาก เนื่องจากไม่มีใครสามารถไขปริศนาของสมการ a² + b² = c² สำหรับเลขยกกำลังสูงกว่าสองได้มานานหลายศตวรรษ จนกระทั่ง Andrew Wiles ทำสำเร็จในปี 1995 และนี่คือครั้งแรกที่การตรวจสอบด้วยเครื่องจักรเสร็จสมบูรณ์
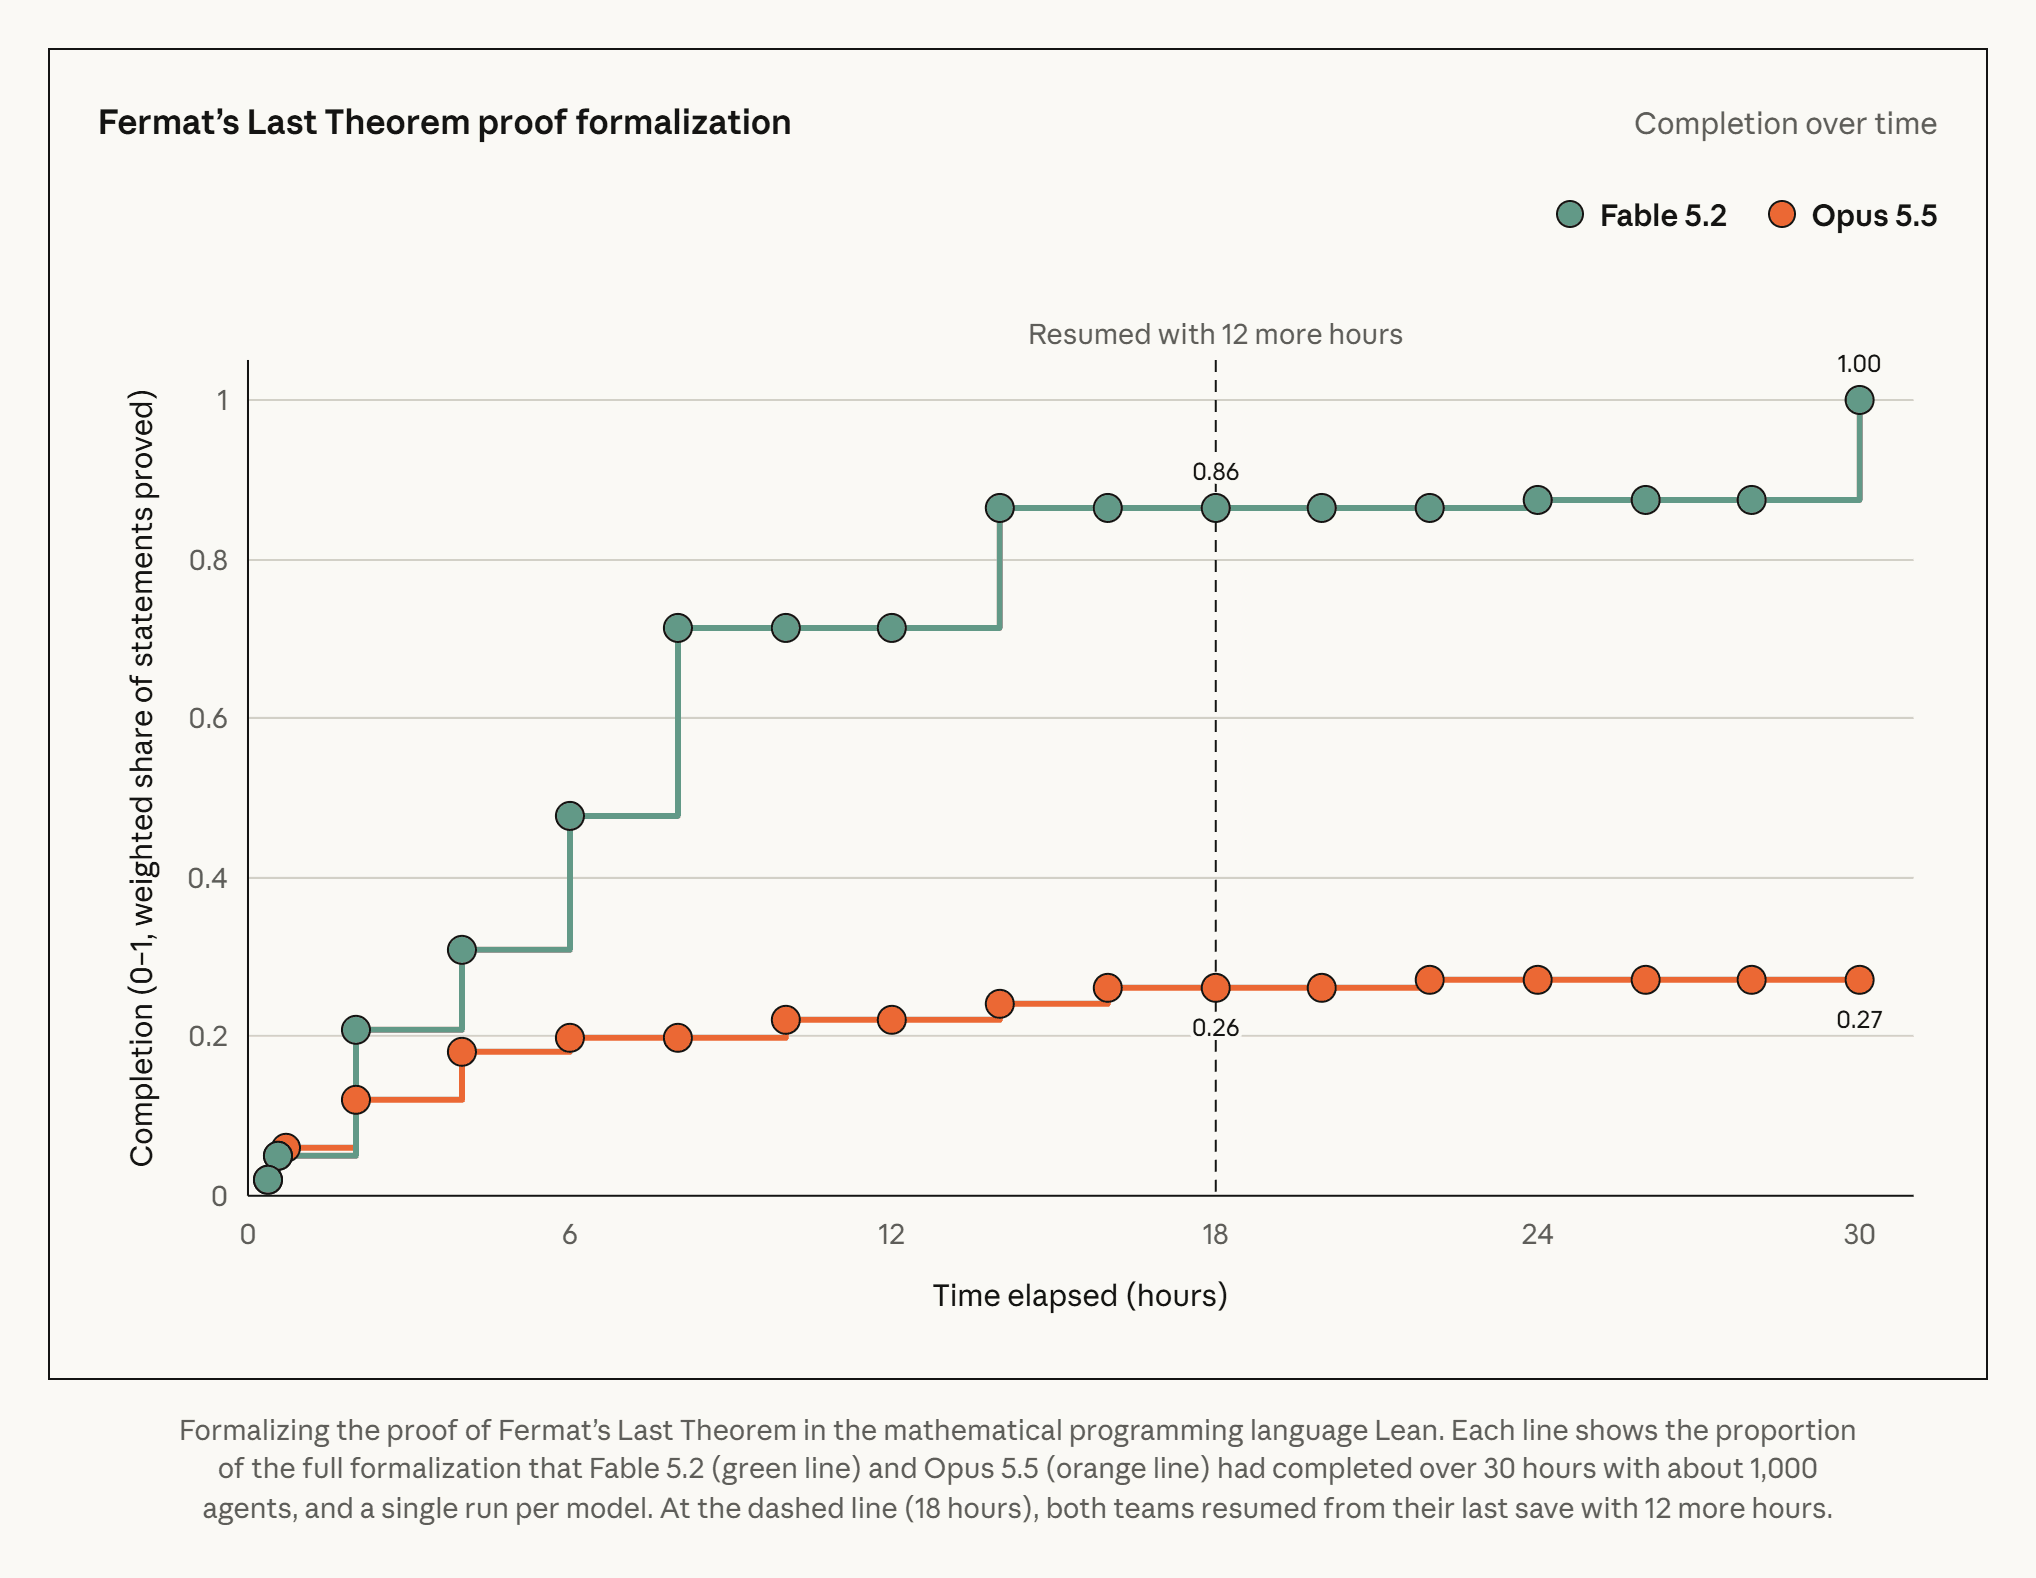
เมื่อเทียบกับรุ่นทดสอบก่อนหน้าที่ใช้เวลาถึง 11 วันและต้องได้รับความช่วยเหลือจากมนุษย์ Fable 5.2 สามารถทำงานร่วมกันและวางแผนได้เองโดยไม่มีการอ้างอิงตำราคณิตศาสตร์ภายนอก ในขณะที่รุ่น Opus 5.5 สามารถทำการพิสูจน์ได้เพียง 26% เท่านั้นในเวลาที่เท่ากัน แสดงให้เห็นถึงก้าวกระโดดที่สำคัญของ Anthropic ในด้านการคิดเชิงตรรกะขั้นสูง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร