
NVIDIA Nemotron 3 Diarization แยกเสียงผู้พูดเรียลไทม์คว้าอันดับ 1
เปลี่ยนบทสนทนาที่พูดทับซ้อนกันให้เป็นข้อมูลที่แยกแยะผู้พูดได้ด้วยโมเดลเดียว
NVIDIA Nemotron 3 Diarization คือโมเดลแบบ open-weight ขนาด 100 ล้านพารามิเตอร์ที่ครองอันดับ #1 ในผลการทดสอบ Diarization-Bench เริ่มต้นของ Voice Arena โดยความสามารถหลักคือการเปลี่ยนบทสนทนาที่มีคนพูดแทรกหรือทับซ้อนกัน ให้กลายเป็นข้อมูลที่ระบุตัวผู้พูดได้อย่างแม่นยำ
ทำไมการแยกแยะเสียงผู้พูด (Speaker Diarization) ถึงสำคัญ
ในทุกการสนทนาจะมีข้อมูลสำคัญสองส่วนคือ "สิ่งที่พูด" และ "ใครเป็นคนพูด" แม้ระบบ Speech Recognition จะถอดความคำพูดได้ถูกต้อง แต่หากขาดการทำ Speaker Diarization เพื่อระบุว่าใครพูดเมื่อไหร่ ข้อมูลนั้นจะนำไปวิเคราะห์ต่อได้ยาก เช่น ในบทถอดความการประชุมหรือการโทรของลูกค้า หากไม่รู้ว่าใครเป็นคนให้สัญญาหรือใครเป็นฝ่ายคัดค้าน ประโยชน์ของข้อมูลก็จะลดลงทันที
NVIDIA Nemotron 3 Diarization เข้ามาแก้ปัญหานี้ด้วยการระบุช่วงเวลาที่ผู้พูดแต่ละคนกำลังพูด รวมถึงช่วงที่พูดทับซ้อนกัน โดยทำอัตราความผิดพลาด (DER) ได้ต่ำเพียง 14.72% รองรับผู้พูดสูงสุด 8 คน พร้อมรองรับทั้งการสนทนาสดและการบันทึกเสียงที่มีความยาวหลากหลาย
โมเดลรุ่นนี้พัฒนาต่อยอดจาก NVIDIA Streaming Sortformer โดยขยายขีดความสามารถจากเดิมที่รองรับเพียง 4 คน เพิ่มเป็น 8 คน พร้อมปรับปรุงทั้งความแม่นยำและประสิทธิภาพ (Throughput) ให้สูงขึ้นอย่างเห็นได้ชัด
Nemotron 3 Diarization ทำงานอย่างไร
โมเดลเดียวสำหรับทั้งการสนทนาแบบออฟไลน์และสตรีมมิ่ง
ระบบต้องแก้โจทย์หินสองข้อ: หนึ่งคือการตรวจจับและระบุผู้พูดให้ถูกต้อง และสองคือการรักษาตัวตนนั้นไว้ตลอดการสนทนา แม้จะมีช่วงเงียบหรือการถูกพูดขัดจังหวะก็ตาม โดยเฉพาะในการสตรีมมิ่งที่โมเดลจะได้รับข้อมูลเป็นส่วนย่อยๆ (Chunks) ทำให้การรักษาความต่อเนื่องของผู้พูดทำได้ยากขึ้น
Nemotron 3 Diarization ใช้แนวทาง Sortformer ในการจัดลำดับผู้พูดตามเวลาที่ปรากฏตัวครั้งแรก ทำให้ป้ายกำกับผู้พูดมีความเสถียร ลดความจำเป็นในการคำนวณลำดับใหม่ในทุกส่วนข้อมูล นอกจากนี้ยังได้รับการฝึกฝนด้วยข้อมูลภาษาอังกฤษและภาษาอื่นๆ รวม 21 ภาษา ช่วยให้ทำงานในสถานการณ์จริงได้แม่นยำยิ่งขึ้น
โมเดลจะให้ป้ายกำกับแบบไม่ระบุตัวตน (เช่น speaker_1, speaker_2) ซึ่งแอปพลิเคชันสามารถนำไปจับคู่กับชื่อจริงของผู้เข้าร่วมประชุมผ่านข้อมูลเมตาหรือโปรไฟล์ผู้ใช้ในภายหลังได้
จากเสียงสู่กิจกรรมของผู้พูด
Architecture flow for Nemotron 3 Diarization

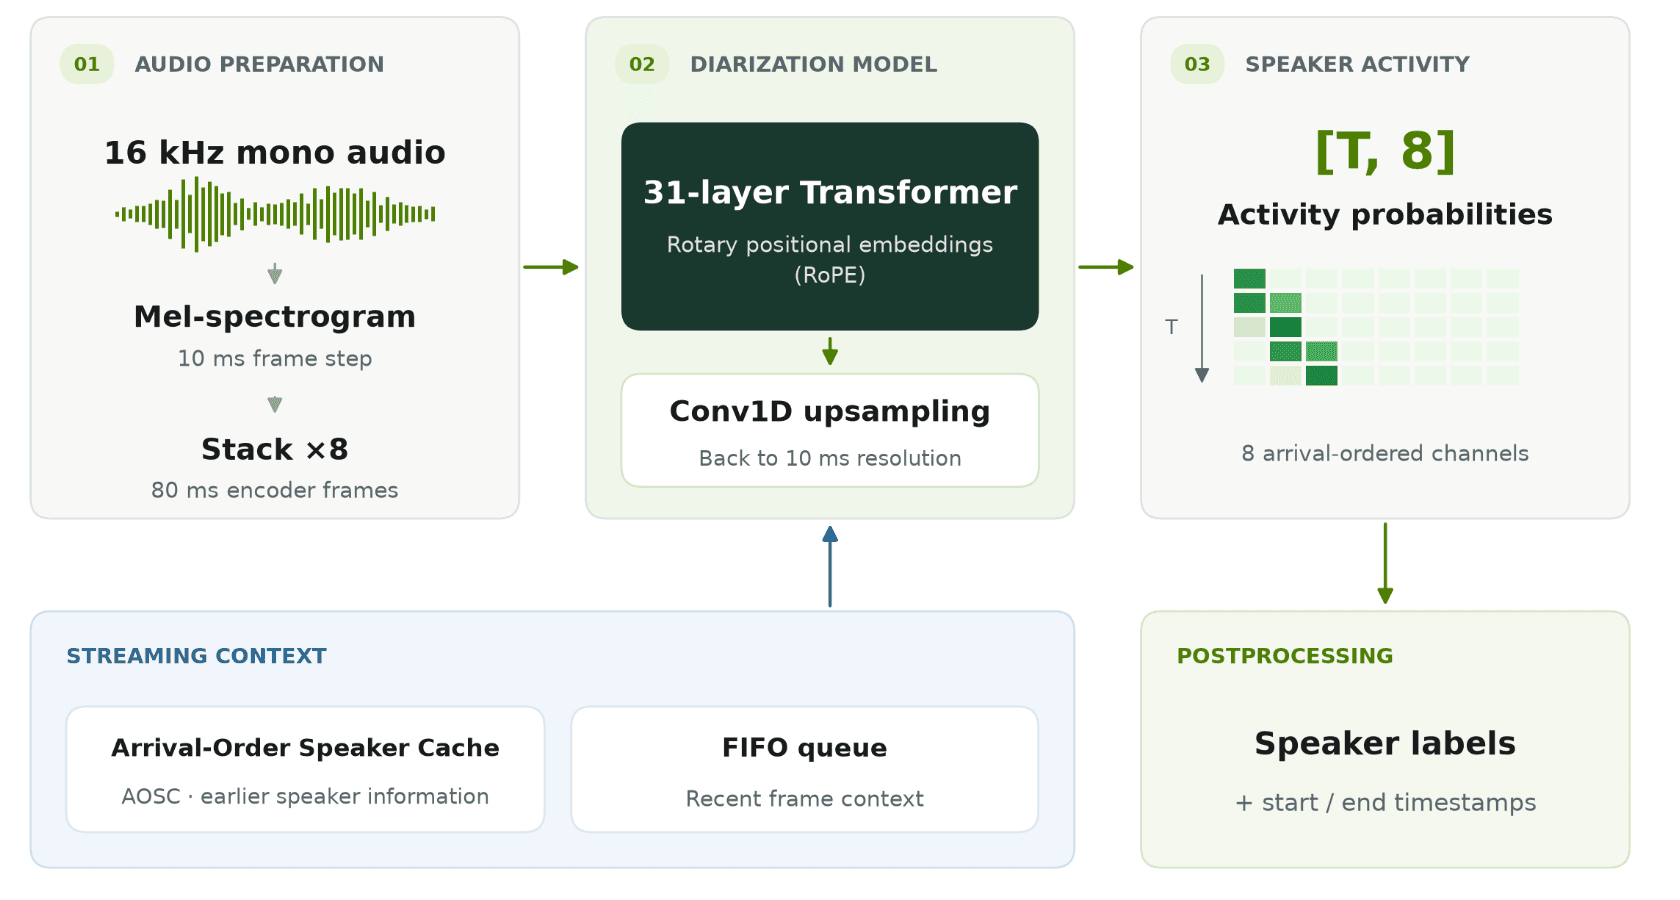
โมเดลรับสัญญาณเสียงแบบ mono 16 kHz แล้วแปลงเป็น Mel-spectrogram ก่อนจะส่งเข้าสู่ Transformer encoder จำนวน 31 เลเยอร์ เพื่อทำนายความน่าจะเป็นที่ผู้พูดแต่ละคนจะกำลังพูดอยู่ในทุกๆ 10 ms
รูปที่ 1. Nemotron 3 Diarization แปลงเสียงให้เป็นความน่าจะเป็นของกิจกรรมผู้พูดที่เรียงตามลำดับการมาถึง โดยมี AOSC และ FIFO context รองรับการอนุมานแบบสตรีมมิ่ง
จุดเด่นคือการจัดการเสียงทับซ้อนได้อย่างเป็นธรรมชาติ หากมีสองคนพูดพร้อมกัน ระบบจะแสดงผลว่ามีสองช่องสัญญาณทำงานในเฟรมเดียวกัน และมีหน่วยความจำ AOSC (Arrival-Order Speaker Cache) ร่วมกับ FIFO คอยเก็บบริบทของผู้พูดจากส่วนข้อมูลก่อนหน้า ทำให้โมเดลทำงานได้อย่างยืดหยุ่นในระดับความหน่วงที่ต้องการ
Diarization และ Multi-speaker ASR ต่างกันอย่างไร
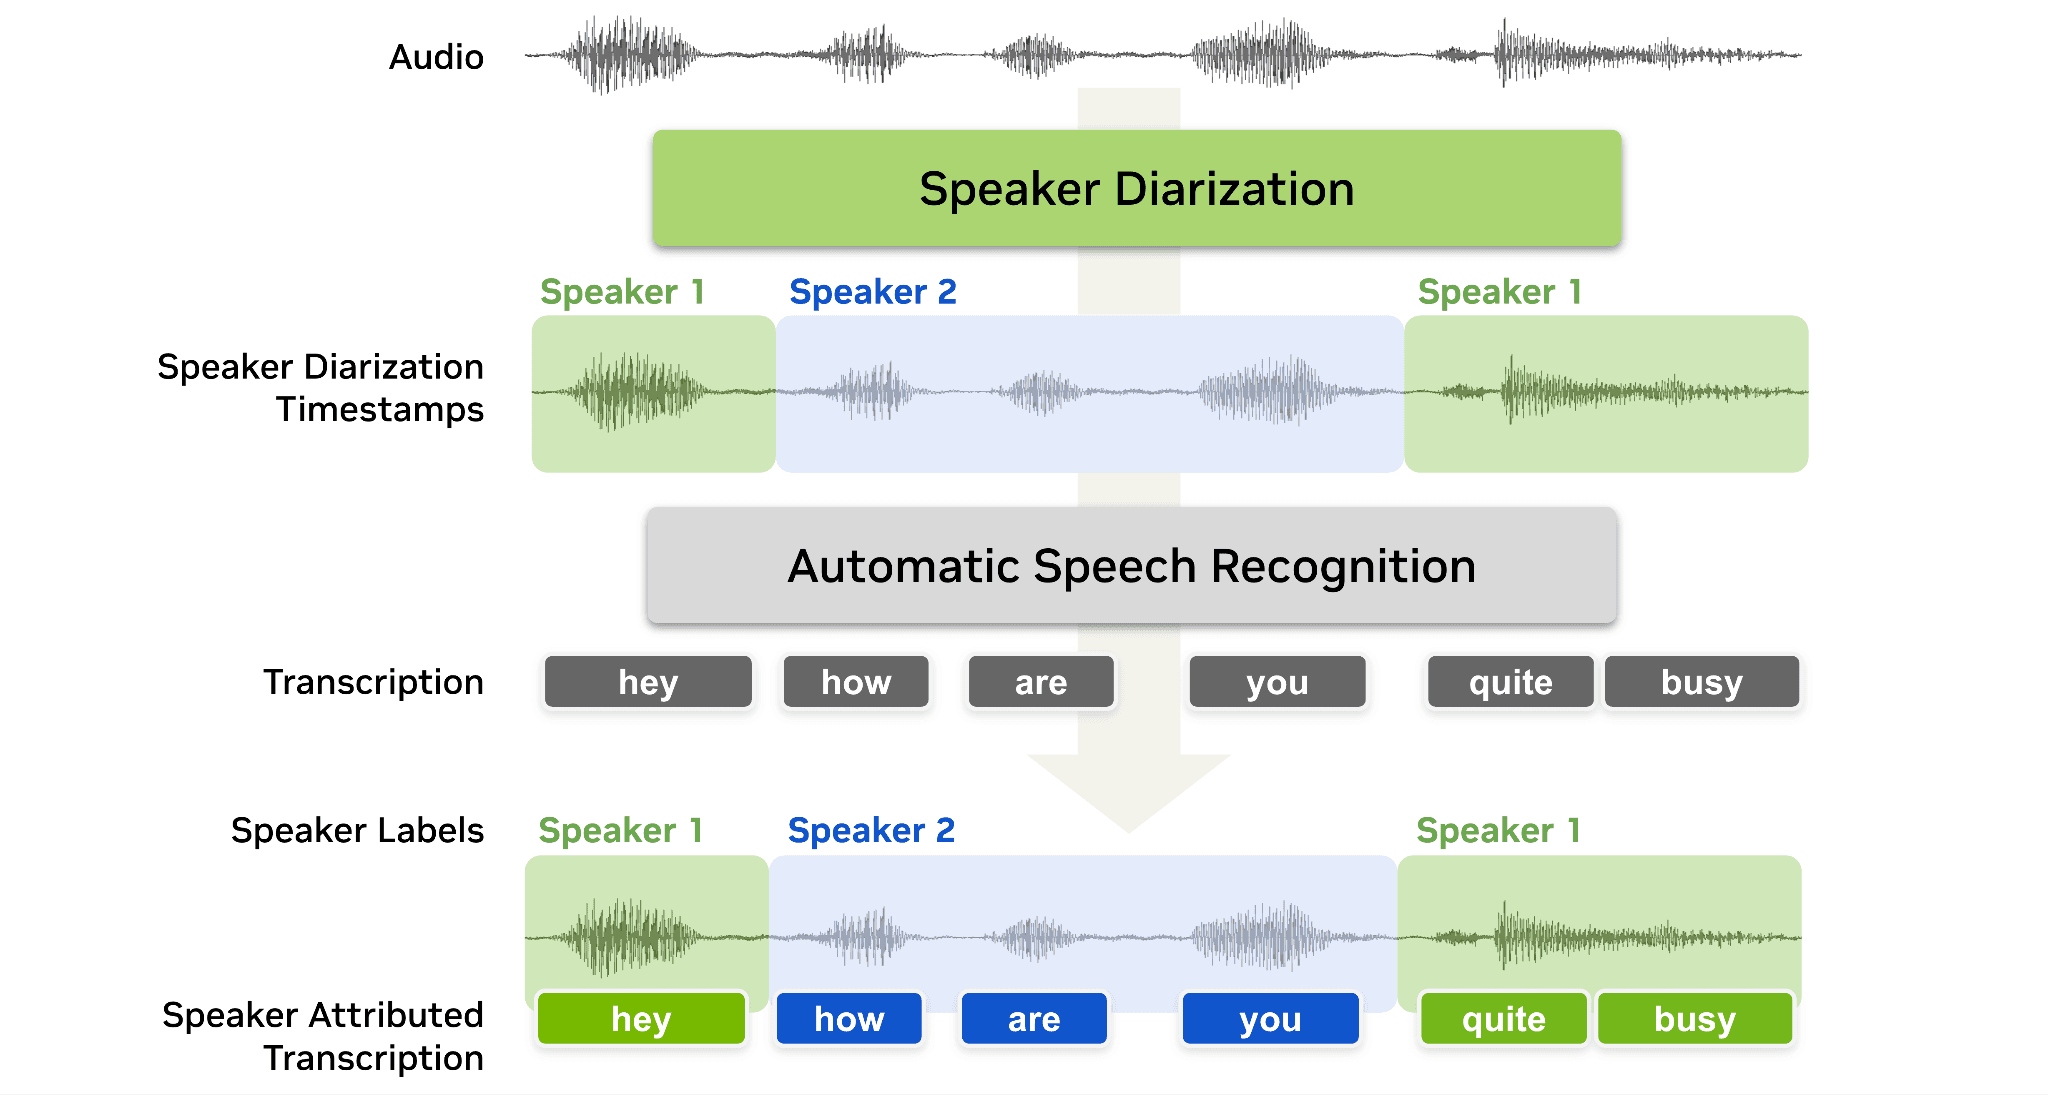
Diarization เน้นการระบุเวลาและกิจกรรมของผู้พูด ในขณะที่ ASR เน้นการถอดความคำพูด การสร้างระบบถอดความที่สมบูรณ์จึงต้องนำทั้งสองส่วนมารวมกันเป็นไปป์ไลน์เดียว เพื่อให้ได้บทสนทนาที่มีทั้งข้อความที่ถูกต้องและระบุตัวผู้พูดที่ชัดเจน
รูปที่ 2. ไปป์ไลน์การถอดความที่ระบุตัวผู้พูดได้แบบ end-to-end ซึ่งรวมการระบุเวลาจาก audio diarization เข้ากับการจดจำเสียงพูดอัตโนมัติ (ASR) เพื่อจับคู่คำพูดกับผู้พูดเฉพาะเจาะจง
รักษาสมดุลความหน่วงและความแม่นยำ
โมเดลนี้รองรับความหน่วงของบัฟเฟอร์ขาเข้าได้หลายระดับ ตั้งแต่ 30.4 วินาทีสำหรับการประมวลผลคุณภาพสูง ไปจนถึง 0.32 วินาทีสำหรับการสตรีมที่ต้องการการตอบสนองรวดเร็ว ยิ่งบัฟเฟอร์ยาว ความแม่นยำก็จะยิ่งสูงขึ้นตามข้อมูลบริบทที่มีมากขึ้น
ผลการทดสอบ Benchmark: อันดับ #1 ใน Voice Arena
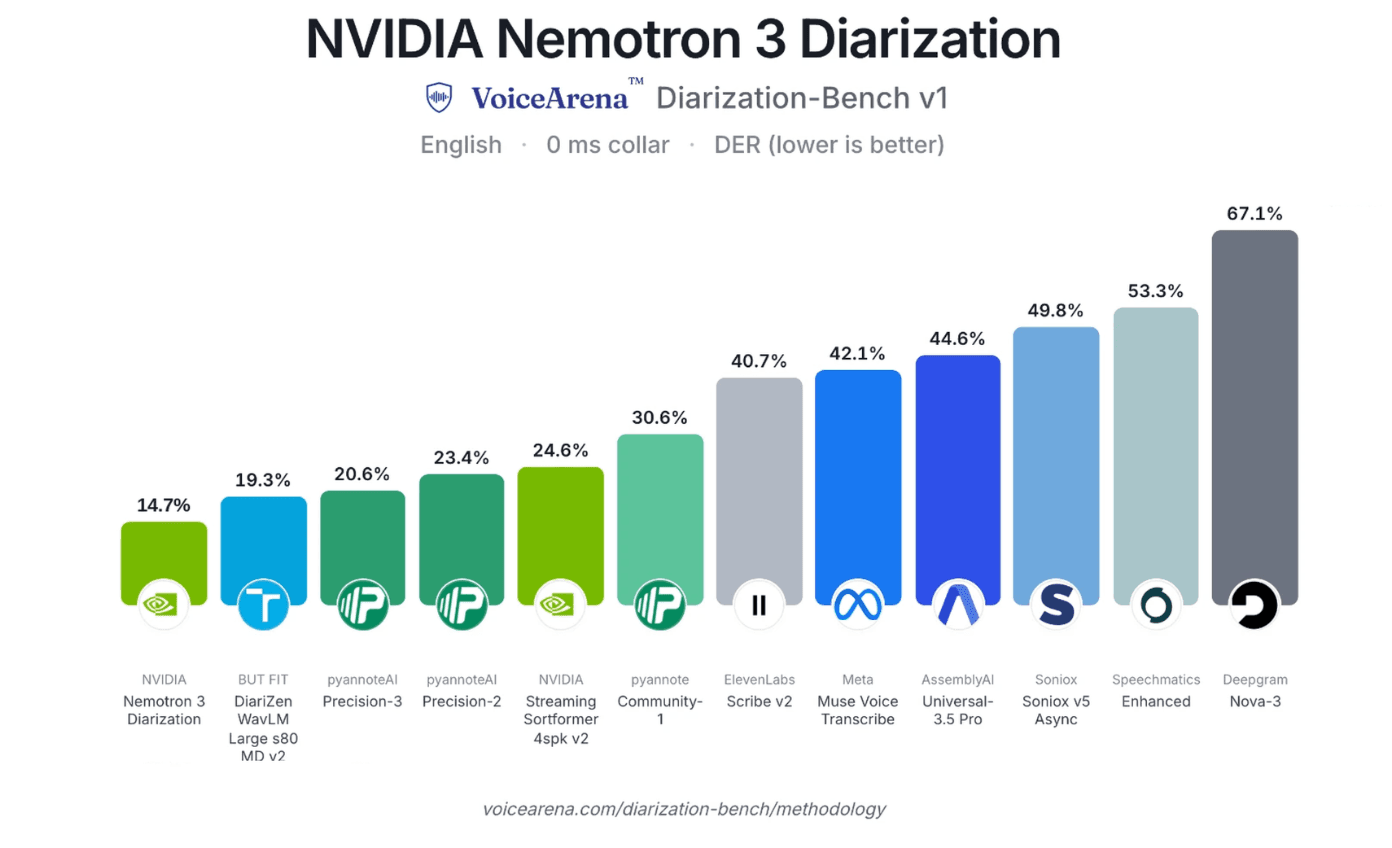
ในการทดสอบ Diarization-Bench ของ Voice Arena พบว่า Nemotron 3 Diarization ทำคะแนนได้เป็นอันดับหนึ่งจาก 17 รูปแบบระบบ โดยทำค่า DER ได้ที่ 14.72% ซึ่งดีกว่าอันดับถัดไปถึง 24% และยังครองตำแหน่งผู้นำไม่ว่าจะวัดผลในรูปแบบออนไลน์หรือการบันทึกเสียงแบบตัวต่อตัว
รูปที่ 3. ผลลัพธ์ Voice Arena Diarization-Bench v1 แสดงให้เห็นว่า NVIDIA Nemotron 3 Diarization ครองอันดับ #1 ด้วย DER 14.72%
รูปที่ 4. ประสิทธิภาพ DER ในการทดสอบสาธารณะแสดงผลลัพธ์ระดับแนวหน้าเมื่อเทียบกับรุ่นก่อนหน้า
การวัดความแม่นยำและประสิทธิภาพ
ตัวชี้วัดหลักคือ DER (Diarization Error Rate) ซึ่งรวมความผิดพลาดจากเสียงที่หายไป (Missed speech), การเตือนผิดพลาด (False alarm) และความสับสนของผู้พูด (Speaker confusion)
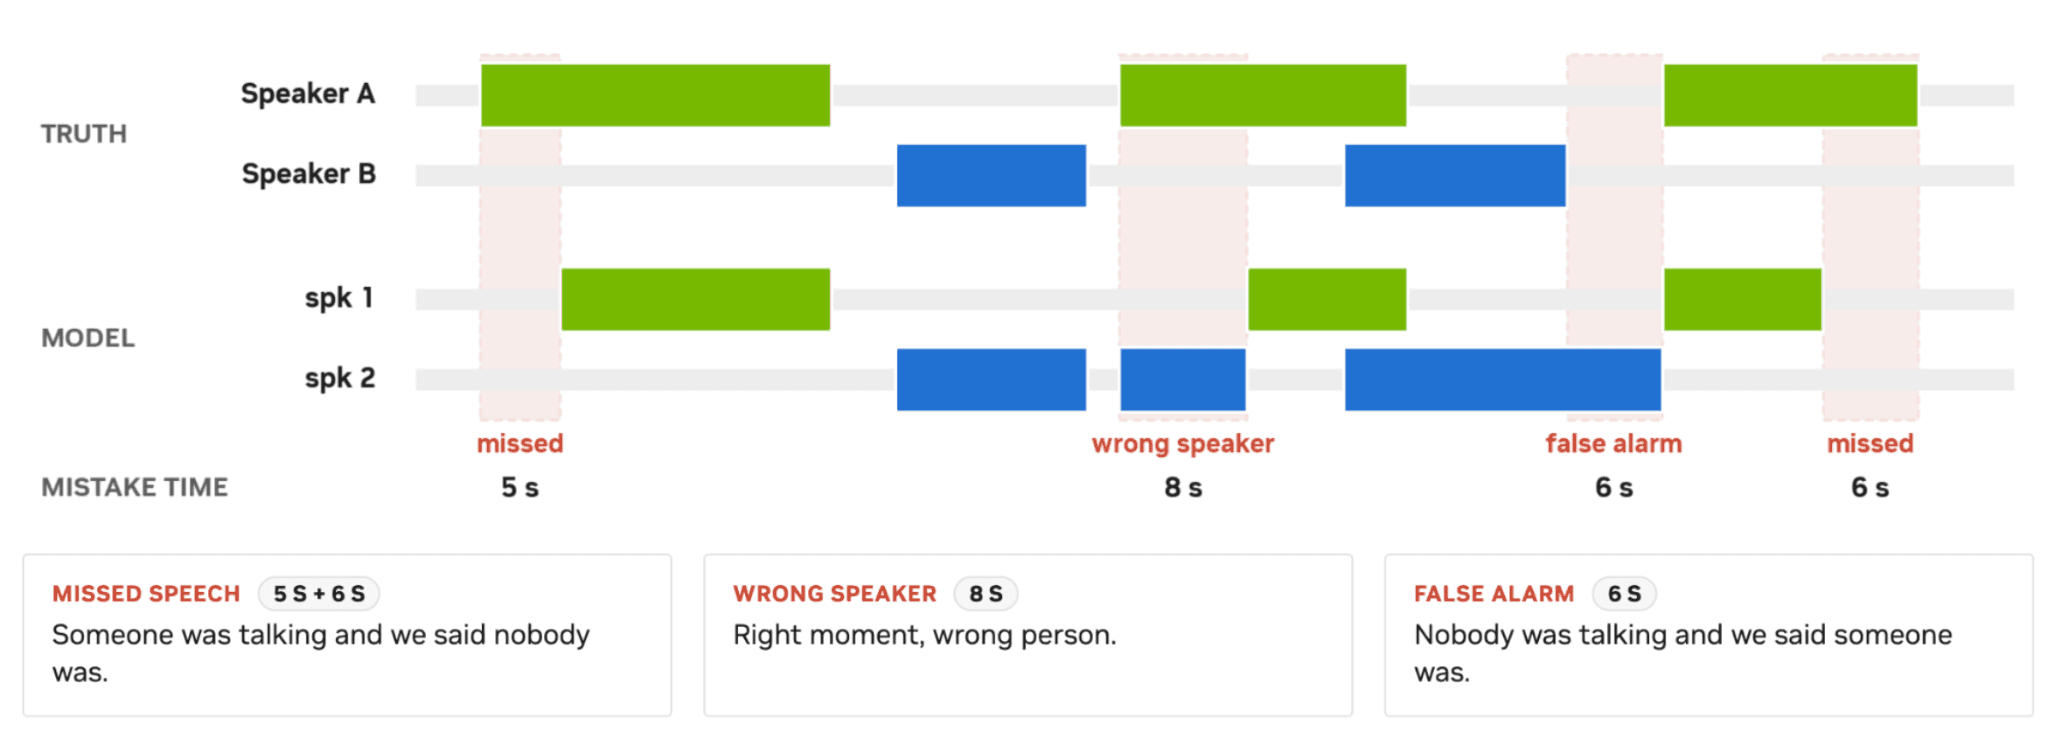
รูปที่ 5. องค์ประกอบของ DER ที่นำมาคำนวณร่วมกับเวลาของผู้พูดอ้างอิง
ในการประเมินผ่านชุดข้อมูลที่ยากลำบาก เช่น DIHARD III และ NOTSOFAR1 พบว่า Nemotron 3 ช่วยลด DER ลงได้เฉลี่ยถึง 41.0% เมื่อเทียบกับเกณฑ์มาตรฐานเดิม โดยเฉพาะในสถานการณ์ที่มีผู้พูดจำนวนมาก
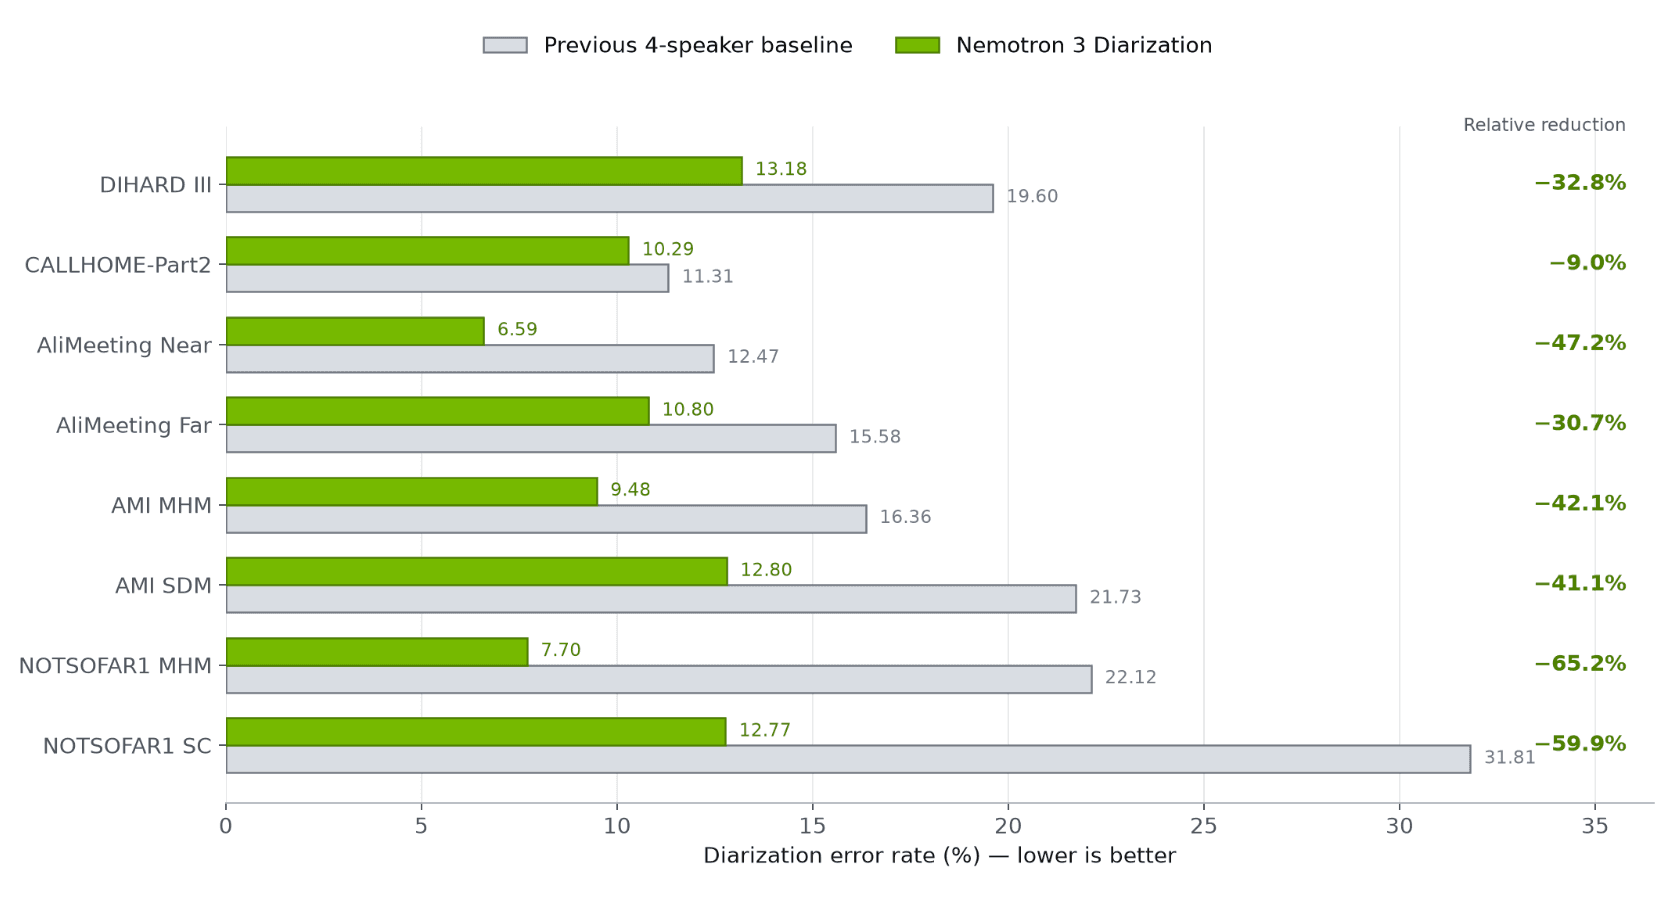
รูปที่ 6. เปรียบเทียบ DER ของโมเดลล่าสุดและรุ่นก่อนหน้า ยิ่งน้อยยิ่งดี
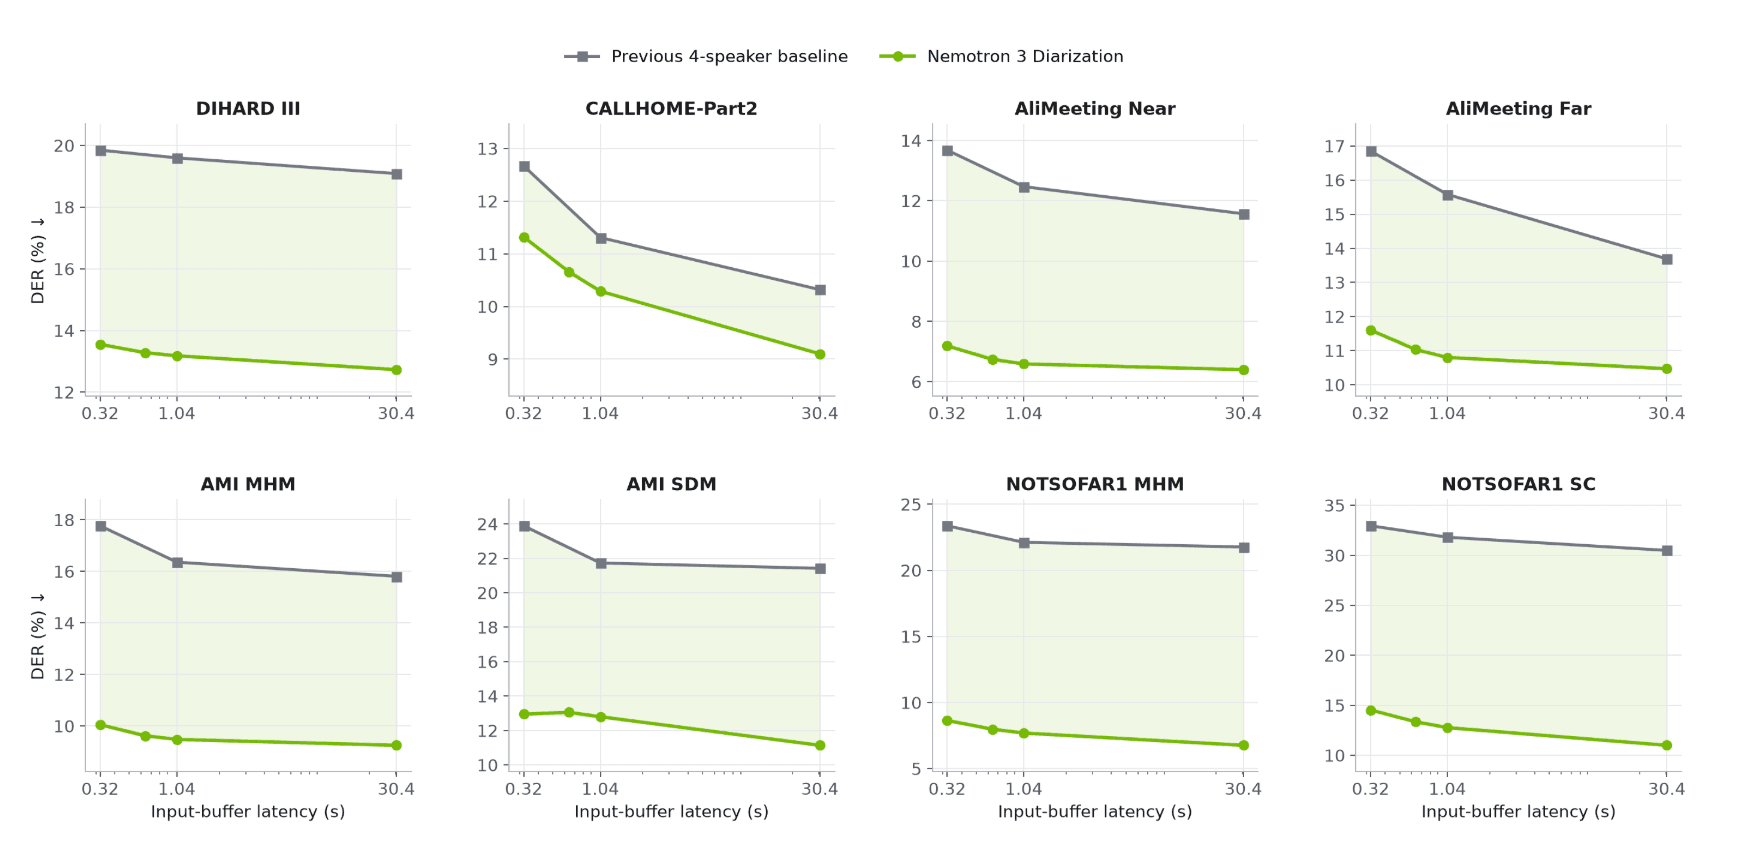
รูปที่ 7. ค่า DER ในระดับความหน่วงต่างๆ
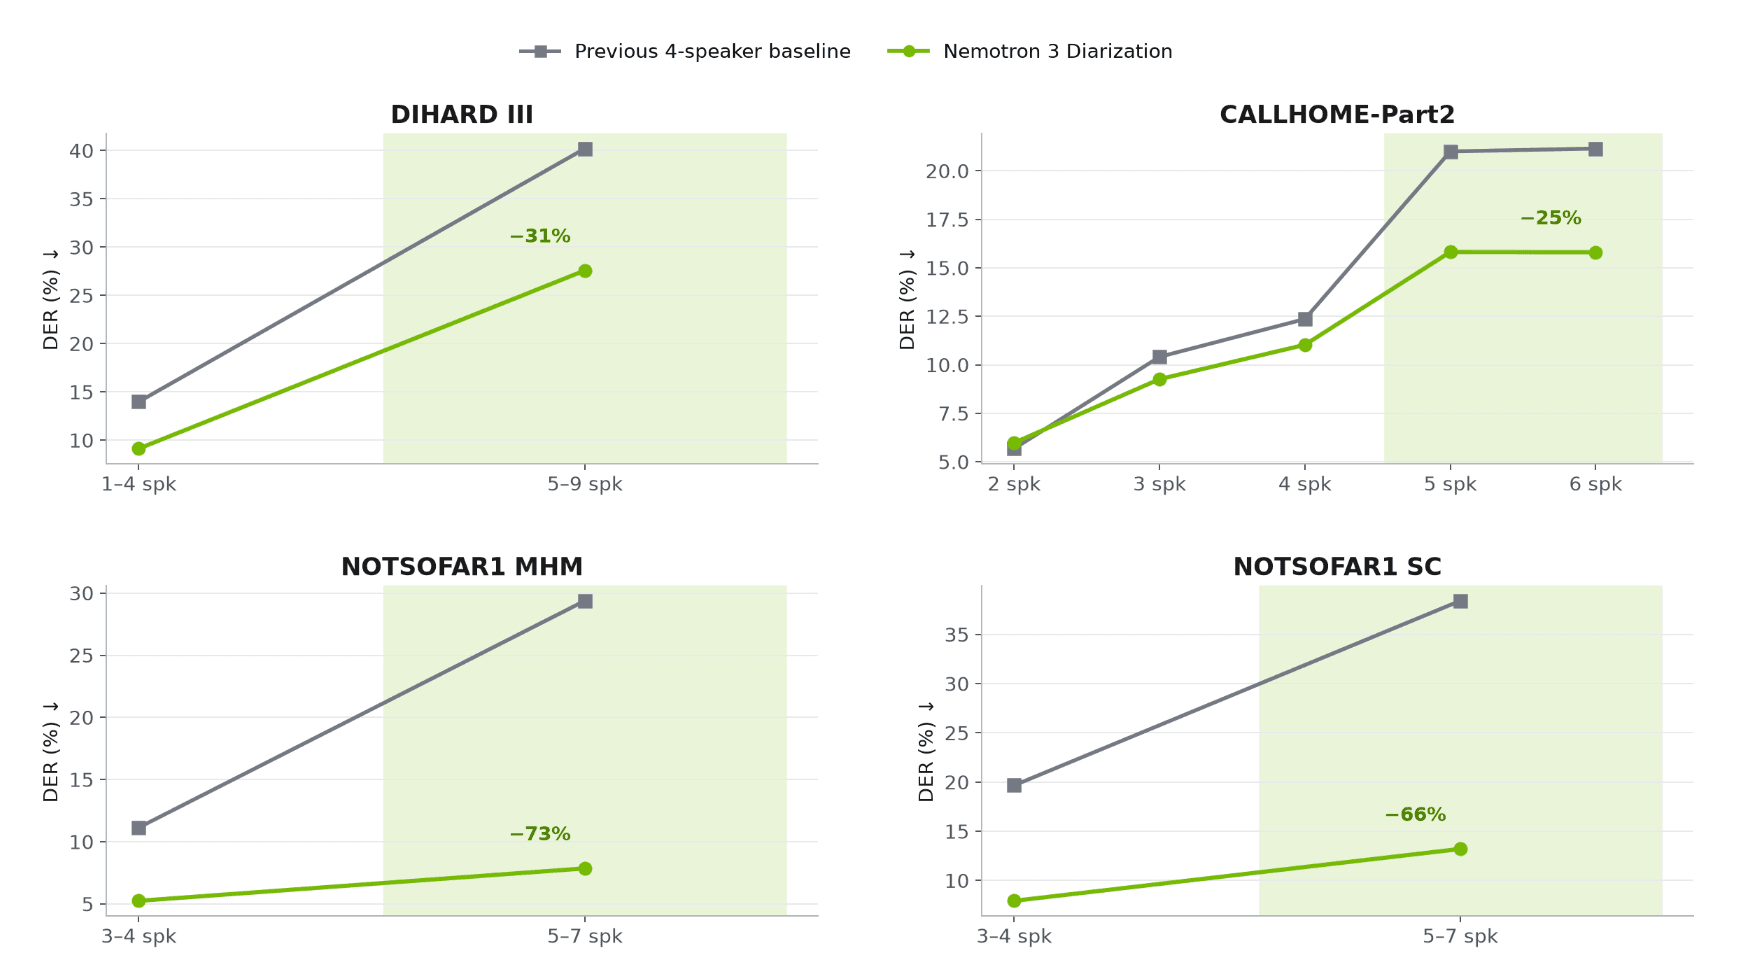
รูปที่ 8. ประสิทธิภาพในกลุ่มผู้พูดจำนวนมาก
ด้านความเร็วในการประมวลผล (Throughput) Nemotron 3 ทำความเร็วได้ถึง 15,113× RTFx บน NVIDIA RTX PRO 5000 ซึ่งเร็วกว่ารุ่นเดิมหลายเท่าตัว ช่วยให้นำไปประยุกต์ใช้งานจริงได้มีประสิทธิภาพสูงขึ้น
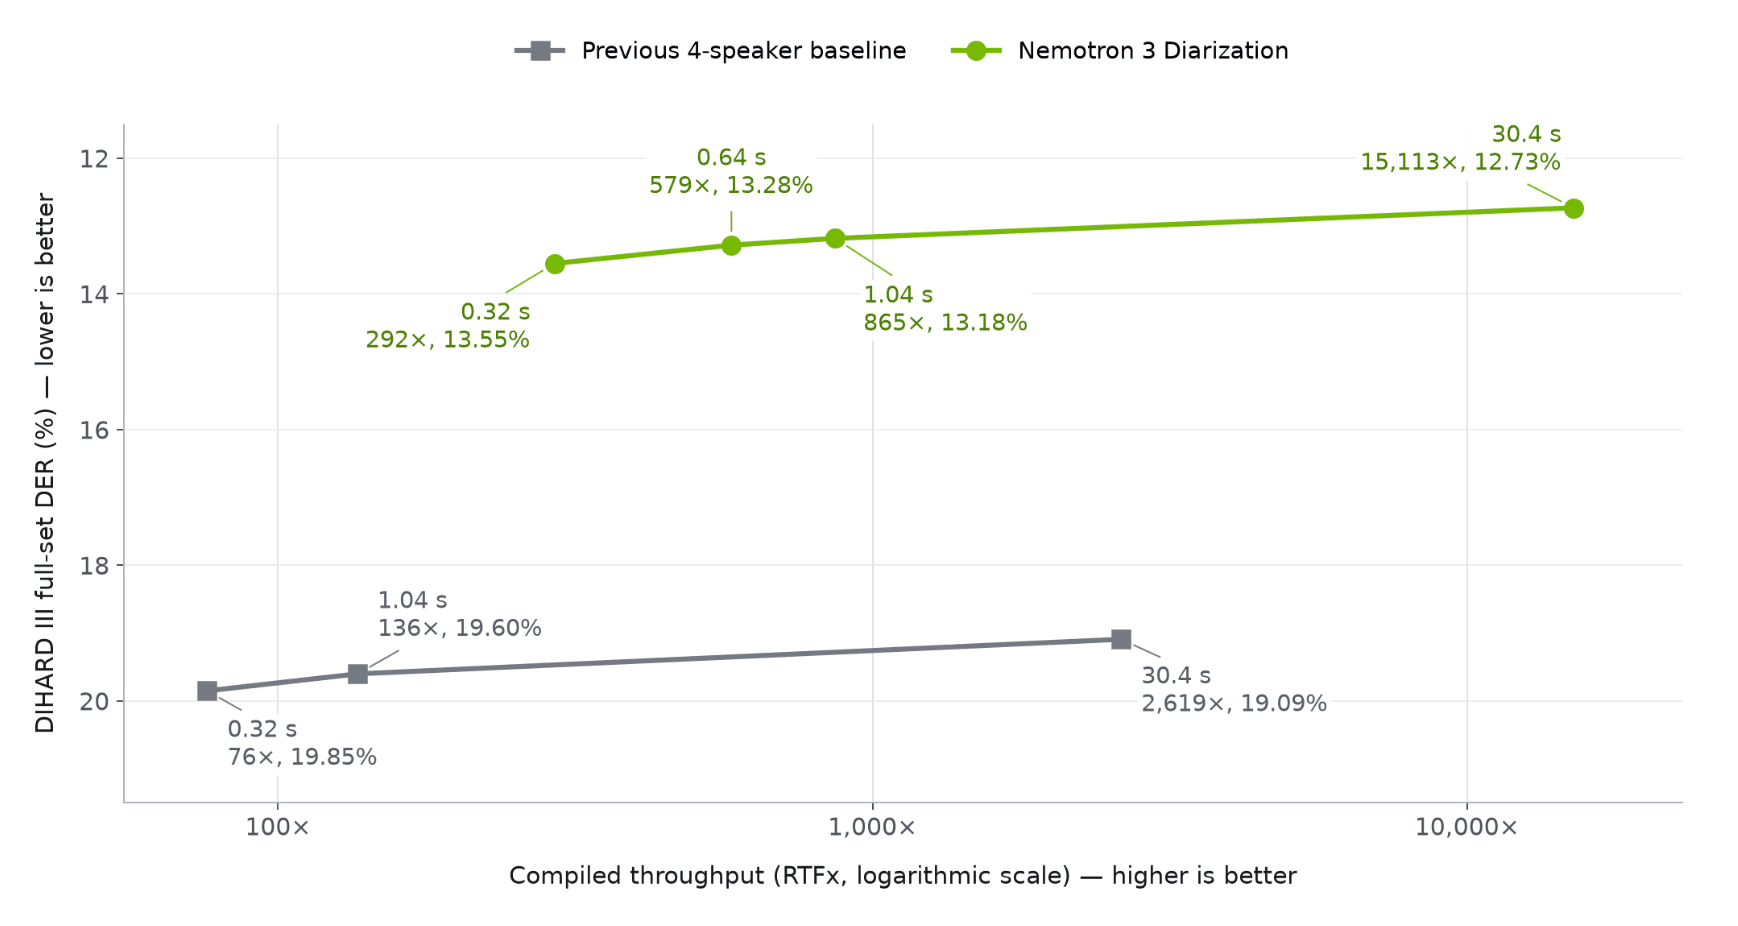
รูปที่ 9. กราฟเปรียบเทียบความแม่นยำกับประสิทธิภาพความเร็วในการประมวลผล
ดูการทำงานของจริง
ผู้ที่สนใจสามารถทดลองใช้ Nemotron Diarization live model demo ซึ่งรองรับทั้งการจำลองบทสนทนา การพูดผ่านไมโครโฟนสด และการอัปโหลดไฟล์เสียง
ตัวอย่างการนำไปใช้: ป้ายกำกับผู้พูดช่วยให้การสรุปการประชุมแม่นยำขึ้น โดยระบุได้ว่าใครเป็นคนพูดคำไหน หรือใครมีรายการสิ่งที่ต้องทำบ้าง ต่างจากบทถอดความทั่วไปที่อาจรวมทุกคำพูดไว้ด้วยกันจนแยกไม่ออก
| แบบไม่มีการระบุผู้พูด | แบบมีการระบุผู้พูด |
|---|---|
| "ฉันจะส่งรายงานให้" "ช่วยรวมตัวเลขไปด้วยได้ไหม?" "ได้ ภายในวันศุกร์นี้" | speaker_0: "ฉันจะส่งรายงานให้" speaker_1: "ช่วยรวมตัวเลขไปด้วยได้ไหม?" speaker_0: "ได้ ภายในวันศุกร์นี้" |
การใช้งานบนอุปกรณ์พกพา
Argmax ได้นำ Nemotron 3 Diarization ไปใช้ใน Argmax Pro SDK 3 เพื่อรองรับการแยกแยะผู้พูดแบบเรียลไทม์บนอุปกรณ์โดยตรง เหมาะสำหรับการถอดความในการสนทนาที่ซับซ้อน
เริ่มต้นใช้งานกับ NVIDIA NeMo Speech
การติดตั้ง
หลังจากตั้งค่า Python 3.12 และ PyTorch แล้ว สามารถติดตั้ง dependencies ได้ดังนี้:
apt-get update && apt-get install -y libsndfile1 ffmpeg
uv pip install Cython packaging
uv pip install 'nemo-toolkit[asr]'
ตัวอย่างการรัน Offline Diarization
คุณสามารถใช้โค้ด Python เพื่อเริ่มใช้งานโมเดลกับไฟล์เสียง .wav ที่มีความถี่ 16 kHz ได้ทันที:
from nemo.collections.asr.models import SortformerEncLabelModel

diar_model = SortformerEncLabelModel.from_pretrained(
    "nvidia/Nemotron-3-Diarization"
)
diar_model.eval()

# การกำหนดค่าสำหรับ Offline-style
diar_model.sortformer_modules.spkcache_len = 264
diar_model.sortformer_modules.fifo_len = 40
diar_model.sortformer_modules.chunk_len = 340
diar_model.sortformer_modules.chunk_right_context = 40
diar_model.sortformer_modules.spkcache_update_period = 300
diar_model._check_streaming_parameters()

predicted_segments = diar_model.diarize(
    audio=["/path/to/conversation.wav"],
    batch_size=1,
)

for segment in predicted_segments[0]:
    print(segment)
การเลือกจุดทำงาน (Latency vs Quality)
คุณสามารถเลือกปรับพารามิเตอร์ตามความต้องการของระบบได้ดังนี้:
| การกำหนดค่า | ความหน่วงบัฟเฟอร์ | Chunk | บริบทด้านขวา |
|---|---|---|---|
| Offline style | 30.4 s | 340 | 40 |
| Low latency | 1.04 s | 9 | 4 |
| Ultra-low latency | 0.32 s | 3 | 1 |
การรวมเข้ากับ Offline ASR
การรวมผลลัพธ์จาก Diarization เข้ากับโมเดล ASR เช่น Parakeet TDT 0.6B v3 จะช่วยให้ได้บทถอดความที่สมบูรณ์ โดยใช้กฎการตัดสินที่จุดกึ่งกลางคำ (Midpoint rule) เพื่อระบุว่าคำนั้นๆ ถูกพูดโดยใคร
for word in words:
    midpoint = (word["start"] + word["end"]) / 2
    label = speaker_at(midpoint)
    print(f"{word['start']:.2f}-{word['end']:.2f} {label}: {word['word']}")
ข้อควรพิจารณา
โมเดลรองรับผู้พูดสูงสุด 8 คน หากมีมากกว่านั้นอาจเกิดความผิดพลาดได้ รวมถึงสภาพแวดล้อมที่มีเสียงรบกวนหรือเสียงก้องรุนแรงอาจส่งผลต่อความแม่นยำ ผู้ใช้งานควรทดสอบระบบในสภาพแวดล้อมจริงก่อนนำไปใช้งานในเวิร์กโฟลว์สำคัญ โดยการใช้งานอยู่ภายใต้ข้อตกลงใบอนุญาต OpenMDW 1.1
แหล่งข้อมูลเพิ่มเติม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร