
NVIDIA เร่งสปีด MoE บน DGX Spark ดันความเร็ว Ling-3.0 พุ่ง 42.5%
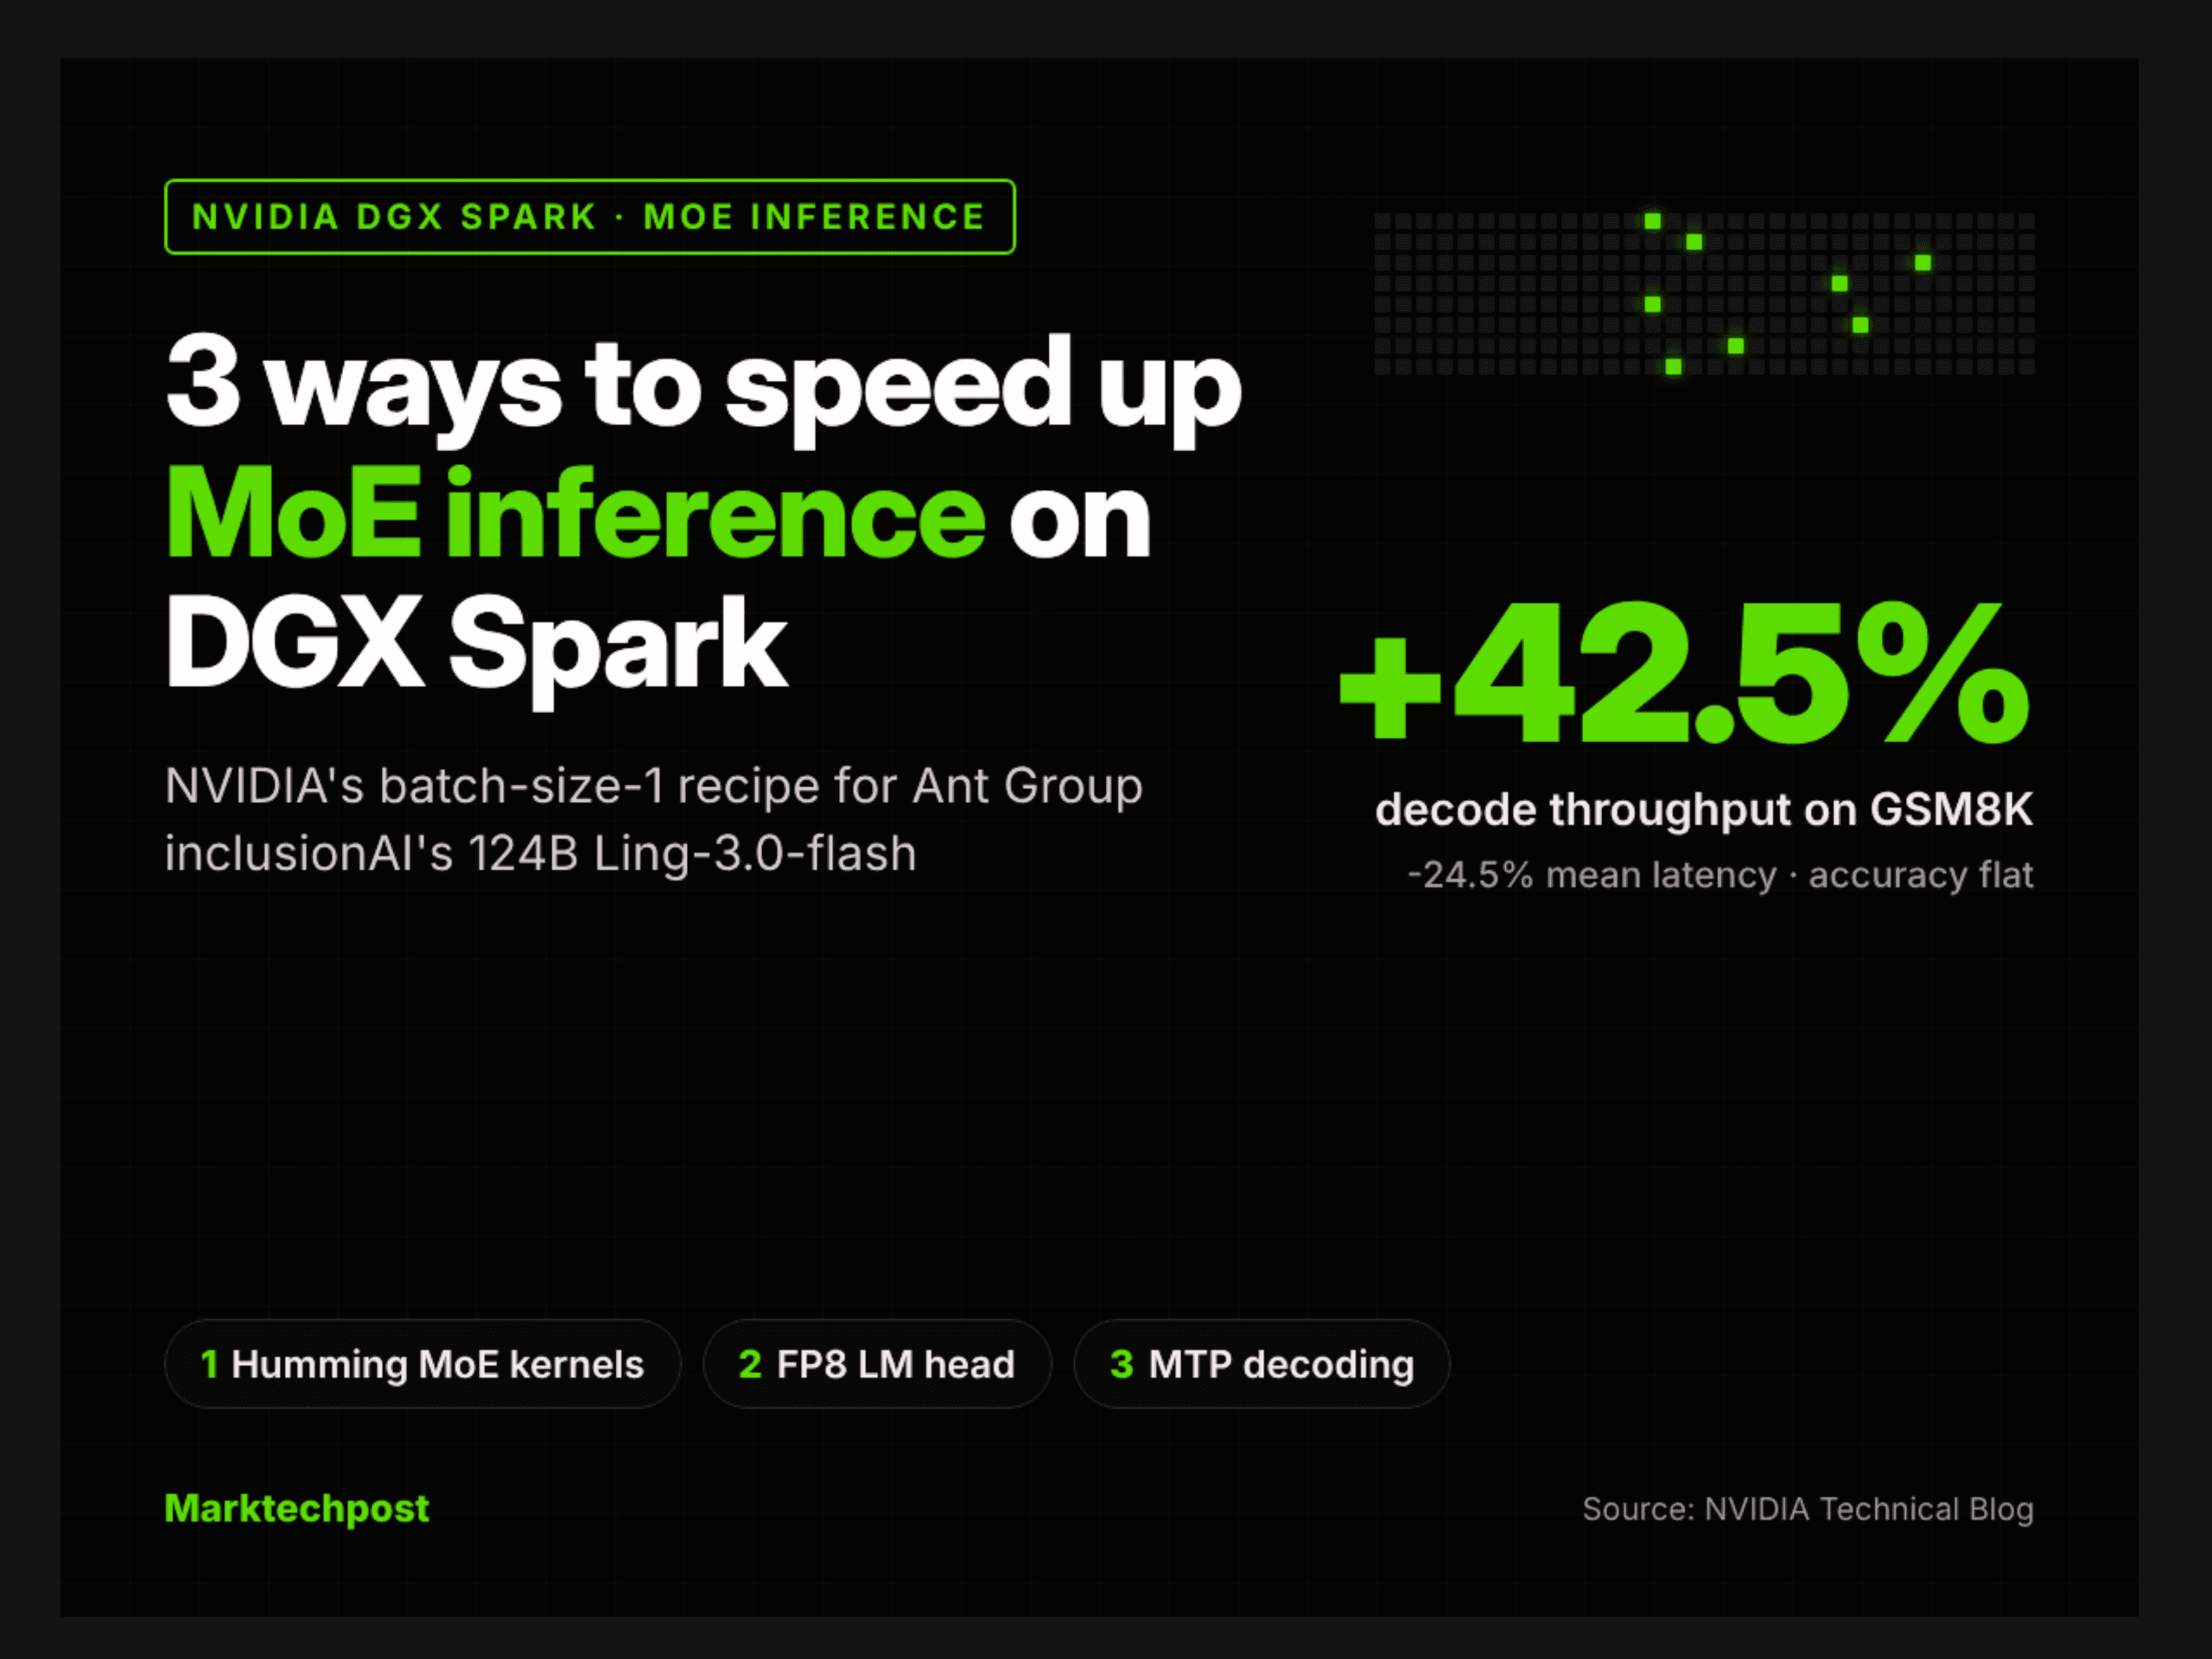
บล็อกทางเทคนิคล่าสุดของ NVIDIA เปิดเผยวิธีการเร่งความเร็วการทำ inference สำหรับโมเดลแบบ mixture-of-experts (MoE) บน DGX Spark เพียงเครื่องเดียว โดยใช้โมเดล Ling-3.0-flash ของ Ant Group inclusionAI เป็นตัวทดสอบ
โมเดล Ling-3.0-flash มีพารามิเตอร์รวม 124B และมีพารามิเตอร์ที่ทำงานจริง (active parameters) อยู่ที่ 5.1B ซึ่งทาง NVIDIA ได้นำ 3 เทคนิคมาปรับใช้ร่วมกัน ได้แก่ การใช้ backend ของ MoE kernel แบบใหม่, การปรับ output layer เป็น FP8 และการใช้ speculative decoding ในตัว ผลลัพธ์จากการทดสอบชุดคำถาม GSM8K พบว่าช่วยเพิ่ม decode throughput ได้ถึง 42.5% โดยที่ความแม่นยำยังคงเดิมในเชิงสถิติ
ความสำคัญของเรื่องนี้สำหรับนักพัฒนาคือ DGX Spark เป็นระบบเดสก์ท็อป ไม่ใช่โหนดในดาต้าเซ็นเตอร์ขนาดใหญ่ ผลการทดสอบนี้พิสูจน์ว่าโมเดล MoE ขนาดใหญ่ระดับ 124B สามารถตอบสนองคำขอของผู้ใช้รายเดียวได้อย่างรวดเร็วบนเครื่องตั้งโต๊ะทั่วไป โดย โพสต์ทางเทคนิค ยังช่วยวิเคราะห์ว่าจุดใดที่เป็นคอขวดของการประมวลผลและจะแก้ไขได้อย่างไร
TL;DR
- ขนาด: Ling-3.0-flash-fp4: รวม 124B, ทำงานจริง 5.1B ต่อ token พร้อม context แบบ native ขนาด 256K
- ฮาร์ดแวร์: ทำงานบน NVIDIA DGX Spark หนึ่งเครื่อง (GB10, หน่วยความจำ unified 128 GB, แบนด์วิดท์ 273 GB/s) ที่ batch size เท่ากับหนึ่ง
- ประสิทธิภาพ: การใช้ 3 เทคนิคร่วมกันช่วยดัน GSM8K decode throughput จาก 37.81 เป็น 53.89 tokens/s
- ผลลัพธ์สูงสุด: Throughput เพิ่มขึ้น 42.5% และลดค่า mean latency ลง 24.5% โดยความแม่นยำคงที่ที่ประมาณ 96.8%
- ข้อจำกัด: แม้ในผลทดสอบสังเคราะห์จะพุ่งสูงถึง +185.1% แต่ในงานจริงอย่าง GSM8K จะลดลงเนื่องจากอัตรา MTP acceptance ลดลงตามความซับซ้อนของเนื้อหา
ทำไมการถอดรหัส MoE บน DGX Spark ถึงติดคอขวดที่หน่วยความจำ?
DGX Spark คือระบบเดสก์ท็อปที่ใช้ชิป GB10 Grace Blackwell Superchip มาพร้อมหน่วยความจำ unified 128 GB และแบนด์วิดท์ 273 GB/s ให้พลังประมวลผลสูงสุด 1 petaFLOP ของ sparse FP4 ซึ่ง NVIDIA ออกแบบมาให้รองรับโมเดลขนาดใหญ่สูงสุดถึง 200B พารามิเตอร์
จากการวิเคราะห์ใน โพสต์ทางเทคนิคของ NVIDIA ทีมงานพบว่าการทำงานของ Ling-3.0-flash-fp4 ที่ batch size 1 นั้นติดปัญหาที่หน่วยความจำ (memory-bound) เป็นหลัก เนื่องจากการอ่านค่าน้ำหนักโมเดลคือปัจจัยหลักที่ใช้เวลาประมวลผล โดยเฉพาะในส่วนการคำนวณ MoE และ LM head การแก้ไขจึงต้องเน้นไปที่การลดการรับส่งข้อมูลในแต่ละขั้นตอน และการสร้าง token ให้ได้มากขึ้นในแต่ละรอบ
สำหรับการทดสอบพื้นฐาน (baseline) ที่ใช้รูปแบบ W4A8 ร่วมกับ FlashInfer MXFP4 MoE kernels และ LM-head แบบ FP32 พบว่าในสภาวะทดสอบแบบสังเคราะห์ (input 32K / output 2K) ตัวเครื่องใช้เวลา 27.71 ms ต่อ token หรือคิดเป็น 36.09 tokens ต่อวินาที
3 เทคนิคการเพิ่มประสิทธิภาพมีอะไรบ้าง?
1. Humming MXFP4 MoE kernels: NVIDIA เปลี่ยนมาใช้ Humming ซึ่งเป็นไลบรารี kernel อิสระแทน FlashInfer โดย Humming ใช้ NVRTC เพื่อคอมไพล์ kernel ตามรูปทรงเมทริกซ์และชนิดข้อมูลจริงขณะรันไทม์ ช่วยลดเวลาคอมไพล์จากระดับหลายสิบนาทีเหลือเพียงไม่กี่วินาที ส่งผลให้ Throughput เพิ่มขึ้น 9.3% เป็น 39.45 tokens ต่อวินาที
2. Online FP8 LM head: เนื่องจาก LM head มีขนาดใหญ่ถึง 157,184 x 2,560 การเก็บในรูปแบบ BF16 ทำให้ต้องอ่านข้อมูลจำนวนมากในทุก token การทำ quantization เฉพาะเลเยอร์นี้เป็น FP8 ช่วยลดการอ่านข้อมูลลงครึ่งหนึ่ง เมื่อเปิดใช้งานผ่าน SGLANG_ENABLE_FP8_LM_HEAD=1 ร่วมกับ Humming จะทำให้ throughput พุ่งขึ้นเป็น 43.94 tokens ต่อวินาที ซึ่งสูงกว่าค่าพื้นฐานเดิมถึง 21.7%
3. MTP speculative decoding พร้อม NEXTN: Ling-3.0-flash มีเลเยอร์ทำนาย NEXTN ในตัว ทำให้ไม่จำเป็นต้องพึ่งพา draft model ภายนอก โดยระบบจะทำการร่าง 3 tokens และตรวจสอบ 4 ตำแหน่งพร้อมกัน แม้จะมีค่าใช้จ่ายในการตรวจสอบเพิ่มขึ้น แต่ผลลัพธ์ในสภาวะสังเคราะห์สามารถทำความเร็วได้ถึง 102.88 tokens ต่อวินาที หรือเพิ่มขึ้น 185.1%
อย่างไรก็ตาม การรวมเทคนิคเหล่านี้ต้องระวัง "กับดักการรวมระบบ" (The integration trap) หากเปิดใช้งาน FP8 LM head และ MTP พร้อมกัน ตัวร่างจะต้องแชร์โมดูล LM-head ตัวเต็มเท่านั้น มิฉะนั้นระบบจะถอยกลับไปทำงานแบบปกติที่ประสิทธิภาพต่ำลง ทีมงานจึงแนะนำให้ตรวจสอบการตั้งค่าผ่าน Ling cookbook notebook เพื่อความถูกต้อง
ประสิทธิภาพในเวิร์กโหลดจริง เพื่อให้เห็นภาพการใช้งานจริง NVIDIA ได้ทดสอบผ่านโจทย์ GSM8K จำนวน 1,319 ข้อ พบว่าเวลาต่อ output token ลดลงจาก 26.45 ms เหลือเพียง 18.56 ms ทำให้ Decode throughput เพิ่มขึ้น 42.5% (จาก 37.81 เป็น 53.89 tokens ต่อวินาที) และค่าเฉลี่ยความหน่วง (Mean latency) ลดลง 24.5% ขณะที่ความแม่นยำแทบไม่มีความเปลี่ยนแปลง (96.89% เทียบกับ 96.82%)
เหตุผลที่ความเร็วในงานจริงน้อยกว่าการทดสอบสังเคราะห์ เนื่องจากคำตอบใน GSM8K มีความซับซ้อนกว่า ทำให้ตัวร่าง (draft) ถูกยอมรับน้อยลง รวมถึงมีการใช้เทคนิค sampling แทน greedy decoding และความยาวของคำตอบที่สั้นกว่าค่าคงที่ที่ใช้ทดสอบเบื้องต้น
ทำความรู้จัก Ling 3.0 และความเหมาะสมกับ DGX Spark
Ling-3.0-flash เป็นหนึ่งในตระกูล Ling 3.0 family ของ Ant Group inclusionAI ภายใต้ลิขสิทธิ์ MIT โดยรุ่นนี้ถูกออกแบบมาเพื่อเน้นความคุ้มค่าของต้นทุนต่อ token ด้วยสถาปัตยกรรม Sparse MoE ที่ใช้งานเพียง 4.1% ของน้ำหนักทั้งหมดต่อหนึ่ง token
โมเดลนี้ยังใช้เทคนิค Hybrid linear attention (KDA และ Gated MLA) เพื่อรักษาขนาดสถานะให้คงที่ แทนการใช้ KV cache ที่ขยายใหญ่ตามเนื้อหา ซึ่งรองรับ context แบบ native ได้ถึง 256K และขยายได้สูงสุดถึง 1M tokens นอกจากนี้ยังโดดเด่นในด้าน Agent โดยมีสภาพแวดล้อมการฝึกแบบโต้ตอบกว่า 10,000 แห่งสำหรับงาน coding และงานวิจัยเชิงลึก
ในด้านคุณภาพ Ling-3.0-flash ทำคะแนนได้ดีในหลาย benchmark เช่น SWE-Bench Pro (56.6) และ MathArena AIME 2026 (93.2) แม้การทำ Quantization เป็นรุ่น FP4 ที่ NVIDIA ใช้ทดสอบจะทำให้คะแนนบางส่วนลดลงบ้าง แต่ก็ยังรักษามาตรฐานการทำงานไว้ได้สูงเมื่อเทียบกับโมเดลในระดับเดียวกันอย่าง Step 3.7 Flash หรือ Gemini 3.5 Flash-Lite ในแง่ของราคาและประสิทธิภาพ
สรุปประเด็นสำคัญ
- NVIDIA ประสบความสำเร็จในการเพิ่มความเร็ว Ling-3.0-flash บน DGX Spark ขึ้น 42.5%
- การใช้ Humming kernels และ FP8 LM head เป็นกุญแจสำคัญในการลดภาระการถอดรหัส
- ระบบ MTP speculative decoding ในตัวช่วยลดจำนวนขั้นตอนประมวลผลได้อย่างมีนัยสำคัญ
- Ling-3.0-flash เป็นโมเดลประสิทธิภาพสูงที่ใช้งานพารามิเตอร์เพียงบางส่วน ช่วยประหยัดทรัพยากร
ผู้ที่สนใจสามารถอ่านบทวิเคราะห์ฉบับเต็มได้ที่ NVIDIA Technical Blog หรือเข้าถึงน้ำหนักโมเดลได้ทาง Hugging Face
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร