
Soniox เปิดตัว STT v6 ชูฟีเจอร์ช่วย Voice Agent ตัดเสียงสะท้อน
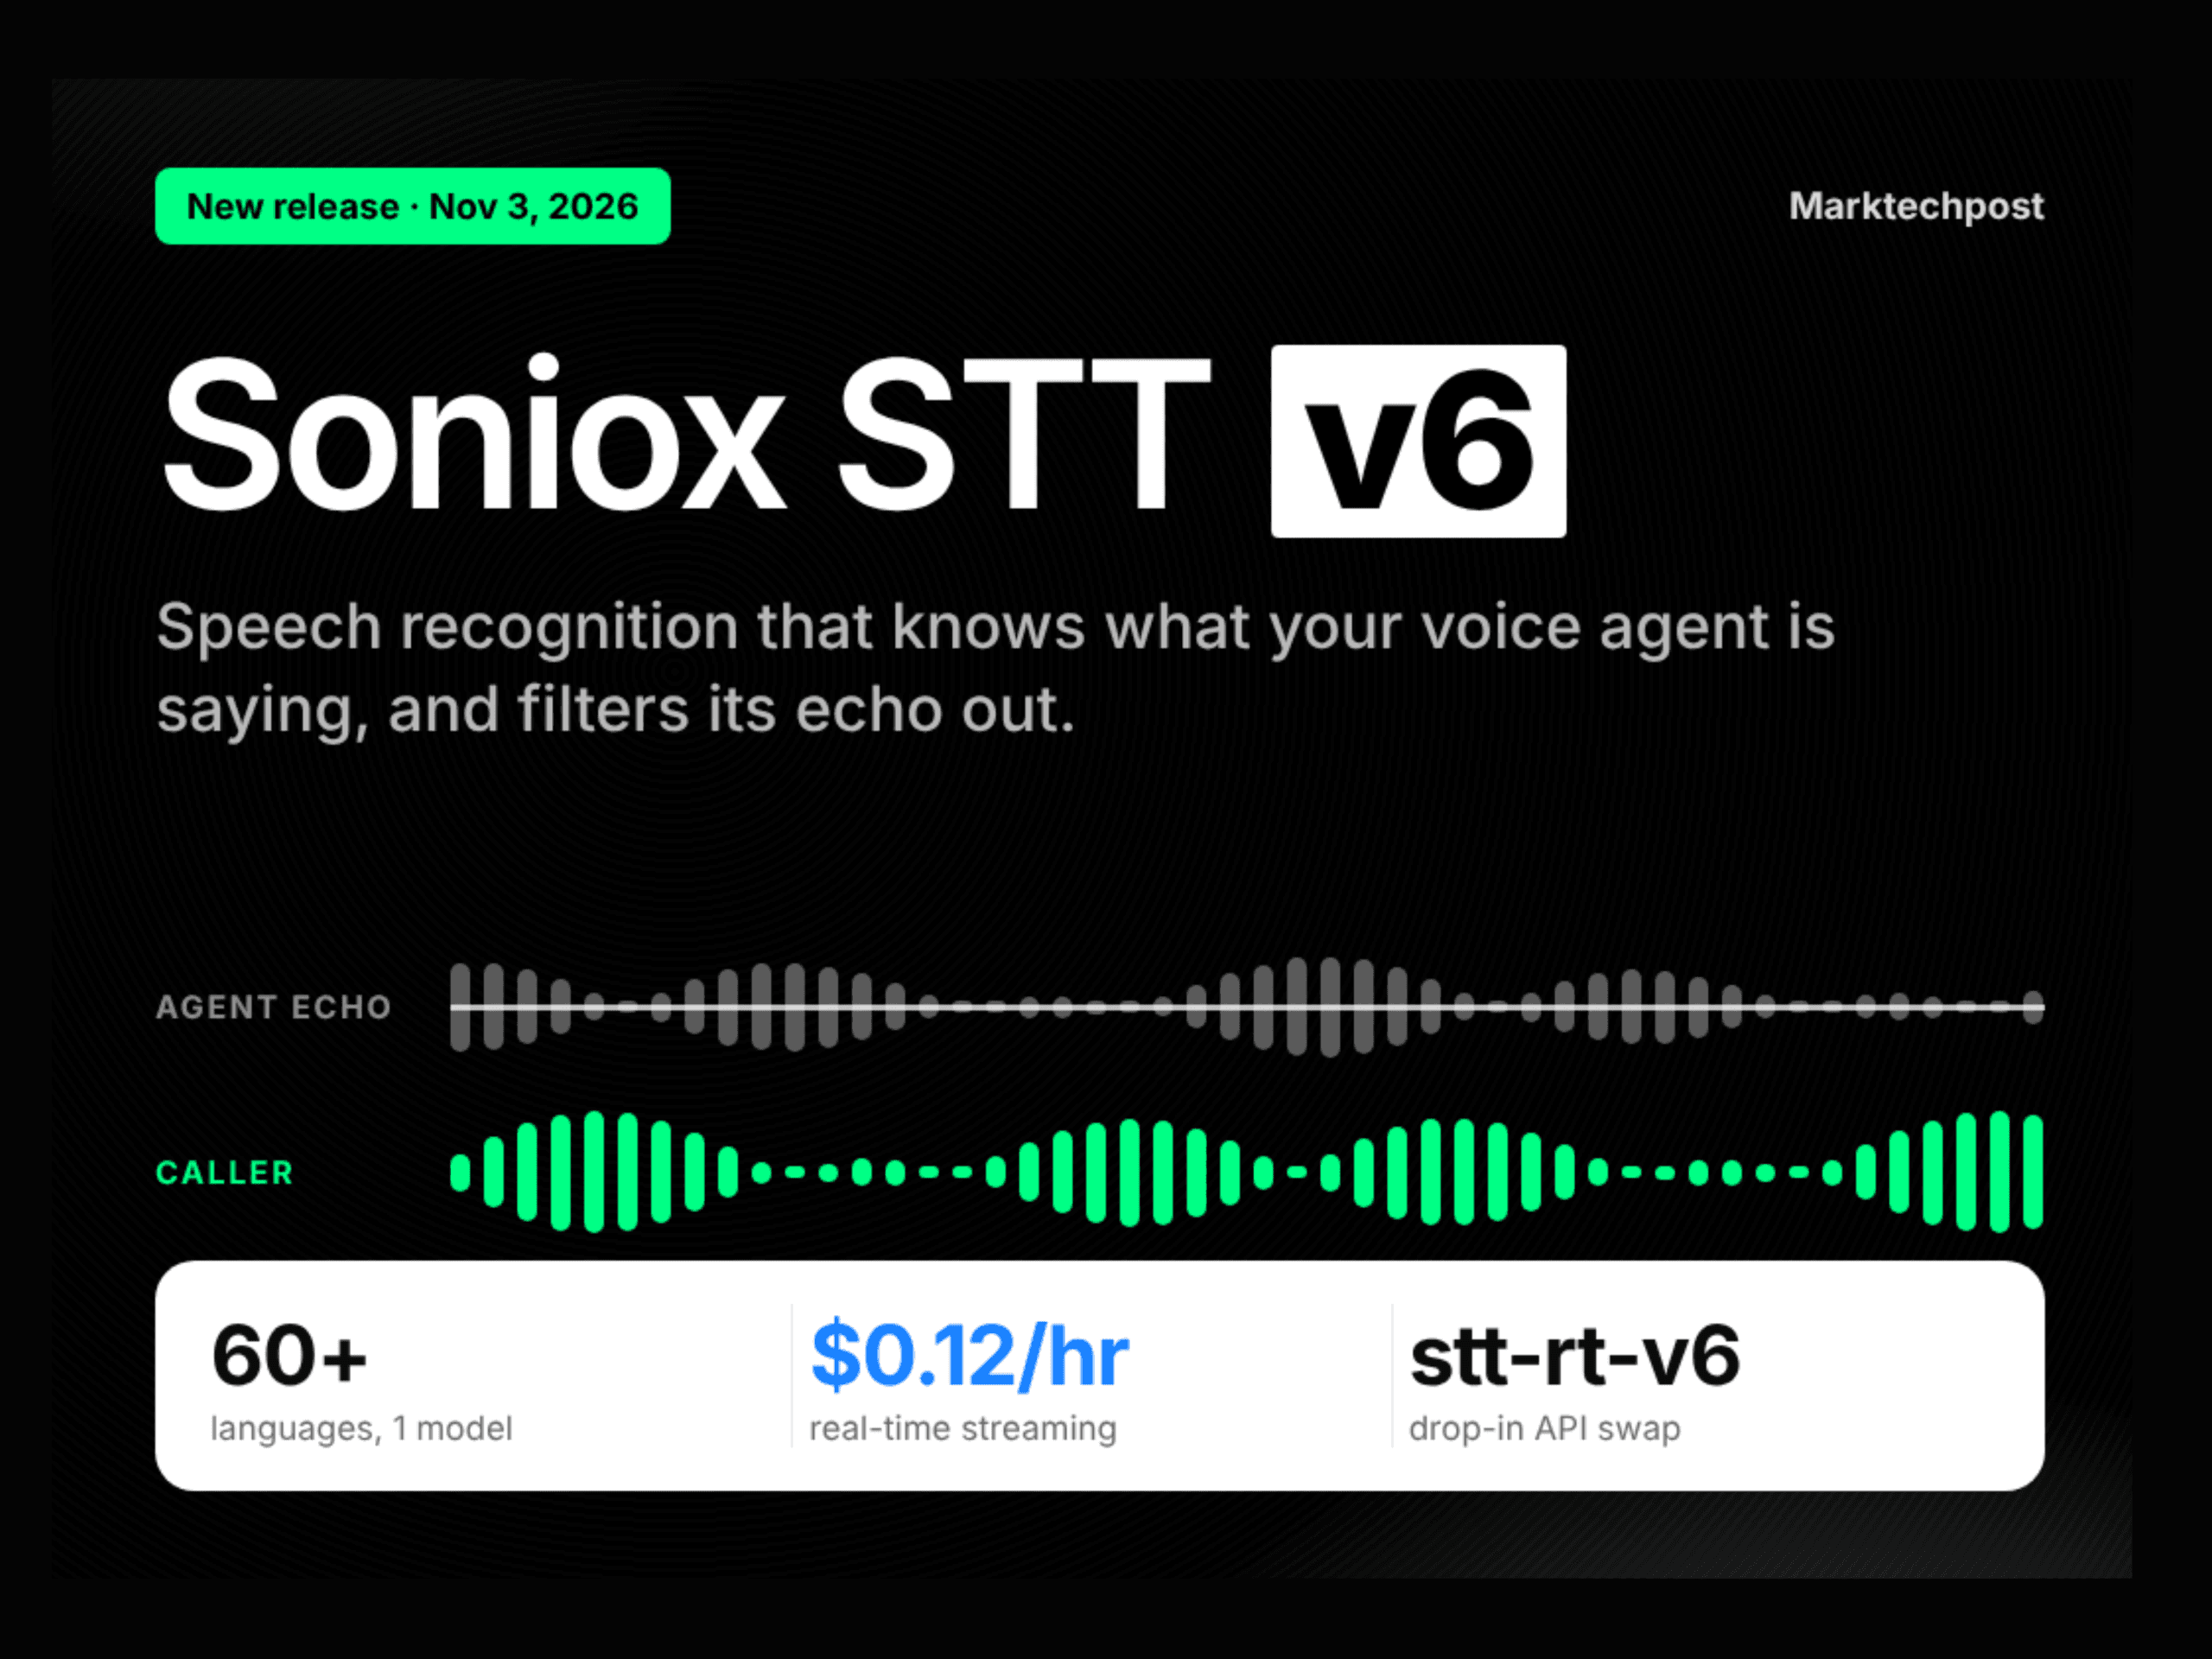
Soniox เปิดตัว Soniox STT v6 รุ่นล่าสุดของ speech-to-text API โดยจุดเด่นอยู่ที่ความสามารถในการอ่านสิ่งที่ voice agent กำลังพูดไปพร้อมๆ กับการฟังเสียงจากผู้โทร โมเดลจะนำข้อความเหล่านั้นมาช่วยจดจำคำตอบสั้นๆ และตัดเสียงของตัวเอเยนต์เองที่อาจแทรกเข้ามาออกไป การเปิดตัวครั้งนี้มาในรูปแบบ stt-rt-v6 สำหรับ streaming และ stt-async-v6 สำหรับการประมวลผลไฟล์ ครอบคลุมการใช้งานมากกว่า 60 ภาษา
TL;DR
- Size: Soniox STT v6 เป็นโมเดลแบบ proprietary hosted ไม่มีการเปิดเผยจำนวนพารามิเตอร์
- Runs on: ใช้งานผ่าน Soniox cloud API เท่านั้น (WebSocket streaming และ async REST) ยังไม่มีตัวเลือกแบบ self-hosted หรือ on-device
- Performance: Soniox ระบุว่ามีความแม่นยำสูงกว่า v5 อย่างมีนัยสำคัญ แต่ยังไม่ได้เปิดเผยตัวเลขทดสอบของ v6 ในขณะนี้
- Best: ราคาคุ้มค่าเพียง $0.12/ชั่วโมง สำหรับ streaming และ $0.10/ชั่วโมง สำหรับ async โดยรวมฟีเจอร์ diarization และ language ID มาให้ในตัว
- Worst: ยังไม่มีผลทดสอบ v6 จากหน่วยงานอิสระ โดยรุ่นก่อนหน้าอย่าง v5 ทำคะแนน semantic WER ได้ 1.34% บน Pipecat ซึ่งตามหลัง v4 ที่ทำได้ 1.25%
Soniox STT v6 แก้ปัญหาอะไร?
ในระบบ voice agent แบบ cascaded ทั่วไป STT มักจะได้ยินเฉพาะเสียงของผู้โทร โดยไม่เห็นข้อความคำถามหรือคำตอบที่เอเยนต์กำลังพูด ส่งผลให้การจดจำคำตอบสั้นๆ มักเกิดความผิดพลาด เช่น "River Roast" อาจถูกเข้าใจผิดเป็น "River Road" หรือ "a tow" กลายเป็น "a tour"
ปัญหาที่สองคือเสียงสะท้อน (echo) ที่เสียงของเอเยนต์รั่วไหลกลับเข้าทางลำโพงหรือไมโครโฟน ทำให้ระบบเข้าใจผิดว่าเป็นคำพูดของผู้ใช้ และส่งผลให้เอเยนต์หยุดชะงักหรือขัดจังหวะตัวเองโดยไม่จำเป็น
การทำงานของ agent text input
ผู้ใช้งานสามารถเปิดฟีเจอร์นี้ได้ง่ายๆ ผ่าน flag ใน start request: "enable_agent_text_input": true โดยรองรับเฉพาะบนโมเดล stt-rt-v6 เท่านั้น ในขณะที่เอเยนต์พูด ระบบจะสตรีมข้อความบน WebSocket เดียวกับเสียงของผู้โทรในรูปแบบ JSON frame ขนาดเล็กดังนี้:
{"type": "agent_text", "text": "...", "end_of_segment": true}เรื่องจังหวะเวลา (timing) มีความสำคัญอย่างมาก เนื่องจากข้อความไม่มี timestamp โมเดลจะวางข้อความ ณ จุดที่ส่งมาถึงใน audio stream โดย Soniox แนะนำให้ส่งข้อความล่วงหน้าประมาณ 500 มิลลิวินาทีถึง 1 วินาทีก่อนเริ่มเล่นเสียงจริง
ในกรณีที่มีการพูดแทรก (barge-in) ผู้ใช้ต้องทำการ flush ข้อมูลที่เล่นไปแล้ว โดยส่ง end_of_segment: true และตัดส่วนที่เหลือทิ้ง ซึ่งข้อความของเอเยนต์จะไม่ปรากฏซ้ำในบทสนทนาที่ระบบส่งกลับมา
ระบบ agent voice echo cancellation
เมื่อเปิดใช้งาน agent text input โมเดล v6 จะรับรู้ว่าเอเยนต์กำลังพูดอะไร และใช้ข้อมูลนั้นแยกแยะเสียงเอเยนต์ที่ตกค้างออกจากเสียงจริงของผู้โทรเพื่อกรองทิ้ง ระบบยังคงฟังเสียงตลอดเวลาเพื่อให้ผู้โทรสามารถพูดแทรกได้ ทั้งนี้ฟีเจอร์ดังกล่าวไม่ได้มาแทนที่ acoustic echo cancellation (AEC) เดิม แต่จะช่วยจัดการเสียงส่วนเกินที่ AEC ทั่วไปเก็บไม่หมด ดังนั้นจึงควรเปิดใช้งาน AEC ควบคู่กันไป
นอกจากนี้ยังมีฟีเจอร์อื่นๆ ที่น่าสนใจ:
- ปรับปรุงการถอดความการประชุมและ speaker diarization ทั้งแบบสดและบันทึกล่วงหน้า
- รองรับสำเนียงที่หลากหลาย รวมถึงการสลับภาษา (code-switching) ภายในประโยคเดียว
- ข้อควรระวัง: v6 จะเขียนคำตามเสียงพูด เช่น "15 dollars and 20 cents" แทนที่จะเป็น "$15.20"
การเปรียบเทียบกับ Benchmark
ปัจจุบัน Soniox ยังไม่ได้เผยแพร่ตัวเลขความแม่นยำของ v6 โดยตรง แต่จากผลทดสอบของรุ่น v5 บน Pipecat STT benchmark พบว่าทำคะแนน semantic WER ได้ 1.34% และมีค่า median TTFS (latency) อยู่ที่ 260 มิลลิวินาที ซึ่งโดดเด่นกว่า Azure ที่มี latency สูงถึง 1,016 มิลลิวินาที แม้จะมีค่า WER ต่ำกว่าเล็กน้อยก็ตาม
| Feature | Soniox stt-rt-v6 | AssemblyAI Universal-3.5 Pro Realtime | Deepgram Nova-3 | ElevenLabs Scribe v2 Realtime |
|---|---|---|---|---|
| Model size | Not disclosed | Not disclosed | Not disclosed | Not disclosed |
| Streaming languages | 60+ | 18 | 60+ (Nova models) | 90+ |
| Streaming price / hour | $0.12 | $0.45 | $0.46 mono, $0.55 multi | $0.39 |
| Agent-side text context | Yes, timed agent_text | Yes, agent_context | Not disclosed | Not disclosed |
| Model-level agent echo filtering | Yes | Not disclosed | Not disclosed | Not disclosed |
| Diarization cost | Included | Not disclosed | +$0.0020/min | Not disclosed |
| Pipecat semantic WER mean | 1.34% (v5; v6 untested) | 1.44% | 1.71% (nova-3-general) | 3.16% |
| Pipecat perfect transcripts | 83.3% (v5) | 84.7% | 76.5% | 81.3% |
| Pipecat TTFS median | 260 ms (v5) | 282 ms | 247 ms | 281 ms |
Soniox เป็นรายแรกในตลาดหรือไม่?
Soniox อ้างว่า v6 เป็นโมเดลแรกที่เข้าใจบริบทว่าเอเยนต์กำลังพูดอะไร ซึ่งความแตกต่างที่ชัดเจนที่สุดคือเทคโนโลยีการกรองเสียงสะท้อน (echo) โดยใช้ข้อความบริบทเข้าช่วย ซึ่งเป็นคุณสมบัติที่ยังไม่พบในเอกสารของคู่แข่งอย่าง AssemblyAI
สำหรับการใช้งาน ผู้ใช้สามารถอัปเกรดเป็น v6 ได้ทันทีเพียงเปลี่ยนชื่อโมเดลเป็น stt-rt-v6 หรือ stt-async-v6 ในระบบเดิม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร