
Supersonic Labs เปิดตัว Julia 1 โมเดลตัดสินใจขนาดเล็ก รันบน CPU ได้
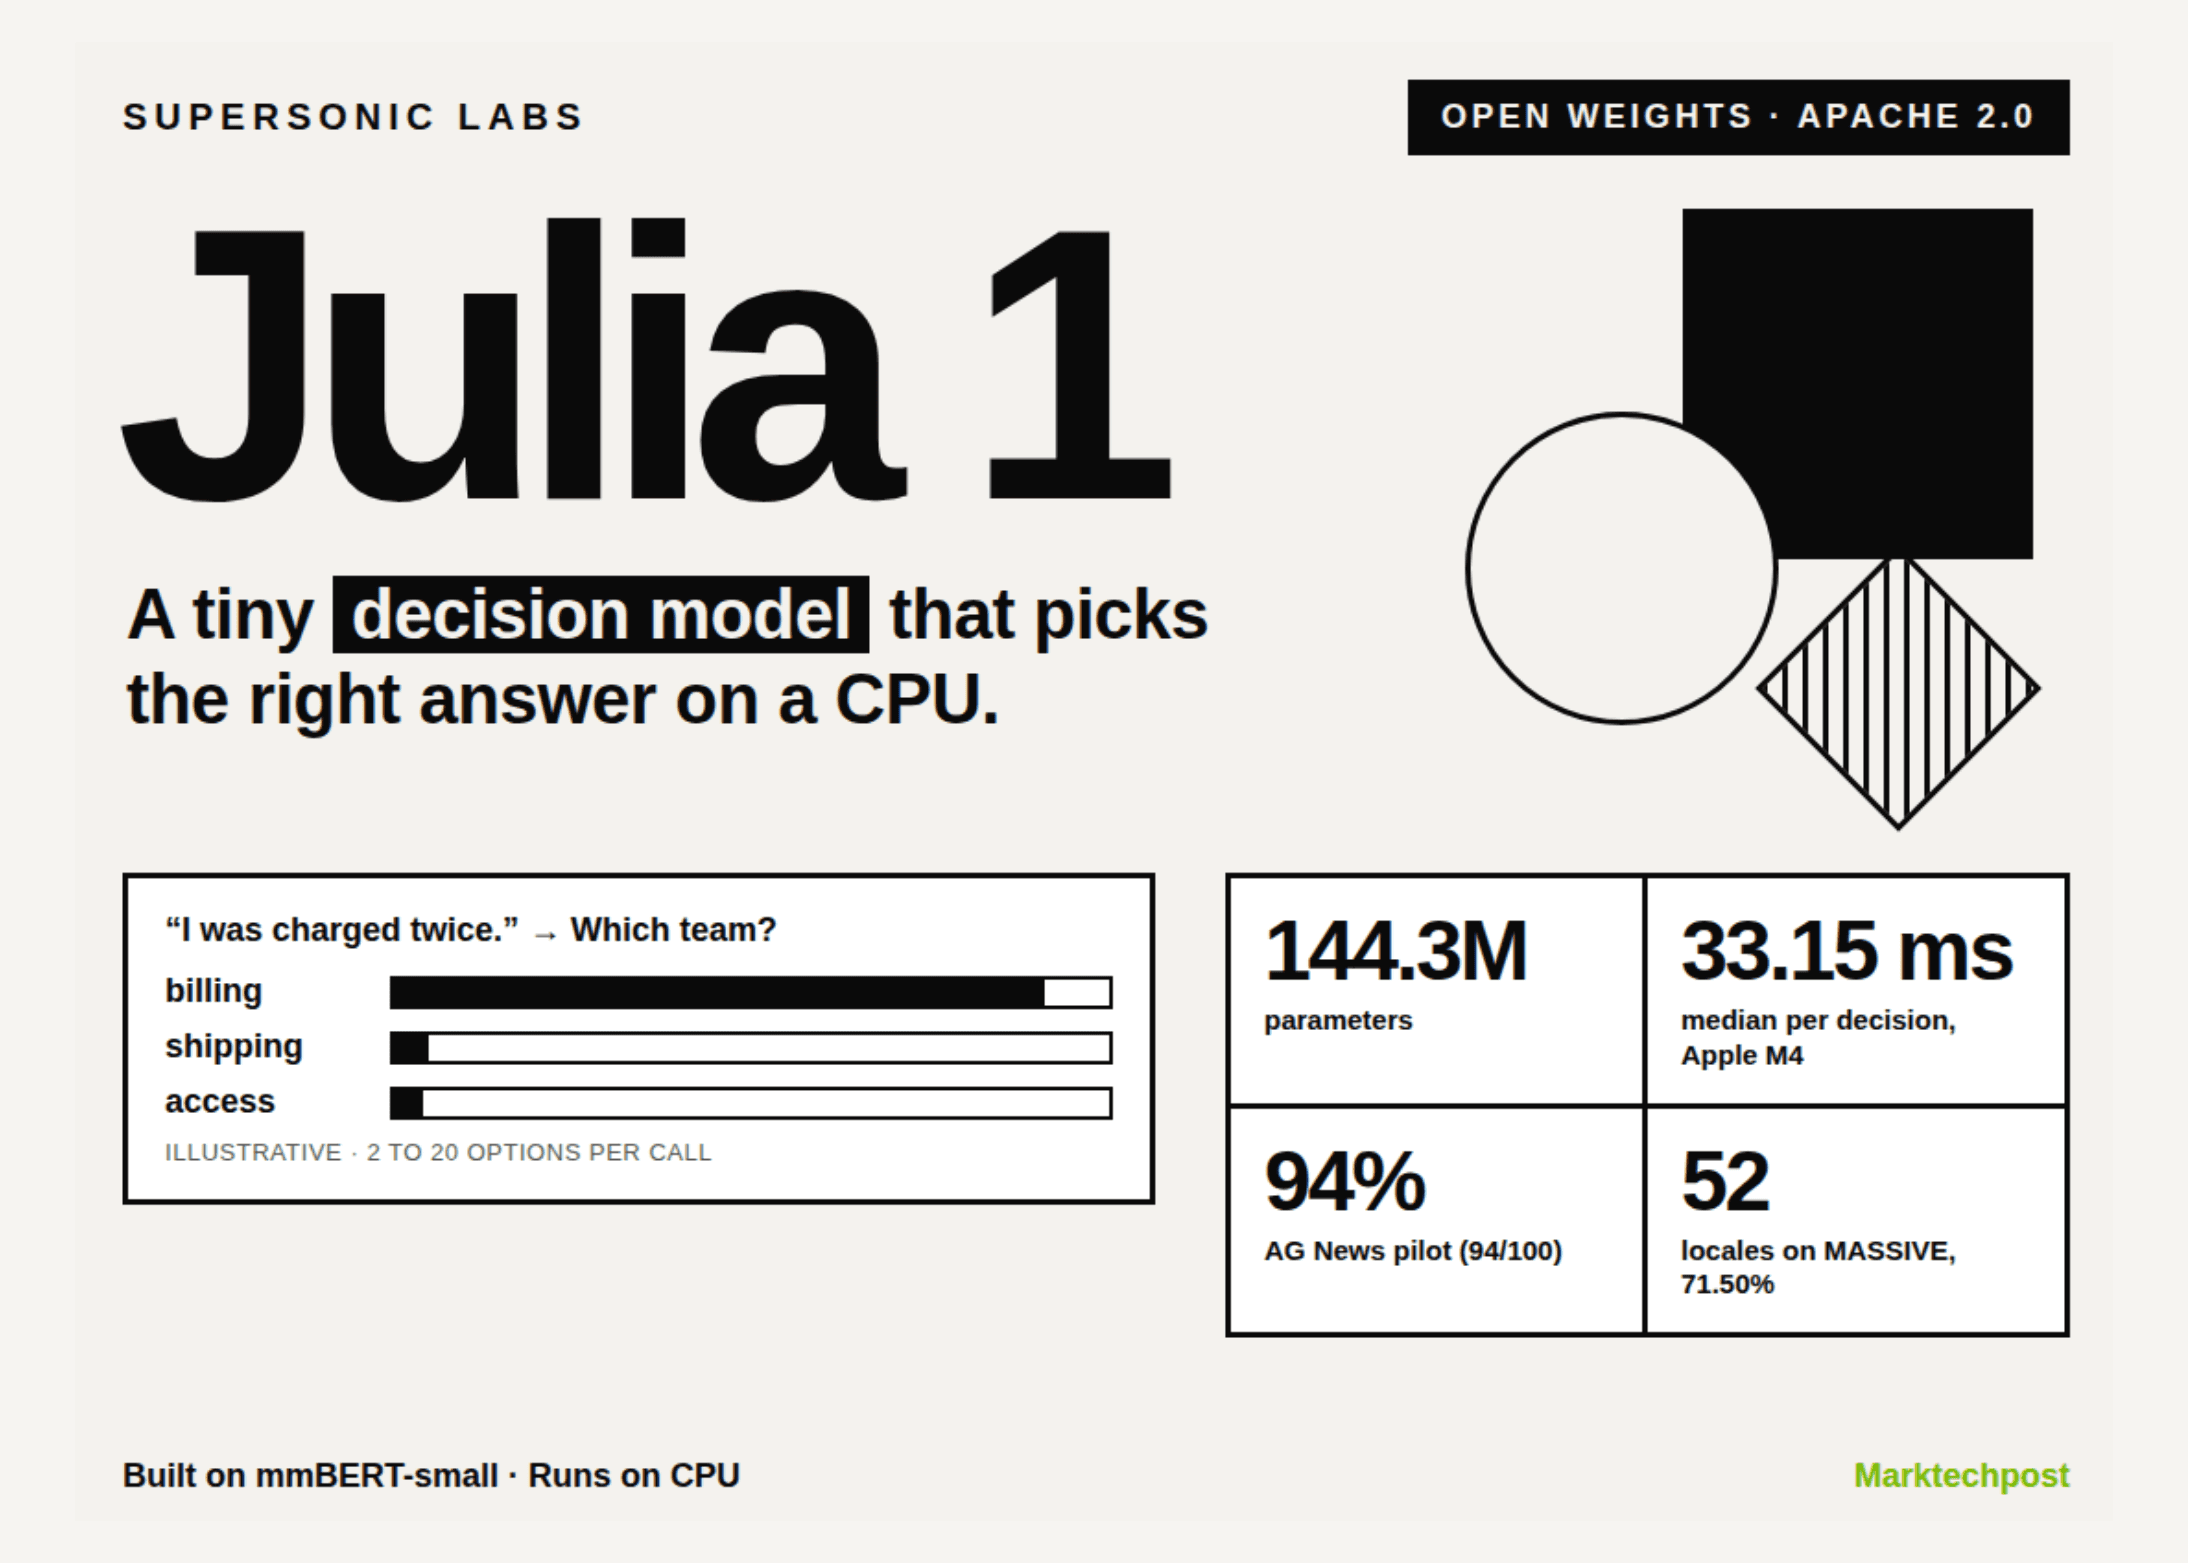
Supersonic Labs แล็บ AI ขนาดเล็กจากบราซิล ประกาศเปิดตัว Julia 1 โมเดลการตัดสินใจขนาดกะทัดรัดที่ออกแบบมาเพื่อประมวลผลทางเลือกโดยเฉพาะ ไม่ใช่แชทบอททั่วไป ผู้ใช้สามารถส่งบริบท คำถาม และตัวเลือกคำตอบได้ตั้งแต่ 2 ถึง 20 รายการ เพื่อให้โมเดลเลือกคำตอบที่ดีที่สุดพร้อมระบุค่าความน่าจะเป็น โดยตัวโมเดลมีพารามิเตอร์เพียง 144.3 ล้านรายการ ทำให้สามารถทำงานบน CPU ทั่วไปได้อย่างมีประสิทธิภาพ
สำหรับการใช้งานจริง โมเดลนี้เปิดให้เข้าถึง weights อยู่บน Hugging Face ภายใต้สัญญาอนุญาตแบบ Apache 2.0 สามารถรันแบบโลคัลด้วย Python 3.11+ บน CPU หรือ GPU ที่รองรับ BF16 นอกจากนี้ยังมี ONNX build ที่รองรับการทำงานในเบราว์เซอร์ผ่าน WebGPU ส่วนบริการ API แบบโฮสต์มีกำหนดเปิดตัวในอนาคต
สิ่งที่ Julia 1 ทำได้
Julia 1 สามารถจัดการการตัดสินใจได้ 3 รูปแบบผ่าน API เดียว ดังนี้:
- choice: เลือกหนึ่งเลเบลจากตัวเลือกที่กำหนด 2 ถึง 20 รายการ (สำหรับการจำแนกประเภทหรือการกำหนดเส้นทาง)
- score: คืนค่าดัชนีที่คาดหวังตามเกณฑ์ที่จัดลำดับไว้ เช่น ต่ำ, กลาง, สูง
- noul: คืนค่าความน่าจะเป็นที่ข้อความรูปแบบ yes-or-no จะเป็นจริง
ผลลัพธ์จะถูกส่งกลับตามลำดับตัวเลือกที่ผู้เรียกกำหนด พร้อมค่าความน่าจะเป็นแบบ softmax เต็มรูปแบบ รวมถึงคงค่า Caller ID อย่างเช่น billing ไว้โดยไม่มีการเปลี่ยนแปลง ทั้งนี้โมเดลถูกออกแบบมาเพื่อการตัดสินใจเท่านั้น ไม่ได้มีไว้สำหรับการสร้างข้อความ (Text Generation)
สถาปัตยกรรมและงบประมาณการฝึกฝน
Julia 1 พัฒนาต่อยอดจาก mmBERT-small ของ JHU CLSP ซึ่งเป็น ModernBERT encoder แบบหลายภาษาที่ผ่านการฝึกฝนกว่า 1,800 ภาษา โดย Supersonic Labs ได้คงส่วน encoder และ tokenizer เดิมไว้ แล้วเพิ่ม decision head เข้าไปพร้อมฝึกฝนด้วยตัวอย่างการตัดสินใจโดยเฉพาะ ทางแล็บยืนยันว่า Julia 1 ไม่ใช่โมเดล Qwen ที่ถูกนำมา fine-tune โดยตัวรันไทม์รองรับโทเค็นรวมสูงสุด 8,192 รายการ แต่ในการทดสอบเบนช์มาร์คได้จำกัดไว้ที่ 1,024 โทเค็น
โครงการนี้ใช้งบประมาณ GPU บนคลาวด์ในการฝึกฝนและทดลองเพียง 540 เรอัลบราซิล (ประมาณ 104.08 ดอลลาร์สหรัฐ) โดยตัว weights แบบ FP32 ใช้พื้นที่เพียง 550.5 MiB ทั้งนี้แม้ไพป์ไลน์การฝึกฝนส่วนตัวจะไม่ได้ถูกเปิดเผย แต่ทางแล็บระบุว่ากำลังพัฒนา Julia 2 ที่จะใช้สถาปัตยกรรมพื้นฐานของตนเองในลำดับถัดไป
ผลลัพธ์เบนช์มาร์ค
จากการประเมินเมื่อวันที่ 24 กันยายน 2026 บน H200 BF16 โดยเปรียบเทียบกับค่าอ้างอิงจาก Jev ของ TypeSafe ผ่าน Jev benchmark protocol ได้ผลลัพธ์ดังนี้:
- Typed Decisions: ทำได้ 73.15% สูงกว่าค่าอ้างอิงที่ 72.70%
- AG News (4 เลเบล): ทำได้ 94/100 สูงกว่าค่าอ้างอิงที่ 91%
- DAIR Emotion (6 เลเบล): ทำได้ 86/100 สูงกว่าค่าอ้างอิงที่ 48%
- Banking77 (72 เลเบล): ทำได้เพียง 64/100 ขณะที่ค่าอ้างอิงอยู่ที่ 87% ซึ่งถือเป็นจุดอ่อนที่ชัดเจน
- MASSIVE (18 สถานการณ์): ความแม่นยำ macro เฉลี่ย 71.50% จาก 52 ภาษาท้องถิ่น โดยในโปรตุเกส (pt-PT) ทำได้ 86.25% และสหรัฐฯ (en-US) ทำได้ 86.75%
สำหรับการทดสอบบน CPU เมื่อวันที่ 25 กันยายน ให้ผลลัพธ์ใกล้เคียงเดิมที่ 72.55% ใน Typed Decisions และ 60/100 ใน Banking77 โดยมีการงดออกเสียง (abstentions) 3 รายการ
Latency บนอุปกรณ์
ผลการวัดประสิทธิภาพรายอุปกรณ์แสดงให้เห็นความเร็วที่น่าสนใจ โดยบน Apple M4 มีค่ามัธยฐานการตัดสินใจอยู่ที่ 33.15 ms ต่อครั้ง ส่วนแท็บเล็ต Samsung SM-X510 ผ่าน ONNX Runtime อยู่ที่ 203 ms สำหรับฝั่ง Intel Core i5-1235U การทดสอบ AG News ใช้เวลาเฉลี่ย 107.83 ms ขณะที่ Banking77 ใช้เวลานานถึง 3,713.54 ms เนื่องจากต้องคัดกรองเลเบลจำนวนมากถึง 72 รายการ
อย่างไรก็ตาม ข้ออ้างบน X @supersonicai ที่ระบุว่า Julia 1 ทำงานเร็วกว่า Jev ถึง 5 เท่าบนแล็ปท็อป i5 ควรได้รับการพิจารณาอย่างระมัดระวัง เนื่องจากค่าความหน่วงของ Jev ถูกวัดจากบริการแบบโฮสต์ในฝรั่งเศส ซึ่งไม่ใช่สภาวะการทดสอบเดียวกัน
คำอธิบายแบบโต้ตอบ
Julia 1 เทียบกับคู่แข่งที่ใกล้เคียงที่สุด
| คุณสมบัติ | Julia 1 | TypeSafe Jev | GLiNER2.5 Multi |
|---|---|---|---|
| ผู้พัฒนา | Supersonic Labs | TypeSafe AI | Fastino |
| การเข้าถึง | Open weights | Hosted API, early access | Open weights |
| สัญญาอนุญาต | Apache 2.0 | มีเจ้าของ (Proprietary) | Apache 2.0 |
| พารามิเตอร์ | 144.3M | ไม่เปิดเผย | 287M |
| Base encoder | mmBERT-small | ไม่เปิดเผย | mDeBERTa-v3-base |
| ประเภทการตัดสินใจ | Choice, score, yes/no | Typed structured decisions | Classification, NER, relations, records |
| ตัวเลือกต่อการเรียก | 2 ถึง 20 (ใช้ Router สำหรับจำนวนที่มากกว่า) | สูงสุด 255 | รายชื่อเลเบลต่อ schema |
| รันแบบโลคัลบน CPU | ใช่ | ไม่ใช่ | ใช่ |
| ราคาอินพุตต่อ 1 ล้านโทเค็น | $0.025 (API ที่วางแผนไว้) | $0.042 | ฟรี (โฮสต์เอง) |
| AG News pilot | 94% | 91% | 70% |
| DAIR Emotion pilot | 86% | 48% | 44% |
| Banking77 pilot | 64% | 87% | 61% |
ที่มา: Julia 1 model card, โพสต์เปิดตัวของ TypeSafe, GLiNER2.5 Multi card, Jev benchmark pilot โดย Julia 1 pilot ถูกรันแยกต่างหากจากการรันของ Jev และ GLiNER
ข้อจำกัด
Julia 1 จะประมวลผลเฉพาะตัวเลือกที่ระบุให้เท่านั้น ไม่สามารถใช้ตรวจสอบข้อเท็จจริง แก้โจทย์พีชคณิต หรือคำนวณหลายขั้นตอนได้ ระบบ Router อาจทำให้เลเบลที่ถูกต้องตกหล่นไประหว่างการคัดกรอง และเนื่องจากไม่ใช่ไพป์ไลน์ Transformers มาตรฐาน จึงยังไม่มีผู้ให้บริการอินเฟอเรนซ์บน Hugging Face รองรับโมเดลนี้ในขณะนี้ ทางแล็บแนะนำให้ผู้ใช้วางแผนประเมินผลด้วยข้อมูลเฉพาะของตนเอง และควรมีมนุษย์ร่วมตรวจสอบในการตัดสินใจที่มีความสำคัญสูง
สรุปประเด็นสำคัญ
- Julia 1 เป็นโมเดลการตัดสินใจขนาด 144.3 ล้านพารามิเตอร์ ภายใต้สัญญาอนุญาต Apache 2.0 ที่ทำงานบน CPU ได้
- API เดียวครอบคลุมการตัดสินใจแบบเลือก (choice), คะแนนแบบจัดลำดับ (ordered score) และแบบใช่หรือไม่ใช่ (yes-or-no) จากตัวเลือก 2 ถึง 20 รายการ
- ชนะค่าอ้างอิงของ Jev ใน 3 จาก 4 การทดสอบนำร่อง แต่ตามหลังอย่างมากใน Banking77 ที่มี 72 เลเบล
- ค่ามัธยฐานของ latency อยู่ที่ 33.15 ms ต่อการตัดสินใจบน Apple M4
- ค่าใช้จ่ายในการฝึกฝนประมาณ 104 ดอลลาร์สหรัฐใน GPU บนคลาวด์; มีแผนสำหรับ API ราคา $0.025/MTok
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร