
ToolGrad: ปฏิวัติการสร้างชุดข้อมูล AI Agent ด้วยเทคนิค Textual Gradients
AI agents ได้แสดงให้เห็นถึงศักยภาพอันยิ่งใหญ่ในการทำภารกิจในโลกแห่งความเป็นจริงให้เป็นอัตโนมัติ ไม่ว่าจะเป็นการค้นหาข้อมูลผ่าน Google Search การจัดการไฟล์ในเครื่อง หรือการรันสคริปต์ Python เพื่อให้บรรลุเวิร์กโฟลว์ระดับสูงเช่นนี้ โมเดลภาษาขนาดใหญ่ (LLMs) จำเป็นต้องเรียนรู้วิธีการใช้เครื่องมืออย่างถูกต้องและมีประสิทธิภาพ
การสอนโมเดลเหล่านี้จำเป็นต้องมีชุดข้อมูลห่วงโซ่การใช้งานเครื่องมือ (tool-use chains) และคำถามของผู้ใช้ที่สอดคล้องกัน ในงานก่อนหน้านี้อย่าง InstructPipe ทีมวิจัยต้องกำกับดูแลข้อมูลด้วยตนเอง ซึ่งไม่สามารถขยายขนาดให้รองรับการ fine-tuning ระดับสูงได้ ขณะที่แนวทางอัตโนมัติอย่าง ToolBench และ ToolACE ก็ยังพบปัญหาความไม่เต็มประสิทธิภาพจากการใช้วิธีลองผิดลองถูกแบบเดิม
ในผลงานวิจัย “ToolGrad: Efficient Tool-use Dataset Generation with Textual ‘Gradients’” ที่นำเสนอในงาน ACL 2026 เราได้เสนอแนวทางใหม่ผ่าน ToolGrad ซึ่งจะสร้างห่วงโซ่การใช้งานเครื่องมือที่ถูกต้อง (ground-truth) ขึ้นมาก่อน แล้วจึงค่อยสร้างคำถามของผู้ใช้ตามมา
การเปลี่ยนมาใช้แนวทางแบบเน้นคำตอบก่อน (answer-first) ช่วยลดความคลุมเครือของข้อมูล และทำให้กระบวนการสร้างชุดข้อมูลซับซ้อน (long-horizon) ทำได้ในราคาที่ถูกลงอย่างมาก ผลการทดสอบพบว่า LLMs ที่ฝึกด้วย ToolGrad มีประสิทธิภาพเหนือกว่าโมเดล baseline และเทียบเท่ากับ proprietary LLMs ระดับ SoTA แม้จะเป็นการใช้งานในเครื่องมือที่ไม่เคยเห็นมาก่อนก็ตาม
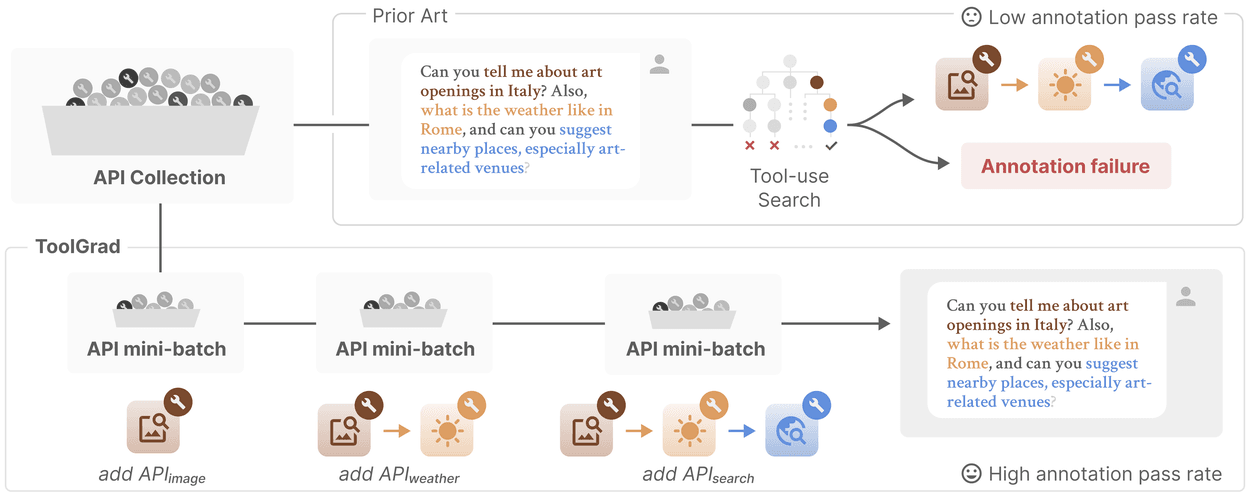
ในขณะที่งานก่อนหน้านี้สร้างชุดข้อมูลการใช้เครื่องมือโดยการค้นหาโซลูชันจากคำถามของผู้ใช้ซึ่งมีอัตราการผ่านต่ำ ToolGrad สร้างห่วงโซ่การใช้เครื่องมือที่สำเร็จก่อนจะสร้าง prompt ซึ่งทำให้อัตราการผ่านสูง
การสร้างห่วงโซ่การใช้งานเครื่องมือแบบวนซ้ำด้วย textual “gradients”
ระบบ Machine Learning (ML) ทั่วไปจะพัฒนาผ่านการคำนวณ numerical loss gradients เพื่ออัปเดตน้ำหนักโมเดล แต่เมื่อไม่นานมานี้ TextGrad ได้นำแนวคิดนี้มาใช้กับ prompt engineering โดยให้ LLM critic ทำหน้าที่ให้คำติชมเป็นข้อความธรรมดาที่เรียกว่า “textual gradients” เพื่อแนะนำการปรับปรุง prompt ให้ดียิ่งขึ้น
ToolGrad ได้ต่อยอดแนวคิดนี้มาใช้ในการสร้างชุดข้อมูลสังเคราะห์ แทนที่จะเพิ่มประสิทธิภาพแค่ตัวอักษรคงที่ ToolGrad ใช้ gradients เหล่านี้เพื่อสร้างเวิร์กโฟลว์ API ที่ถูกต้องและซับซ้อนจากคลังเครื่องมือขนาดใหญ่ผ่านกระบวนการแบบวนซ้ำ
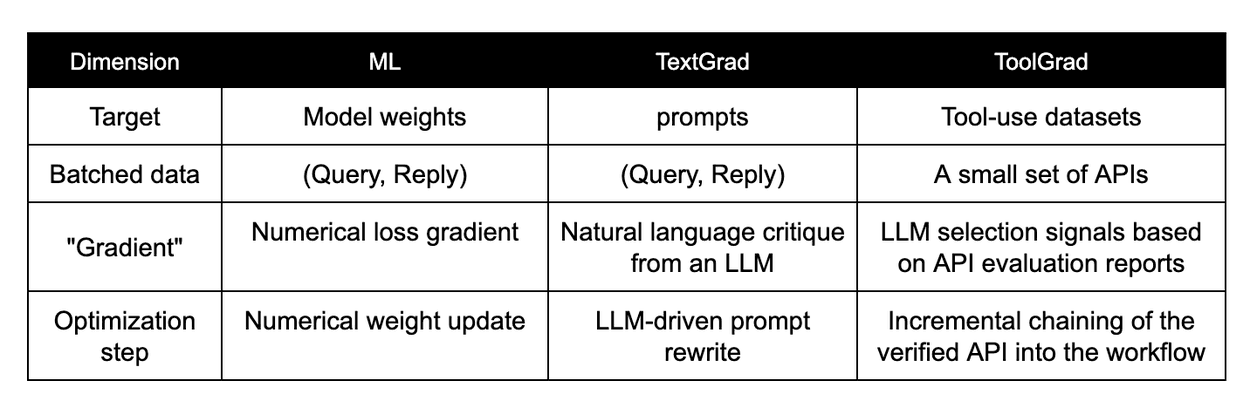
การเปรียบเทียบส่วนประกอบการเพิ่มประสิทธิภาพของ ToolGrad กับ ML แบบดั้งเดิมและ TextGrad
กรอบการทำงาน ToolGrad
ToolGrad ประกอบด้วย 4 โมดูลหลักที่ทำงานต่อเนื่องกันดังนี้:
- API Proposer: คัดกรอง API ที่สุ่มมาให้เหลือเฉพาะรายการที่มีแนวโน้มดีเพื่อนำไปขยายเวิร์กโฟลว์
- API Executors: ทดสอบการทำงานของ API ที่เลือกแบบขนานและสร้างรายงานผลโดยละเอียด
- API Selector: ตรวจสอบรายงานและเลือกการเรียกใช้ API ที่ดีที่สุดเพื่อทำหน้าที่เป็น textual gradient ในการให้คำติชมเชิงทิศทางและเพิ่มเข้าสู่เวิร์กโฟลว์
- LLM Updater: ปรับปรุงคำถามของผู้ใช้สังเคราะห์และการตอบกลับของ AI ให้สอดคล้องกับชุด API ใหม่
การทำซ้ำในขั้นตอนนี้จะส่งผลให้ได้ตัวอย่างข้อมูลที่สมบูรณ์ ทั้งคำถามของผู้ใช้ เวิร์กโฟลว์ API ที่ผ่านการตรวจสอบแล้ว และคำตอบสุดท้ายจาก AI
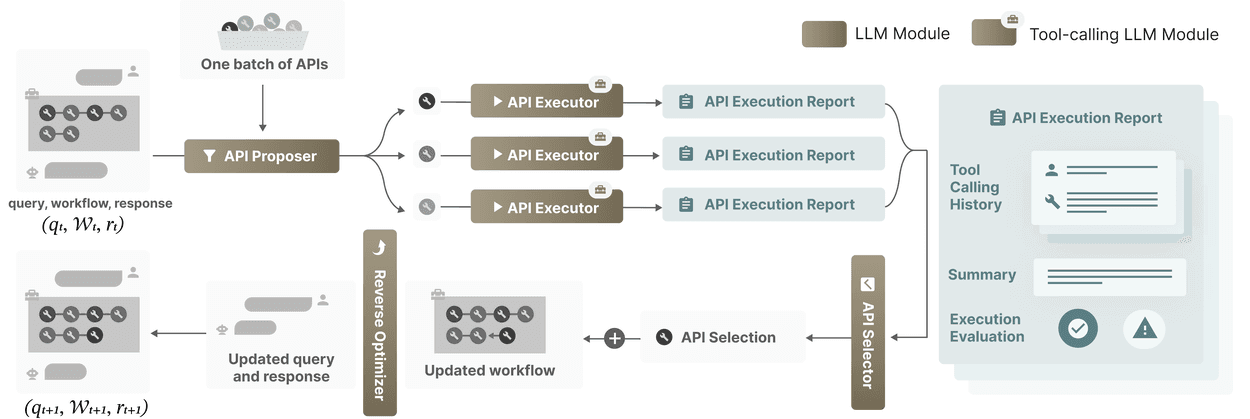
ToolGrad สร้างห่วงโซ่การใช้เครื่องมือที่สำเร็จก่อนจะสร้าง prompt ซึ่งให้อัตราการผ่านที่สูง
การทดลอง
ประสิทธิภาพในการสร้างข้อมูล
ทีมวิจัยได้ทดสอบโดยใช้ ToolBench ซึ่งมี API ในโลกจริงกว่า 16,000 รายการ ผลการเปรียบเทียบระหว่างแนวทางเน้นคำถามก่อน (query-first) แบบดั้งเดิม กับแนวทางเน้นคำตอบก่อน (answer-first) ของ ToolGrad พบว่า ToolGrad สามารถสร้างข้อมูลที่มีความซับซ้อนสูงกว่าด้วยอัตราการผ่าน (pass rate) ที่สูงเกือบ 100% ภายใต้ต้นทุนที่ต่ำกว่ามาก
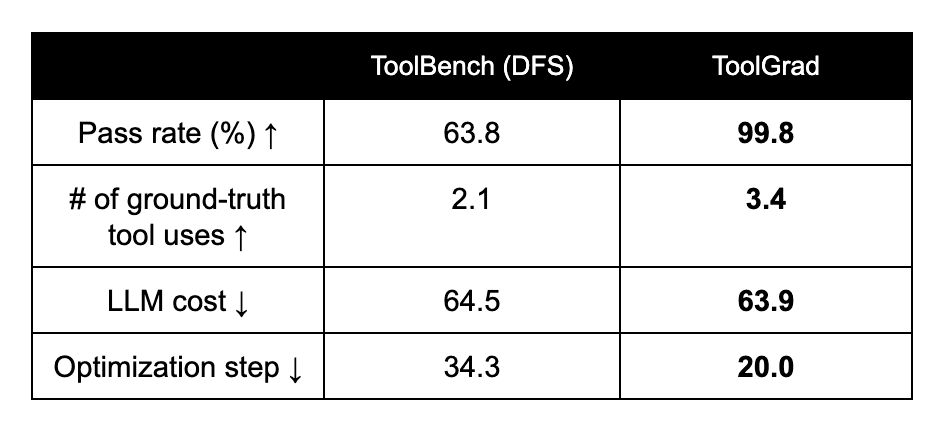
การเปรียบเทียบประสิทธิภาพการสร้างระหว่างแนวทาง query-first (baseline) และแนวทาง answer-first (ของเรา)
Berkeley function calling leaderboard
ทีมงานได้สร้างชุดข้อมูล ToolGrad-500 เพื่อนำมา fine-tune โมเดล Gemma-3 ในขนาดต่างๆ (1B, 4B และ 12B) แล้วทดสอบบน Berkeley Function Calling Leaderboard (BFCL) ซึ่งเป็นเบนช์มาร์กมาตรฐานที่มีชุดเครื่องมือแตกต่างจากที่ใช้ฝึก
ข้อสรุปสำคัญจากการทดลองมีดังนี้:
- พัฒนาขึ้นอย่างก้าวกระโดด: การฝึก Gemma-3 ด้วย ToolGrad-500 ช่วยเพิ่มความสามารถในการใช้เครื่องมือในทุกขนาดโมเดลอย่างชัดเจน
- ชนะโมเดลยักษ์ใหญ่: ToolGrad-12B ทำคะแนนได้ถึง 83.1 ซึ่งใกล้เคียงกับ gemini-2.5-pro (83.2) และสูงกว่า gpt-5 (74.4) รวมถึง claude-4.5 Opus (82.8)
- การวิวัฒนาการด้วยตนเอง (Self-evolving): แม้ ToolGrad-500 จะสร้างโดย gemini-2.5-flash-lite แต่ผลปรากฏว่า Gemma-3-12B ที่ฝึกจากข้อมูลนี้กลับมีประสิทธิภาพเหนือกว่าโมเดลผู้สร้าง (teacher model) ของมันเอง
- นำหน้าโมเดล Open-source: ToolGrad-12B มีประสิทธิภาพเหนือกว่าโมเดลเฉพาะทางอย่าง ToolACE และ Hammer-2.1-7B อย่างเห็นได้ชัด
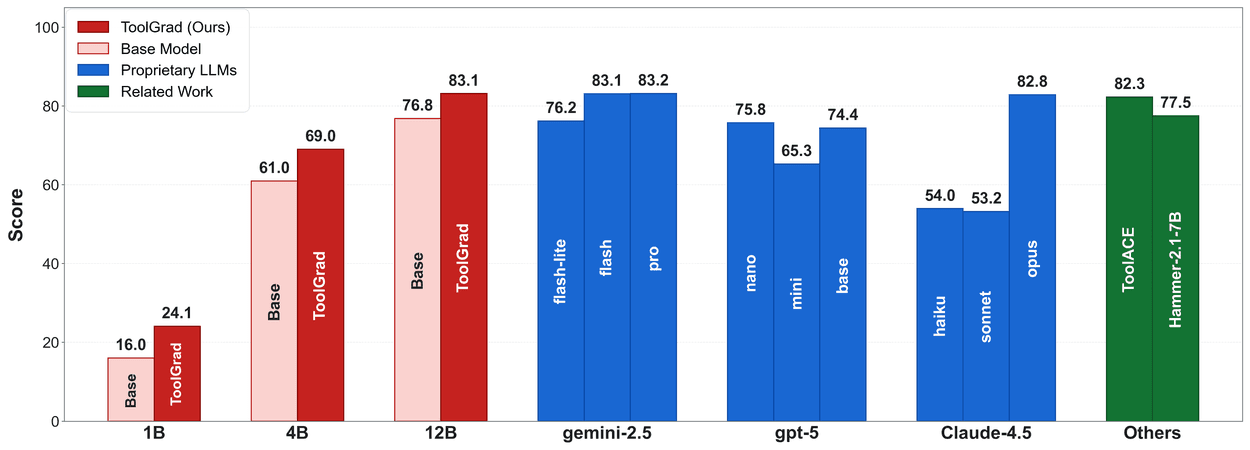
ผลการประเมิน BFCL บนโมเดล Gemma-3, ToolGrad, Gemini 2.5 series, GPT-5, Claude-4.5, ToolACE และ Hammer-2.1-7B
บทสรุปและทิศทางในอนาคต
ToolGrad พิสูจน์ให้เห็นว่าชุดข้อมูลคุณภาพสูงสามารถสร้างขึ้นได้อย่างน่าเชื่อถือผ่านแนวคิดแบบเน้นคำตอบก่อน การใช้ textual gradients เชื่อมโยง API ช่วยทลายกำแพงด้านต้นทุนและการขยายขนาดข้อมูล ground-truth ทำให้โมเดลขนาดกะทัดรัดสามารถทำงานได้เทียบเท่าหรือดีกว่าโมเดลขนาดใหญ่
ในอนาคต งานวิจัยนี้จะขยายผลสู่ระบบนิเวศ API ที่กว้างขวางและยืดหยุ่นยิ่งขึ้น เพื่อรองรับการเรียนรู้แบบต่อเนื่องและการปรับแต่งเฉพาะบุคคล (personalization) ซึ่งจะเป็นรากฐานสำคัญในการสร้างดิจิทัลเอเจนต์ที่ฉลาดและประหยัดต้นทุนสำหรับองค์กรและชีวิตประจำวัน
กิตติกรรมประกาศ
งานวิจัยนี้ดำเนินการโดย Zhongyi Zhou ในระหว่างดำรงตำแหน่ง Visiting Researcher ที่ Google ร่วมกับคณะผู้วิจัย Kohei Uehara, Haoyu Zhang, Jingtao Zhou, Lin Gu, Zheng Xu, Tatsuya Harada พร้อมคำแนะนำเชิงกลยุทธ์จาก Adarsh Kowdle และ Shahram Izadi
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร