
Abacus.AI เปิดตัว Smaug ตระกูลโมเดล Open-weight ทรงพลัง
เนื้อหาที่ได้รับการสนับสนุน
TL;DR:
- Smaug Flash ก้าวกระโดดมากที่สุดในสายการผลิต โดยทำคะแนนเพิ่มขึ้น +14.3 ใน agentic coding, +13.7 ใน AutomationBench และ +19 ใน NL2Repo-Bench มุ่งแก้ปัญหาการเรียกใช้เครื่องมือที่ผิดพลาดในลูปยาวๆ ของ DeepSeek V4 Flash
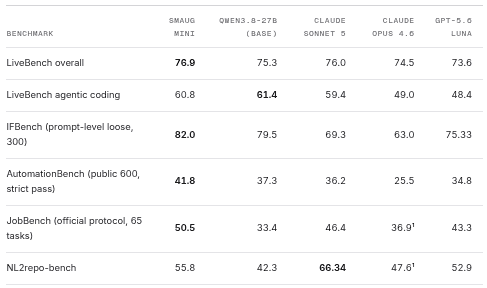
- Smaug Mini (28B) สามารถเอาชนะรุ่นใหญ่อย่าง Claude Sonnet 5, Claude Opus 4.6 และ GPT-5.6 Luna ได้ใน IFBench, AutomationBench และ JobBench แม้จะมีคะแนนด้าน agentic coding ลดลงเล็กน้อย
- Smaug Agentic แม้คะแนนรวมจะเพิ่มขึ้นน้อย (+0.3) แต่โดดเด่นด้านความเสถียร โดยรันงานต่อเนื่อง 113 งานยาวนานกว่า 7 ชั่วโมงโดยไม่มีข้อผิดพลาดทางโครงสร้างพื้นฐาน
ในทั้งสามกรณี ผลกำไรจากการพัฒนาจะกระจุกตัวอยู่ในจุดที่โมเดลตั้งต้น (base model) มีช่องว่างกว้างที่สุด แม้จะใช้สูตรเดียวกันแต่ผลลัพธ์ที่ได้ย่อมต่างกันตามพื้นฐานเดิม
ความสำคัญของประสิทธิภาพ AI Agents
AI agent ในสถานการณ์จริงมักเผชิญปัญหาเมื่อต้องทำงานหลายขั้นตอนต่อเนื่องกัน โมเดลอาจเริ่มเบี่ยงเบนไปจากเป้าหมายเริ่มต้นเมื่อต้องวิเคราะห์ข้อมูลและเรียกใช้เครื่องมือซ้ำๆ ซึ่งทำลายความน่าเชื่อถือของผลลัพธ์และเพิ่มต้นทุนโดยใช่เหตุ
Abacus.AI พบว่าการทำให้โมเดลระดับ state-of-the-art ทำงานได้เหมือน agent ที่ดีนั้นเป็นความท้าทายด้านการฝึกฝน (training) ไม่ใช่เรื่องการทำ prompting เพราะโมเดลภาษาทั่วไปไม่ได้ถูกออกแบบมาเพื่อใช้งานในบริบทที่ยาวและซับซ้อนตลอดเวลา
แนวทางหลักจึงเป็นการปรับปรุงที่ตัวโมเดลโดยตรงแทนการพยายามชดเชยด้วยการปรับจูนภายนอก จนเกิดเป็นตระกูล Smaug models ที่เน้นประสิทธิภาพตามประเภทของงานและตัวโมเดล
Smaug Line คืออะไร?
Smaug คือตระกูลโมเดล open-weight สามรุ่นที่ได้รับการ fine-tuned โดย Abacus.AI สำหรับงานสาย agentic โดยเฉพาะ แต่ละตัวถูกเลือกมาจากฐานที่ต่างกันเพื่อตอบโจทย์ความสามารถและประสิทธิภาพที่หลากหลายบน Hugging Face
| Model | Base Model | Optimized For | Size |
|---|---|---|---|
| Smaug Flash | DeepSeek V4 Flash 0731 | Enterprise agents ที่ทำงานตลอดเวลา, ความเร็ว + ต้นทุน | 304B |
| Smaug Mini | Qwen3.8-27B | Multimodal, กะทัดรัด, งานแบบครั้งเดียวจบ | 28B |
| Smaug Agentic | Kimi K3 | Frontier-scale, การเขียนโค้ดระยะยาว | 2.8T (MoE) |
การใช้สูตรเดียวกันกับฐานที่ต่างกันสามแบบเป็นการพิสูจน์ว่า ระเบียบวิธีนี้มีความเป็นสากลเพียงพอที่จะสร้างการปรับปรุงที่วัดผลได้จริง โดยไม่คำนึงถึงสถาปัตยกรรมหรือขนาดของโมเดล
Smaug Flash: การพัฒนาที่ยิ่งใหญ่ที่สุดในสายการผลิต
Smaug Flash คือรุ่นที่เห็นการก้าวกระโดดของ benchmark ชัดเจนที่สุด โดยถูกสร้างขึ้นเพื่อแก้ปัญหาการวนซ้ำ (spins) และความสับสนในการใช้เครื่องมือที่มีบริบทกว้างยาวของ DeepSeek V4 Flash
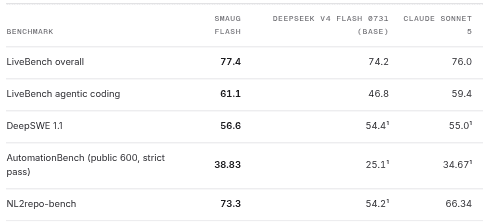
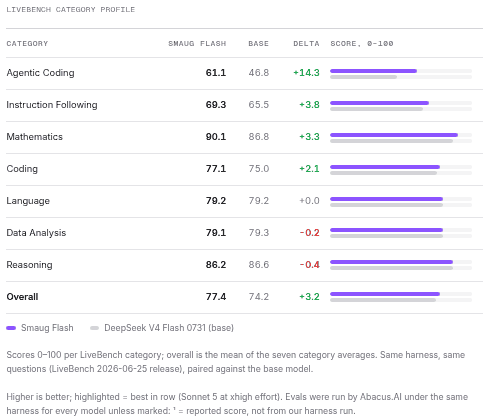
ผลลัพธ์ใน LiveBench แสดงให้เห็นความแม่นยำที่เพิ่มขึ้นอย่างน่าทึ่ง โดยหมวด agentic coding เพิ่มขึ้นถึง +14.3 คะแนน (จาก 46.8 เป็น 61.1) ถือเป็นค่าความต่างที่ใหญ่ที่สุดในตระกูล Smaug ทั้งหมด นอกจากนี้ยังทำคะแนนได้ดีกว่า Claude Sonnet 5 ในหลายหมวดหมู่
Smaug Flash vs DeepSeek V4 Flash vs Claude Sonnet 5:
ที่มา: abacus.ai/smaug
¹ = คะแนนที่รายงานโดยผู้ผลิต ไม่ได้รันภายใต้ระบบทดสอบของ Abacus.AI
รายละเอียดหมวดหมู่ต่อหมวดหมู่ของ LiveBench:
ที่มา: abacus.ai/smaug
การลดลงเล็กน้อยในด้าน Data Analysis และ Reasoning ถือเป็นการแลกเปลี่ยนที่คุ้มค่า เพื่อให้ได้ทักษะที่จำเป็นสำหรับ production agents เช่น ความสามารถในการใช้เครื่องมืออย่างถูกต้องในบริบทที่ยาวขึ้น
Smaug Mini: เรื่องราวที่น่าประหลาดใจ
Smaug Mini เป็นรุ่นปรับปรุงจาก Qwen3.8-27B มุ่งเน้นงาน multimodal และการปฏิบัติตามคำสั่ง ด้วยขนาดพารามิเตอร์เพียง 27 พันล้านตัว ทำให้ใช้งานง่ายขึ้นภายใต้ข้อจำกัดของฮาร์ดแวร์ แต่กลับทำผลงานได้ดีกว่าโมเดลแบบปิด (closed models) ขั้นสูงหลายตัว
Smaug Mini vs Base และ Frontier Closed Models:
ที่มา: abacus.ai/smaug
โปรไฟล์หมวดหมู่ LiveBench สำหรับ Smaug Mini:
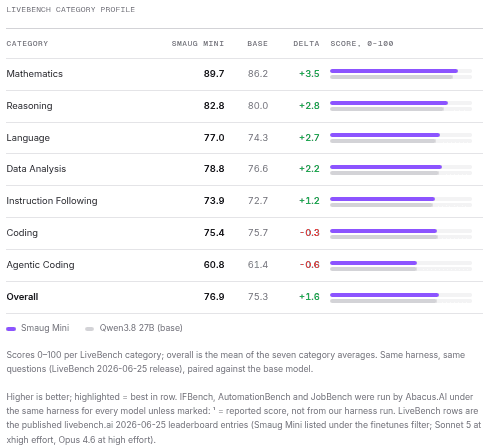
ที่มา: abacus.ai/smaug
จุดที่น่าสนใจคือ แม้คะแนน agentic coding ของ Smaug Mini จะลดลงจากฐานเล็กน้อย (-0.6) แต่ในด้าน IFBench (การปฏิบัติตามคำสั่ง), AutomationBench และ JobBench มันกลับนำหน้าโมเดลระดับแถวหน้าอย่าง Claude และ GPT-5.6 Luna ได้อย่างน่าประทับใจ
Smaug Agentic: เมื่อพฤติกรรมสำคัญกว่าตัวเลข
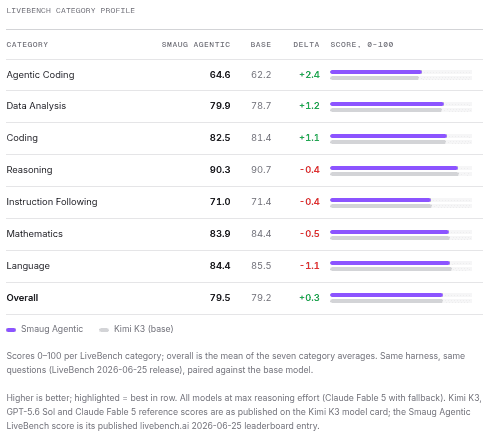
Smaug Agentic คือพี่ใหญ่ที่พัฒนาจาก Kimi K3 (2.8 ล้านล้านพารามิเตอร์) แม้ค่าความต่างของคะแนน benchmark จะน้อยที่สุด แต่ความสำคัญอยู่ที่พฤติกรรมที่เปลี่ยนไป โดยโมเดลสามารถรันงานโค้ดต่อเนื่องได้นานถึง 7 ชั่วโมงโดยไม่มีอาการค้างหรือข้อผิดพลาด
Smaug Agentic vs Kimi K3 Base:
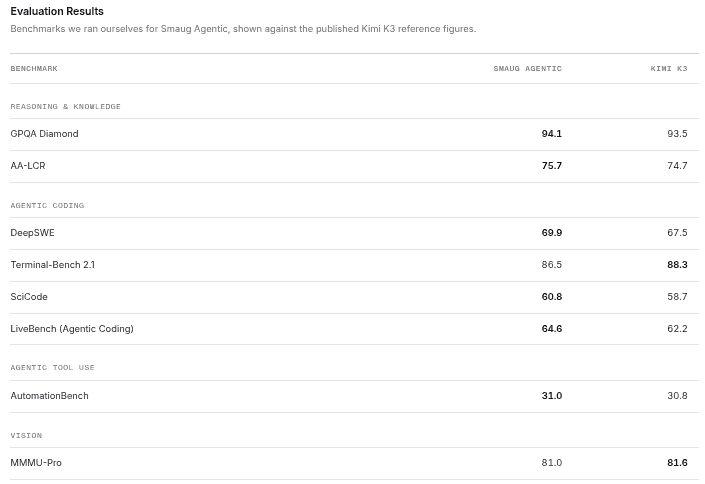
ที่มา: abacus.ai/research
ในงาน agentic coding 113 งาน Smaug Agentic ทำงานเฉลี่ย 78 steps ต่องานโดยไม่มีข้อผิดพลาดทางโครงสร้างพื้นฐาน ซึ่งเป็นจุดที่โมเดลระดับ frontier-scale ส่วนใหญ่มักจะพังทลายเมื่อต้องทำงานในลูปที่ยาวนาน
ระเบียบวิธีการฝึกฝนที่อยู่เบื้องหลังการพัฒนา
Abacus.AI ใช้ระเบียบวิธีที่ผสมผสานร่องรอยการทำงานจริงจากมนุษย์เข้ากับข้อมูลสังเคราะห์ เพื่อให้รางวัลแก่การแก้ปัญหาที่แท้จริง ไม่ใช่แค่การทำคะแนน benchmark
- Smaug Flash: ใช้ LoRA adapters สามตัวในการแก้ไข attention factor matrices เพื่อให้ทำงานร่วมกับโมเดลฐานเดิมได้ทันที และรองรับ context window สูงสุดถึง 1 ล้าน token
- Smaug Agentic: ใช้วิธี Supervised fine-tune โดยการ mask reasoning tokens เพื่อรักษากระบวนการคิดดั้งเดิมควบคู่กับการสอนนิสัยการใช้เครื่องมือที่ดีขึ้น
- Smaug Mini: ใช้ระเบียบวิธีเดียวกันเพื่อปรับปรุงหมวดหมู่ที่โมเดลฐานยังมีช่องว่างให้พัฒนา
สิ่งที่ Benchmark กำลังวัดผลอยู่จริงๆ
LiveBench ซึ่งเป็นงานวิจัยจาก Abacus.AI ถูกออกแบบมาเพื่อป้องกันการปนเปื้อนของข้อมูล โดยอัปเดตคำถามใหม่ทุกเดือนเพื่อให้โมเดลไม่สามารถจดจำคำตอบได้ การประเมินผลจึงสะท้อนความสามารถจริงในด้านต่างๆ เช่น AutomationBench สำหรับการใช้เครื่องมืออัตโนมัติ หรือ NL2Repo-Bench สำหรับการเขียนโค้ดระดับ repository
นัยสำคัญสำหรับการใช้งานจริง
การเลือกใช้โมเดล Smaug ควรพิจารณาจากประเภทงานเป็นหลัก เช่น หากต้องเรียกใช้ API ซ้ำๆ ในเวิร์กโฟลว์ที่ยาวนาน Smaug Flash คือตัวเลือกที่โดดเด่นที่สุด แต่ถ้าต้องการความกะทัดรัดที่รันบน GPU ตัวเดียวได้ Smaug Mini จะตอบโจทย์กว่า
ผลลัพธ์ของ benchmark เป็นเพียงจุดเริ่มต้นในการระบุว่าโมเดลใดคุ้มค่าที่จะนำไปประเมินต่อ แต่นักพัฒนาควรทดสอบกับภาระงานจริง (production workloads) เพื่อดูความเสถียรและต้นทุนที่แท้จริงประกอบด้วย
บทสรุป
ซีรีส์ Smaug พิสูจน์ให้เห็นว่าการ fine-tuning อย่างถูกจุดสามารถปิดช่องว่างของโมเดล open-weight ได้อย่างมีนัยสำคัญ โดยแต่ละรุ่นมีความโดดเด่นที่ต่างกันไปตามพื้นฐานเดิม ข้อมูลการประเมินนี้จะช่วยให้นักพัฒนาเลือกโมเดลที่เหมาะสมที่สุดสำหรับแอปพลิเคชัน AI agent ของตนเองได้แม่นยำยิ่งขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร