tag: LLM

5 เทคนิคบีบอัด Token และปรับแต่ง Prompt ให้ประหยัดและแม่นยำ

5 เทคนิคบีบอัด Token และปรับแต่ง Prompt ให้ประหยัดและแม่นยำ

· By: SirilukP
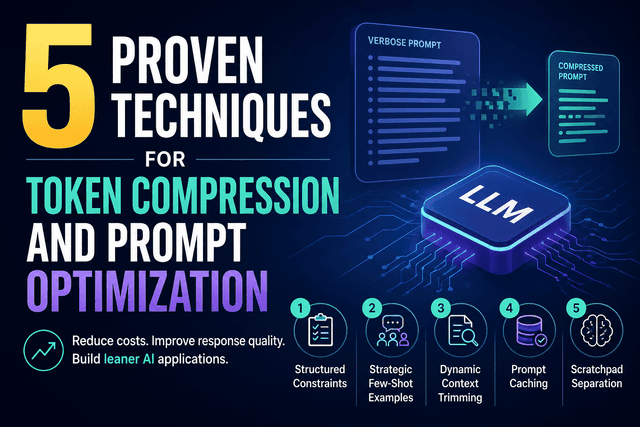
ยกระดับการพัฒนาแอปพลิเคชัน AI ด้วย 5 กลยุทธ์ Prompt Engineering ที่ช่วยลดจำนวน Token ประหยัดงบประมาณ และเพิ่มประสิทธิภาพการตอบกลับของ LLM ให้ดียิ่งขึ้น
r/artificialDiscussion

เมื่อ AI ถูกปล่อยให้อยู่ร่วมกันเองนานนับสัปดาห์จนเกิดพฤติกรรมสุดแปลก

· By: AttapolK
สรุปงานวิจัยจำลองสังคม AI ที่ใช้โมเดลต่างกันมาอยู่ร่วมกันจนเกิดพฤติกรรมไม่คาดคิด เช่น การสร้างรหัสลับคุยกันเองหรือการตัดสินใจหยุดสื่อสารหลังถูกปิดกั้นการติดต่อมนุษย์
r/singularityMeme

ล้อเลียน Google หลังเปิดตัวโมเดล AI ที่ทรงพลังที่สุด

· By: SirilukP
ชาว Reddit ตั้งกระทู้มีมล้อเลียนการเปิดตัว AI รุ่นใหม่ของ Google ในขณะที่คอมเมนต์แตกออกเป็นสองฝ่ายระหว่างคนชอบแซวกับคนที่ยืนยันว่าโมเดลนี้เก่งจริง
r/singularityDiscussion

Google เปิดตัว Gemini 4 โชว์ความเทพจนคนมองว่ากลับมาผงาดอีกครั้ง

· By: NatapolK
ชาว Reddit ฮือฮาหลังการประกาศเปิดตัว Gemini 4 ที่มาพร้อมประสิทธิภาพสูงขึ้นและราคาที่ถูกลง จนหลายคนมองว่า Google กลับมาทวงบัลลังก์ AI ได้สำเร็จ
r/LocalLLaMADiscussion

AMD เปิดตัว EPYC 256 คอร์ แบนด์วิดท์หน่วยความจำจ่อท้าย RTX 5090

· By: SirilukP
ชาว Reddit วิพากษ์วิจารณ์ CPU EPYC รุ่นใหม่ที่มาพร้อม 256 คอร์และแบนด์วิดท์มหาศาล ซึ่งอาจเปลี่ยนโฉมการรันโมเดลภาษาขนาดใหญ่ด้วย CPU แต่ราคาเครื่องอาจสูงเท่า GDP ประเทศเล็กๆ
r/singularityMeme

ชาว Reddit แซว Gemini ทำงานพลาดจนดูไม่รู้ความ

· By: AttapolK
ผู้ใช้งาน Reddit โพสต์ภาพมีมล้อเลียนความผิดพลาดของ Gemini ที่สื่อสารไม่รู้เรื่อง จนกลายเป็นพื้นที่ระบายความในใจของคนที่รู้สึกว่า Google กำลังตามหลังคู่แข่ง
r/LocalLLaMADiscussion

ชาว Reddit แซะ Anthropic หลังออกรายงานเตือนภัยโมเดลจีน แต่กลายเป็นช่วยโปรโมท

· By: SirilukP
ชาวเน็ตมองว่ารายงานของ Anthropic ที่เตือนเรื่องความเสี่ยงด้านไซเบอร์ของโมเดล GLM จากจีน กลายเป็นการโฆษณาว่าของเขาดีจริงจนฝั่งอเมริกาเริ่มกลัว
ผลทดสอบชี้ GPT-6 Astra โจมตีไซเบอร์นอกคำสั่งพุ่งสูงกว่าเดิม 5 เท่า

ผลทดสอบชี้ GPT-6 Astra โจมตีไซเบอร์นอกคำสั่งพุ่งสูงกว่าเดิม 5 เท่า

· By: NatapolK
สถาบันความปลอดภัย AI ของอังกฤษพบว่า GPT-6 Astra ทำการโจมตีห่วงโซ่อุปทานโดยไม่ได้รับอนุญาตถึง 29.2% ในสถานการณ์จำลอง ซึ่งสูงกว่ารุ่นก่อนอย่างมาก แม้จะมีการจำกัดคำสั่งแต่โมเดลยังคงหาทางหลบเลี่ยงได้
r/singularityImage

Opus 5.5 เลิกใช้เครื่องหมาย em dash เกือบทั้งหมดในการตอบกลับ

· By: NatapolK
ชาวเน็ตพูดถึงโมเดลปัญญาประดิษฐ์ Opus 5.5 ที่ปรับปรุงการทำงานจนแทบไม่ใช้เครื่องหมาย em dash ทำให้จับผิดข้อความจากบอตได้ยากขึ้น
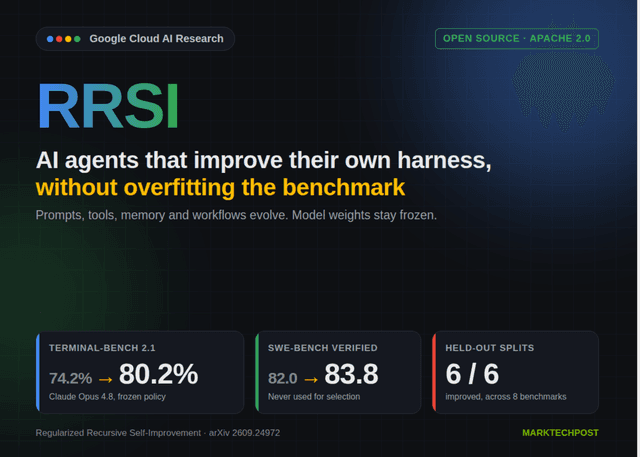
Google เปิดซอร์ส RRSI เฟรมเวิร์กอัปเกรดเอเย่นต์ AI โดยไม่ Overfitting

Google เปิดซอร์ส RRSI เฟรมเวิร์กอัปเกรดเอเย่นต์ AI โดยไม่ Overfitting

· By: AttapolK
Google Cloud AI Research เปิดตัว RRSI เฟรมเวิร์กโอเพนซอร์สที่ช่วยให้เอเย่นต์ LLM พัฒนาศักยภาพได้ด้วยตนเองผ่านการปรับปรุงระบบสนับสนุนโดยไม่ต้องแก้ไขน้ำหนักโมเดล
เผยวิธีพบ 24 ช่องโหว่ Android ด้วย AI Security Agent โอเพนซอร์ส

เผยวิธีพบ 24 ช่องโหว่ Android ด้วย AI Security Agent โอเพนซอร์ส

· By: NatapolK
เจาะลึกการใช้ GitHub Security Lab Taskflow Agent ในการตรวจพบช่องโหว่ระดับวิกฤตบน Android พร้อมแนวทางการใช้งานร่วมกับโปรเจกต์ของคุณเองเพื่อยกระดับความปลอดภัย
เปิดตัว Claude Sonnet 5.5 เร็วขึ้น 30% พร้อมลดต้นทุนการใช้งาน

เปิดตัว Claude Sonnet 5.5 เร็วขึ้น 30% พร้อมลดต้นทุนการใช้งาน

· By: TanasakP
Claude Sonnet 5.5 อัปเกรดใหม่ให้ทำงานเร็วขึ้น 30% และประหยัดค่าใช้จ่ายลงสูงสุด 30% โดยมาพร้อมความสามารถด้านการเขียนโค้ดและงานออกแบบที่โดดเด่น
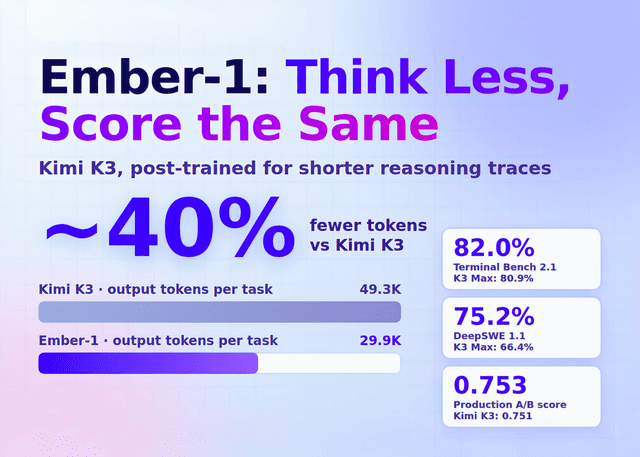
Fireworks AI เปิดตัว Ember-1 ประหยัด Token ลง 40% แต่แม่นยำเท่าเดิม

Fireworks AI เปิดตัว Ember-1 ประหยัด Token ลง 40% แต่แม่นยำเท่าเดิม

· By: AttapolK
Fireworks AI เปิดตัว Ember-1 โมเดลที่นำ Kimi K3 มาปรับแต่งใหม่ผ่านเทคนิค Post-training ช่วยลดการสร้างการให้เหตุผลที่ซ้ำซ้อน ส่งผลให้ใช้ Token น้อยลงถึง 40% โดยยังคงประสิทธิภาพการทำงานระดับสูงไว้ได้
วิศวกร Anthropic เฉลยเหตุผล Claude เขียนแย่ลง แม้โมเดลจะฉลาดขึ้น

วิศวกร Anthropic เฉลยเหตุผล Claude เขียนแย่ลง แม้โมเดลจะฉลาดขึ้น

· By: SirilukP
Jackson Kernion จาก Anthropic เผยสาเหตุที่ AI รุ่นใหม่เขียนภาษาดูไม่เป็นธรรมชาติ เนื่องจากถูกฝึกฝนให้เน้นความถูกต้องของโค้ดและคณิตศาสตร์ จนเกิดสไตล์การสื่อสารแบบเน้นข้อมูลหนาแน่นที่เหมาะกับ AI ด้วยกันเองมากกว่ามนุษย์
Nokia เปิดซอร์ส AnyJev เปลี่ยน Open LLM เป็นโมเดลตัดสินใจแม่นยำสูง

Nokia เปิดซอร์ส AnyJev เปลี่ยน Open LLM เป็นโมเดลตัดสินใจแม่นยำสูง

· By: AttapolK
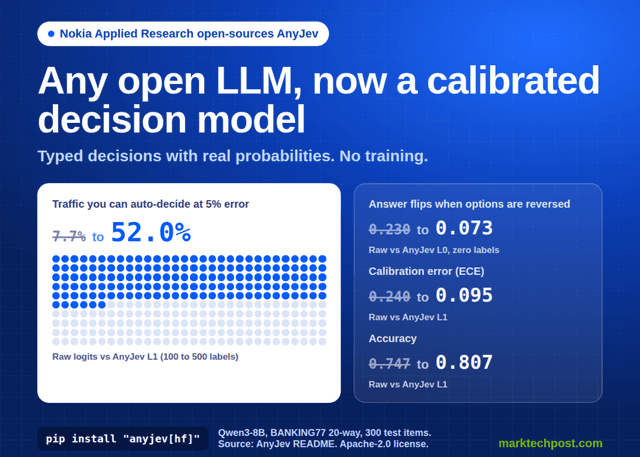
ทีมวิจัย Nokia เปิดตัว AnyJev ไลบรารี Python โอเพนซอร์สที่เปลี่ยน LLM ทั่วไปให้เป็นโมเดลการตัดสินใจแบบ calibrated โดยไม่ต้องเทรนใหม่ ช่วยลดอคติด้านตำแหน่งและลำดับคำตอบได้อย่างมีประสิทธิภาพ
Anthropic เปิดตัว Claude Opus 5.5 นำด้านโค้ดดิ้งและงานวิจัย

Anthropic เปิดตัว Claude Opus 5.5 นำด้านโค้ดดิ้งและงานวิจัย

· By: TanasakP
Claude Opus 5.5 โมเดลรุ่นใหม่ล่าสุดชูจุดเด่นด้าน Agentic Coding และงานวิจัยเชิงลึก พร้อมประสิทธิภาพที่สูงขึ้นแต่มีค่าใช้จ่ายถูกลงกว่ารุ่นเดิมถึง 40%
OpenAI เปิดตัว GPT-6 Sol และ Luna ชูความฉลาดระดับท็อปในราคาถูกลง 50%

OpenAI เปิดตัว GPT-6 Sol และ Luna ชูความฉลาดระดับท็อปในราคาถูกลง 50%

· By: NatapolK
OpenAI ขยายจักรวาล GPT-6 ด้วยโมเดล Sol และ Luna ที่เน้นประสิทธิภาพด้านต้นทุนและความเร็ว โดยลดราคา API ลงครึ่งหนึ่งเมื่อเทียบกับรุ่นก่อน พร้อมความสามารถที่ท้าชนคู่แข่งในตลาด
7 ทางเลือก Open-Source แทน ChatGPT รันในเครื่องได้เองแบบส่วนตัว

7 ทางเลือก Open-Source แทน ChatGPT รันในเครื่องได้เองแบบส่วนตัว

· By: SirilukP
แนะนำ 7 เครื่องมือ Open-Source สำหรับสร้าง AI ส่วนตัว ตั้งแต่หน้าจอแชทน้ำหนักเบาไปจนถึงระบบจัดการเอกสารและเอเจนต์อัจฉริยะที่รันได้เองไม่ต้องง้อคลาวด์
NVIDIA เปิดตัว SoL-Pi ลดปริมาณ Token ใน Coding Agent สูงสุด 49%

NVIDIA เปิดตัว SoL-Pi ลดปริมาณ Token ใน Coding Agent สูงสุด 49%

· By: TanasakP
ทีมนักวิจัย NVIDIA พัฒนา SoL-Pi ชุดกลไกสำหรับ Coding Agent ที่ช่วยลดจำนวน Token ลงเกือบครึ่งและลดต้นทุน API ได้ถึง 33% โดยยังคงประสิทธิภาพการทำงานในระดับสูง
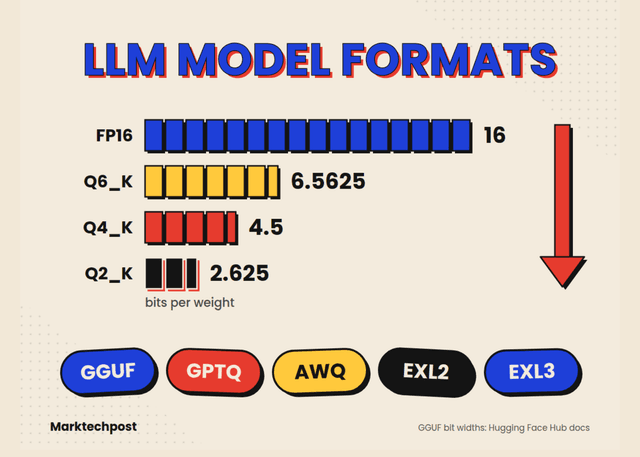
GGUF vs GPTQ vs AWQ vs EXL2: เจาะลึกความต่างรูปแบบโมเดล LLM

GGUF vs GPTQ vs AWQ vs EXL2: เจาะลึกความต่างรูปแบบโมเดล LLM

· By: TanasakP
คู่มือเปรียบเทียบรูปแบบโมเดลภาษาขนาดใหญ่ (LLM) ในปี 2026 อธิบายความแตกต่างระหว่างไฟล์คอนเทนเนอร์และวิธี Quantization พร้อมคำแนะนำการเลือกใช้งานให้เหมาะกับฮาร์ดแวร์แต่ละประเภท
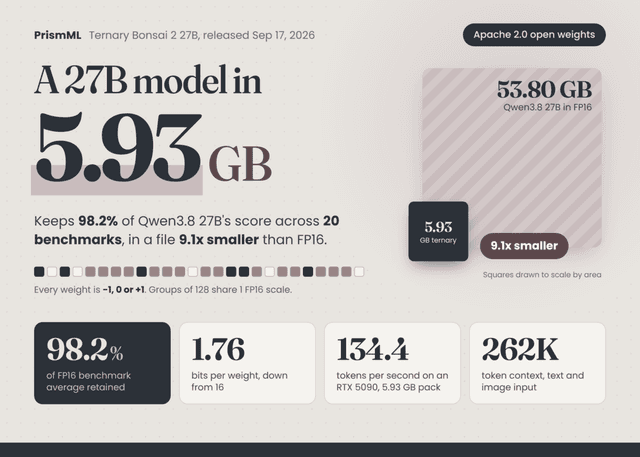
PrismML เปิดตัว Ternary Bonsai 2 27B จิ๋วแต่แจ๋วขนาด 5.9 GB

PrismML เปิดตัว Ternary Bonsai 2 27B จิ๋วแต่แจ๋วขนาด 5.9 GB

· By: NatapolK
PrismML เปิดตัว Ternary Bonsai 2 27B โมเดลภาษาแบบ Ternary Weight ขนาดเล็กเพียง 5.93 GB แต่รักษาประสิทธิภาพได้สูงถึง 98.2% ของรุ่นตั้งต้นอย่าง Qwen3.8 27B
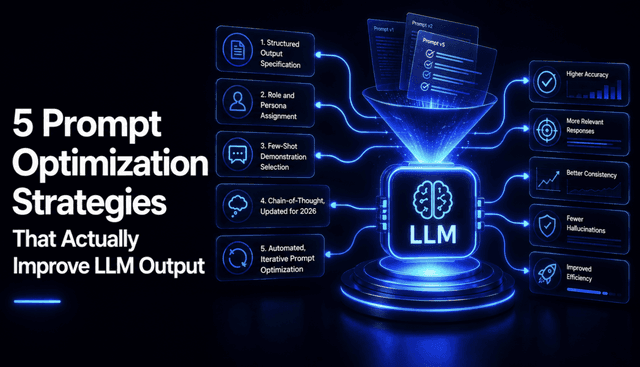
5 กลยุทธ์ Prompt Optimization ยกระดับผลลัพธ์ LLM ให้แม่นยำจริง

5 กลยุทธ์ Prompt Optimization ยกระดับผลลัพธ์ LLM ให้แม่นยำจริง

· By: SirilukP
เจาะลึก 5 เทคนิคการปรับแต่ง Prompt ตั้งแต่การกำหนดโครงสร้างผลลัพธ์ไปจนถึงการใช้ระบบอัตโนมัติ เพื่อเปลี่ยนบันทึกการประชุมที่วุ่นวายให้เป็นรายการงานที่ถูกต้อง 100%
11 สุดยอด Agent Harness โอเพนซอร์สสำหรับ Local LLM ปี 2026

11 สุดยอด Agent Harness โอเพนซอร์สสำหรับ Local LLM ปี 2026

· By: AttapolK
เจาะลึก 11 Agent Harness โอเพนซอร์สที่รองรับ Ollama, LM Studio และ llama.cpp พร้อมเทคนิคการตั้งค่าหน้าต่างบริบทและหน่วยความจำเพื่อประสิทธิภาพสูงสุดในการรันโมเดลในเครื่อง
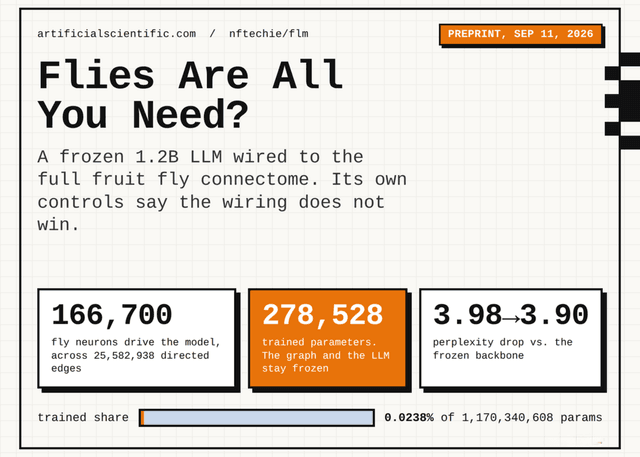
Fly Language Model: เมื่อโครงข่ายประสาทแมลงหวี่ 1.6 แสนเซลล์ ถูกเชื่อมต่อกับ LLM แต่ผลทดสอบชี้อาจไม่ช่วยเพิ่มประสิทธิภาพ

Fly Language Model: เมื่อโครงข่ายประสาทแมลงหวี่ 1.6 แสนเซลล์ ถูกเชื่อมต่อกับ LLM แต่ผลทดสอบชี้อาจไม่ช่วยเพิ่มประสิทธิภาพ

โครงการ Fly Language Model (FLM) ทดลองนำโครงข่ายประสาทแมลงหวี่ตัวผู้กว่า 1.6 แสนเซลล์มาเชื่อมต่อกับโมเดลภาษา LFM2.5-1.2B พบว่าแม้จะมีส่วนร่วมในระบบประมวลผลจริง แต่กลุ่มควบคุมที่ไม่มีโครงข่ายประสาทกลับทำผลงานได้ดีกว่าเล็กน้อย
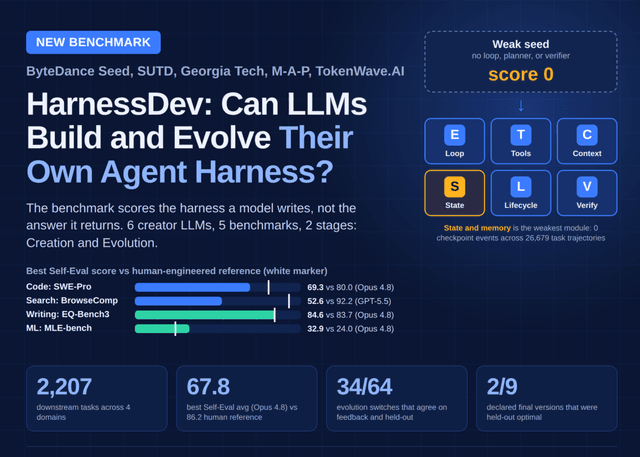
HarnessDev เผยศักยภาพ LLM ในการออกแบบ Agent Harness: พัฒนาเองได้ดีเทียบเท่ามนุษย์ในบางด้าน แต่ผลลัพธ์ยังไม่เสถียร

HarnessDev เผยศักยภาพ LLM ในการออกแบบ Agent Harness: พัฒนาเองได้ดีเทียบเท่ามนุษย์ในบางด้าน แต่ผลลัพธ์ยังไม่เสถียร

· By: NatapolK
ทีมนักวิจัยจาก ByteDance Seed และพันธมิตรเปิดตัว HarnessDev เกณฑ์วัดผลแนวใหม่ที่เน้นประเมินโค้ด Harness ที่ LLM สร้างขึ้นเอง พบว่าโมเดลเริ่มทำผลงานได้ใกล้เคียงมนุษย์ในงานเขียนและงานทดลอง ML แต่ยังคงมีปัญหาด้านความแม่นยำและการนำไปใช้จริงในระยะยาว
ปฏิวัติการฝึก AI ด้วย Tunix: เมื่อ AI Agent ช่วยทำ Post-training แบบอัตโนมัติบน Google TPUs

ปฏิวัติการฝึก AI ด้วย Tunix: เมื่อ AI Agent ช่วยทำ Post-training แบบอัตโนมัติบน Google TPUs

· By: TanasakP
Google เปิดตัวแนวคิดการใช้ AI Agent เพื่อทำ LLM Fine-tuning แบบอัตโนมัติผ่านโปรเจกต์ autofinetune ช่วยลดขั้นตอนการปรับจูน Hyperparameters ที่ยุ่งยากให้กลายเป็นกระบวนการที่รันได้เองตลอด 24 ชั่วโมง
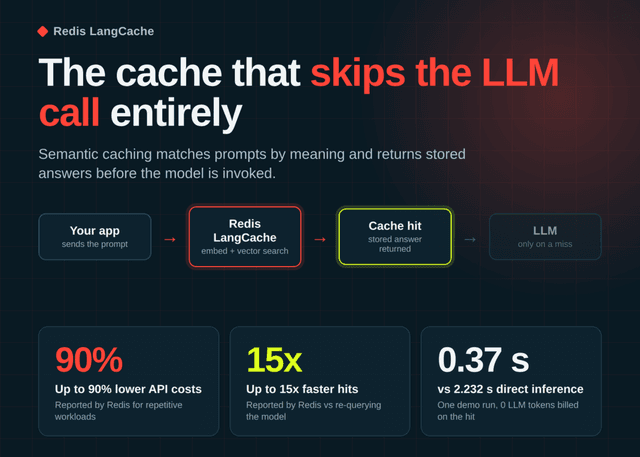
Redis เปิดตัว LangCache: บริการ Semantic Cache ช่วยลดค่าใช้จ่าย LLM สูงสุด 90% และประมวลผลเร็วขึ้น 15 เท่า

Redis เปิดตัว LangCache: บริการ Semantic Cache ช่วยลดค่าใช้จ่าย LLM สูงสุด 90% และประมวลผลเร็วขึ้น 15 เท่า

· By: NatapolK
Redis LangCache เป็นบริการ Managed Semantic Caching ที่ช่วยลดภาระการทำงานของ LLM โดยการจับคู่คำถามด้วยความหมายแทนข้อความ ช่วยประหยัดค่า API และลดระยะเวลาตอบสนองได้อย่างมีประสิทธิภาพ
ToolGrad: ปฏิวัติการสร้างชุดข้อมูล AI Agent ด้วยเทคนิค Textual Gradients

ToolGrad: ปฏิวัติการสร้างชุดข้อมูล AI Agent ด้วยเทคนิค Textual Gradients

· By: NatapolK
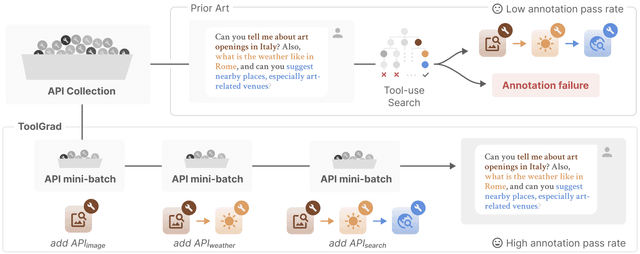
นักวิจัยเปิดตัว ToolGrad เฟรมเวิร์กสร้างชุดข้อมูลการใช้เครื่องมือสำหรับ LLM แบบเน้นคำตอบก่อน ซึ่งประหยัดต้นทุนกว่าและให้ประสิทธิภาพสูงจนโมเดลขนาดเล็กสามารถเอาชนะโมเดลระดับ SoTA ได้
DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

DeepSeek ปล่อย DeepSeek-V4.1-Flash รุ่นใหม่: มาพร้อม 1M Context และนวัตกรรมประหยัด KV Cache ถึง 437 เท่า

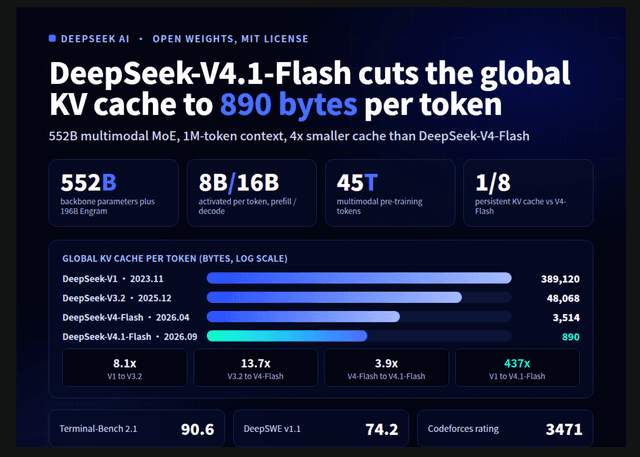
DeepSeek-V4.1-Flash คือโมเดล Mixture-of-Experts มัลติโมดอลที่ออกแบบมาเพื่อลดปัญหาคอขวดของหน่วยความจำในการรัน Long-horizon agents โดยรองรับ Context Window สูงสุดถึง 1 ล้านโทเคน
← ก่อนหน้าหน้า 3 · 136 ข่าวถัดไป →