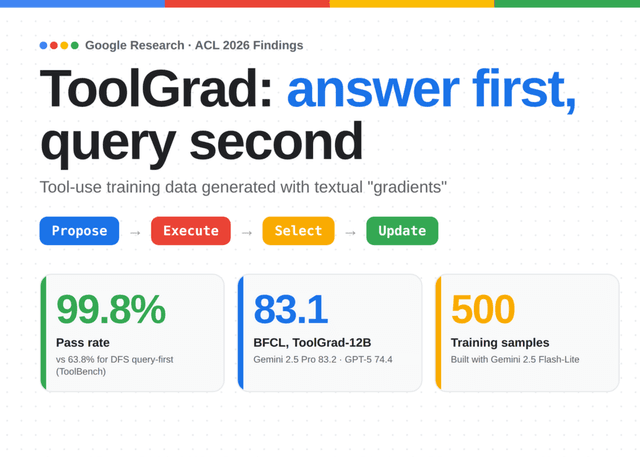
Google Research พัฒนา ToolGrad เฟรมเวิร์กที่พลิกกระบวนการสร้างชุดข้อมูล tool-use โดยตรวจสอบ API chain ก่อนเขียน query ส่งผลให้ Gemma-3-12B ที่ถูกฝึกด้วยข้อมูลเพียง 500 ชุด มีประสิทธิภาพเทียบเท่า Gemini 2.5 Pro
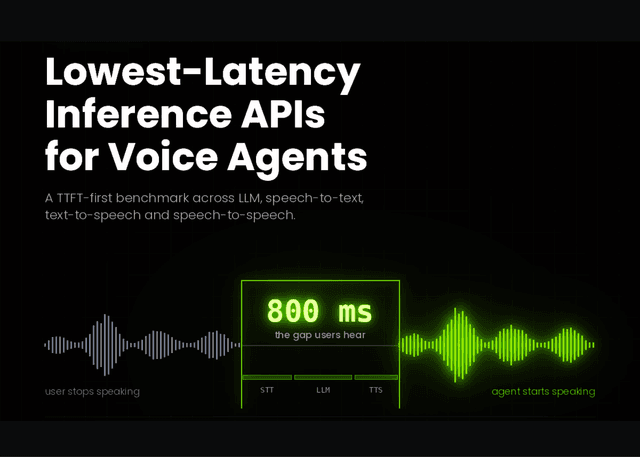
เจาะลึกประสิทธิภาพ Voice Stack ทุกเลเยอร์ตั้งแต่ LLM ถึง Speech-to-Speech พร้อมชี้ให้เห็นว่า Time to First Token (TTFT) อาจไม่ใช่มาตรวัดที่สะท้อนประสบการณ์ผู้ใช้จริงได้ดีเท่ากับความเร็วในการสร้างประโยค
ผลการศึกษาใหม่พบว่าผู้ช่วยเขียนโค้ด AI อย่าง Claude Code และ Codex ขาดความเข้าใจเรื่องเวลาและประเมินผลงานตัวเองสูงเกินจริง ซึ่งเป็นความท้าทายสำคัญในการกำกับดูแลงานอัตโนมัติระยะยาว
CTO ของ Pangram ระบุว่าระบบป้องกันหลังการฝึกฝน (Post-training) ทำให้ AI แสดงออกได้จำกัดจนเกิดภาวะ mode collapse ซึ่งต่างจาก Base model ที่มีความหลากหลายของภาษาจนยากต่อการตรวจจับ
IBM Research พบว่าการใส่ความจำหรือคำแนะนำให้เอเจนท์ AI ไม่ได้ยิ่งมากยิ่งดีเสมอไป แต่ต้องปรับปริมาณยาให้เหมาะสมกับระดับความฉลาดของโมเดลแต่ละรุ่นเพื่อประสิทธิภาพสูงสุดและต้นทุนที่ต่ำลง
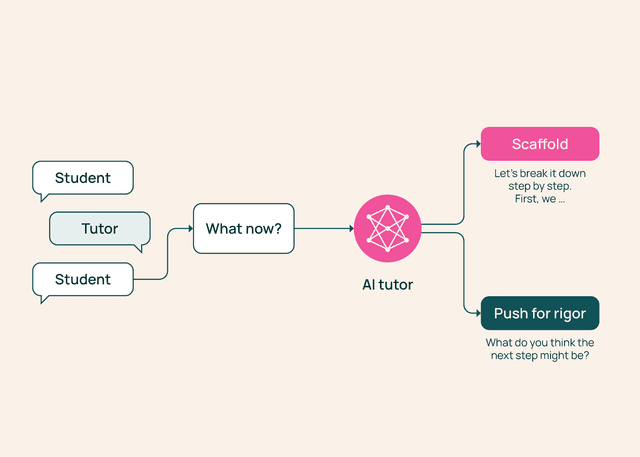
Allen Institute for AI เปิดตัว TutorMoments พรีวิวเฟรมเวิร์กสำหรับประเมินโมเดลภาษา (LLMs) ในบทบาทครูสอนพิเศษ โดยเน้นจุดตัดสินใจสำคัญว่าโมเดลควรยื่นมือเข้าช่วยหรือผลักดันให้นักเรียนใช้ความคิดด้วยตัวเอง