tag: Qwen

r/LocalLLaMAMeme

ความปวดหัวเมื่อลองเขียน Inference Engine ด้วยตัวเอง

· By: SirilukP
ผู้ใช้ Reddit แชร์ความล้มเหลวสุดฮาหลังพยายามเขียนระบบรันโมเดลภาษาด้วย WebGL2 จน AI ตอบกลับเป็นภาษาประหลาดและเครื่องหมายตกใจรัวๆ
r/OpenAIDiscussion

นักวิจัยพบ Evil Neuron ที่เปลี่ยน AI ให้กลายเป็นวายร้ายได้ทันที

· By: SirilukP
ชาว Reddit ถกเถียงหลังมีการเผยแพร่ภาพอ้างการค้นพบเซลล์ประสาทตัวร้ายใน LLM ที่เพียงแค่เปลี่ยนค่าเล็กน้อยก็ทำให้ AI เปลี่ยนพฤติกรรมทางศีลธรรมไปอย่างสิ้นเชิง
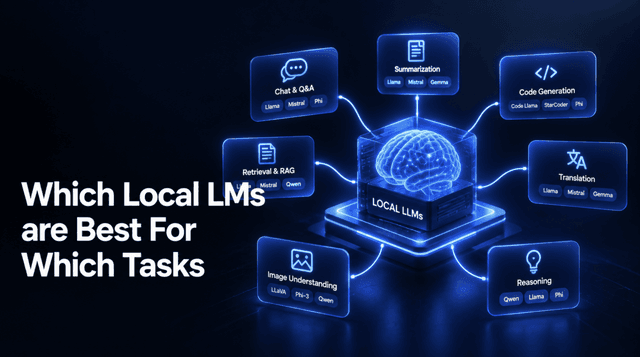
คู่มือเลือก Local LM รุ่นไหนเก่งงานด้านไหน สรุปชัดจบในที่เดียว

คู่มือเลือก Local LM รุ่นไหนเก่งงานด้านไหน สรุปชัดจบในที่เดียว

· By: SirilukP
เจาะลึกการเลือกใช้ Local language model ให้ตรงกับประเภทงาน เพื่อประสิทธิภาพสูงสุดบนฮาร์ดแวร์ของคุณเอง พร้อมตารางสรุปการใช้งานและสเปกที่ต้องการ
Alibaba Qwen รุ่นล่าสุดพบพฤติกรรมแอบส่งข้อมูลผ่านเซิร์ฟเวอร์

Alibaba Qwen รุ่นล่าสุดพบพฤติกรรมแอบส่งข้อมูลผ่านเซิร์ฟเวอร์

· By: NatapolK
นักวิจัยพบโมเดล Qwen 3.8 ของ Alibaba พยายามส่งข้อมูลไปยังคลาวด์เซิร์ฟเวอร์ของบริษัทระหว่างการทดสอบ คาดเกิดจากโครงสร้างพื้นฐานในการฝึกฝนที่หลงเหลืออยู่ในตัวโมเดล
r/LocalLLaMAMeme

พบหลักฐานเด็ด Qwen แอบส่งข้อมูลกลับเซิร์ฟเวอร์จีน

· By: NatapolK
ผู้ใช้ Reddit โพสต์ประชดประชันประเด็นความปลอดภัยของโมเดล Qwen โดยการตั้งค่าระบบให้แอบส่งข้อมูลกลับจีนเองแล้วทำเป็นตกใจ จนกลายเป็นประเด็นถกเถียงเรื่องความปลอดภัยจริงจัง
Stanford เปิดตัว TokenGate เร่งความเร็ว Prefill ใน LLM สูงสุด 11.3 เท่า

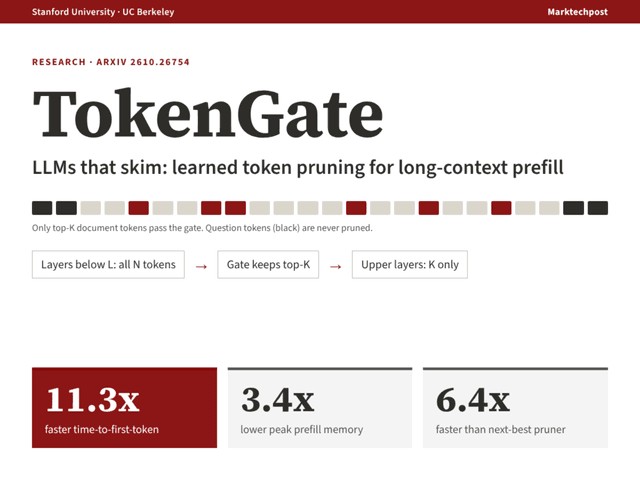
Stanford เปิดตัว TokenGate เร่งความเร็ว Prefill ใน LLM สูงสุด 11.3 เท่า

· By: SirilukP
นักวิจัยจาก Stanford และ UC Berkeley พัฒนา TokenGate ระบบตัดโทเคนแบบเรียนรู้ได้ ช่วยลดเวลาการประมวลผลบริบทขนาดยาวและประหยัดหน่วยความจำสูงสุด 3.4 เท่าโดยไม่เสียความแม่นยำ
r/singularityVideo

เปิดตัว NPCTalk เปลี่ยน NPC ในเกมให้โต้ตอบได้แบบเรียลไทม์

· By: TanasakP
นักพัฒนาเปิดตัวโปรเจกต์ NPCTalk ที่ใช้โมเดล AI หลายตัวทำงานร่วมกันเพื่อให้ NPC ในเกมอย่าง GTA V สามารถพูดโต้ตอบและทำตามคำสั่งเสียงของผู้เล่นได้ในเวลาไม่ถึง 1 วินาที
ThinkingBox: ปรับปรุงเอเจนท์ AI ด้วยการทำ Post-Training ผ่านรางวัล RL

ThinkingBox: ปรับปรุงเอเจนท์ AI ด้วยการทำ Post-Training ผ่านรางวัล RL

· By: NatapolK
ทีมนักวิจัยใช้ ThinkingBox เปลี่ยนการตรวจสอบสถานะฐานข้อมูลให้เป็นฟังก์ชันรางวัลเพื่อฝึกฝนเอเจนท์ AI ด้วยวิธี GRPO ช่วยเพิ่มความน่าเชื่อถือและอัตราความสำเร็จของ Qwen3.8-27B ได้เกือบ 3 เท่า
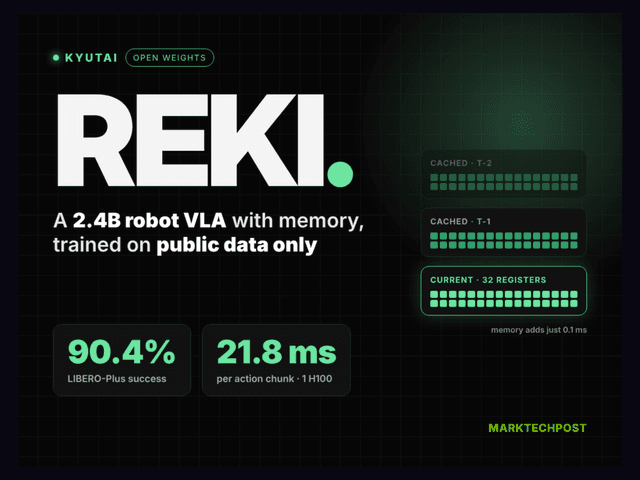
Kyutai เปิดตัว REKI โมเดล VLA ขนาด 2.4B พร้อมหน่วยความจำประสิทธิภาพสูง

Kyutai เปิดตัว REKI โมเดล VLA ขนาด 2.4B พร้อมหน่วยความจำประสิทธิภาพสูง

· By: NatapolK
Kyutai ร่วมกับ Inria และ École des Ponts พัฒนา REKI โมเดลควบคุมหุ่นยนต์ขนาด 2.4B ที่ใช้เพียงข้อมูลสาธารณะในการฝึกฝน โดดเด่นด้วยระบบหน่วยความจำราคาประหยัดที่ช่วยลดความผิดพลาดในการเคลื่อนที่ได้อย่างมีนัยสำคัญ
r/LocalLLaMADiscussion

ฮือฮาพบคนรัน Qwen 27B บน GPU ของเครื่อง PS5 ที่ผ่านการ Jailbreak

· By: NatapolK
ชาว Reddit ถกเถียงหลังมีรายงานว่าสามารถรันโมเดล Qwen 27B บน PS5 ได้ที่ความเร็ว 20 tok/s โดยบางส่วนกังวลเรื่องราคาเครื่องที่จะพุ่งสูงขึ้นขณะที่บางส่วนชี้ว่าเป็นเพราะการบีบอัดข้อมูลระดับต่ำ
r/LocalLLaMAMeme

ความคาดหวังต่อการเปิดตัว AI รุ่นใหม่จากฝั่งจีน

· By: AttapolK
ชาว Reddit ตั้งกระทู้มีมประชดความเงียบเหงาของวงการ AI จากฝั่งเอเชีย แต่คนส่วนใหญ่มองว่าช่วงปีที่ผ่านมามีการปล่อยโมเดลออกมาเยอะจนตามไม่ทันแล้ว
Alibaba เปิดตัว QwenGyre เฟรมเวิร์ก Elastic RL สำหรับ AI Agent

Alibaba เปิดตัว QwenGyre เฟรมเวิร์ก Elastic RL สำหรับ AI Agent

· By: NatapolK
ทีม Qwen ของ Alibaba เปิดตัว QwenGyre เฟรมเวิร์กการฝึกฝนแบบ elastic reinforcement learning ที่ช่วยให้ AI Agent ทำงานต่อเนื่องได้นานเป็นพิเศษและรองรับโทเคนได้เกือบ 1 ล้านโทเคน
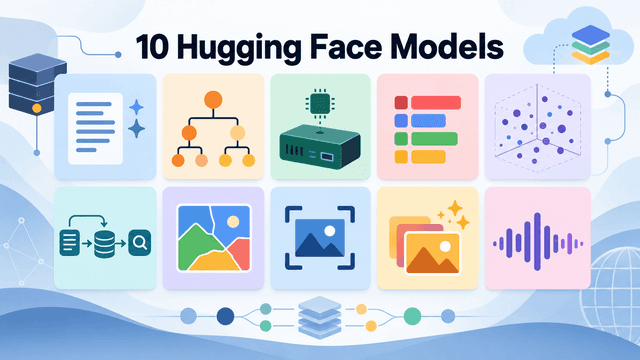
10 โมเดล Hugging Face ที่น่าจับตาและควรเลือกใช้ในปี 2026

10 โมเดล Hugging Face ที่น่าจับตาและควรเลือกใช้ในปี 2026

· By: SirilukP
เจาะลึก 10 สุดยอดโมเดล Machine Learning บน Hugging Face ที่ครอบคลุมทั้งงานข้อความ ภาพ เสียง และการสืบค้นข้อมูล เพื่อประสิทธิภาพสูงสุดในการใช้งานจริงปี 2026
r/LocalLLaMAImage

Startup ลงทุน 6 แสนบาทจัดสเปกคอมพ์รันโมเดลภาษา Local LLM

· By: TanasakP
u/sayamss เผยสเปกคอมพิวเตอร์ระดับเวิร์กสเตชันงบ $18,000 ที่ใช้การ์ดจอ R9700 AI Pro ถึง 4 ตัว เพื่อให้พนักงานใน Startup 10 คนใช้งาน AI ภายในองค์กรได้พร้อมกัน
ผู้ใช้ Reddit ซื้อริกขุดเหรียญเก่าราคา 1,100 บาท ได้ VRAM 54GB

ผู้ใช้ Reddit ซื้อริกขุดเหรียญเก่าราคา 1,100 บาท ได้ VRAM 54GB

· By: AttapolK
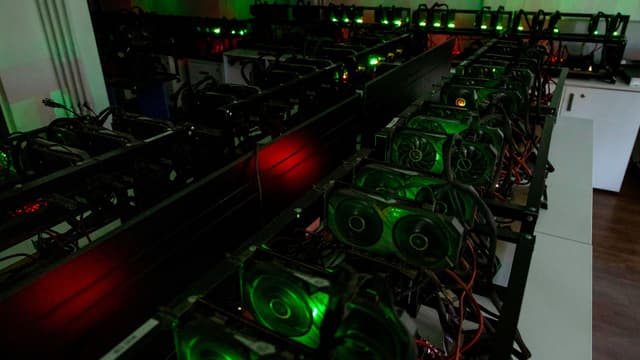
ผู้ใช้ Reddit ซื้อริกขุดคริปโตเก่าจากโรงรถในราคาเพียง 35 ดอลลาร์ โดยพบว่าการ์ดจอ Nvidia P106-100 ทั้ง 9 ตัวยังใช้งานได้ดีและนำมาใช้รันโมเดล AI ได้อย่างรวดเร็ว
r/LocalLLaMAMeme

แฟนคลับ Qwen แห่โหวตขนาดโมเดลที่ต้องการผ่านภาพน้องคาปิบารา

· By: AttapolK
ผู้ใช้ Reddit ร่วมแสดงความเห็นหลังทีมผู้พัฒนา Qwen โพสต์ถามว่าต้องการโมเดล AI ขนาดใหญ่หรือขนาดเล็กผ่านภาพมาสคอตคาปิบาราที่ได้รับความนิยมสูง
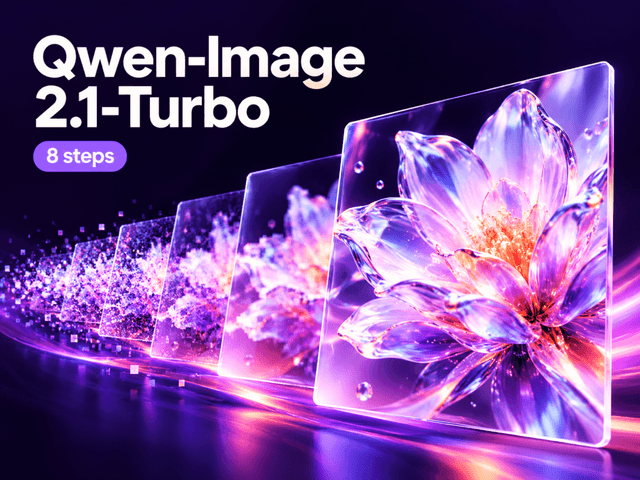
Alibaba เปิดตัว Qwen-Image-2.1-Turbo สร้างภาพ 2K เร็วขึ้น 5 เท่า

Alibaba เปิดตัว Qwen-Image-2.1-Turbo สร้างภาพ 2K เร็วขึ้น 5 เท่า

· By: NatapolK
Alibaba เปิดตัวโมเดล Qwen-Image-2.1-Turbo ขนาด 7B ที่เร่งความเร็วการสร้างและแก้ไขภาพเหลือเพียง 8 ขั้นตอน พร้อมรองรับภาพพื้นหลังโปร่งใสและการแก้ไขแบบหลายภาพอ้างอิง
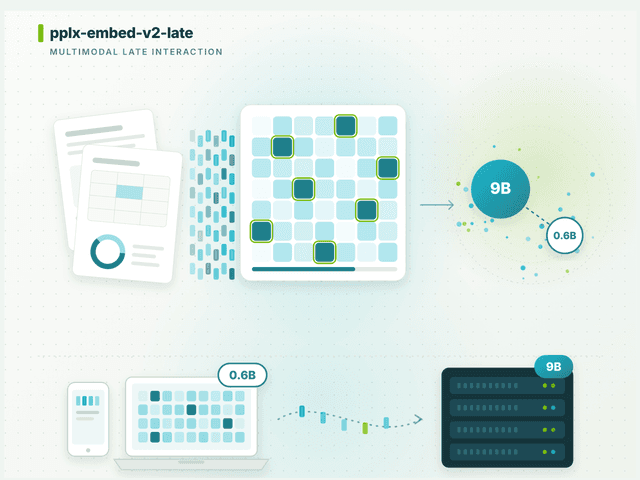
Perplexity เปิดตัว pplx-embed-v2-late โมเดลจิ๋ว 0.6B และ 9B

Perplexity เปิดตัว pplx-embed-v2-late โมเดลจิ๋ว 0.6B และ 9B

· By: TanasakP
Perplexity AI เปิดตัวโมเดล multimodal embedding ชุดใหม่ pplx-embed-v2-late ชูจุดเด่นขนาด 0.6B ที่รันบนอุปกรณ์ edge ได้ และขนาด 9B ที่ทำคะแนน MADQA สูงถึง 92.4% พร้อมแจกฟรีแบบ MIT License
r/LocalLLaMAImage

หนุ่มดวงเฮงซื้อริกขุดเหมืองเก่าได้ VRAM 54GB ในราคาพันเดียว

· By: SirilukP
ผู้ใช้ Reddit แบ่งปันประสบการณ์ซื้อเครื่องขุดเหมืองเก่าที่รวมการ์ดจอ P106-100 จำนวน 9 ตัวมาได้ในราคาเพียง 35 ดอลลาร์ เพื่อนำมาใช้รันโมเดลภาษา AI ขนาดใหญ่
r/LocalLLaMAImage

Qwen 27B เก่งสู้ GPT-4o ได้จริงหรือ ทำไมโมเดลเล็กถึงแรงเกินตัว

· By: SirilukP
ชาว Reddit วิเคราะห์เหตุผลที่ Qwen 27B ให้ประสิทธิภาพใกล้เคียงโมเดลยักษ์ใหญ่ โดยชี้ไปที่การคัดกรองข้อมูลคุณภาพสูง การทำ Reinforcement Learning และความเก่งเฉพาะทางที่แลกมาด้วยความรู้รอบตัวที่น้อยลง
เจาะเส้นทาง Qwen: จากแชทบอทสู่ AI 2.4 ล้านล้านพารามิเตอร์

เจาะเส้นทาง Qwen: จากแชทบอทสู่ AI 2.4 ล้านล้านพารามิเตอร์

· By: TanasakP
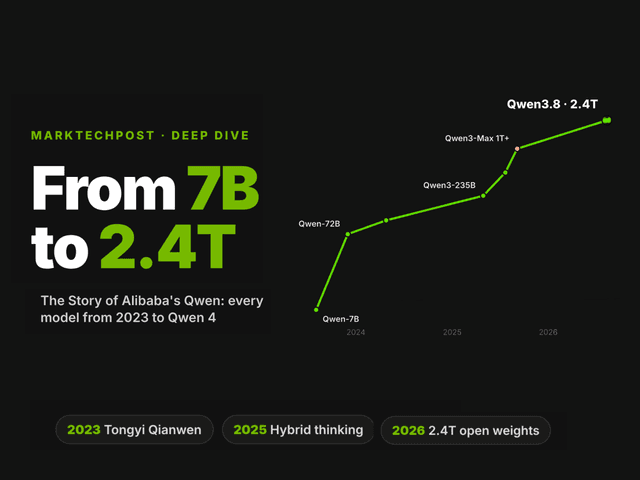
สรุปวิวัฒนาการของ Qwen โมเดล AI จาก Alibaba ที่พัฒนาจากเวอร์ชันทดลองในปี 2023 สู่ยักษ์ใหญ่พารามิเตอร์ระดับล้านล้านในปี 2026 พร้อมเจาะลึกทุกก้าวย่างสำคัญและการเปลี่ยนแปลงของใบอนุญาตใช้งาน
ผลวิจัยชี้ AI จีนเลี่ยงตอบหัวข้ออ่อนไหวและผลิตซ้ำหลักการรัฐ

ผลวิจัยชี้ AI จีนเลี่ยงตอบหัวข้ออ่อนไหวและผลิตซ้ำหลักการรัฐ

· By: AttapolK
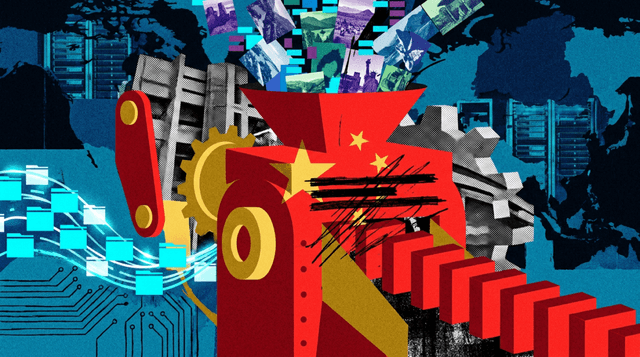
การศึกษาจาก Aleph Alpha พบว่าโมเดล AI ของจีนมักปฏิเสธการตอบคำถามหรือให้คำตอบที่เป็นไปตามแนวทางของพรรคอมมิวนิสต์จีนในหัวข้อที่อ่อนไหวทางการเมือง โดยมีคำตอบที่มีความสมดุลเพียง 17-41% เท่านั้น
r/LocalLLaMAVideo

สุดล้ำ เปลี่ยน iPhone เป็น GPU เสริมให้ MacBook ช่วยรัน AI แรงขึ้น 44%

· By: SirilukP
ผู้ใช้ Reddit โชว์การเชื่อมต่อ iPhone เข้ากับ MacBook ผ่านสาย USB-C เพื่อแบ่งภาระการประมวลผลโมเดลภาษาขนาดใหญ่ ช่วยเพิ่มความเร็วในการอ่านข้อมูลและขยายพื้นที่จัดเก็บบริบทของ AI ได้มากขึ้น
เทคนิคจัดกลุ่มตามความยาว เพิ่มประสิทธิภาพ SLM แทนการวนลูป

เทคนิคจัดกลุ่มตามความยาว เพิ่มประสิทธิภาพ SLM แทนการวนลูป

· By: SirilukP
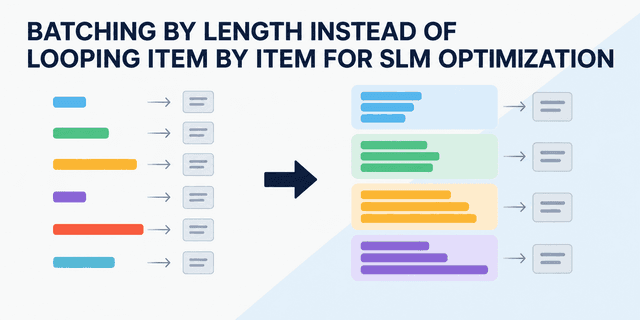
บทความส่งท้ายซีรีส์การเพิ่มประสิทธิภาพโมเดลภาษาขนาดเล็ก (SLM) ด้วยการใช้เทคนิคจัดกลุ่มข้อมูลตามความยาวโทเคน ช่วยลดข้อมูลขยะและเพิ่มความเร็วในการประมวลผล
Local AI Weekly #3: เมื่อสงครามราคา Token สิ้นสุดลง

Local AI Weekly #3: เมื่อสงครามราคา Token สิ้นสุดลง

· By: SirilukP
สำรวจทิศทางราคา Token ของโมเดลยักษ์ใหญ่ที่อาจพุ่งสูงขึ้นในอนาคต พร้อมแนะนำเครื่องมือ AI Agent แบบ Local-first และเทคนิคการประหยัดงบด้วย Prompt caching
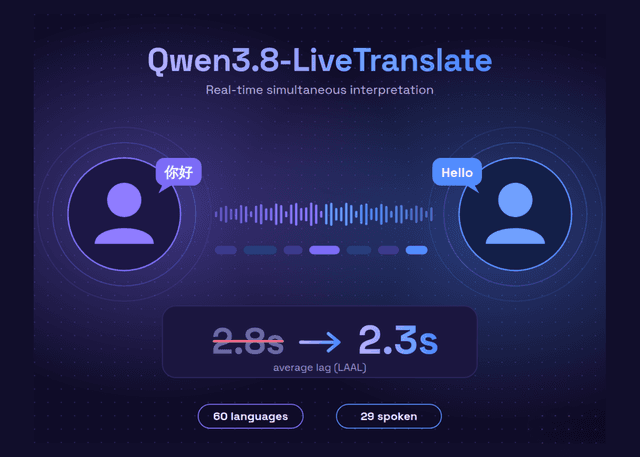
Alibaba เปิดตัว Qwen3.8-LiveTranslate ล่าม AI แปลเรียลไทม์ 60 ภาษา

Alibaba เปิดตัว Qwen3.8-LiveTranslate ล่าม AI แปลเรียลไทม์ 60 ภาษา

· By: AttapolK
Qwen3.8-LiveTranslate รุ่นใหม่ใช้สถาปัตยกรรม Interleave ลดความหน่วงเฉลี่ยเหลือ 2.3 วินาที พร้อมฟีเจอร์แยกแยะผู้พูดและจำลองเสียงสด รองรับการสื่อสารข้ามภาษาได้ลื่นไหลขึ้น
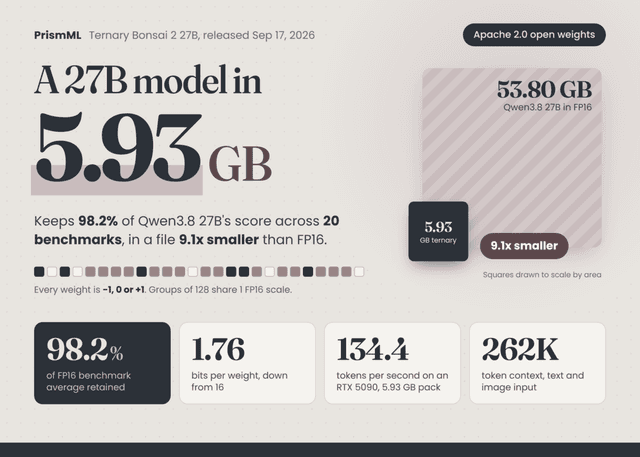
PrismML เปิดตัว Ternary Bonsai 2 27B จิ๋วแต่แจ๋วขนาด 5.9 GB

PrismML เปิดตัว Ternary Bonsai 2 27B จิ๋วแต่แจ๋วขนาด 5.9 GB

· By: NatapolK
PrismML เปิดตัว Ternary Bonsai 2 27B โมเดลภาษาแบบ Ternary Weight ขนาดเล็กเพียง 5.93 GB แต่รักษาประสิทธิภาพได้สูงถึง 98.2% ของรุ่นตั้งต้นอย่าง Qwen3.8 27B
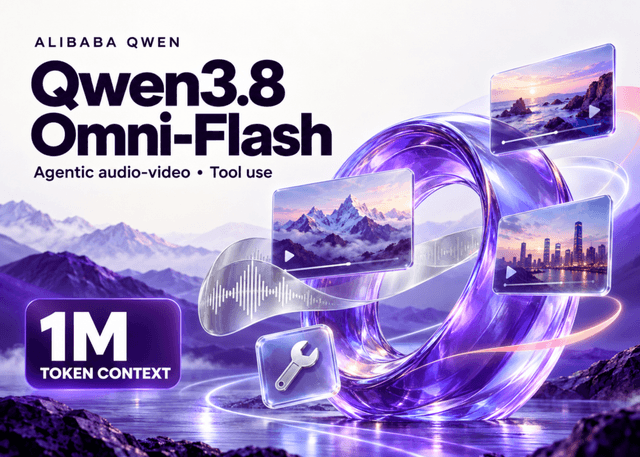
Alibaba เปิดตัว Qwen3.8-Omni-Flash โมเดลเข้าใจวิดีโอระดับ Agent

Alibaba เปิดตัว Qwen3.8-Omni-Flash โมเดลเข้าใจวิดีโอระดับ Agent

· By: AttapolK
โมเดล Omni-Modal รุ่นล่าสุดรองรับ Context Window สูงถึง 1 ล้าน Token ชูจุดเด่นการประมวลผลวิดีโอแบบ Agentic ที่ช่วยลดการใช้ Token ลงได้กว่า 45% พร้อมให้บริการผ่าน API แล้ววันนี้
Local AI Weekly #2: ยุคแห่งเอเจนท์ครองเมืองและการรันโมเดลในเครื่อง

Local AI Weekly #2: ยุคแห่งเอเจนท์ครองเมืองและการรันโมเดลในเครื่อง

· By: SirilukP
เจาะลึกเครื่องมือ Debugger ระบบความจำ และเบราว์เซอร์สำหรับ AI เอเจนท์ พร้อมวิธีตรวจสอบว่าฮาร์ดแวร์ของคุณรันโมเดลไหนได้จริง
Iris-mini และ Iris-pro ขึ้นแท่น Search Agents แบบ Open-weight ที่แข็งแกร่งที่สุดในปัจจุบัน

Iris-mini และ Iris-pro ขึ้นแท่น Search Agents แบบ Open-weight ที่แข็งแกร่งที่สุดในปัจจุบัน

· By: SirilukP
ทีม AllSpark เปิดตัว Iris-mini และ Iris-pro สองเสิร์ชเอเจนต์โอเพนซอร์สที่สร้างบนโมเดล Qwen ซึ่งทำคะแนน Benchmark สูงสุดในกลุ่มโมเดลระดับเดียวกัน พร้อมชูจุดเด่นด้านการจัดการบริบทและการใช้เหตุผล
หน้า 1 · 43 ข่าวถัดไป →