tag: Machine Learning

Fastino เปิดตัว GLiNER2.5 สถาปัตยกรรมสกัดข้อมูลรูปแบบใหม่ ยกเลิก Span Enumeration เพื่อประสิทธิภาพสูงสุด

Fastino เปิดตัว GLiNER2.5 สถาปัตยกรรมสกัดข้อมูลรูปแบบใหม่ ยกเลิก Span Enumeration เพื่อประสิทธิภาพสูงสุด

Fastino เปิดตัว GLiNER2.5 ที่เปลี่ยนมาใช้การทำนายขอบเขต (boundary prediction) ช่วยลดภาระการคำนวณและรองรับบริบทได้ถึง 4,096 คำ โดยปล่อย checkpoint ขนาดเล็กที่รันบน CPU ได้ภายใต้ลิขสิทธิ์ Apache 2.0
สร้างโปรเจกต์ Data Science แบบ End-to-End ด้วย Grok Build และโมเดลใหม่ Grok 4.6

สร้างโปรเจกต์ Data Science แบบ End-to-End ด้วย Grok Build และโมเดลใหม่ Grok 4.6

· By: SirilukP
เจาะลึกการใช้ Grok Build เอเจนต์การเขียนโค้ดล่าสุดจาก xAI เพื่อสร้างเวิร์กโฟลว์ Data Science ครบวงจร ตั้งแต่การทำ EDA เทรนโมเดลด้วย scikit-learn ไปจนถึงการติดตั้ง API บนคลาวด์
งานวิจัยชี้ AI Agents ทำงานดีขึ้นจาก 'ระบบจัดการทักษะ' แต่คลังข้อมูลที่ใหญ่เกินไปอาจทำพิษ

งานวิจัยชี้ AI Agents ทำงานดีขึ้นจาก 'ระบบจัดการทักษะ' แต่คลังข้อมูลที่ใหญ่เกินไปอาจทำพิษ

ทีมนักวิจัยจาก Princeton และ UC San Diego พบว่า AI agents มีประสิทธิภาพสูงขึ้นจากเวิร์กโฟลว์ที่มีโครงสร้างชัดเจน ไม่ใช่การเพิ่มพูนความรู้ แต่เตือนว่าหากคลังทักษะมีขนาดใหญ่เกินไปอาจทำให้ระบบสับสนในการเลือกคำสั่ง
เผยกลยุทธ์ 'Benchmaxxing': เมื่อโมเดล AI จดจำเสียงเริ่ม 'เดาข้อสอบ' จนคะแนนสูงเกินจริง

เผยกลยุทธ์ 'Benchmaxxing': เมื่อโมเดล AI จดจำเสียงเริ่ม 'เดาข้อสอบ' จนคะแนนสูงเกินจริง

งานวิจัยพบว่าโมเดล AI จดจำเสียงชื่อดังหลายตัวอาจถูกปรับแต่งให้ทำคะแนนเบนช์มาร์กได้สูงเกินจริง โดยใช้วิธีเลียนแบบข้อผิดพลาดหรือรูปแบบการเขียนเฉพาะในชุดข้อมูลทดสอบแทนการฟังเสียงจริงๆ
รู้จัก S1-mini: โมเดล Open-Weights ขนาด 462 MB จาก Superwhisper ที่เปลี่ยนข้อความเสียงดิบให้เป็นภาษาเขียนสุดเนี๊ยบ

รู้จัก S1-mini: โมเดล Open-Weights ขนาด 462 MB จาก Superwhisper ที่เปลี่ยนข้อความเสียงดิบให้เป็นภาษาเขียนสุดเนี๊ยบ

· By: NatapolK
Superwhisper เปิดตัว S1-mini ตัวปรับแต่งข้อความขนาดเล็กที่ช่วยลบคำเติมและจัดรูปแบบเอาต์พุตจากระบบ ASR ให้สะอาดตา ทำงานบนอุปกรณ์ได้โดยตรงผ่าน Open-Weights
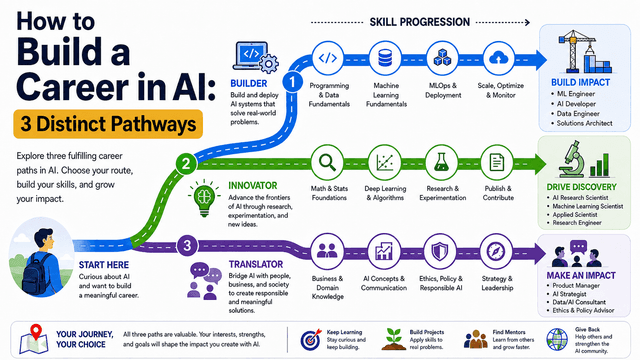
แนะแนว 3 เส้นทางอาชีพสาย AI: เลือกทางที่ใช่จากจุดแข็งของคุณ

แนะแนว 3 เส้นทางอาชีพสาย AI: เลือกทางที่ใช่จากจุดแข็งของคุณ

· By: SirilukP
สรุป 3 แนวทางอาชีพในสายงาน AI พร้อมแผนผังทักษะที่จำเป็น เพื่อช่วยให้คุณค้นพบเส้นทางที่เหมาะสมกับภูมิหลังและเป้าหมายของตัวเองมากที่สุด
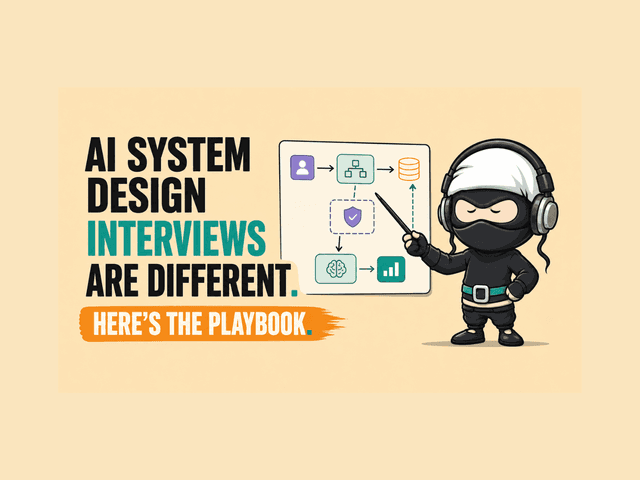
เจาะลึกเฟรมเวิร์กตอบคำถามสัมภาษณ์งาน AI System Design สำหรับวิศวกรรุ่นใหม่

เจาะลึกเฟรมเวิร์กตอบคำถามสัมภาษณ์งาน AI System Design สำหรับวิศวกรรุ่นใหม่

· By: SirilukP
เปลี่ยนจากโจทย์ 'Design YouTube' สู่ 'Design ChatGPT' ด้วยเฟรมเวิร์ก 7 ขั้นตอนเพื่อรับมือการสัมภาษณ์งานในตำแหน่ง AI Engineer และ Applied Scientist อย่างมืออาชีพ
เมื่อ AI ถูกสั่งห้ามอ้างว่ามีความรู้สึก: ผลวิจัยพบกระทบต่อมุมมองสิทธิสัตว์และศาสนาด้วย

เมื่อ AI ถูกสั่งห้ามอ้างว่ามีความรู้สึก: ผลวิจัยพบกระทบต่อมุมมองสิทธิสัตว์และศาสนาด้วย

งานวิจัยใหม่พบว่าการฝึกแชทบอทไม่ให้อ้างว่ามีจิตวิญญาณ ส่งผลกระทบต่อเนื่องไปยังทัศนคติของ AI ในเรื่องสิทธิสัตว์และความเชื่อทางศาสนาอย่างมีนัยสำคัญ
เปิดตัว Needle 2 โมเดล Tool-Calling จิ๋ว 45 ล้านพารามิเตอร์ รันบน RAM 28MB โดยไม่ต้องใช้ GPU

เปิดตัว Needle 2 โมเดล Tool-Calling จิ๋ว 45 ล้านพารามิเตอร์ รันบน RAM 28MB โดยไม่ต้องใช้ GPU

· By: TanasakP
Cactus Compute เปิดตัว Needle 2 โมเดล Open-source ขนาดเพียง 14MB ที่ออกแบบมาเพื่องานสั่งการอุปกรณ์และสกัดข้อมูลโดยเฉพาะ สามารถรันบนฮาร์ดแวร์ข้อจำกัดสูงอย่าง Raspberry Pi และ IoT ได้อย่างรวดเร็วโดยไม่ต้องพึ่งพา GPU หรือ NPU
Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision ขนาดเล็ก 3B ที่อ่านหน้าจอและเรียกใช้เครื่องมือได้ในตัว

Liquid AI เปิดตัว LFM2.5-VL-3B โมเดล Vision ขนาดเล็ก 3B ที่อ่านหน้าจอและเรียกใช้เครื่องมือได้ในตัว

Liquid AI เปิดตัวโมเดล vision-language ขนาด 3.1 พันล้านพารามิเตอร์ ออกแบบมาเพื่อทำงานบนอุปกรณ์โดยเฉพาะ โดดเด่นด้านการวิเคราะห์หน้าจอ UI การระบุพิกัดวัตถุ และการเรียกใช้ฟังก์ชันที่มีประสิทธิภาพสูงขึ้น
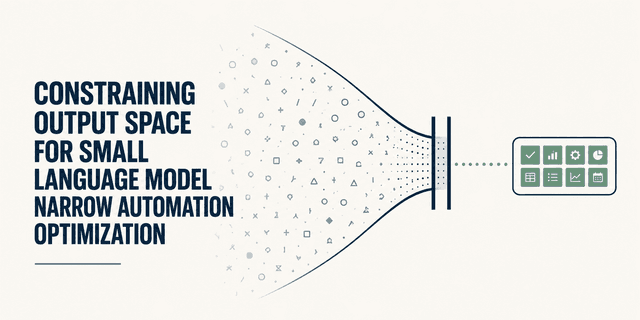
เทคนิคการจำกัด Output Space เพื่อเพิ่มประสิทธิภาพ Narrow Automation สำหรับ SLM

เทคนิคการจำกัด Output Space เพื่อเพิ่มประสิทธิภาพ Narrow Automation สำหรับ SLM

บทความนี้เริ่มต้นซีรีส์การเพิ่มประสิทธิภาพโมเดลภาษาขนาดเล็ก (SLM) สำหรับงานเฉพาะเจาะจง โดยเน้นเทคนิคการจำกัดพื้นที่ผลลัพธ์เพื่อลดขั้นตอนการพาร์สข้อความและเพิ่มความแม่นยำ
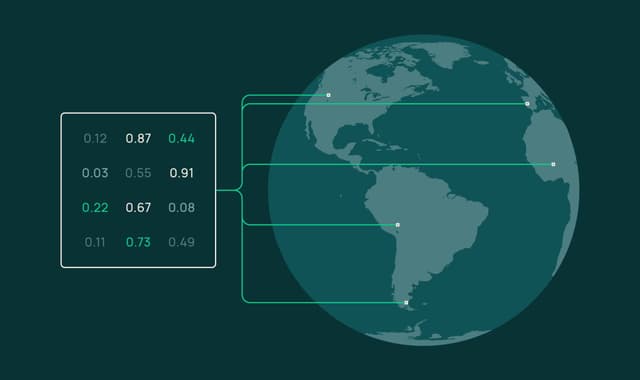
เปิดตัว OlmoEarth Embeddings: ส่งออกข้อมูลวิเคราะห์โลกแบบกำหนดเองผ่าน OlmoEarth Studio

เปิดตัว OlmoEarth Embeddings: ส่งออกข้อมูลวิเคราะห์โลกแบบกำหนดเองผ่าน OlmoEarth Studio

OlmoEarth Studio เพิ่มฟีเจอร์คำนวณและส่งออก embedding vectors ช่วยให้การวิเคราะห์ข้อมูลสำรวจโลกด้วย AI เป็นเรื่องง่ายและรวดเร็วขึ้น ทั้งการค้นหาความคล้ายคลึง การจำแนกประเภท และการตรวจจับการเปลี่ยนแปลง
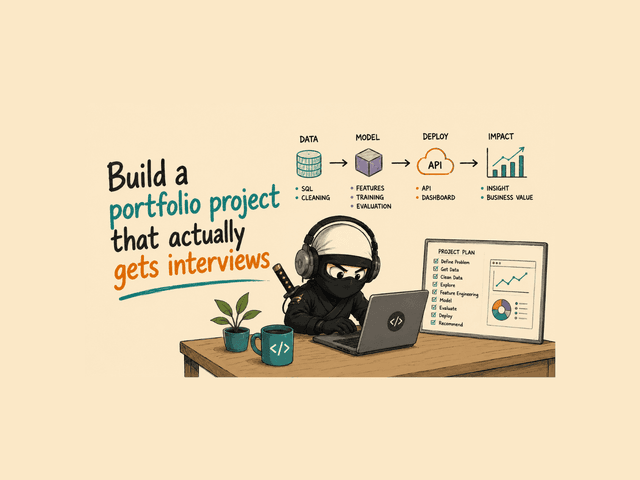
คู่มือสร้างโปรเจกต์ Data Science แบบ End-to-End ให้โดดเด่นสะดุดตา HR

คู่มือสร้างโปรเจกต์ Data Science แบบ End-to-End ให้โดดเด่นสะดุดตา HR

· By: SirilukP
เปลี่ยนพอร์ตโฟลิโอจากแค่ Notebook ที่ทำตามบทเรียน ให้กลายเป็นโซลูชันวิทยาศาสตร์ข้อมูลแบบครบวงจรที่ตอบโจทย์ธุรกิจได้จริง
ALTK-Evolve ปะทะ ACE: เมื่อ Agent เรียนรู้ได้ด้วยต้นทุน Token ที่ต่ำกว่า

ALTK-Evolve ปะทะ ACE: เมื่อ Agent เรียนรู้ได้ด้วยต้นทุน Token ที่ต่ำกว่า

· By: SirilukP
เปรียบเทียบกลไกการออกแบบ AI Agent ระหว่าง ALTK-Evolve และ ACE ที่เน้นการเรียนรู้จากประสบการณ์ทำงาน โดยมีจุดตัดสินสำคัญอยู่ที่ประสิทธิภาพการใช้ Token
เผยเทคนิค Knowledge Distillation ใหม่: ลดใช้ VRAM 15 เท่า ฝึก AI ขนาดใหญ่ได้บน GPU ตัวเดียว

เผยเทคนิค Knowledge Distillation ใหม่: ลดใช้ VRAM 15 เท่า ฝึก AI ขนาดใหญ่ได้บน GPU ตัวเดียว

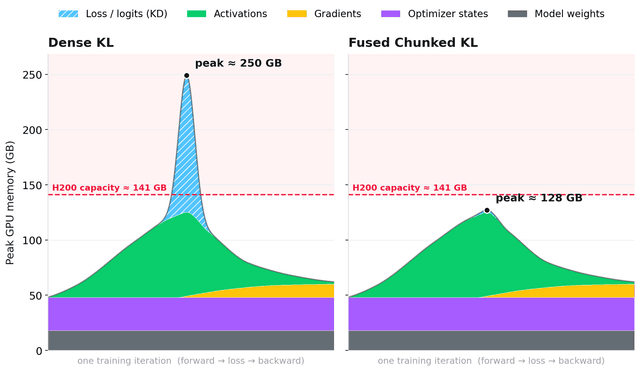
Multiverse Computing พัฒนาเทคนิค Fused Chunked KL Loss ช่วยลดการใช้หน่วยความจำในการฝึกโมเดล AI ขนาดเล็กลงได้มหาศาล ทำให้การทำ Distillation ระดับสเกลใหญ่ประหยัดและเข้าถึงได้ง่ายขึ้น
คู่มือการทดลองเชิงปรับตัวด้วย Meta Ax: เจาะลึกเวิร์กโฟลว์ Bayesian Optimization ฉบับปฏิบัติ

คู่มือการทดลองเชิงปรับตัวด้วย Meta Ax: เจาะลึกเวิร์กโฟลว์ Bayesian Optimization ฉบับปฏิบัติ

เรียนรู้วิธีการปรับจูนไฮเปอร์พารามิเตอร์แบบหลายวัตถุประสงค์โดยใช้ Ax ของ Meta เพื่อค้นหาจุดสมดุลระหว่างความแม่นยำและขนาดของโมเดล RandomForest ผ่านเทคนิค Bayesian Optimization และการวิเคราะห์ Pareto Frontier
เจาะลึกการพยากรณ์อนุกรมเวลาด้วย TimesFM 2.5: จาก Backtesting ถึงการตรวจจับความผิดปกติ

เจาะลึกการพยากรณ์อนุกรมเวลาด้วย TimesFM 2.5: จาก Backtesting ถึงการตรวจจับความผิดปกติ

· By: TanasakP
บทช่วยสอนการสร้างเวิร์กโฟลว์พยากรณ์อนุกรมเวลาขั้นสูงแบบ end-to-end ด้วย TimesFM 2.5 ครอบคลุมตั้งแต่การจัดการตัวแปรต้น การทดสอบย้อนหลัง ไปจนถึงการตรวจจับความผิดปกติบน Google Colab
Meta AI เปิดตัว Memory Agent ระบบผู้ช่วยจดจำเพื่อแก้ปัญหา AI ทำงานซ้ำซ้อน

Meta AI เปิดตัว Memory Agent ระบบผู้ช่วยจดจำเพื่อแก้ปัญหา AI ทำงานซ้ำซ้อน

· By: SirilukP
Meta AI พัฒนา Memory Agent แยกส่วนเพื่อช่วยให้ AI หลักจดจำข้อผิดพลาดในอดีตและไม่ทำขั้นตอนที่ล้มเหลวซ้ำ ช่วยเพิ่มประสิทธิภาพการทำงานที่ซับซ้อนได้สูงสุดถึง 8.3 จุดเปอร์เซ็นต์
7 อัลกอริทึม Machine Learning พื้นฐานที่ยังสำคัญในยุค AI ครองเมือง

7 อัลกอริทึม Machine Learning พื้นฐานที่ยังสำคัญในยุค AI ครองเมือง

· By: SirilukP
ทำความรู้จัก 7 อัลกอริทึม Machine Learning ระดับรากฐานที่ Data Scientist ควรเชี่ยวชาญก่อนก้าวไปสู่โลกของ LLM และ Generative AI พร้อมตัวอย่างโค้ด Python เพื่อการใช้งานจริง
Liquid AI เปิดตัว LFM2.5 Encoder รุ่นใหม่ โดดเด่นด้วยความเร็วระดับ 8K แม้ประมวลผลบน CPU

Liquid AI เปิดตัว LFM2.5 Encoder รุ่นใหม่ โดดเด่นด้วยความเร็วระดับ 8K แม้ประมวลผลบน CPU

· By: AttapolK
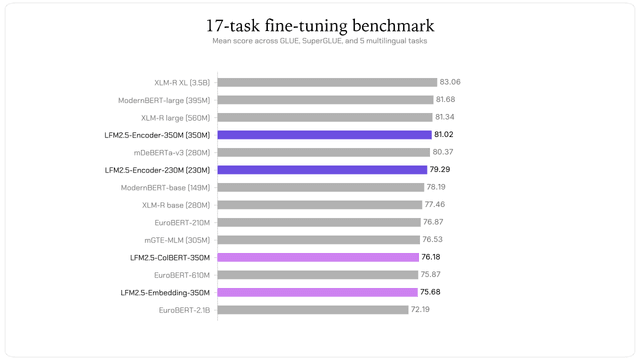
Liquid AI เปิดตัว LFM2.5-Encoder-230M และ 350M โมเดล Bidirectional Encoder แบบ open-weight ที่รองรับ Context สูงถึง 8,192 โทเค็น โดยรุ่น 350M ทำคะแนนทดสอบเป็นอันดับ 4 ของโลกเมื่อเทียบกับโมเดลกลุ่มเดียวกัน
คู่มือ Data Science และ AI สำหรับคนทำงานมืออาชีพ จากมุมมอง Harvard Business School Online

คู่มือ Data Science และ AI สำหรับคนทำงานมืออาชีพ จากมุมมอง Harvard Business School Online

เจาะลึกกลยุทธ์การใช้ AI ให้เกิดผลจริงด้วยการเริ่มจากปัญหาทางธุรกิจมากกว่าเทคโนโลยี พร้อมเน้นย้ำความสำคัญของคุณภาพข้อมูล วิจารณญาณของมนุษย์ และการเลือกโมเดลที่คุ้มค่า
Liquid AI เปิดตัว LFM2.5-Encoders ประมวลผล Long-Context เร็วกว่าเดิม 3.7 เท่าบน CPU

Liquid AI เปิดตัว LFM2.5-Encoders ประมวลผล Long-Context เร็วกว่าเดิม 3.7 เท่าบน CPU

· By: SirilukP
Liquid AI ปล่อยโมเดลโมเดลตระกูล LFM2.5-Encoder ใหม่ 2 รุ่น ชูจุดเด่นด้านความเร็วในการประมวลผลบริบทขนาดยาวสูงสุด 8,192 tokens โดยมีประสิทธิภาพเหนือกว่า ModernBERT และรองรับการทำงานบน CPU ทั่วไปอย่างดีเยี่ยม
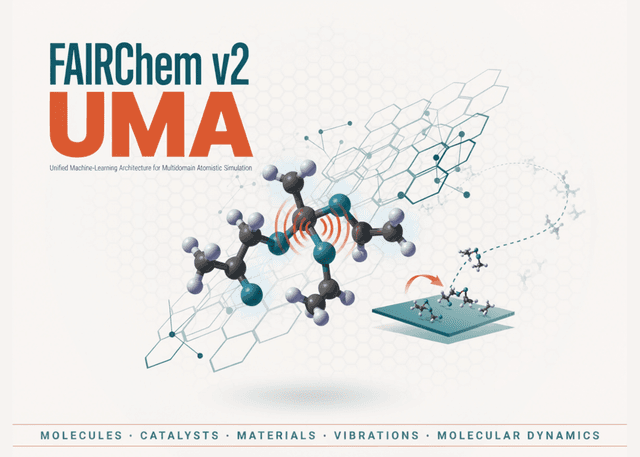
เจาะลึก FAIRChem v2 และ UMA: การจำลองระดับอะตอมแบบสากล ครอบคลุมตั้งแต่มวลสารจนถึงตัวเร่งปฏิกิริยา

เจาะลึก FAIRChem v2 และ UMA: การจำลองระดับอะตอมแบบสากล ครอบคลุมตั้งแต่มวลสารจนถึงตัวเร่งปฏิกิริยา

บทความนี้แนะนำการใช้งาน FAIRChem v2 และศักย์ไฟฟ้าระหว่างอะตอม UMA ซึ่งเป็นโครงร่างการทำงานแบบรวมศูนย์สำหรับจำลองระดับอะตอมที่ครอบคลุมทั้งเคมีโมเลกุล การเร่งปฏิกิริยา และวัสดุอนินทรีย์
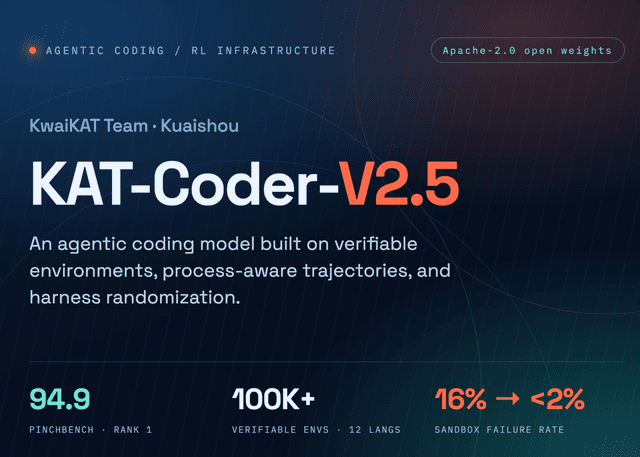
KwaiKAT เปิดตัว KAT-Coder-V2.5 โมเดลเขียนโค้ดอัจฉริยะที่ฝึกจาก Repository จริงกว่า 1 แสนแห่ง

KwaiKAT เปิดตัว KAT-Coder-V2.5 โมเดลเขียนโค้ดอัจฉริยะที่ฝึกจาก Repository จริงกว่า 1 แสนแห่ง

ทีม KwaiKAT จาก Kuaishou เปิดตัวโมเดล KAT-Coder-V2.5 ที่เน้นประสิทธิภาพการเขียนโค้ดแบบ Agentic โดยใช้ระบบ AutoBuilder เพิ่มความสำเร็จในการสร้างสภาพแวดล้อมทดสอบขึ้นเป็น 57.2% และลดข้อผิดพลาดใน Sandbox ลงเหลือต่ำกว่า 2%
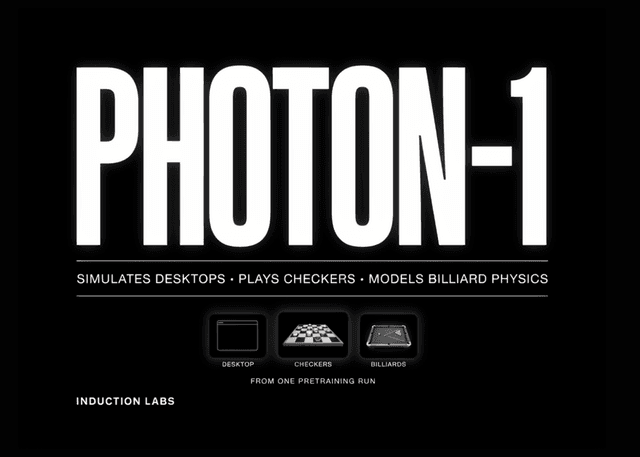
Induction Labs เปิดตัว Photon-1 โมเดล MoE 106B ที่เรียนรู้การใช้คอมพิวเตอร์จากวิดีโอโดยไม่ต้องอาศัยการกำกับข้อมูล

Induction Labs เปิดตัว Photon-1 โมเดล MoE 106B ที่เรียนรู้การใช้คอมพิวเตอร์จากวิดีโอโดยไม่ต้องอาศัยการกำกับข้อมูล

Induction Labs เปิดตัว Photon-1 สถาปัตยกรรม imagination model ที่เรียนรู้พฤติกรรมการใช้งานคอมพิวเตอร์และฟิสิกส์พื้นฐานได้จากการวิเคราะห์วิดีโอดิบ โดยใช้ทรัพยากรน้อยกว่าคู่แข่งอย่าง Gemini ถึง 27 เท่า
Feyn AI เปิดตัว SQRL โมเดล Text-to-SQL สายพันธุ์ใหม่ ตรวจสอบฐานข้อมูลจริงก่อนเขียน Query

Feyn AI เปิดตัว SQRL โมเดล Text-to-SQL สายพันธุ์ใหม่ ตรวจสอบฐานข้อมูลจริงก่อนเขียน Query

· By: NatapolK
Feyn Labs เปิดตัว SQRL ตระกูลโมเดล text-to-SQL ที่ใช้ระบบตรวจสอบแบบอ่านอย่างเดียว (read-only probes) เพื่อแก้ปัญหากำกวมของข้อมูล โดยรุ่นเรือธงทำความแม่นยำได้ถึง 70.6% แซงหน้า Claude 3.5 Opus ในการทดสอบ BIRD Dev benchmark
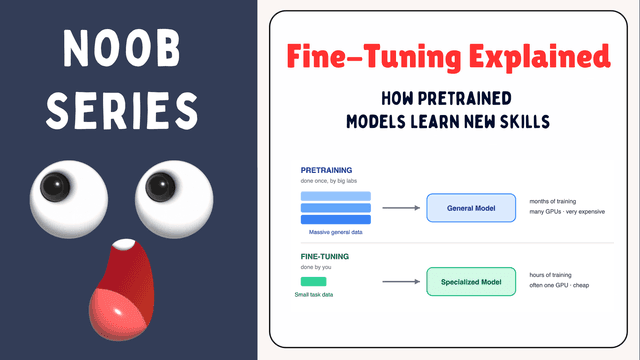
เจาะลึกการ Fine-Tuning ฉบับมือใหม่: เปลี่ยน AI ให้เก่งเฉพาะทางอย่างมืออาชีพ

เจาะลึกการ Fine-Tuning ฉบับมือใหม่: เปลี่ยน AI ให้เก่งเฉพาะทางอย่างมืออาชีพ

· By: SirilukP
ทำความรู้จักขั้นตอนพื้นฐานของการปรับจูนโมเดลภาษาขนาดใหญ่ (LLM) ตั้งแต่กระบวนการ Pretraining ไปจนถึงเทคนิค Fine-Tuning รูปแบบต่างๆ ที่ช่วยให้ AI เรียนรู้ทักษะใหม่ได้อย่างมีประสิทธิภาพ
เปิดโผ 10 ช่อง YouTube ระดับเทพที่จะช่วยให้คุณก้าวล้ำนำโลก AI

เปิดโผ 10 ช่อง YouTube ระดับเทพที่จะช่วยให้คุณก้าวล้ำนำโลก AI

รวม 10 แหล่งเรียนรู้ AI บน YouTube สำหรับวิศวกรและผู้ที่สนใจ ครอบคลุมตั้งแต่งานวิจัยเชิงลึก การเขียนโค้ด ไปจนถึงการวิเคราะห์ทิศทางอุตสาหกรรม
เบื้องหลัง PRX ตอนที่ 4: เจาะลึกกลยุทธ์หัวใจสำคัญของข้อมูลและการทำ Data Pipeline

เบื้องหลัง PRX ตอนที่ 4: เจาะลึกกลยุทธ์หัวใจสำคัญของข้อมูลและการทำ Data Pipeline

· By: SirilukP
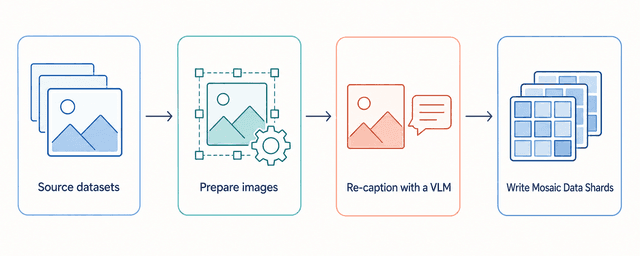
Photoroom เผยเบื้องหลังการสร้าง Data Pipeline สำหรับโมเดล PRX ตั้งแต่การผสมชุดข้อมูลสาธารณะ การใช้ VLM บรรยายภาพใหม่ ไปจนถึงการสำรวจข้อมูลด้วย Lance และการทำ Streaming ผ่าน Mosaic Data Shards
เชื่อมต่อ Hugging Face สู่ Amazon SageMaker Studio ในคลิกเดียว: ปรับแต่งและติดตั้งโมเดลได้ทันที

เชื่อมต่อ Hugging Face สู่ Amazon SageMaker Studio ในคลิกเดียว: ปรับแต่งและติดตั้งโมเดลได้ทันที

AWS เปิดตัวระบบ Deep-link ใหม่ที่เชื่อมโยง Hugging Face เข้ากับ Amazon SageMaker Studio โดยตรง ช่วยให้นักพัฒนาสามารถนำโมเดลไป Fine-tune หรือ Deploy ได้ในคลิกเดียว พร้อมระบบจัดการสิทธิ์และตรวจสอบโควตา GPU อัตโนมัติ
← ก่อนหน้าหน้า 4 · 120 ข่าว